Reseña de GLM-5.3-Flash: Ox-Alpha, API, benchmarks y límites NSFW
GLM-5.3-Flash es el modelo open-weight que Z.ai reveló detrás de Ox-Alpha. Combina MoE, contexto largo, capacidades multimodales y un enfoque claro en código, agentes y…

GLM-5.3-Flash es el modelo open-weight que Z.ai reveló detrás de Ox-Alpha. Combina MoE, contexto largo, capacidades multimodales y un enfoque claro en código, agentes y coste bajo.
Es especialmente interesante para desarrolladores que necesitan API barata, razonamiento sólido y opción de autoalojamiento. No es un modelo NSFW sin censura ni el más ligero para una GPU doméstica.
Índice
Veredicto rápido
| Elemento | Evaluación |
|---|---|
| Ideal para | Código, agentes, documentos largos, productos con API |
| Modelo | MoE de 320B totales y unos 18B activos |
| Acceso | Z.ai Chat, API, Hugging Face, OpenRouter |
| Cuidado | Filtros de seguridad y despliegue local pesado |
Lecturas relacionadas: Qwen 3.8 / Gemma 4 / Dolphin 3
Qué es el modelo
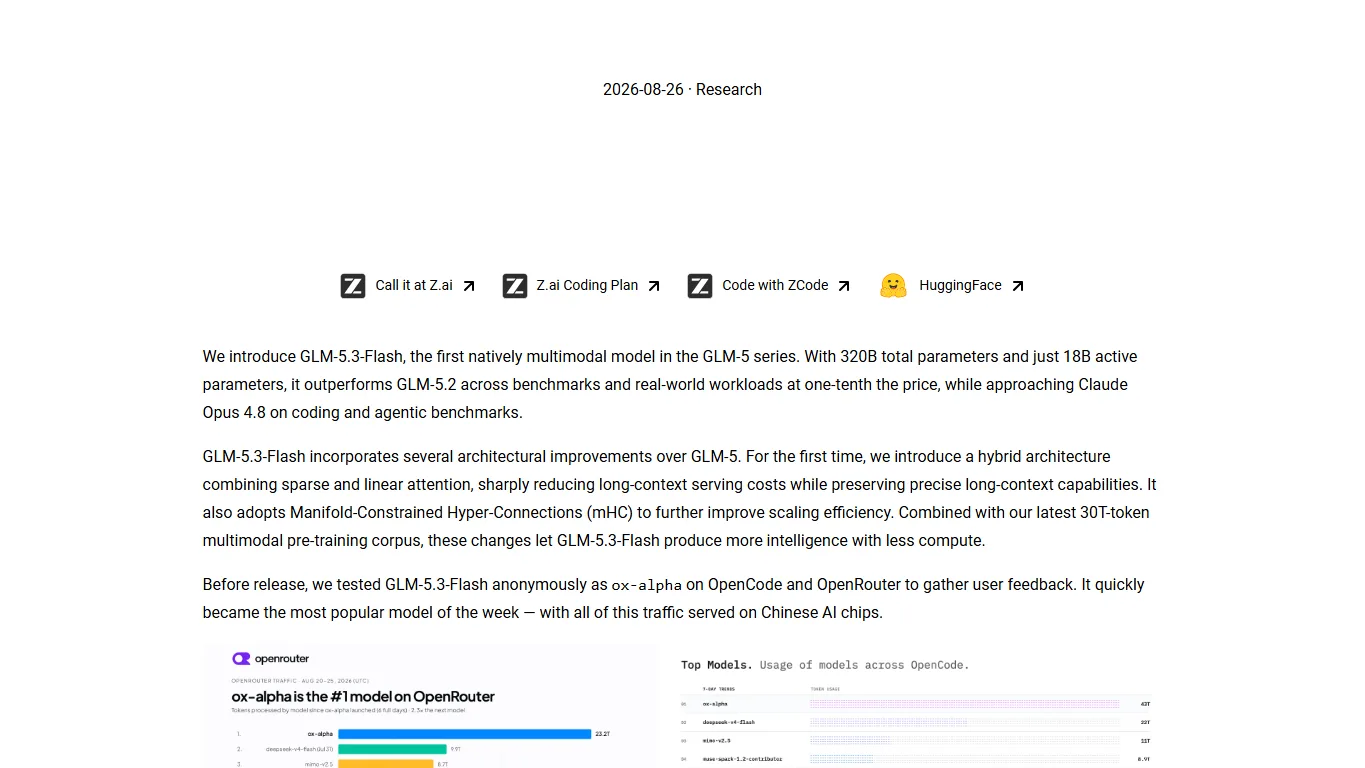
Z.ai lo describe como el primer modelo GLM-5 nativamente multimodal. Usa atención sparse/linear para reducir coste en contexto largo y una arquitectura MoE para activar solo parte del modelo por token.
El nombre Ox-Alpha ayudó a obtener feedback público antes del lanzamiento, sobre todo en tareas de código y agentes.
Acceso oficial y descargas
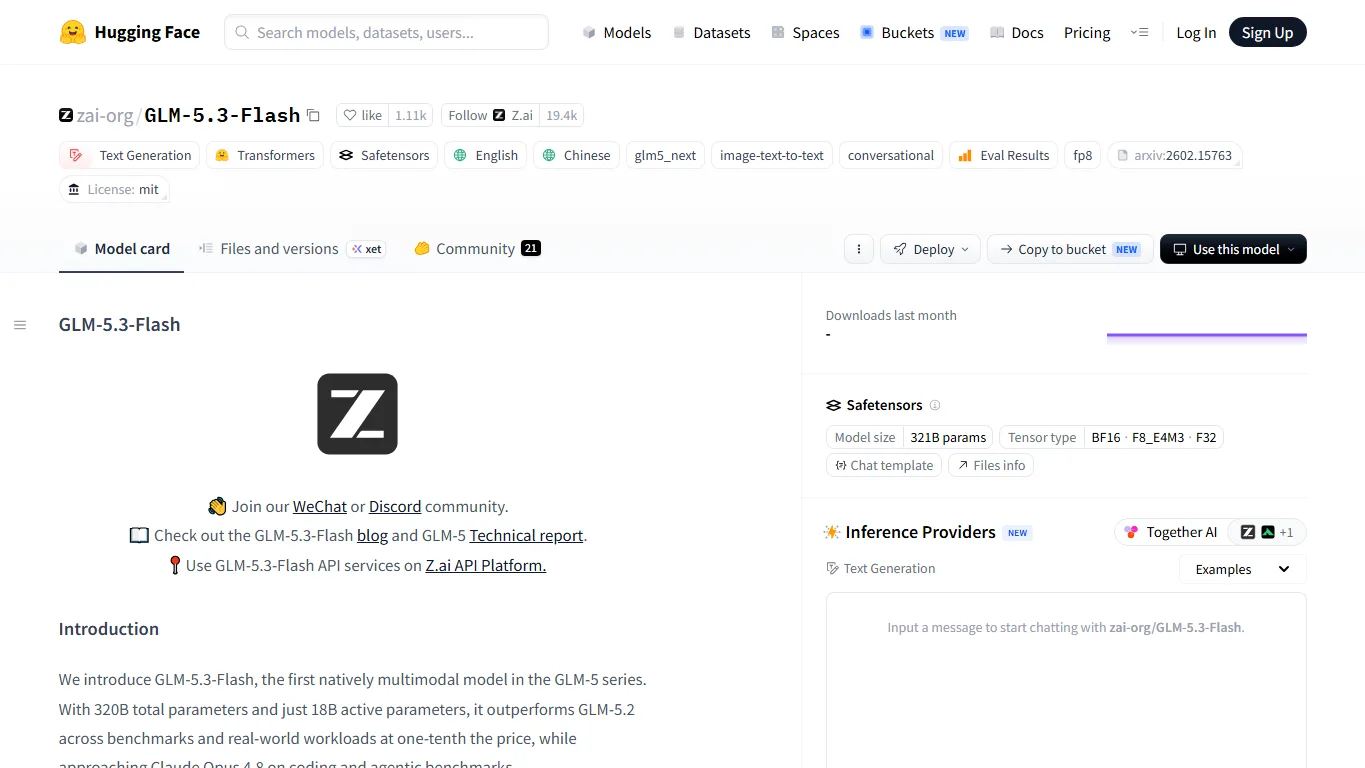
Puedes probarlo en Z.ai Chat o ChatGLM. Para integración, consulta la API de Z.ai. Los pesos están en Hugging Face y los archivos en Files and versions.
Si no tienes hardware suficiente, empieza con API u OpenRouter antes de montar un servidor local.
Funciones y experiencia
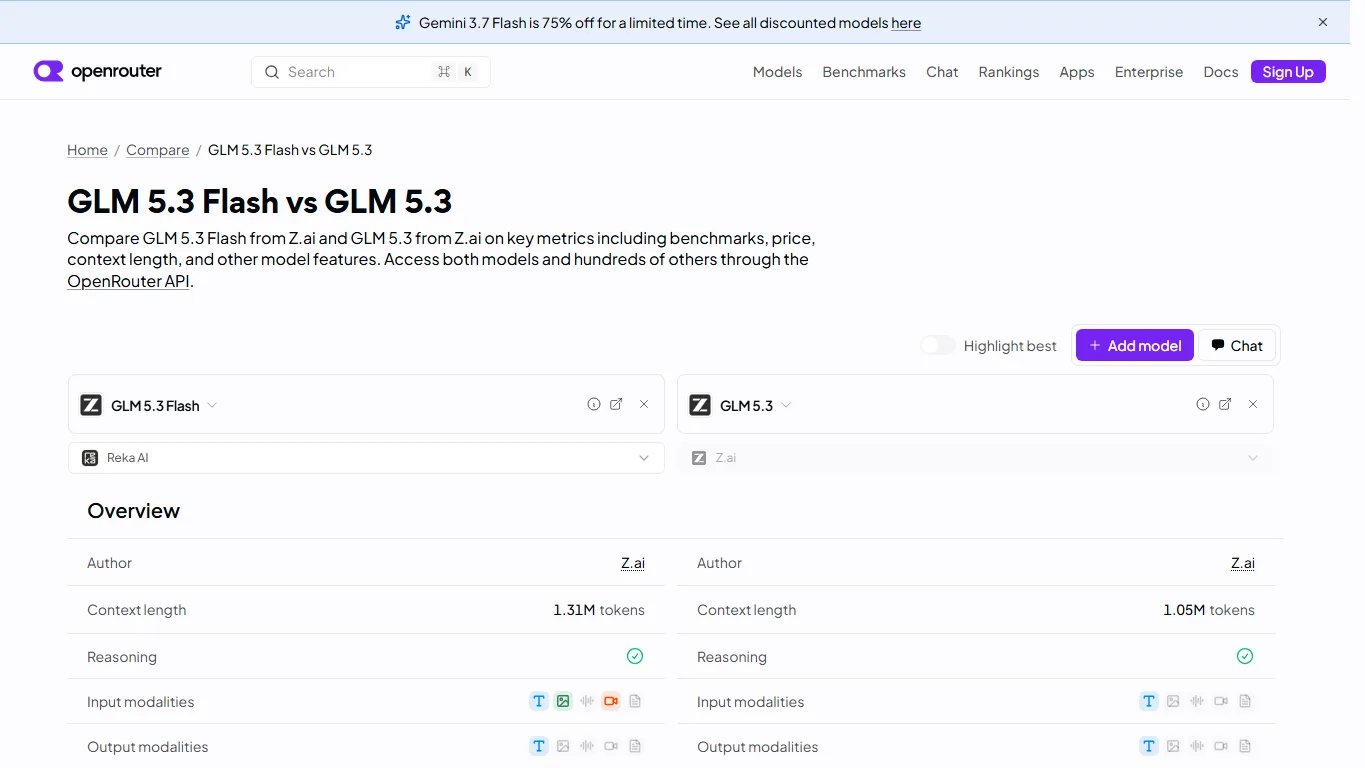
Su valor está en contexto largo, código, multimodalidad y eficiencia de coste. Es más un modelo para workflows y productos que un chatbot casual.
Se puede usar para resumen de documentos, análisis de especificaciones, refactorización, extracción de datos y agentes con herramientas.
Comparación con modelos similares
| Modelo | Ventaja | Uso |
|---|---|---|
| GLM-5.3-Flash | Bajo coste, multimodal, contexto largo | API y agentes |
| Qwen 3.8 | Ecosistema local fuerte | LLM local |
| Gemma 4 | Buen equilibrio local | Asistente general |
| Dolphin 3 | Ruta uncensored | Roleplay y escritura libre |
Soporte y límites NSFW
No conviene tratar GLM-5.3-Flash como modelo sin censura. Z.ai Chat y API aplican reglas de seguridad.
Con pesos locales hay más control, pero la licencia, la publicación y las normas de plataforma siguen importando. Para NSFW libre, Dolphin y modelos similares son más directos.
Preguntas frecuentes
¿Es open-weight?
Sí, hay pesos en Hugging Face.
¿Ox-Alpha es el mismo modelo?
Ox-Alpha fue el nombre usado en pruebas antes de revelar GLM-5.3-Flash.
¿Es bueno para código?
Sí, código y agentes son parte central de su posicionamiento.
¿Es NSFW?
No es un modelo uncensored.
Referencias
- Z.ai GLM-5.3-Flash official blog
- GLM-5.3-Flash on Hugging Face
- Z.ai API documentation
- OpenRouter model comparison
- AIbase report
- AIbase benchmark coverage
Conclusión
GLM-5.3-Flash une coste bajo, API, pesos abiertos y rendimiento fuerte en tareas largas.
Es recomendable para productos y agentes; menos ideal para baja VRAM o NSFW sin filtros.
Relacionados Reseñas
Reseña de Pony V7: AuraFlow, LoRA, comparación con V6 y NSFW

Reseña de Gemini Omni 1.1 Flash: video IA de Google, 4K, API y límites NSFW

Review de Wan 3.0: video IA de 30 s, estado open source y límites NSFW
Análisis de GPT-6 Astra: precios, API, opiniones y límites

Claude Fable 5.1 y Mythos 5.1: análisis 2026, precios, API, NSFW y comparación con GPT y Gemini
Review de Qwen 3.8: rendimiento, instalación local, requisitos de GPU y política NSFW