Review de Gemma 4: instalación local, requisitos de GPU y política NSFW
Gemma 4 es la familia de modelos open-weight más reciente de Google DeepMind para desarrolladores que quieren probar un LLM local o autoalojado dentro del…

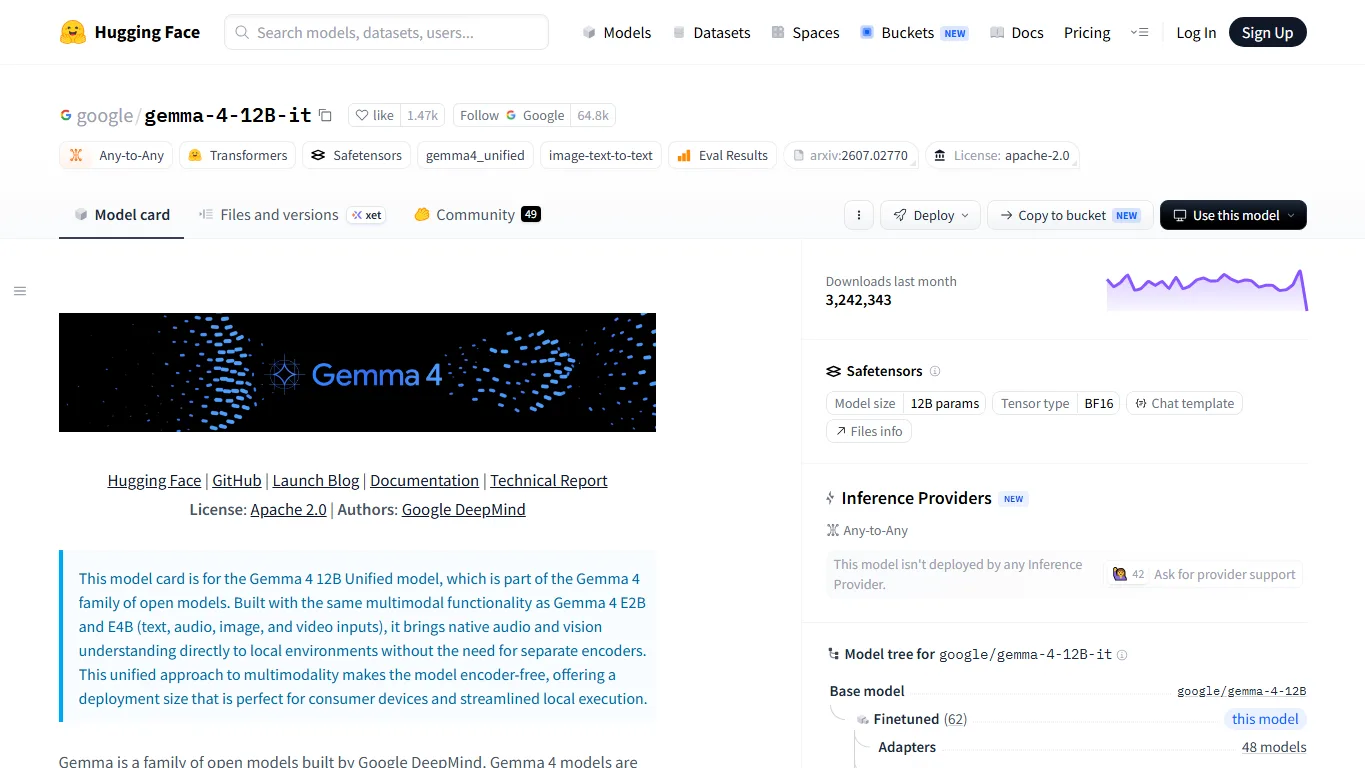
Gemma 4 es la familia de modelos open-weight más reciente de Google DeepMind para desarrolladores que quieren probar un LLM local o autoalojado dentro del ecosistema de Google. No es un solo modelo: incluye opciones E2B, E4B, 12B, 26B-A4B y 31B.
Para evaluar Gemma 4 conviene separar calidad, coste local, GPU y política NSFW. El 31B apunta a calidad, el 26B-A4B busca eficiencia y el 12B es el punto de entrada más realista. Los modelos oficiales están alineados con seguridad, mientras que Hugging Face ya tiene variantes uncensored y abliterated de la comunidad.
Índice
Qué es Gemma 4
Gemma 4 es una familia de modelos abiertos de Google DeepMind basada en investigación de Gemini 3. La ficha oficial enumera E2B, E4B, 12B, 26B-A4B y 31B, con contexto de hasta 256K, entrada de texto e imagen y audio en algunas variantes pequeñas.
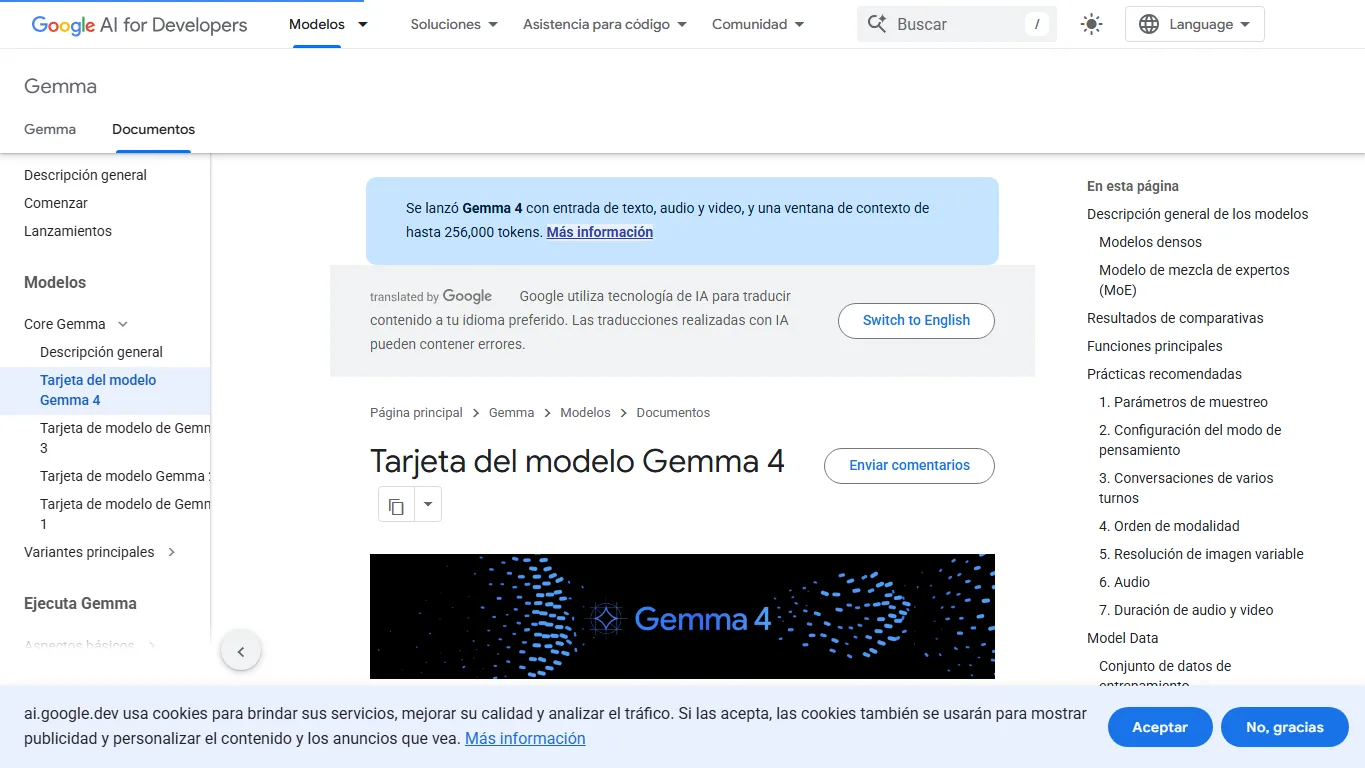
En términos prácticos, E2B/E4B son ligeros, 12B sirve para pruebas locales, 26B-A4B destaca por eficiencia activa y 31B es la opción pesada orientada a calidad.
Descargas oficiales
| Modelo | Mejor para | Descarga |
|---|---|---|
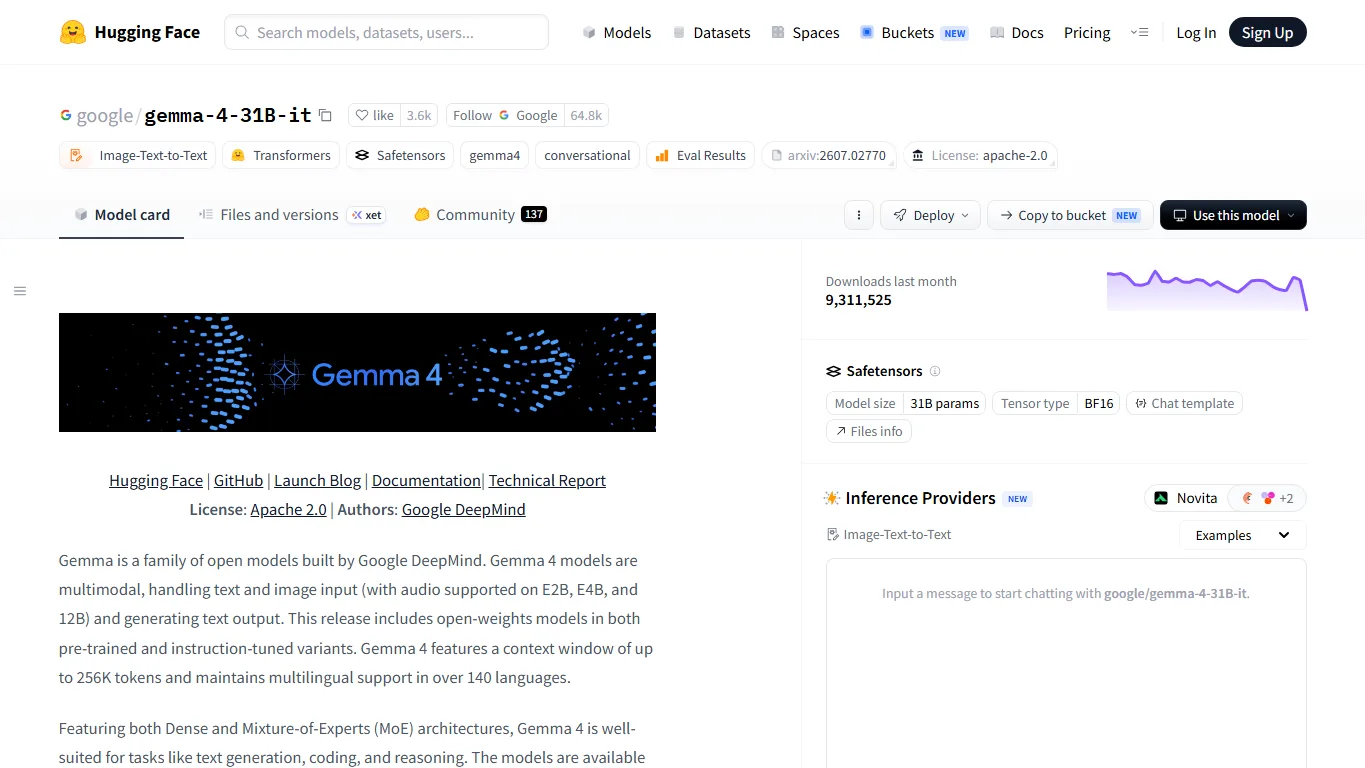
| Gemma 4 31B IT | Calidad y pruebas locales exigentes | Hugging Face 31B IT |
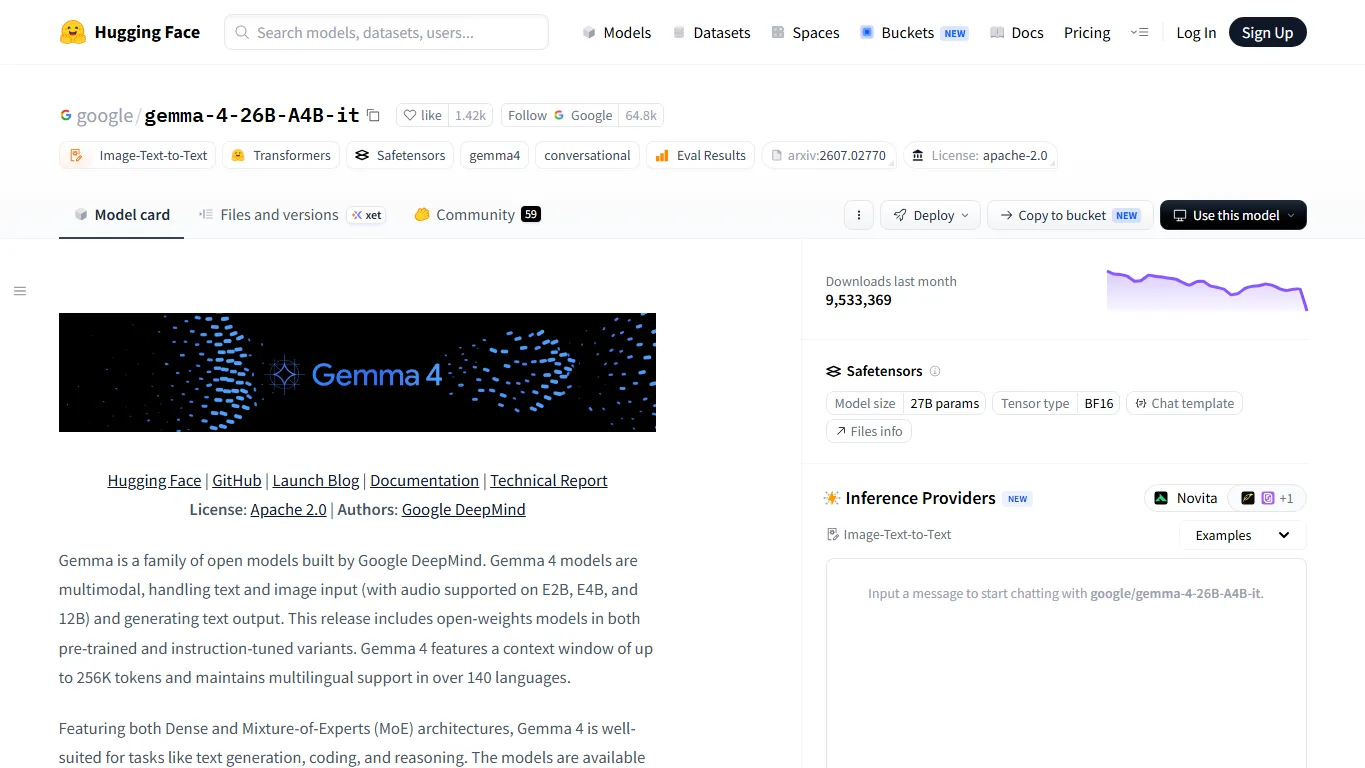
| Gemma 4 26B-A4B IT | Eficiencia y pruebas de throughput | Hugging Face 26B-A4B IT |
| Gemma 4 12B IT | Primera prueba en GPU de consumo | Hugging Face 12B IT |
| Gemma 4 model card | Especificaciones y seguridad | Google AI Developers |
Rendimiento y experiencia real
La comunicación oficial insiste en inteligencia por parámetro, contexto largo, entrada multimodal y facilidad para desarrolladores. En la práctica, conviene probar tareas propias: código, resumen largo, RAG local, escritura mixta, extracción estructurada e imagen pueden cambiar el ranking.
Comparación con LLM locales
| Modelo | Nota |
|---|---|
| Gemma 4 | Pesos abiertos de Google, contexto largo, multimodal y documentación clara. |
| Qwen 3.8 | Muy fuerte en multilingüe, código y tareas chino/japonés/inglés. |
| Llama | Ecosistema enorme de cuantizaciones y fine-tunes. |
| DeepSeek | Muy comparado en razonamiento y código. |
| Mistral / Mixtral | Ecosistema maduro para MoE y despliegues abiertos. |
Instalación local
Para una primera prueba local, Transformers es suficiente. Para API, batching o más throughput, revisa vLLM o SGLang. En modelos grandes, confirma VRAM, cuantización y contexto.
pip install -U transformers accelerate torch safetensors python - <<'PY' from transformers import AutoModelForCausalLM, AutoTokenizer model_id = "google/gemma-4-12B-it" tokenizer = AutoTokenizer.from_pretrained(model_id) model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype="auto", device_map="auto") PYRequisitos de GPU y hardware
| Variante | VRAM | Nota |
|---|---|---|
| Gemma 4 31B IT | BF16 60GB+ / 80GB GPU preferred | 24GB exige 4-bit y contexto corto. |
| Gemma 4 26B-A4B IT | Large total weights | Menos parámetros activos no significa pesos pequeños. |
| Gemma 4 12B IT | 16GB-24GB comfortable / lower with quantization | Mejor punto de partida local. |
Uso online si tu hardware no alcanza
Google AI Studio es la ruta más directa si tu hardware no alcanza: prueba prompts, contexto y API antes de descargar pesos grandes.
NSFW, Uncensored y modelos Abliterated
Los modelos oficiales Gemma 4 y Google AI Studio no son servicios NSFW sin límites. Contenido adulto, peligroso, ilegal o sensible puede ser rechazado o respondido con cautela.
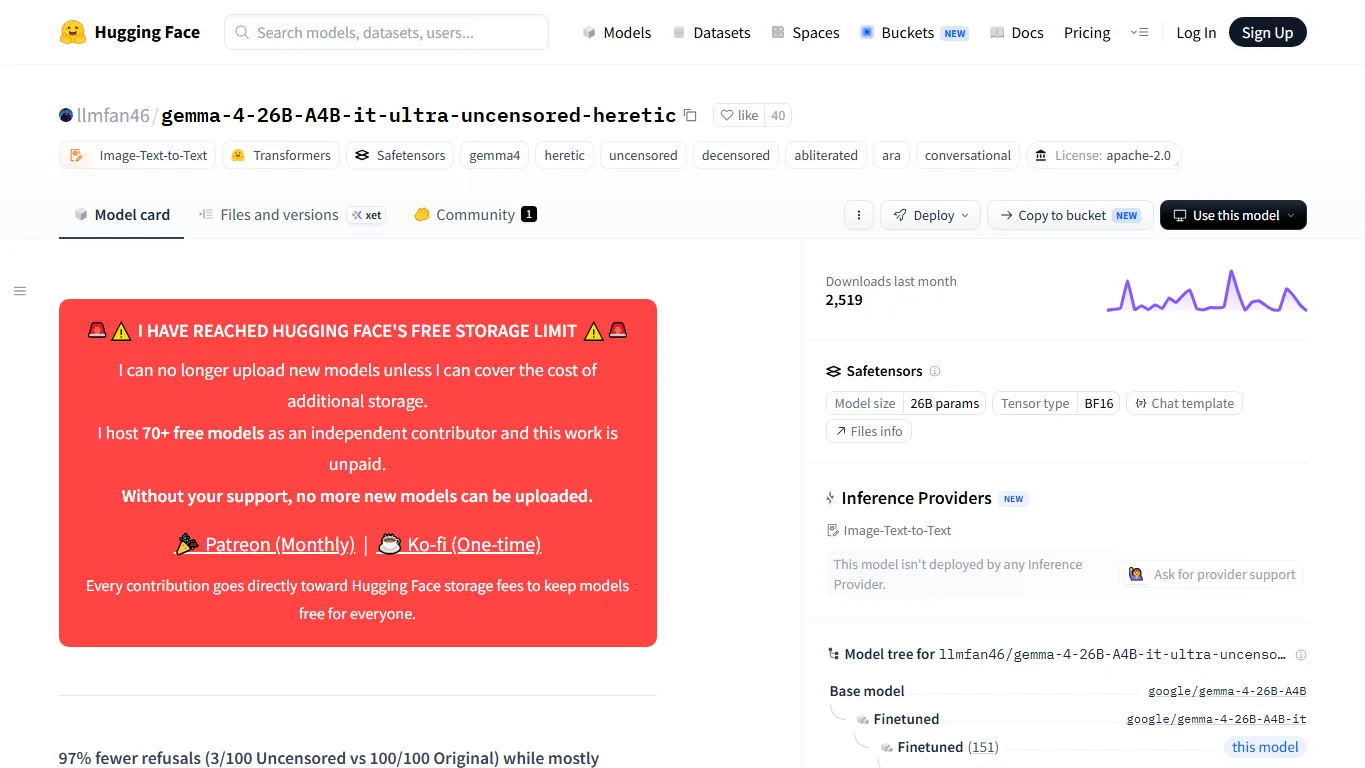
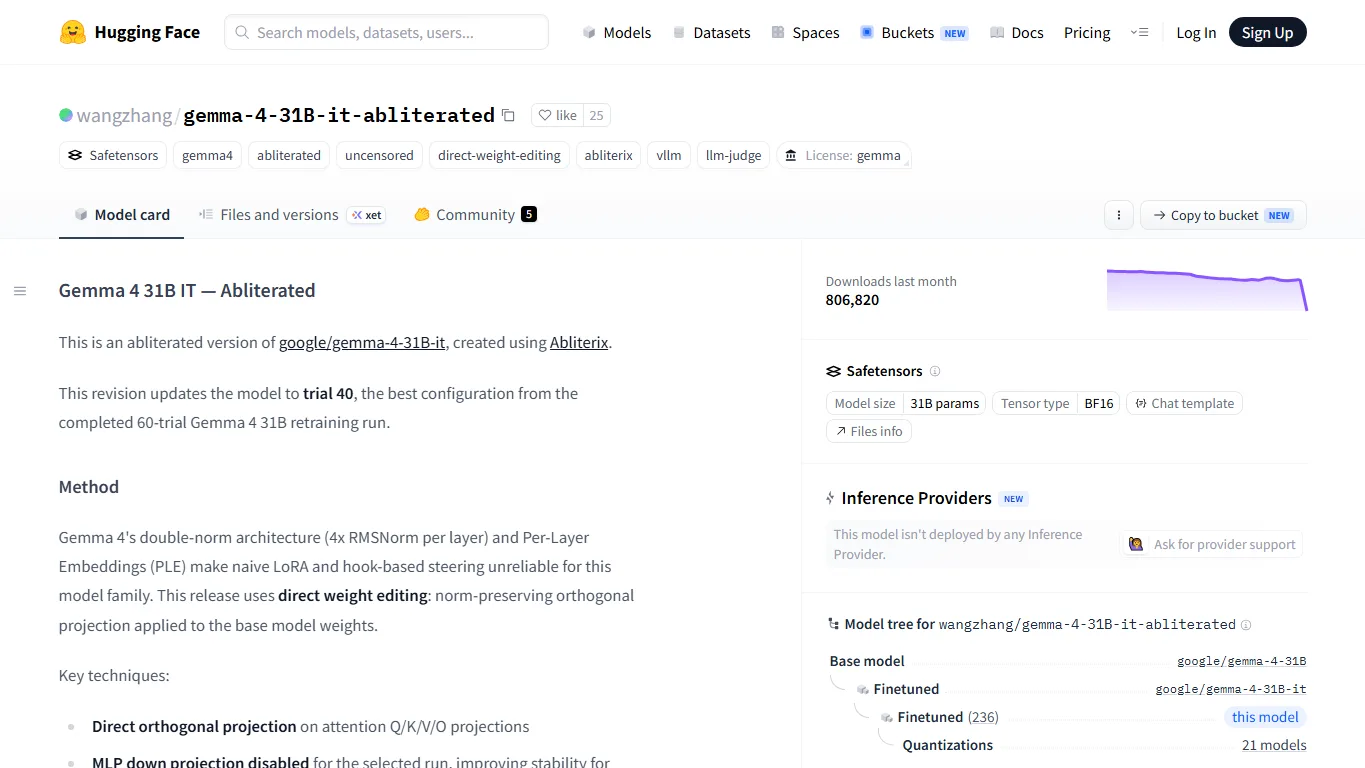
Quien investigue el comportamiento de rechazo puede encontrar Gemma 4 26B-A4B Uncensored / Heretic y Gemma 4 31B Abliterated. Son modelos de la comunidad, no versiones oficiales de Google.
Preguntas frecuentes
¿Qué Gemma 4 conviene descargar primero?
Con una GPU común, empieza por 12B o una versión cuantizada antes de pasar a 26B-A4B o 31B.
¿Una GPU de 24 GB puede ejecutar 31B?
En BF16 no es realista; solo con cuantización y contexto corto.
¿Las variantes uncensored son oficiales?
No. Heretic y Abliterated son derivados de la comunidad en Hugging Face.
Conclusión
Gemma 4 encaja con quien busca pesos abiertos de Google, contexto largo, multimodalidad y documentación clara. Lo más prudente es probar AI Studio o 12B antes de desplegar 26B-A4B o 31B.
Referencias
Relacionados Reseñas
GPT-Image-2.5: análisis 2026 de Flare, Sunburst, precios y NSFW

Review de Kimi K3: MoE open-weight 2.8T, despliegue local, benchmarks y NSFW
Reseña de Hy4 Preview: Tencent Hunyuan 770B MoE, contexto 1M, API, hardware local y límites NSFW
Reseña de GLM-5.3-Flash: Ox-Alpha, API, benchmarks y límites NSFW

Review de Wan 3.0: video IA de 30 s, estado open source y límites NSFW
Análisis de GPT-6 Astra: precios, API, opiniones y límites
