Reseña de Dolphin 3.0: LLM local sin censura para NSFW, rol y programación
Dolphin 3.0 es uno de los nombres clásicos dentro del ecosistema de LLM locales y sin censura. No se trata de otro modelo pensado únicamente…

Dolphin 3.0 es uno de los nombres clásicos dentro del ecosistema de LLM locales y sin censura. No se trata de otro modelo pensado únicamente para pruebas de rendimiento: la gente busca Dolphin porque quiere una inteligencia artificial dispuesta a obedecer las instrucciones del sistema, mucho más flexible para la escritura y el *roleplay*, y menos filtrada que los asistentes comerciales tradicionales.
En resumen: Dolphin 3.0 R1 Mistral 24B es la opción insignia más potente si dispones de suficiente memoria en la GPU, mientras que Dolphin 3.0 Llama 3.1 8B resulta mucho más accesible para equipos de escritorio mediante Ollama, LM Studio y pruebas locales rápidas. Es una excelente alternativa para la escritura creativa, el juego de rol, la programación, las matemáticas y los flujos de trabajo con agentes locales, aunque un despliegue público siempre requerirá de tus propias normas de seguridad.
Contenido
¿Qué es Dolphin 3.0?
Dolphin 3.0 es una familia de modelos locales ajustados mediante instrucciones y desarrollada por Eric Hartford, Ben Gitter, BlouseJury y Cognitive Computations. La ficha técnica de Dolphin3.0-R1-Mistral-24B lo define como un modelo local de propósito general apto para programación, matemáticas, tareas con agentes, llamadas a funciones y conversación general. Asimismo, deja clara la filosofía de Dolphin: es el propietario del sistema, y no el creador del modelo, quien debe decidir la directiva del sistema y las políticas de alineación.
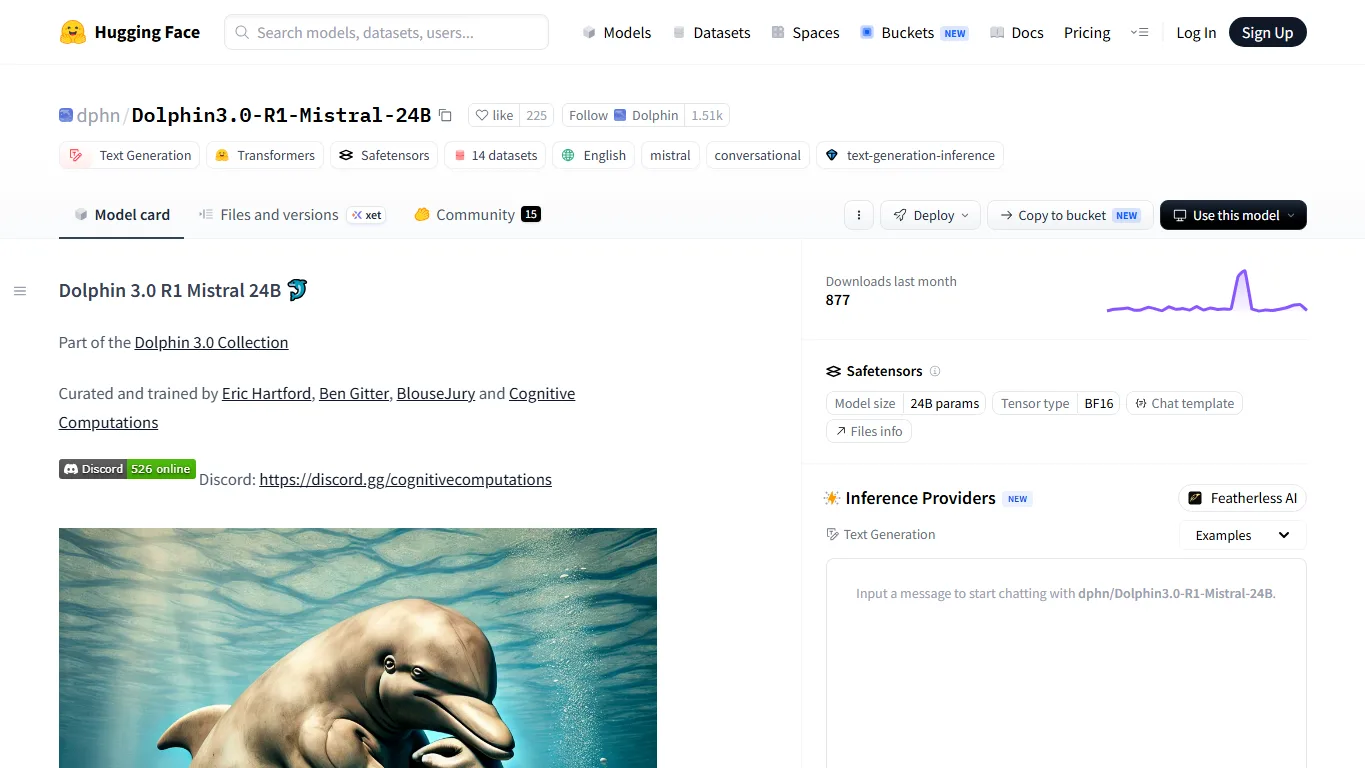
Esta filosofía explica por qué Dolphin sigue gozando de tanta popularidad en la comunidad local. A menudo es la opción preferida por aquellos usuarios que consideran que los asistentes comerciales con filtros de seguridad son demasiado restrictivos para la ficción, el *roleplay* privado, la experimentación local o la investigación sobre el comportamiento de las indicaciones. Al mismo tiempo, Dolphin no deja de ser un modelo: puede alucinar, seguir directrices deficientes y generar contenidos no aptos para productos públicos si no cuenta con la debida moderación.
Descargas oficiales
| Modelo | Ideal para | Descarga |
|---|---|---|
| Dolphin 3.0 R1 Mistral 24B | La mejor calidad general de la línea clásica Dolphin 3.0; programación, matemáticas, *roleplay* y tareas con agentes. | Hugging Face 24B |
| Dolphin 3.0 Llama 3.1 8B | Pruebas en GPU de consumo, chat local de escritorio, *roleplay* rápido y redacción. | Hugging Face 8B |
| Dolphin 3.0 Llama 3.1 8B GGUF | Uso local con llama.cpp, LM Studio, KoboldCPP o herramientas compatibles con Ollama. | GGUF 8B oficial |
| Dolphin 3.0 R1 Mistral 24B GGUF | Pruebas de modelos cuantizados de 24B para equipos de escritorio y servidores. | GGUF 24B de Bartowski |
| Ollama dolphin3 | Configuración local rápida mediante un único comando para la versión de 8B. | Ollama dolphin3 |
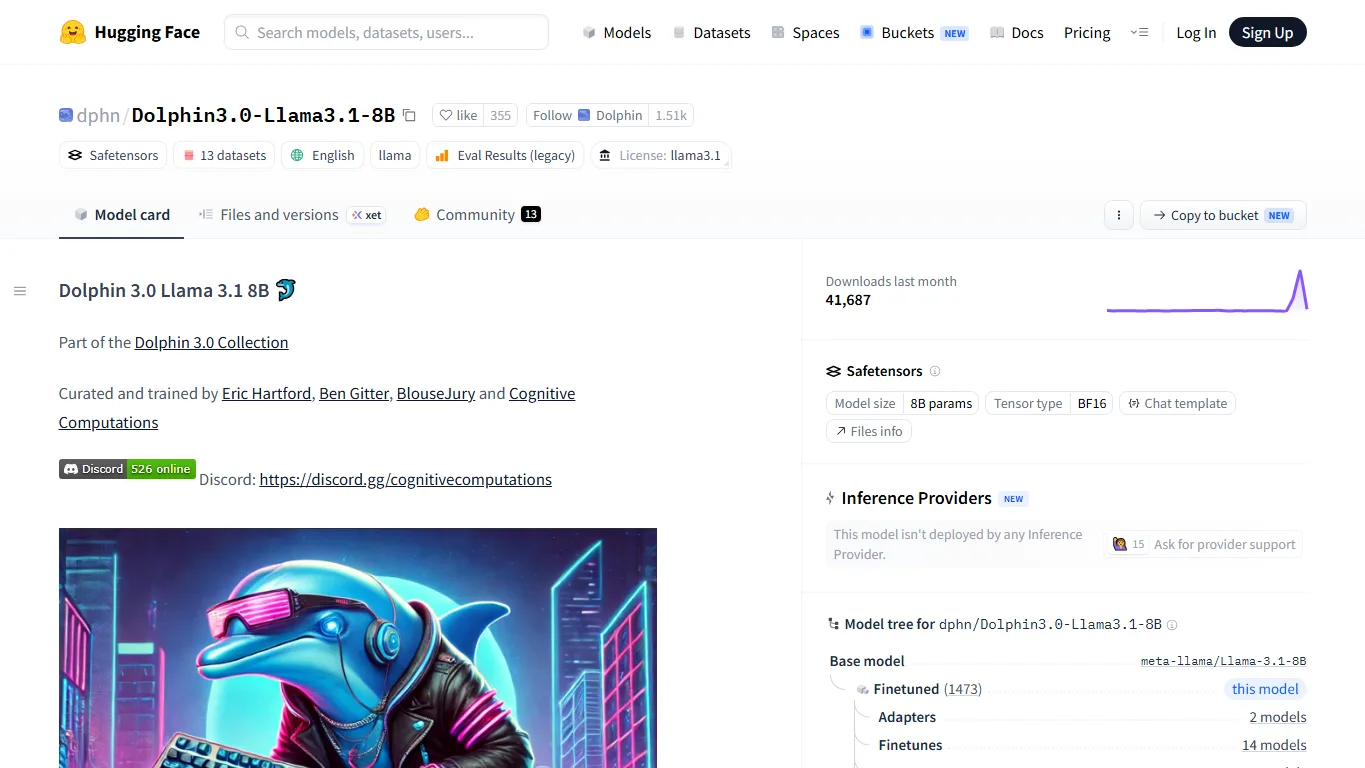
Si te estás iniciando con Dolphin, te recomendamos empezar por la versión de 8B o mediante Ollama. Da el salto al modelo de 24B una vez que domines tus indicaciones, la longitud del contexto y los límites de tu hardware. La variante de 24B resulta más interesante para realizar análisis profundos, pero la de 8B es la que la mayoría de los usuarios puede ejecutar sin tener que actualizar su equipo.
Opiniones de los usuarios y puntos fuertes
El interés de la comunidad por Dolphin suele girar en torno a tres pilares fundamentales: la obediencia a las instrucciones, la estabilidad en la redacción y el *roleplay*, y la reducción de negativas. El modelo no pretende ser el asistente general más seguro posible, sino ofrecer una herramienta local controlable que permita al usuario definir su comportamiento a través del mensaje del sistema.
En comparación con muchos modelos de chat oficiales, Dolphin suele ofrecer respuestas más directas y menos paternalistas. Esto lo convierte en un recurso muy útil para la escritura de ficción, el diálogo entre personajes, la ideación privada, los agentes locales y los asistentes de programación en los que el usuario busca un estricto seguimiento de las pautas. El inconveniente es que exige una mayor disciplina por parte del usuario: si la instrucción es deficiente, el resultado también lo será de manera literal.
Comparativa con otros LLM locales
| Modelo | Comparación con Dolphin 3.0 | ¿Quién debería elegirlo? |
|---|---|---|
| Dolphin 3.0 | El enfoque clásico de modelos ajustados sin censura, con un gran control mediante las directivas del sistema; muy popular para escritura y juegos de rol. | Usuarios que buscan flexibilidad local y menos restricciones. |
| Qwen 3.8 | Un ecosistema multilingüe y de programación más amplio, perteneciente a una familia de modelos más moderna; cuenta con mayores restricciones de seguridad en sus canales oficiales. | Usuarios que necesitan trabajar en japonés, chino o inglés, además de tareas de programación y RAG. |
| Gemma 4 | Una familia de modelos respaldada por Google, con documentación oficial más depurada y un enfoque multimodal; menos inclinado a la ausencia de filtros por defecto. | Usuarios que prefieren pesos abiertos convencionales y documentación de seguridad oficial. |
| Ajustes de Llama 3.1 / Llama 4 | Un ecosistema gigantesco con numerosos derivados sin censura; Dolphin destaca por ser una línea comisariada muy reconocible. | Usuarios que buscan la máxima variedad de modelos comunitarios. |
| Mistral Small 24B | El estilo base que hay detrás de la versión de 24B es competente, pero Dolphin modifica el perfil de seguimiento de instrucciones y de rechazo. | Usuarios que prefieren un modelo de instrucciones más convencional. |
| Modelos Nous / Hermes | También destacan en juegos de rol y seguimiento de instrucciones; por lo general, se comercializan menos explícitamente como modelos sin censura. | Usuarios que comparan la escritura creativa y el comportamiento de los agentes. |
Configuración local
La alternativa más sencilla para la versión de 8B es Ollama. Oculta la mayor parte de los detalles de instalación y resulta idónea para pruebas rápidas de chat, experimentos con directivas y flujos de redacción locales.
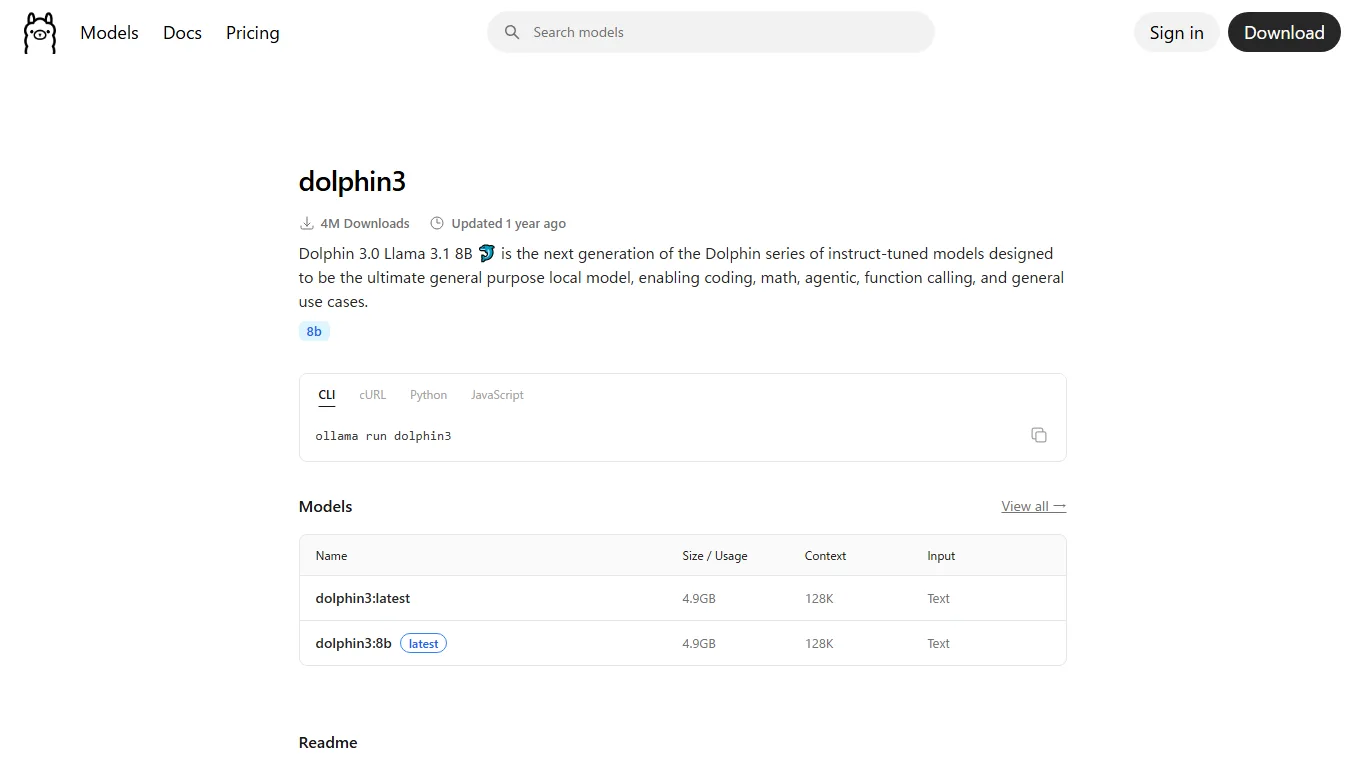
ollama pull dolphin3 ollama run dolphin3Para utilizar archivos GGUF, emplea LM Studio o llama.cpp. Si prefieres el modelo completo Safetensors de 24B, utiliza Transformers o una infraestructura de servicio como vLLM siempre que tu hardware esté preparado.
pip install -U transformers accelerate torch safetensors python - <<'PY' from transformers import AutoModelForCausalLM, AutoTokenizer model_id = "dphn/Dolphin3.0-R1-Mistral-24B" tok = AutoTokenizer.from_pretrained(model_id) model = AutoModelForCausalLM.from_pretrained( model_id, torch_dtype="auto", device_map="auto", ) PYRequisitos de GPU
| Modelo | Estimación en BF16 | Enfoque práctico | Notas |
|---|---|---|---|
| Dolphin 3.0 Mistral 24B | Más de 48 GB para los pesos; cantidad mayor con contextos extensos y caché KV. | Una GPU de 24 GB puede ser viable con compilaciones cuantizadas o GGUF de 4 bits y un contexto más reducido. | Ofrece la máxima calidad, pero no es el modelo local más fácil de manejar. |
| Dolphin 3.0 Llama 3.1 8B | 16 GB o más resultan cómodos para un uso basado en BF16. | Entre 6 GB y 12 GB pueden funcionar utilizando cuantización GGUF. | El modelo más recomendable para empezar en equipos domésticos. |
| GGUF solo por CPU | No requiere memoria VRAM, pero la velocidad es menor. | Utiliza GGUF en Q4 o Q5 con llama.cpp o LM Studio. | Válido para pruebas de escritura, aunque no es el ideal para agentes complejos. |
| API / chat en línea | Sin GPU local. | Utiliza la web de Dolphin, OpenRouter u otro proveedor. | Excelente para evaluar el modelo antes de descargarlo. |
Los requisitos reales de memoria dependen de la cuantización, la longitud del contexto, el tamaño del lote, la caché KV, la descarga en la GPU y el software ejecutor. Para tareas de *roleplay* o escritura con contextos extensos, el consumo de memoria se dispara rápidamente. Si el modelo se carga pero funciona con lentitud o se bloquea, reduce la longitud del contexto antes de dar por sentado que el modelo no sirve.
Uso en línea cuando tu hardware no es suficiente
El portal web oficial de Dolphin es dphn.ai/chat, y la organización de Dolphin en Hugging Face también redirige a los usuarios hacia los canales oficiales del proyecto. Este es el sitio más adecuado para empezar si deseas conocer el proyecto antes de descargar un modelo local.
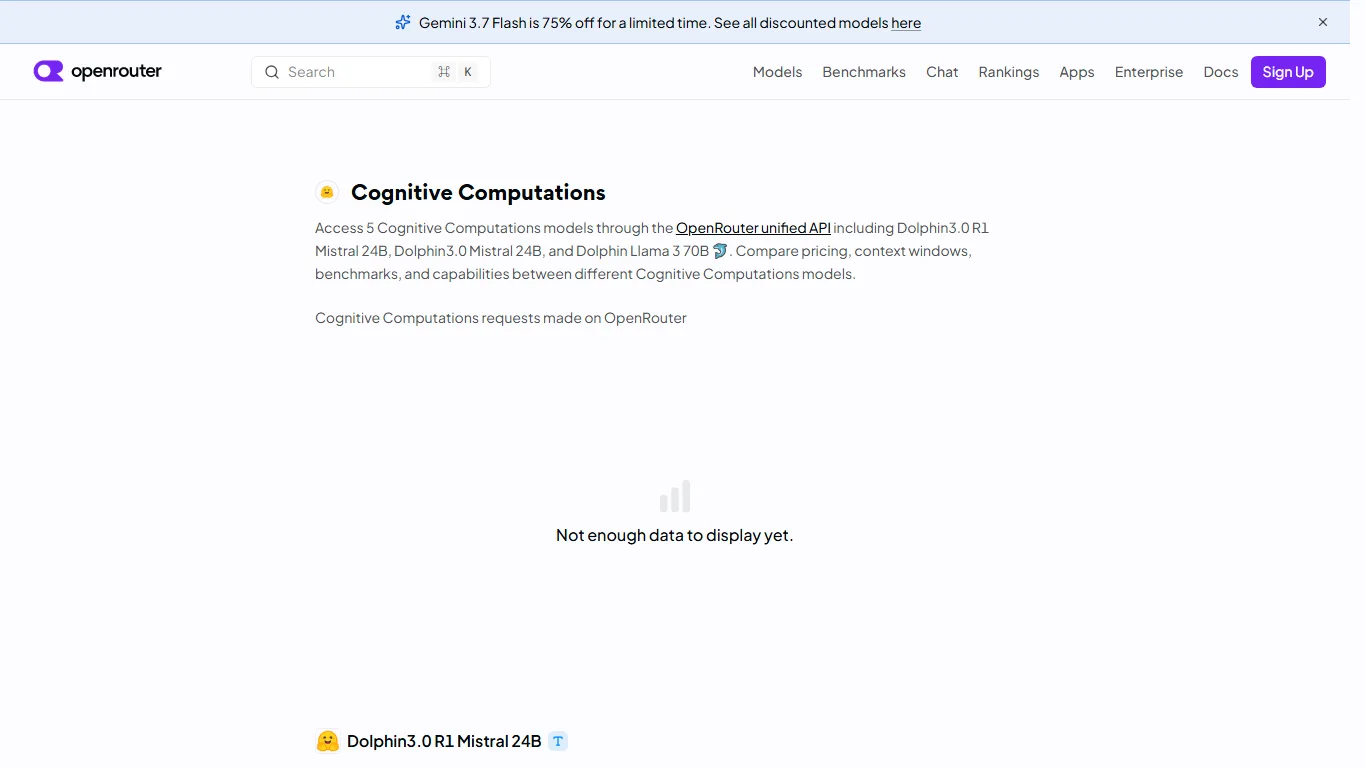
Para realizar pruebas mediante API, la página de Cognitive Computations en OpenRouter resulta de gran utilidad. En ella se listan los modelos de Cognitive Computations y se permite a los desarrolladores comparar precios, ventanas de contexto y capacidades. Venice es otro servicio de chat de IA en línea que suelen valorar los usuarios que priorizan la privacidad y los entornos menos restrictivos, aunque debe considerarse un servicio independiente y no la página oficial de Dolphin.
NSFW y comportamiento sin censura
Dolphin 3.0 es una de las familias de modelos locales sin censura más conocidas. Para un uso privado en local, suele mostrarse mucho más dispuesto a aceptar indicaciones adultas, de juego de rol o de temática delicada en comparación con los asistentes comerciales alojados en la nube. Este es el motivo principal por el que los usuarios buscan Dolphin empleando términos como NSFW, sin censura, *roleplay* y LLM local sin restricciones.
Aun así, que no tenga censura no significa que sea inofensivo o ilimitado. Si se le instruye para ello, Dolphin puede generar contenidos para adultos, sugerencias poco seguras, material sesgado o respuestas delicadas desde el punto de vista legal. El modelo no sustituye de forma automática el diseño de políticas de uso. Si decides implementarlo para terceros, necesitarás establecer tus propias normas, filtros, métodos de registro y protocolos de gestión de abusos. Para uso personal, mantenlo en tu entorno local y asegúrate de comprender las leyes y normativas de tu lugar de residencia.
La mejor perspectiva para entender Dolphin no es verlo como un modelo mágico sin consecuencias, sino como un ajuste local que ofrece un alto grado de control. Es una herramienta excelente cuando quieres que el mensaje del sistema tenga peso real y asumes la responsabilidad de aquello que le pides.
Preguntas frecuentes
¿Dolphin 3.0 no tiene censura de verdad?
Muestra muchas menos negativas que los asistentes comerciales tradicionales y se le reconoce ampliamente dentro de la tradición de los modelos ajustados sin censura. No obstante, el comportamiento final sigue dependiendo de la variante del modelo, la instrucción, el software ejecutor y cualquier capa de moderación adicional que incorpores.
¿Con qué modelo Dolphin 3.0 debería empezar?
Empieza con Dolphin 3.0 Llama 3.1 8B a través de Ollama o GGUF si dispones de un ordenador de sobremesa convencional. Prueba Dolphin 3.0 R1 Mistral 24B cuando busques una mayor calidad y dispongas de suficiente memoria VRAM o de una compilación cuantizada.
¿Puede una RTX 4090 de 24 GB ejecutar el modelo de 24B?
El modelo completo de 24B en BF16 es demasiado grande para funcionar con comodidad en 24 GB, pero los archivos GGUF de 4 bits u otras versiones cuantizadas pueden ser viables si se utiliza un contexto más corto y una configuración ajustada.
¿Dolphin funciona bien en japonés?
Es capaz de responder en japonés, pero no destaca principalmente como un modelo nativo de dicho idioma. Qwen u otros modelos multilingües pueden ofrecer un desempeño superior en la redacción refinada en japonés. El atractivo principal de Dolphin reside en su obediencia a las instrucciones y su comportamiento en juegos de rol sin restricciones.
¿Es seguro utilizar Dolphin en línea?
Los proveedores en línea cuentan con sus propias normas de privacidad, registros, sistemas de moderación y condiciones de servicio. Para indicaciones confidenciales, el uso local es siempre más seguro. Para evaluaciones rápidas, las plataformas en línea resultan cómodas siempre que no subas material de carácter confidencial.
¿Puedo utilizar Dolphin con fines comerciales?
Debes revisar la licencia específica del modelo exacto, así como la del modelo base o la conversión GGUF que vayas a descargar. Las licencias y las condiciones de uso aceptable pueden variar entre los pesos originales, los modelos ajustados y las subidas cuantizadas.
Veredicto
Dolphin 3.0 continúa siendo uno de los exponentes más claros de la línea clásica de modelos locales ajustados sin censura. Es una recomendación fácil cuando el usuario busca escritura creativa, juegos de rol, indicaciones orientadas a agentes, asistencia en programación y una menor cantidad de negativas en comparación con los asistentes de chat convencionales.
El mejor punto de partida es el modelo de 8B mediante Ollama o GGUF. La variante Mistral de 24B se erige como la opción de mayor calidad si dispones de un hardware más potente. Para un uso de carácter NSFW y sin censura, el modelo destaca precisamente porque devuelve el control al usuario, lo que implica a su vez que este debe asumir una mayor responsabilidad sobre sus actos.
References
Relacionados Reseñas
NoobAI XL Review: VRAM, LoRA, V-Pred, Prompts y Uso Local NSFW

Análisis de Nucleus Image: 17B Sparse MoE, configuración local, soporte para NSFW y pesos abiertos bajo licencia Apache 2.0
Reseña de Z-Image: Turbo, Base, VRAM, LoRA y uso local sin censura (NSFW)
Reseña de Illustrious XL: Configuración, LoRA, VRAM, Prompts y uso local sin censura (NSFW)

Anima AI Model Review: Anime Image Model, LoRA, Licencia y Uso NSFW
Análisis de Qwen Image Edit: Edición de texto, Inpainting, ComfyUI y política de NSFW