Los 10 mejores modelos de IA en 2026: ranking Arena, precios y usos
Compara los 10 primeros puestos de Arena en octubre de 2026: Gemini, Claude y Muse, sus precios API, especificaciones, reseñas y dónde utilizarlos.

Gemini 4 Argon encabeza la clasificación general de Text Arena, pero la mejor primera prueba depende del trabajo. Claude Opus 5.5 es un buen punto de partida para programación y documentos exigentes; Gemini 3.8 Flash ofrece las tarifas por token más bajas de este grupo; Muse Wonder merece atención para flujos de agentes prolongados.
Son diez configuraciones clasificadas, no diez marcas de chatbots. Aparecen varias generaciones de Claude y dos entradas de Opus 4.6. Conviene usar la tabla para seleccionar candidatos y decidir después por disponibilidad, coste de completar una tarea y calidad del resultado.
Comprobado el 14 de octubre de 2026. Datos del ranking: 13 de octubre de 2026.
Los 10 primeros puestos de Arena
Seguimos Text → Overall de Arena, no las tablas específicas de código, agentes, imágenes o vídeo. La puntuación refleja preferencias entre respuestas de texto, no un porcentaje de aciertos. Los intervalos se solapan: el rango de posición de Wonder es 1–11, de modo que el segundo puesto no demuestra una ventaja clara sobre el tercero.
Los sufijos high, max y xHigh identifican configuraciones de evaluación, no cantidades de parámetros ni ajustes disponibles en todas las aplicaciones. Las diez entradas son propietarias y las especificaciones oficiales citadas no publican su número de parámetros. Un contexto de 1M indica aproximadamente un millón de tokens de trabajo, no el tamaño del modelo.
| Puesto | Entrada de Arena | Puntuación e incertidumbre | Votos | API: USD por millón de tokens, entrada / salida | Contexto |
|---|---|---|---|---|---|
| 1 | gemini-4-argon-high | 1525 ±9 * | 4,903 | $2 / $10 | 1M |
| 2 | muse-wonder-max | 1513 ±13 | 1,944 | $4 / $20 | 1M |
| 3 | claude-opus-5.5-high | 1508 ±8 | 7,687 | $4 / $20 | 1M |
| 4 | claude-fable-5-high | 1503 ±4 | 41,439 | $10 / $50 | 1M |
| 5 | claude-opus-4-6-high | 1503 ±3 | 80,827 | $5 / $25 | 1M |
| 6 | claude-opus-4-7-high | 1501 ±4 | 65,125 | $5 / $25 | 1M |
| 7 | claude-fable-5.1-max | 1501 ±6 | 14,121 | $10 / $50 | 1M |
| 8 | claude-opus-4-6 | 1498 ±3 | 85,445 | $5 / $25 | 1M |
| 9 | gemini-3.8-flash-high | 1496 ±5 * | 35,670 | $0.75 / $3.75 | 1M |
| 10 | muse-spark-1.2 (xHigh) | 1495 ±7 | 7,611 | $1.25 / $4.25 | N/A |
Tarifas API estándar en dólares estadounidenses por millón de tokens, no cuotas mensuales ni precios locales con impuestos. El razonamiento, la caché, las herramientas y la longitud de salida modifican el total. Argon cuesta $2/$10 hasta el 30 de noviembre de 2026 y $4/$20 después; la tarifa introductoria de Flash termina el 31 de diciembre. * señala una puntuación preliminar; N/A significa que Arena no proporciona ese contexto.
Qué aporta cada modelo
1. Gemini 4 Argon (high) — El líder para trabajo multimodal exigente
Especificaciones clave: Parámetros no publicados; ventana unificada de 1.048.576 tokens; entrada de texto, imágenes, audio, vídeo y PDF, salida de texto. Límite síncrono habitual: 65.536 tokens.
Es candidato para trabajos que combinan documentos, material visual y razonamiento. La entrada, el razonamiento y la salida comparten ventana: no hay un millón de tokens de respuesta adicional a un millón de entrada. La generación larga usa ese mismo presupuesto. Arena evalúa high; la API utiliza medium por defecto.
Desde el 13 de octubre, Google AI Pro y Ultra permiten usar Argon en la aplicación Gemini. También está la API de pago; el anuncio para desarrolladores detalla acceso con Ultra a AI Studio y Antigravity. La suscripción de consumo no incluye API ilimitada.
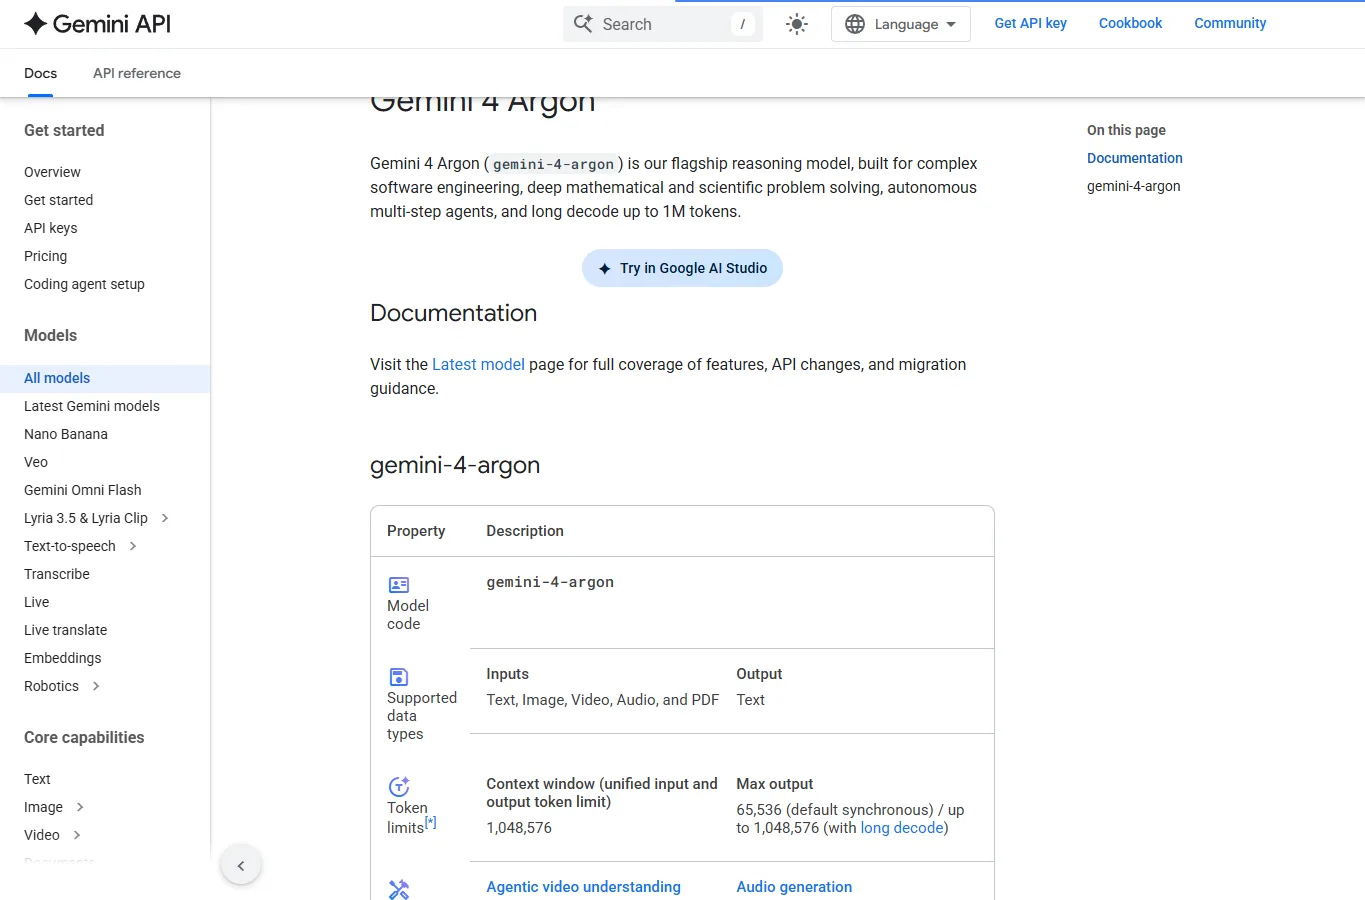
Reseñas y criterio de elección: En su prueba de acceso anticipado, Tim Simmons destacó la persistencia en juegos, edición y escritura, aunque hizo falta una revisión humana final. Es una experiencia concreta, no una garantía de terminar todo con una instrucción. Mide tiempo y consumo antes de usar siempre high.
Información oficial · Uso online / API · API / AI Studio
2. Muse Wonder (max) — Una opción nueva para agentes de larga duración
Especificaciones clave: Parámetros no publicados; contexto de 1M; $4 de entrada / $20 de salida. Esta entrada es Wonder max, no Wonder Full.
Meta destaca la memoria entre conversaciones y la continuidad en tareas largas. Se ofrece en Meta Model API, Muse Code y el playground para desarrolladores. Wonder Full es otro modelo, ligado a planes compatibles de Muse Code; sus resultados no deben atribuirse a esta segunda posición.
Axios cubrió su llegada como nuevo modelo de frontera. En las pruebas de Spring Prompt del 13 de octubre, el análisis de datos suministrados fue sólido, pero hubo problemas de maquetación y afirmaciones comerciales sin respaldo. La mayoría usó Wonder estándar en medium, no max.
Reseñas y criterio de elección: Pruébalo en el entorno de agentes que realmente utilizarás. La memoria y las herramientas conectadas afectan al resultado; la clasificación de texto no evalúa por sí sola todo ese sistema.
Información oficial · Uso online / API · API / Meta
3. Claude Opus 5.5 (high) — Un punto de partida práctico dentro de Claude
Especificaciones clave: Parámetros no publicados; contexto de 1M; salida máxima de 128K; entrada de texto e imágenes; $4 / $20.
Combina programación difícil, investigación y escritura profesional con una tarifa base inferior a los Opus antiguos de la tabla. Su ID API es claude-opus-5-5. Puedes empezar en Claude, trabajar con repositorios en Claude Code o integrar la API de Claude Platform; sus límites no son idénticos.
La cobertura de MacRumors recoge las mejoras anunciadas por Anthropic, no una comparación independiente. DataLLM Lab sí ejecutó nueve tareas pequeñas de Python con éxito, pero modelos más baratos también superaron la prueba. Eso no justifica pagar un modelo insignia para cualquier tarea sencilla.
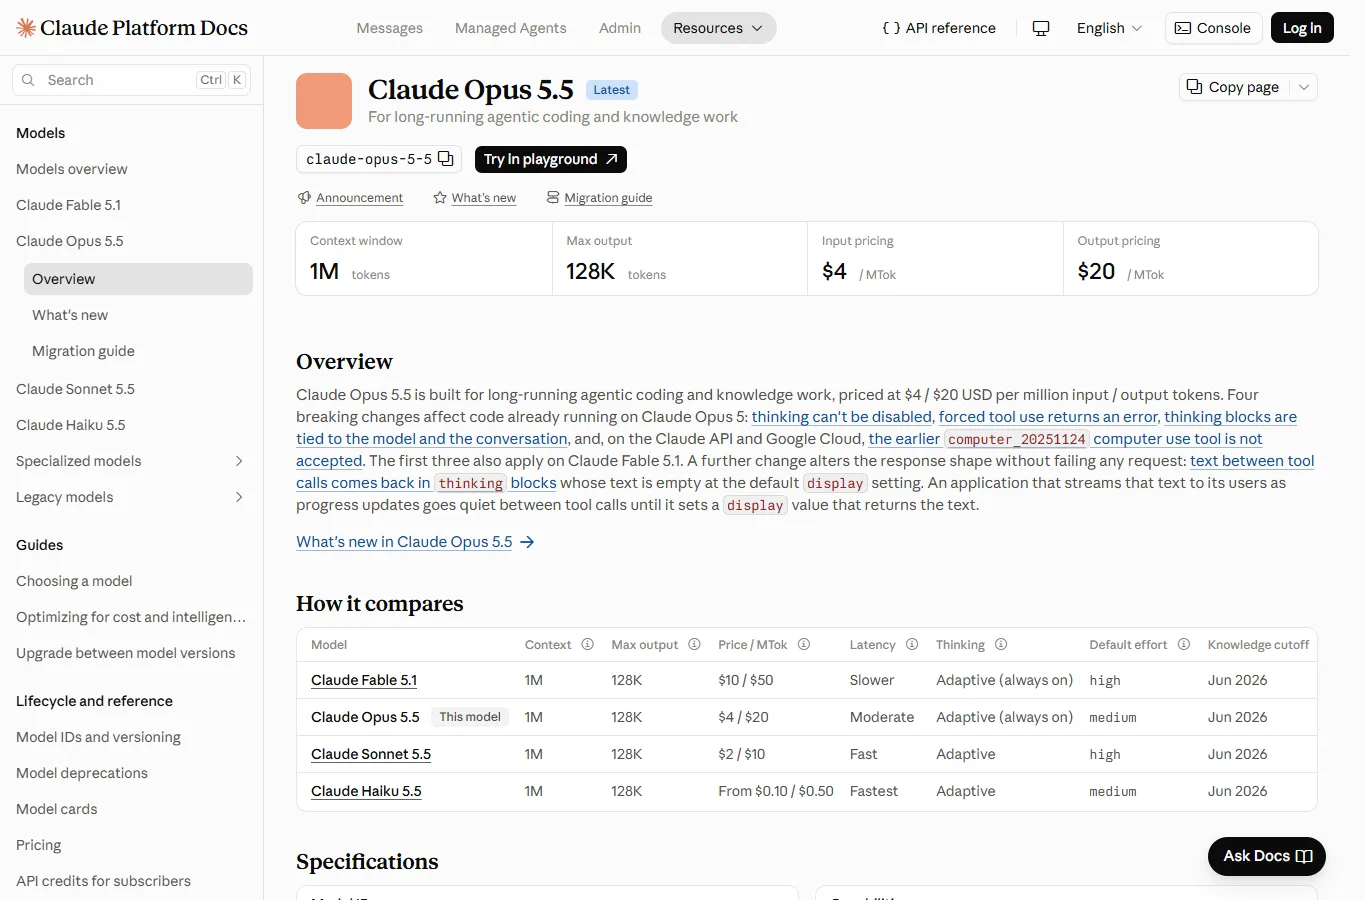
Reseñas y criterio de elección: Para un flujo nuevo con Claude, comienza por 5.5 y compara Flash en los trabajos simples. Una posición parecida de un modelo antiguo no basta para pagar una tarifa mayor.
Información oficial · Uso online / API · API / Claude Platform
4. Claude Fable 5 (high) — Bien clasificado, pero ya no es el Fable más reciente
Especificaciones clave: Parámetros no publicados; contexto de 1M; $10 / $50 por millón de tokens.
Fable 5 prioriza programación sostenida, análisis y comprensión visual. Es la oferta pública con salvaguardas, distinta del acceso restringido a Mythos. Comprueba que la versión antigua siga en el catálogo y en tu plan.
Una experiencia de Tom’s Guide resalta el paso de contestar preguntas a ejecutar proyectos. Para empezar hoy, sin embargo, tiene sentido comparar antes Fable 5.1 y Opus 5.5.
Reseñas y criterio de elección: Especialmente relevante si ya tienes un flujo validado con Fable 5. Ejecuta pruebas de regresión antes de cambiar; no retrocedas de versión solamente por esta posición.
Información oficial · Uso online / API · API / Claude Platform
5. Claude Opus 4.6 (high) — Un modelo anterior con una muestra amplia
Especificaciones clave: Parámetros no publicados; contexto de 1M; salida normal de hasta 128K; $5 / $25.
Esta configuración reúne más de 80.000 votos. Es una muestra mucho mayor que la de algunos recién llegados. La documentación actual lo considera legacy y propone valorar Opus 5.5; el contexto completo de 1M ya se factura a tarifa estándar.
Simon Willison contó en febrero que utilizaba mucho Opus 4.6 en Claude Code. Es una experiencia real de aquel momento, no una recomendación de octubre frente a 5.5. El esfuerzo high puede añadir espera innecesaria en trabajos sencillos.
Reseñas y criterio de elección: Consérvalo si tus instrucciones y pruebas demuestran una ventaja. Para un proyecto nuevo, compara resultados y coste total con 5.5.
Información oficial · Uso online / API · API / Claude Platform
6. Claude Opus 4.7 (high) — Mejoras en código y visión, con matices de facturación
Especificaciones clave: Parámetros no publicados; contexto de 1M; $5 / $25; comprensión de imágenes de mayor resolución que 4.6.
Se centra en ingeniería compleja, seguimiento preciso de instrucciones y verificación de resultados. Puede interesar para interfaces, diagramas y repositorios. Comprueba el ID disponible en la API: la versión predeterminada de la aplicación actual puede ser otra.
Willison midió aproximadamente 1,46 veces más tokens en un texto largo con el nuevo tokenizador; no es un multiplicador universal de la factura. En su comparación de un pelícano SVG prefirió incluso el resultado de un modelo local pequeño: una tarea creativa puede producir otro orden.
Reseñas y criterio de elección: Mide tus documentos, tokens y coste final. Una tarifa idéntica no asegura un gasto idéntico, y una pequeña diferencia de ranking no resume la actualización.
Información oficial · Uso online / API · API / Claude Platform
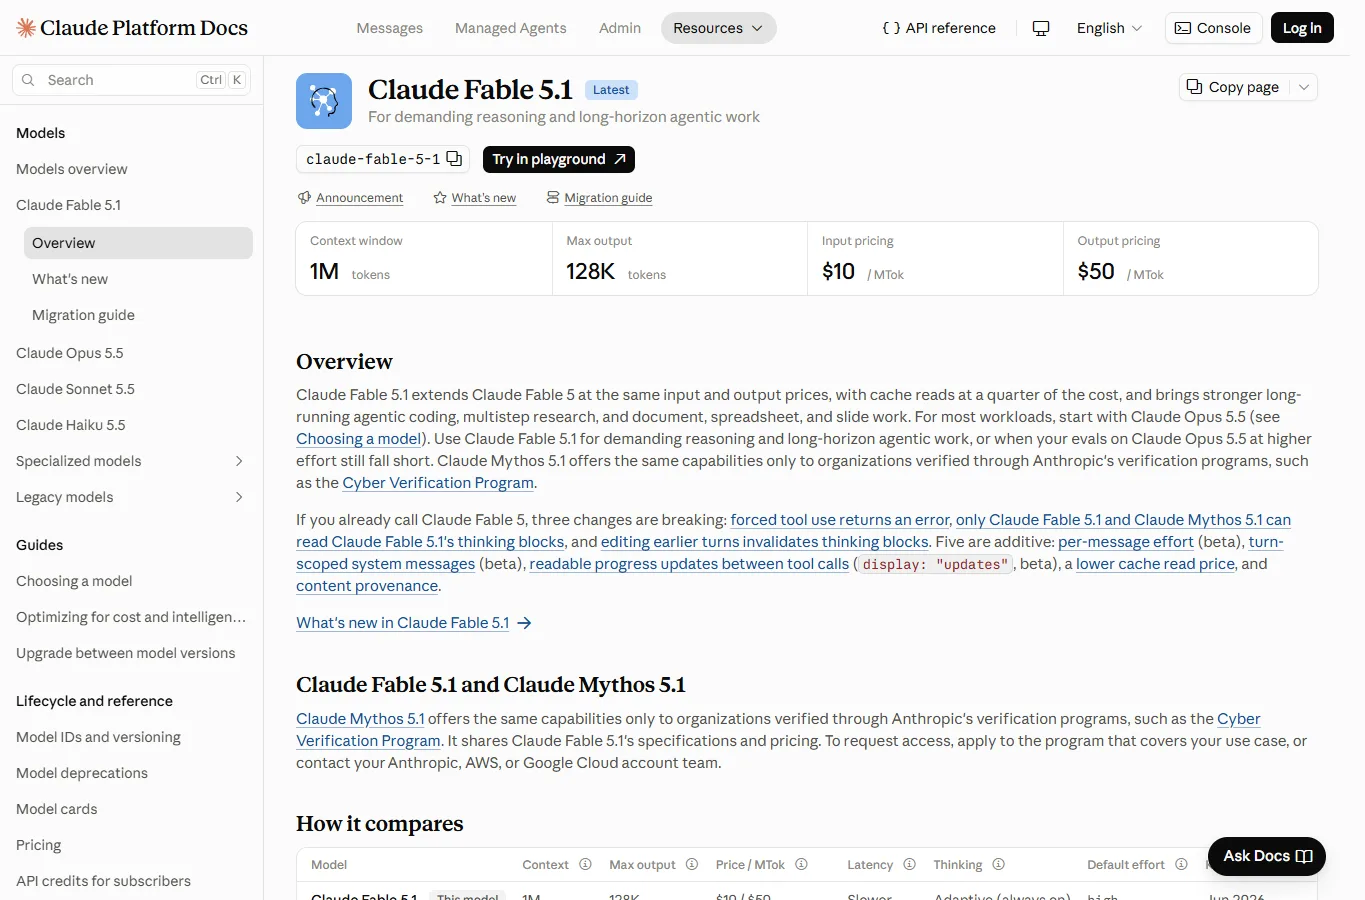
7. Claude Fable 5.1 (max) — Trabajo complejo donde la caché puede importar mucho
Especificaciones clave: Parámetros no publicados; contexto de 1M; salida de 128K; $10 / $50; lectura de caché: $0,25 por millón.
Tiene sentido cuando el análisis, la escritura o los agentes ahorran bastante revisión humana. La rebaja principal está en las lecturas de caché: las tarifas normales de entrada y salida siguen iguales a Fable 5. Las consultas nuevas y cortas no obtienen el mismo ahorro que un contexto largo reutilizado.
Fable 5.1 tiene disponibilidad general, incluida la API de Claude; Mythos 5.1 mantiene acceso restringido. La reseña de No Code MBA y su prueba con un desarrollador plantea si compensa el sobreprecio para crear aplicaciones corrientes.
Reseñas y criterio de elección: Prueba primero una alternativa más barata. El sufijo max de Arena tampoco garantiza que todas las suscripciones permitan reproducir esa configuración.
Información oficial · Uso online / API · API / Claude Platform
8. Claude Opus 4.6 (otra entrada de Arena) — La misma familia, no otro producto
Especificaciones clave: Familia Opus 4.6; parámetros no publicados; contexto de 1M; $5 / $25.
No lleva el sufijo high, pero eso no demuestra que el razonamiento esté desactivado: la fila no explica toda la configuración del ensayo. Está cinco puntos por debajo de la otra entrada de 4.6, con incertidumbre solapada.
Comparte los accesos y las reseñas de familia del puesto cinco. Sirve para pensar en el ajuste de esfuerzo, no para contratar otro servicio. Seleccionar diez familias diferentes requeriría cambiar el criterio del artículo.
Reseñas y criterio de elección: No implica especificaciones ni pruebas independientes de un producto nuevo. Consulta el apartado cinco y la documentación de Opus 4.6.
Información oficial · Uso online / API · API / Claude Platform
9. Gemini 3.8 Flash (high) — La referencia de bajo coste de este grupo
Especificaciones clave: Parámetros no publicados; entrada de 1.048.576 y salida de 65.536 tokens; imágenes, audio, vídeo y PDF; tarifa introductoria $0,75 / $3,75.
Es atractivo para documentos repetitivos y preguntas sobre vídeos. Los accesos son Gemini en los planes incluidos, AI Studio y Gemini API. High no equivale a respuesta instantánea: mide el tiempo hasta terminar, no solo la velocidad de emisión.
Tom’s Guide señala la comprensión nativa de vídeo como diferencia práctica. Es una explicación de capacidades, no una prueba controlada de calidad global. Para clases grabadas o análisis de clips puede importar más que unos puestos en la tabla.
Reseñas y criterio de elección: Empieza con Flash en automatizaciones sensibles al coste y escala los casos difíciles. Tanto la puntuación preliminar como los precios introductorios pueden cambiar.
Información oficial · Uso online / API · API / AI Studio
10. Muse Spark 1.2 (xHigh) — Una versión anterior económica: comprueba cuál estás usando
Especificaciones clave: Parámetros no publicados; contexto N/A en Arena; $1,25 / $4,25. No atribuyas a 1.2 las especificaciones actuales de 1.3.
El anuncio original destaca planificación y programación prolongada en repositorios, con acceso por Muse Code y Meta Model API. La página principal ya promociona 1.3: comprueba si tu proveedor permite seleccionar exactamente 1.2.
En una prueba publicada en Reddit, un desarrollador de servicios de revisión de código destacó velocidad y detección de errores. Es una muestra pequeña y autodeclarada de alguien con un producto relacionado, no prueba de equivalencia general con los modelos insignia.
Reseñas y criterio de elección: Inclúyelo en una comparación de costes si esa versión sigue disponible. No elijas una versión antigua solo por quedar un puesto por encima de 1.3.
Información oficial · Uso online / API · API / Meta
Cuál probar según tu trabajo
Para documentos, audio y vídeo combinados: Argon en los casos difíciles y Flash en tareas repetidas. Para un nuevo entorno Claude: Opus 5.5 primero; Fable 5.1 cuando la calidad adicional reduzca de verdad el trabajo humano.
Para agentes persistentes, evalúa Wonder con las herramientas reales. Si ya usas Opus 4.6/4.7 o Fable 5, comprueba regresiones antes de migrar. Un modelo antiguo puede seguir siendo útil sin ser la mejor compra nueva.
Repite tres pruebas idénticas: una pregunta verificable, un documento o cambio de código real y un texto en español. Anota errores, correcciones, tiempo y coste. Comprueba también el registro y el vocabulario de tu público; una buena reseña en inglés no los garantiza.
Preguntas antes de suscribirte
¿Por qué no aparecen ChatGPT, DeepSeek o Qwen?
Se reproduce el top diez de Text Arena Overall en la fecha indicada. ChatGPT es una aplicación; sus modelos OpenAI están en otras posiciones. No se han reservado plazas por marca y otras categorías darían otra lista.
¿High o max indican el tamaño del modelo?
No, son configuraciones de razonamiento o evaluación. Los parámetros de estos modelos propietarios no están publicados en las especificaciones citadas; contexto, salida y coste sí permiten comparar.
¿Puedo probarlos todos gratis?
No. Arena permite comparar, pero no garantiza acceso libre a todos los modelos, ajustes y herramientas. Suscripciones de chat, playgrounds y API tienen condiciones distintas.
¿Por qué una versión antigua supera a la nueva?
Las preferencias de texto, los prompts, el esfuerzo y las muestras no coinciden con las pruebas de código o agentes. Un pequeño salto de posición con intervalos solapados no demuestra superioridad general.
¿Cuál resulta más barato?
Flash tiene las menores tarifas base aquí, pero razonamiento, reintentos, caché y longitud cambian la factura. Compara tareas completadas correctamente, no solo el precio de entrada.
¿Se pueden descargar para usarlos sin conexión?
Son modelos propietarios alojados, no pesos descargables para ejecución local. Si necesitas trabajar sin conexión, busca otro grupo de modelos abiertos; para servicios online revisa sus controles de datos.
Empieza comparando dos modelos
Compara primero Opus 5.5 con Argon en calidad y usa Flash como referencia económica. Añade Wonder si los agentes son centrales; los Claude y Spark anteriores sirven sobre todo para contrastar flujos existentes.
Quédate con el modelo que entregue un resultado correcto y útil con menos correcciones costosas. Arena orienta la selección; tu propio trabajo terminado decide.
Relacionado: modelos locales y chatbots: LLM locales · Chatbots de IA
Relacionados Reseñas
Review de Ideogram 4.0: texto, ComfyUI, límites de censura y NSFW

GPT-Image-2.5: análisis 2026 de Flare, Sunburst, precios y NSFW

Kling 4.0: análisis, precios, fotogramas clave y límites NSFW
MiniMax H3 Image Studio: análisis, edición en ComfyUI e imágenes para vídeo
Review de Wan 3.0: video IA de 30 s, estado open source y límites NSFW

Análisis de Krea 3: edición, Ultra, costes reales y uso local