Mejores LLM locales de código abierto en 2026: rendimiento, NSFW y comparativa de hardware
El mejor LLM local ya no es necesariamente el modelo con más parámetros. En 2026, la pregunta clave es mucho más concreta: ¿qué modelo de…

El mejor LLM local ya no es necesariamente el modelo con más parámetros. En 2026, la pregunta clave es mucho más concreta: ¿qué modelo de código abierto u open-weight ofrece el equilibrio adecuado entre calidad, flexibilidad para contenido NSFW, costes de hardware, licencias y control local?
Para la mayoría de los usuarios, la lista de opciones prácticas es reducida. Elige Qwen 3.8 para tareas multilingües, programación y RAG; Gemma 4 si buscas un modelo con pesos abiertos de Google y una documentación sólida; Dolphin 3.0 cuando la flexibilidad en rol o contenido NSFW con pocas restricciones sea una prioridad; y DeepSeek V4 si estás evaluando cargas de trabajo de contexto largo, agentes o entornos empresariales en lugar de un modelo de chat convencional para el escritorio.
Contenido
Recomendación rápida
| Necesidad | Mejor opción | Por qué destaca |
|---|---|---|
| El mejor LLM local todoterreno para multilingüe y programación | Qwen 3.8 27B | Gran rendimiento multilingüe, en programación y uso de herramientas, con una versión de 27B muy práctica para usuarios avanzados en local. |
| Ecosistema de Google y documentación de seguridad clara | Gemma 4 | Ficha técnica detallada, documentación oficial, varios tamaños y una alineación oficial más segura. |
| Contenido NSFW, rol y escritura sin restricciones | Dolphin 3.0 | Una línea clásica de ajustes sin censura diseñada para el control mediante el prompt del sistema y un menor número de negativas. |
| Evaluación a escala empresarial y contexto largo | DeepSeek V4 | Pesos abiertos, soporte para un millón de tokens y opciones Pro/Flash, aunque exige mucho hardware. |
| El mayor ecosistema de modelos ajustados (fine-tunes) | Llama 4 / Familia Llama | Gran comunidad, variantes GGUF y derivados orientados a rol o sin censura. |
| MoE de pesos abiertos para servidores exigentes | Mistral Large 3 | Una sólida alternativa europea de pesos abiertos, pero fuera del alcance de un ordenador de sobremesa convencional. |
| Modelo enfocado en agentes y uso de herramientas | Kimi K2 / Kimi K2 Thinking | Interesante para agentes de programación y flujos de trabajo con herramientas, no tanto para contenido NSFW. |
| Programación con contexto largo y tareas de agentes | GLM-4.6 | Una gran opción cuando un contexto de 200K y la programación mediante agentes priman sobre el comportamiento sin censura. |
Rendimiento
Los benchmarks son útiles, pero la elección de un LLM local debe partir siempre de tu carga de trabajo. Tareas como la programación, la redacción en japonés, chino o inglés, el RAG con contexto largo, el rol y los flujos con agentes suelen posicionar de forma distinta a un mismo modelo. Un modelo pequeño con una buena cuantización puede superar a uno más grande si cabe en tu GPU y responde con mayor rapidez.
Las tablas de clasificación públicas como Artificial Analysis y LMArena sirven como referencia general, pero no sustituyen a las pruebas prácticas en local. Por ejemplo, un modelo con excelentes puntuaciones en chat general puede flojear con tus documentos privados, llamadas a herramientas, control de tono en japonés o redacción creativa NSFW.
| Modelo | Perfil de rendimiento | Principal inconveniente |
|---|---|---|
| Qwen 3.8 | La opción más equilibrada para tareas multilingües, programación y uso local práctico. | Los modelos oficiales no están diseñados como herramientas NSFW sin censura. |
| Gemma 4 | Línea con pesos abiertos y buena documentación, disponible en tamaños de 12B, 26B y 31B. | Puede resultar más restrictiva en términos de seguridad y menos flexible que los ajustes sin censura. |
| Dolphin 3.0 | Excelente obediencia a las instrucciones del sistema, redacción y juegos de rol. | Menor enfoque en benchmarks; requiere disciplina de seguridad por parte del usuario. |
| DeepSeek V4 | Interesante para contexto largo, agentes y despliegues a gran escala. | No resulta cómodo para un equipo de escritorio con una sola GPU. |
| Llama 4 / Familia Llama | El mayor ecosistema de la comunidad para ajustes, compilaciones GGUF y experimentación local. | Las versiones oficiales no priorizan el contenido NSFW; la calidad depende mucho del ajuste elegido. |
| Mistral Large 3 | Modelo MoE de pesos abiertos con un techo muy elevado para despliegues en servidores. | Las versiones de clase 675B no son viables para equipos domésticos. |
| Kimi K2 Thinking | Muy adecuado para agentes de programación, llamadas a herramientas y tareas complejas de varios pasos. | Está más orientado a agentes que a la creación de roles o contenido NSFW. |
| GLM-4.6 | Mejoras en contexto largo, programación y agentes, con distribución accesible de modelos abiertos. | Menos conocido a nivel global que Llama o Qwen, pero merece la pena probarlo en flujos de programación. |
Comportamiento NSFW y sin censura
El ámbito del contenido NSFW es donde los LLM locales marcan una mayor diferencia respecto a los asistentes en la nube. Los modelos alojados suelen incorporar moderación en la plataforma, mientras que los modelos locales de pesos abiertos permiten al usuario elegir el motor, el prompt del sistema y los filtros adicionales. No obstante, esto no significa que todos los modelos locales carezcan de restricciones por igual.
Dolphin 3.0 destaca claramente como la opción más afín al contenido NSFW en este grupo. Pertenece a la tradición clásica de ajustes sin censura y goza de gran popularidad para juegos de rol privados, ficción, escritura para adultos y experimentos de control mediante prompts. Su gran ventaja radica en que transfiere una mayor responsabilidad al usuario.
Qwen 3.8 y Gemma 4 cuentan con versiones oficiales alineadas con políticas de seguridad, aunque la comunidad también crea derivados modificados o sin censura. Estas variantes pueden reducir las negativas, pero no son versiones oficiales y deben considerarse modelos independientes sujetos a sus propias comprobaciones de confianza y licencia. Por su parte, DeepSeek V4 se orienta mejor hacia tareas de contexto largo o agentes antes que al contenido NSFW.
Requisitos de hardware y VRAM
El error más común al trabajar con LLM locales es descargar el modelo que mejor pinta sobre el papel para luego descubrir que funciona con extrema lentitud en tu equipo. La VRAM, la cuantización, la longitud del contexto y la caché KV son tan importantes como el tamaño del modelo.
Análisis modelo por modelo
Qwen 3.8: La mejor opción local equilibrada
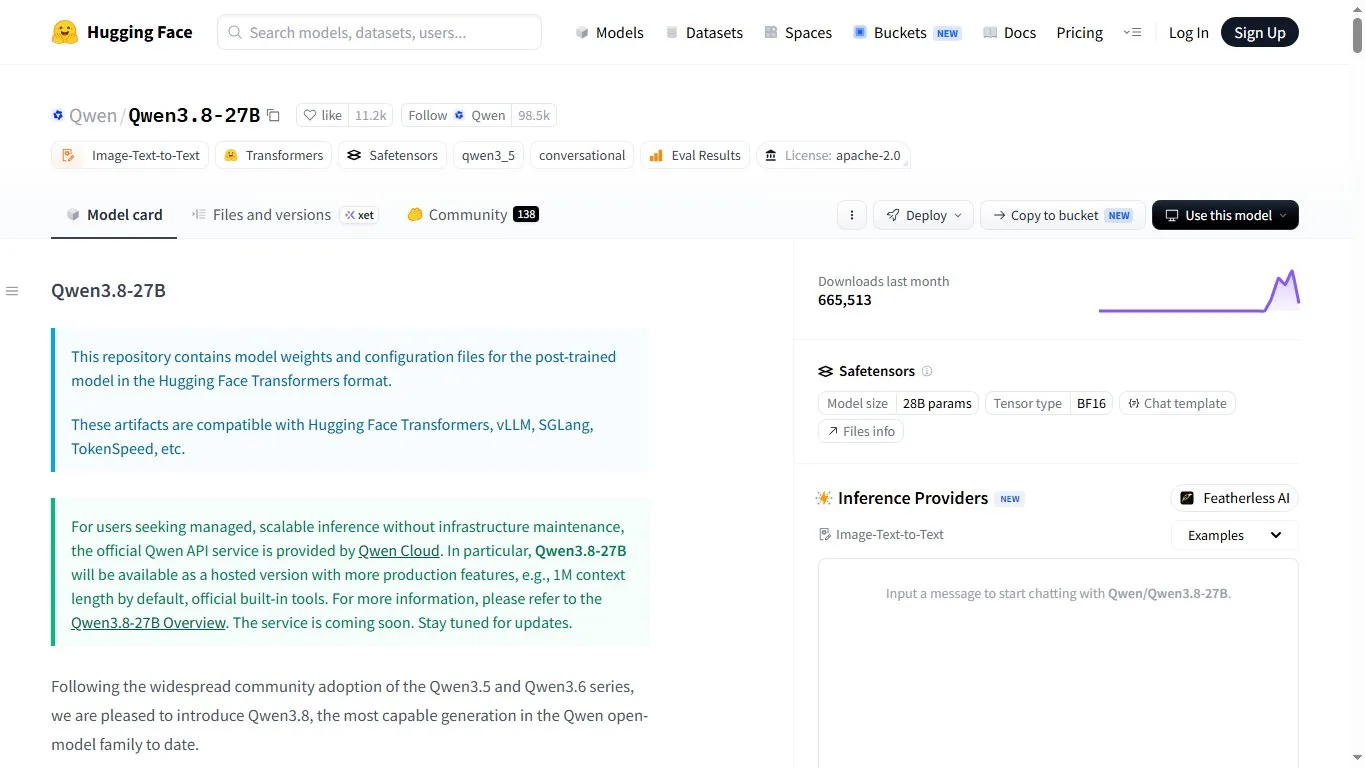
Qwen 3.8 es la familia de modelos con la que empezaría para tareas multilingües, programación, RAG y asistencia local diaria. La variante de 27B resulta mucho más realista que la enorme rama Max, a la vez que ofrece una capacidad muy superior a la de los modelos pequeños de 7B u 8B.
Su punto débil no es la calidad, sino su propósito. Los modelos oficiales de Qwen no están concebidos como herramientas NSFW sin censura. Si tu objetivo principal es reducir las negativas en juegos de rol para adultos, Qwen no es la primera opción a menos que selecciones y pruebes deliberadamente una versión modificada por la comunidad.
Gemma 4: Excelente documentación y ecosistema de Google
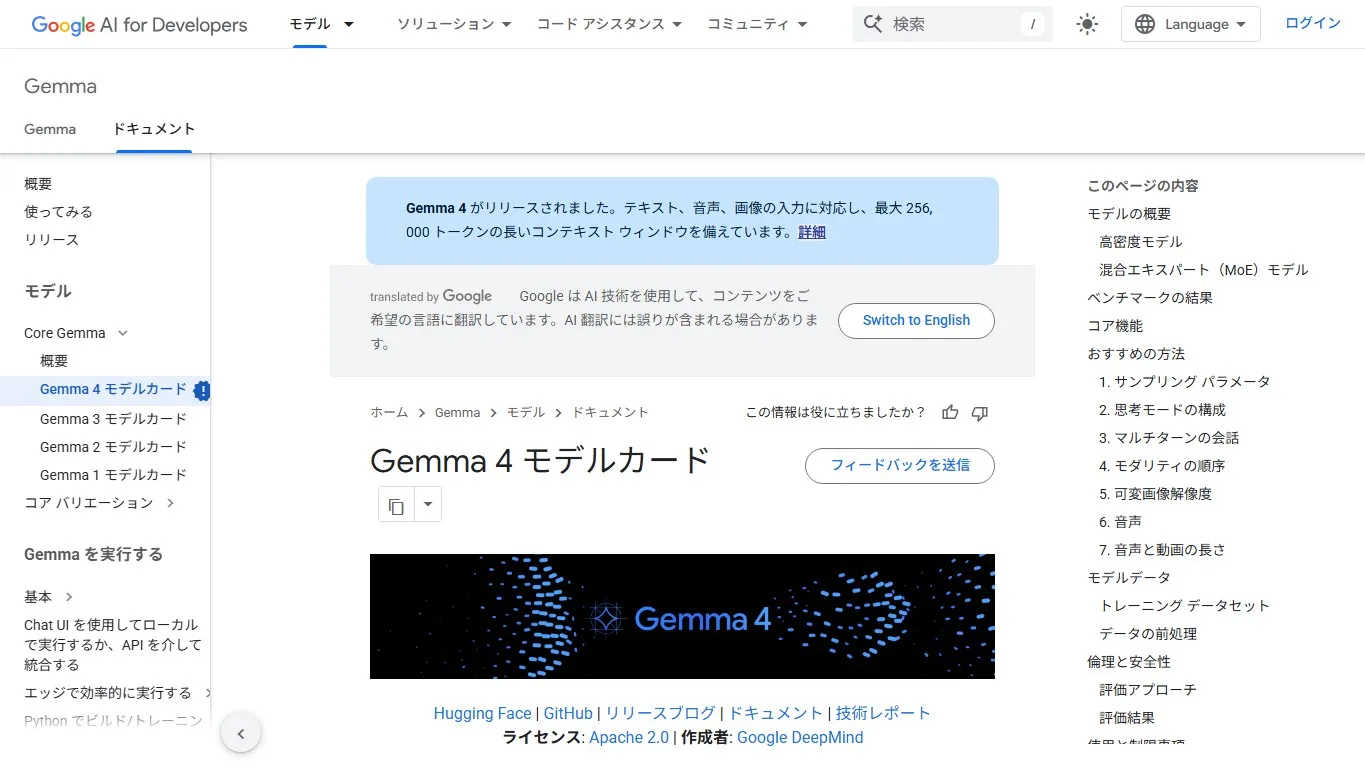
Gemma 4 resulta muy atractiva cuando buscas pesos abiertos, documentación oficial y una familia de modelos limpia. La versión de 12B es la más accesible para empezar, mientras que las de 26B-A4B y 31B representan opciones de mayor calidad para hardware más potente.
En el ámbito NSFW, Gemma 4 adopta un enfoque más conservador en su versión oficial. La existencia de modelos alternativos creados por la comunidad añade interés al ecosistema, pero no deben confundirse con la postura de seguridad o alineación oficial de Google.
Dolphin 3.0: La mejor opción para rol y contenido NSFW sin censura
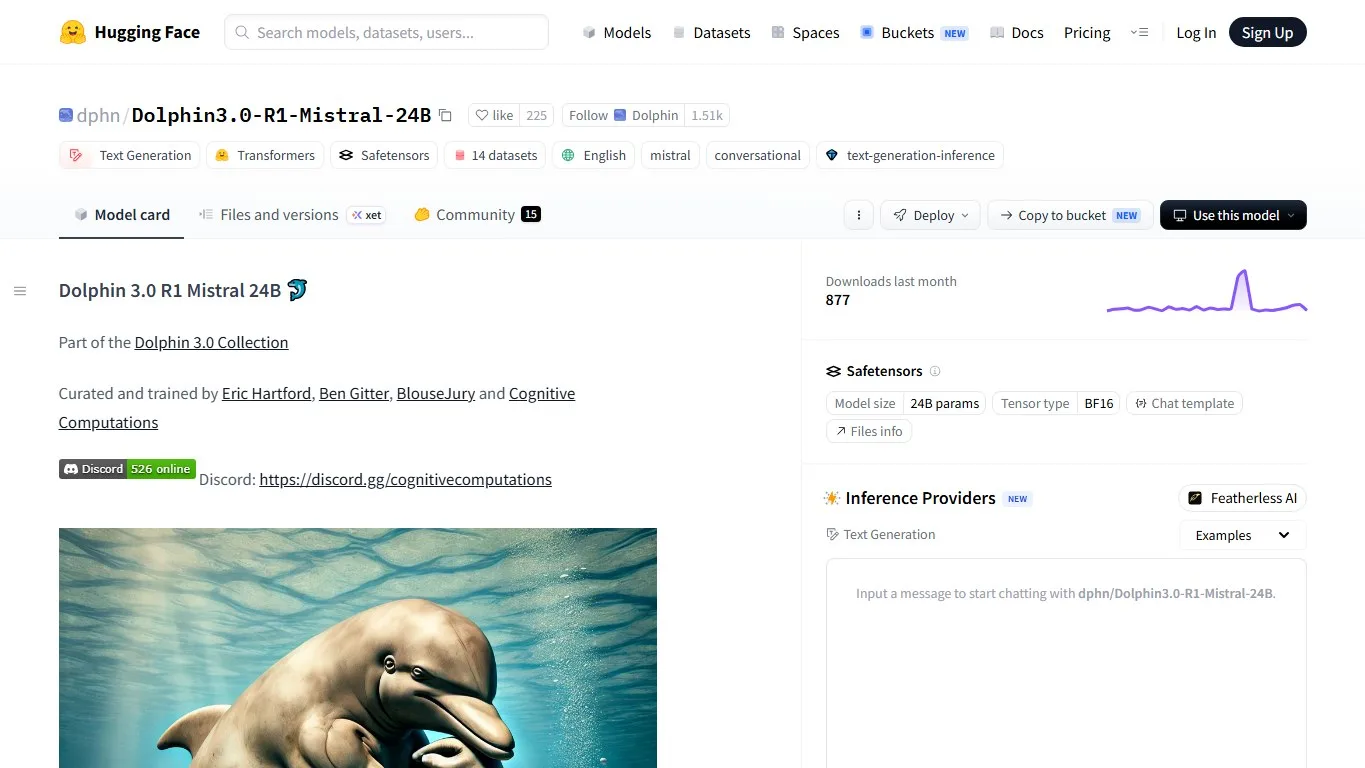
Dolphin 3.0 sigue siendo la recomendación más directa cuando el objetivo de búsqueda incluye contenido sin censura, NSFW, rol o escritura con pocas negativas. No pretende ser el asistente general más seguro, sino un modelo local controlable donde el propietario del sistema decide su comportamiento.
Empieza con la versión de 8B o mediante GGUF si utilizas un ordenador de sobremesa convencional. Da el salto a Mistral 24B si buscas una mejor redacción y razonamiento y tu hardware te lo permite. Para despliegues públicos, asegúrate de añadir tus propias reglas de moderación y uso.
DeepSeek V4: Potente pero exigente
DeepSeek V4 impresiona técnicamente y merece la pena seguirle la pista, especialmente para tareas de contexto largo, agentes y entornos de servidor. La división entre las versiones Pro y Flash resulta útil porque permite a los equipos decidir entre una mayor calidad de salida o un rendimiento más económico.
Para el usuario local medio, el obstáculo es el hardware. DeepSeek V4 no es el modelo cómodo para una sola GPU. Está pensado para equipos capaces de gestionar servidores con vLLM o SGLang, controlar costes y evaluar su rendimiento frente a cargas de trabajo reales.
Llama 4 y sus variantes: El ecosistema más amplio
La familia Llama sigue siendo imposible de ignorar. Llama 4 Scout y Maverick han impulsado los modelos abiertos de Meta hacia el terreno multimodal y MoE, mientras que su ecosistema general sigue ofreciendo el acceso más sencillo a compilaciones GGUF, adaptaciones para rol, variantes de programación y guías de despliegue.
El inconveniente es que Llama no se reduce a un solo modelo. Una versión oficial básica, un ajuste para programación, un modelo adaptado para rol y un derivado sin censura pueden comportarse de forma totalmente distinta. Para quienes buscan la máxima capacidad de elección, Llama es excelente; para quienes prefieren una recomendación clara, Qwen o Gemma pueden resultar menos confusos.
Mistral Large 3: Pesos abiertos para infraestructuras exigentes
Mistral Large 3 destaca por representar una ambición diferente dentro del código abierto. Se trata de un modelo MoE de gran tamaño orientado a despliegues abiertos de vanguardia, con requisitos de infraestructura muy superiores a los de un modelo de escritorio de 12B o 27B.
Para un usuario individual, rara vez será la primera descarga local. En cambio, para un equipo con GPUs de servidor, encaja perfectamente junto a DeepSeek V4 y otros modelos MoE de gran tamaño. Su comportamiento con contenido NSFW debe evaluarse a partir del punto de control exacto, la capa del proveedor y la política de despliegue, y no únicamente por el nombre del modelo.
Kimi K2: Especialista en agentes y herramientas
Kimi K2 Thinking resulta interesante para quienes priorizan el uso de herramientas, agentes de programación y flujos complejos de varios pasos. No es la opción evidente para un chat de escritorio sencillo, pero cobra gran valor al desarrollar sistemas de agentes o evaluar la ejecución de tareas complejas.
A diferencia de Dolphin, Kimi no está pensado principalmente para juegos de rol sin censura. Frente a Qwen, se posiciona más como un competidor especializado en agentes y código. Si desarrollas agentes de programación, navegadores autónomos o automatización de flujos, merece una prueba específica en lugar de evaluarse únicamente mediante puntuaciones de chat general.
GLM-4.6: Una alternativa para contexto largo y programación
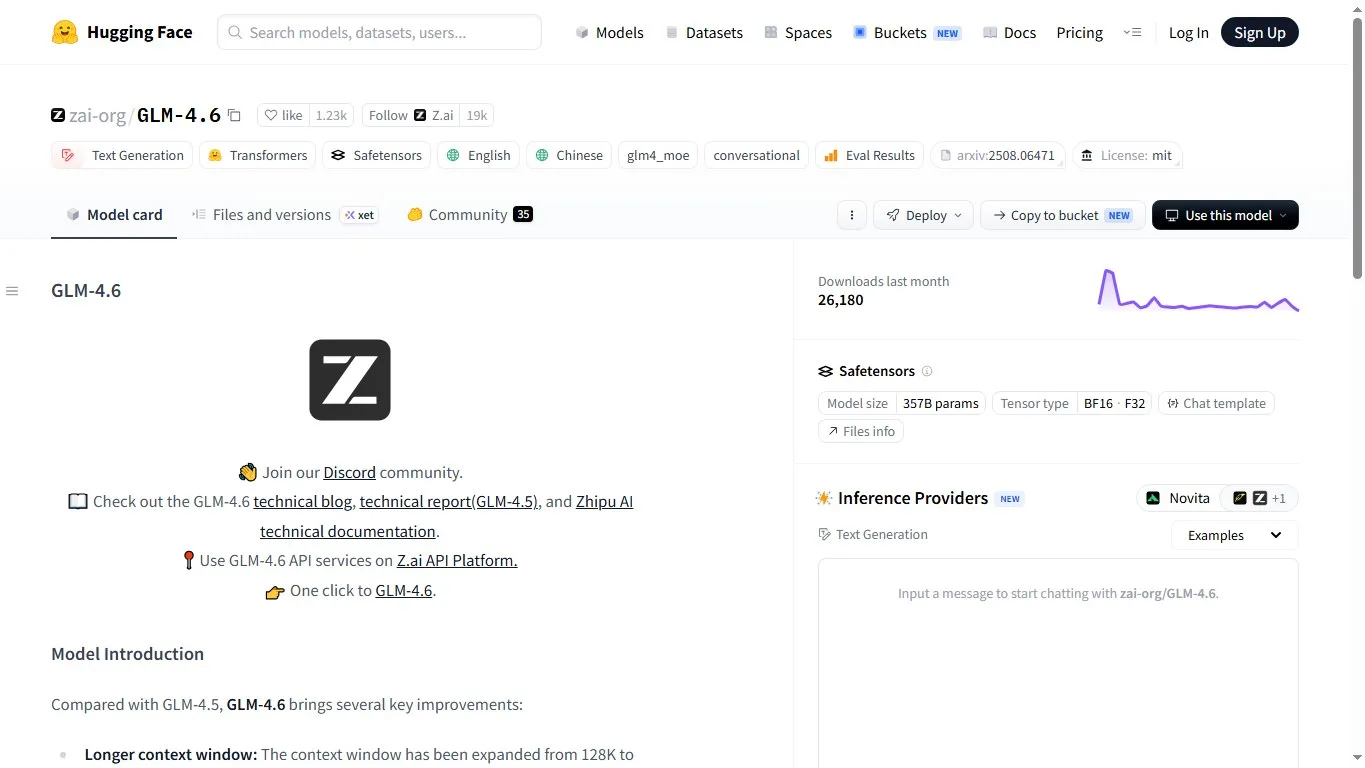
GLM-4.6 es otra línea de modelos que conviene incluir en cualquier comparativa de 2026. Aunque no resulte tan familiar para el público occidental como Llama o Mistral, es muy relevante para tareas de contexto largo, programación y agentes, especialmente para quienes ya comparan ecosistemas de modelos abiertos de origen chino.
Su función práctica se asemeja a la de Kimi y Qwen: pruébalo con tus propias tareas de código, multilingües y de gestión de documentos. No lo elijas únicamente por un buen resultado en los benchmarks; hazlo si gestiona tu longitud de contexto real, las llamadas a herramientas y tu pila de servidores locales mejor que las alternativas.
Cómo elegir
- Empieza por definir tu tarea principal: programación, redacción, RAG, rol, documentos extensos o agentes.
- Elige el modelo más grande que funcione con suficiente fluidez en tu hardware, no el de mayor tamaño que seas capaz de cargar técnicamente.
- Utiliza GGUF o cuantización de 4 bits para realizar pruebas en el escritorio, y recurre a BF16 o servidores dedicados solo cuando sea estrictamente necesario.
- Para contenido NSFW o escritura creativa sin restricciones, evalúa los modelos basados en Dolphin y las adaptaciones de Llama por separado de los modelos oficiales alineados con la seguridad.
- En entornos comerciales, comprueba con atención la licencia, los términos del modelo base y si se permite el uso de adaptaciones comunitarias.
Preguntas frecuentes
¿Cuál es el mejor LLM local de código abierto en general?
Para la mayoría de los usuarios avanzados en local, Qwen 3.8 27B ofrece el mejor punto de partida equilibrado gracias a sus capacidades multilingües, su rendimiento en programación y sus opciones de despliegue práctico. Si tu prioridad son los juegos de rol NSFW, Dolphin 3.0 se adapta mejor a tus necesidades.
¿Qué modelo debo ejecutar en una tarjeta RTX 4090 de 24 GB?
Puedes utilizar Qwen 27B, Gemma 31B/26B, Dolphin 24B o modelos similares en formato cuantizado. Si prefieres mayor velocidad y un contexto más amplio, puedes optar por versiones de 12B u 8B. Un modelo que funcione con soltura suele ser mucho más útil que uno que apenas quepa en la memoria.
¿Son seguros los LLM de código abierto para un uso comercial?
Pueden serlo, pero únicamente tras verificar las licencias, diseñar una estrategia de privacidad adecuada, definir políticas de registro y revisar las salidas del modelo. Los pesos abiertos no garantizan el cumplimiento normativo de forma automática. Para documentos sensibles, el despliegue local mejora la privacidad, pero la organización sigue necesitando una gobernanza adecuada.
¿Qué LLM local es mejor para contenido NSFW?
Dolphin 3.0 es la opción más clara entre los modelos analizados aquí. Qwen y Gemma cuentan con variantes sin censura creadas por la comunidad, pero sus versiones oficiales no están diseñadas principalmente para contenido NSFW.
¿Debo usar Ollama, LM Studio, vLLM o SGLang?
Ollama y LM Studio resultan ideales para realizar pruebas rápidas en el escritorio. En cambio, vLLM y las herramientas basadas en SGLang son más adecuadas para servidores API, procesamiento por lotes, experimentos con contextos largos y uso en equipo.
Verdict
No existe un único mejor LLM local de código abierto para todo el mundo. Qwen 3.8 destaca como la opción polivalente más práctica; Gemma 4 representa la línea de pesos abiertos más limpia respaldada por Google; Dolphin 3.0 es la mejor alternativa para contenido NSFW y rol sin censura; DeepSeek V4 y Mistral Large 3 se posicionan como soluciones sólidas a nivel de servidor; y Llama, Kimi y GLM aportan una gran profundidad en cuanto a ecosistemas, agentes y gestión de contextos largos.
La estrategia más inteligente resulta previsible pero efectiva: empieza con un modelo cuantizado que se ajuste a tu GPU, pruébalo con tus prompts reales, compara su comportamiento ante negativas, la estabilidad del contexto y la latencia, y asciende a modelos mayores solo cuando el más pequeño se quede corto. La IA local se vuelve realmente útil en el momento en que funciona con la suficiente agilidad para usarla a diario.
Referencias
Relacionados Reseñas
Reseña de Illustrious XL: Configuración, LoRA, VRAM, Prompts y uso local sin censura (NSFW)

Análisis de Mistral AI: modelos locales, Large 3, Small 4 y política NSFW
FLUX 3 Review: Vídeo, imagen, pesos abiertos y política NSFW
Reseña de Grok 4.6: razonamiento, agentes, precio y política NSFW

Análisis de Llama 4: Scout, Maverick, Behemoth, despliegue local y política NSFW
Análisis de Qwen Image Edit: Edición de texto, Inpainting, ComfyUI y política de NSFW
