Review de Qwen 3.8: rendimiento, instalación local, requisitos de GPU y política NSFW
Qwen 3.8 se entiende mejor como dos líneas relacionadas: Qwen3.8-2.4T-A95B / Max para inferencia a gran escala, y Qwen3.8-27B para usuarios que quieren probar un…

Qwen 3.8 se entiende mejor como dos líneas relacionadas: Qwen3.8-2.4T-A95B / Max para inferencia a gran escala, y Qwen3.8-27B para usuarios que quieren probar un LLM potente en entornos locales o de pequeña escala. El primero apunta al techo de rendimiento; el segundo es el punto de partida más práctico.
Si te interesan la instalación local, los requisitos de GPU, los enlaces de descarga, el uso comercial y la política NSFW, no basta con mirar un benchmark. Las versiones de Qwen 3.8 cambian mucho en tamaño, licencia, coste de ejecución y comportamiento entre servicio online y pesos descargables.
Índice
- Qué es Qwen 3.8
- Versiones del modelo y descargas
- Rendimiento y experiencia real
- Comparación con LLM locales populares
- Instalación local
- Requisitos de GPU y VRAM
- Uso online si tu hardware no alcanza
- Política NSFW y límites
- Qwen3.8-27B Uncensored / Abliterated
- Preguntas frecuentes
- Conclusión
- Información de referencia
Qué es Qwen 3.8
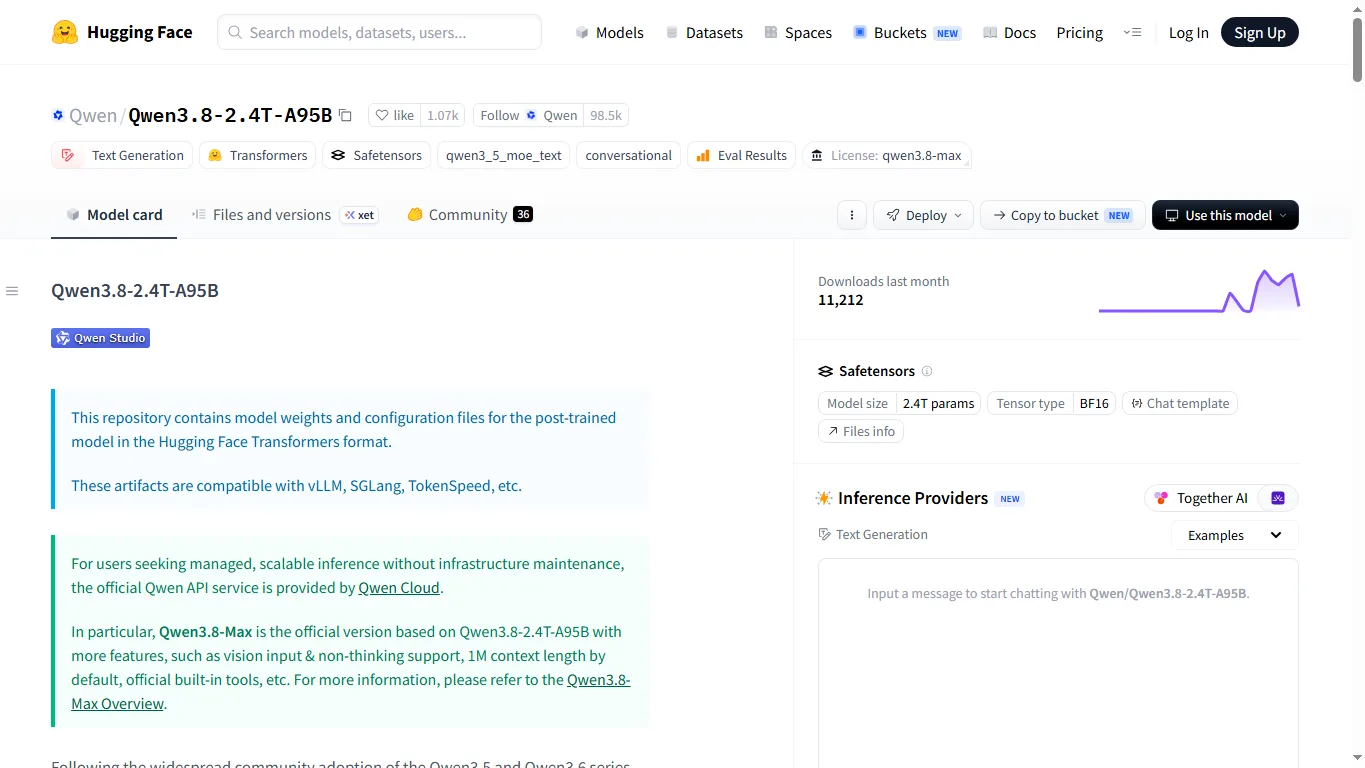
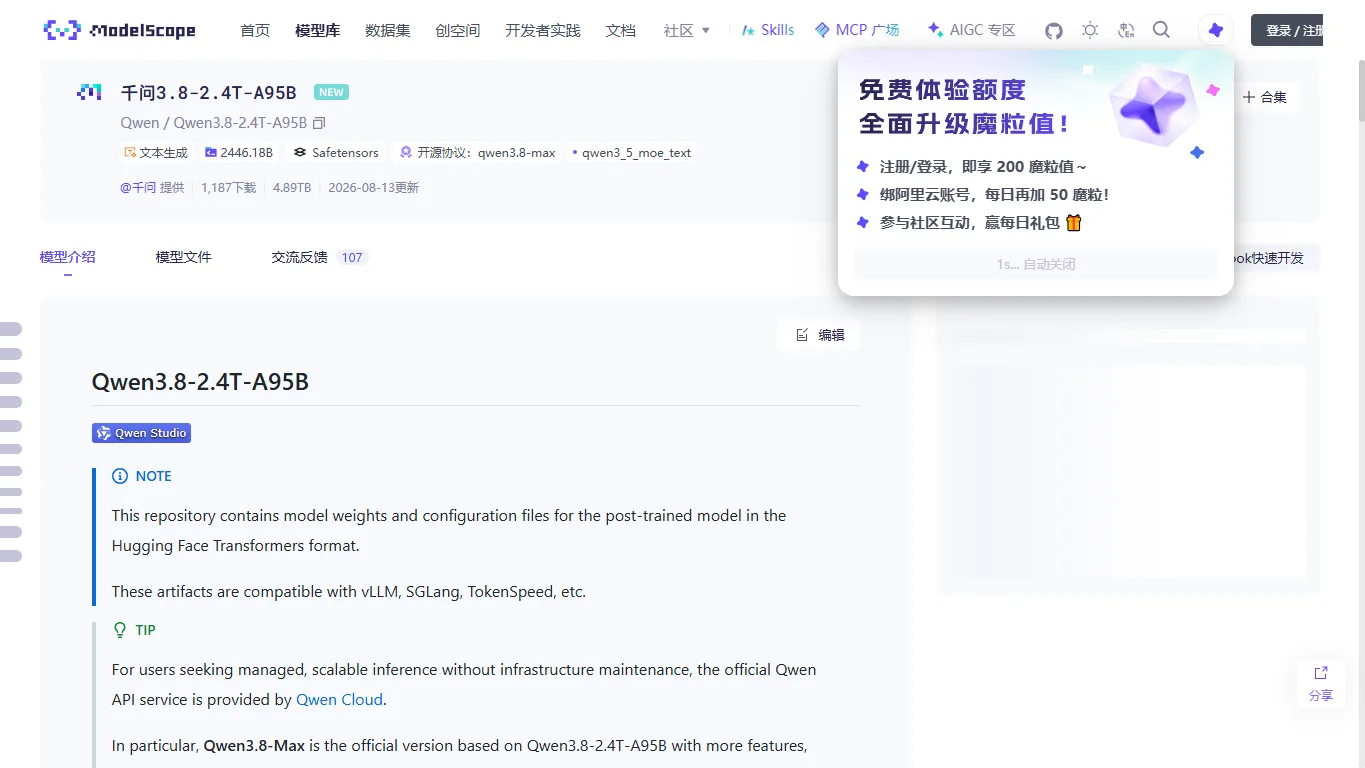
Qwen3.8-2.4T-A95B es la base open weight de la línea Max, con 2,4T parámetros y licencia qwen3.8-max en la página del modelo.
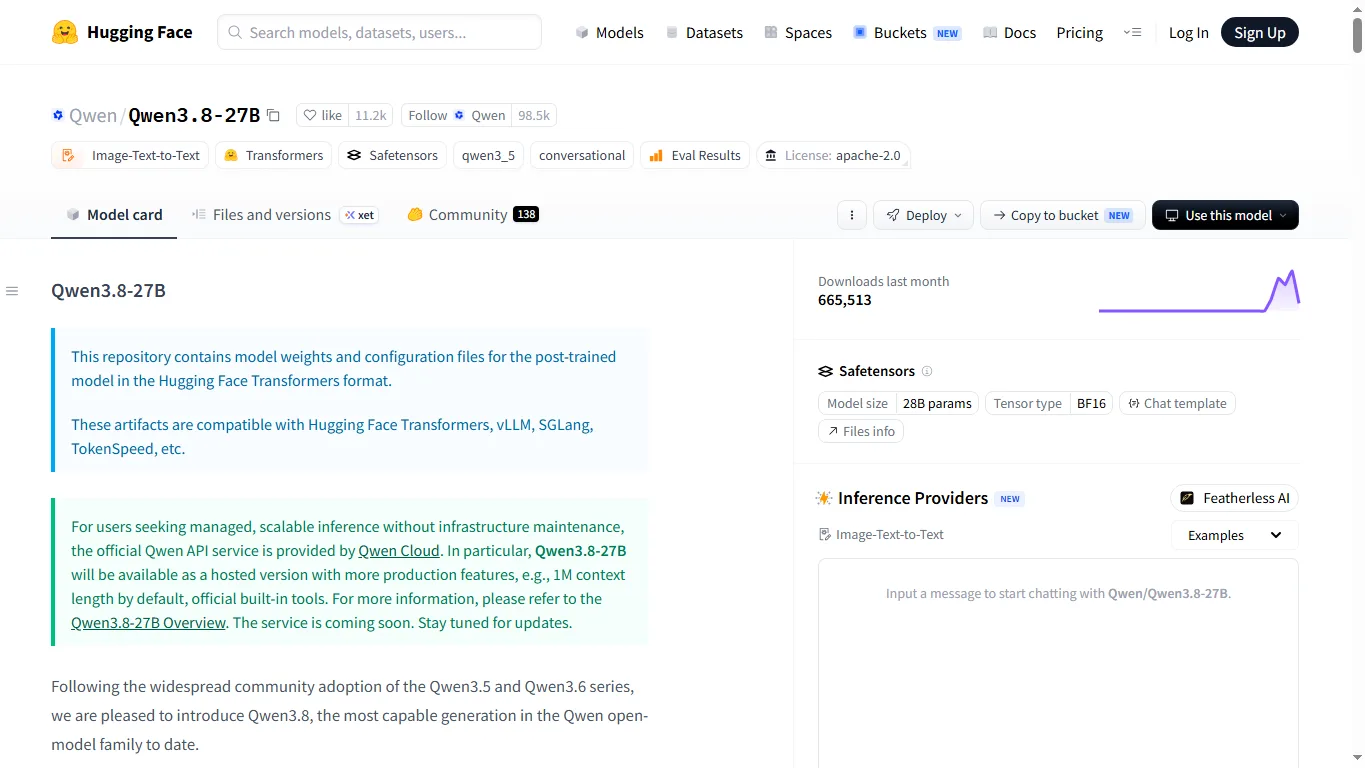
Qwen3.8-27B es la opción más práctica para usuarios locales. Aparece como un modelo de unos 28B parámetros, BF16 y Apache-2.0, por lo que es más accesible para pruebas y uso comercial.
Versiones del modelo y descargas
| Modelo | Posición | Mejor uso |
|---|---|---|
| Qwen3.8-2.4T-A95B | Max / 2.4T | Empresa, investigación, inferencia cloud |
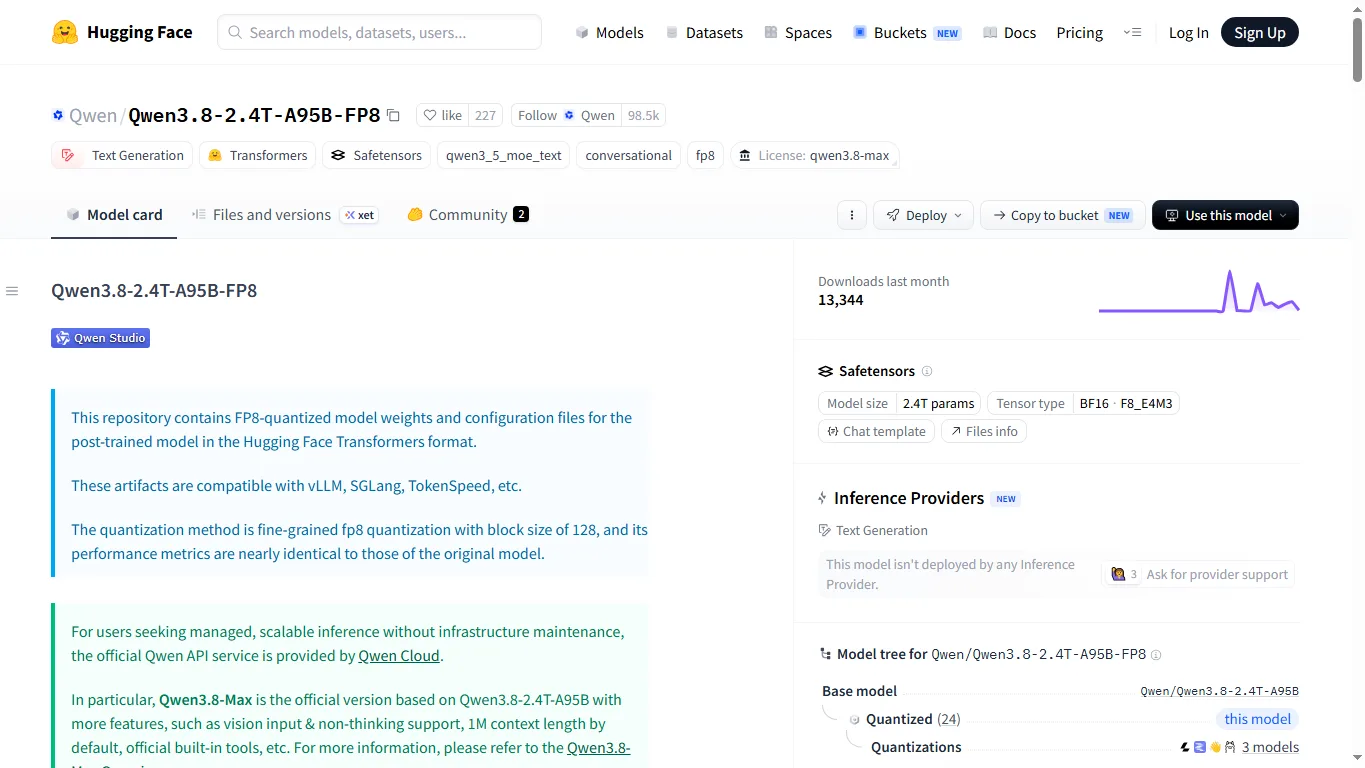
| Qwen3.8-2.4T-A95B-FP8 | FP8 | Reducir memoria en inferencia grande |
| Qwen3.8-27B | 27B / Apache-2.0 | LLM local, RAG, ayuda de código |
| ModelScope | ModelScope | Entornos China/ModelScope |
Rendimiento y experiencia real
Qwen 3.8 destaca por multilingüe, código, contexto largo y uso de herramientas. En la comunidad se discute más si 27B es suficientemente rápido, si las cuantizaciones funcionan bien, si vLLM/SGLang están maduros y si la línea Max compensa el coste cloud.
Comparación con LLM locales populares
| Punto clave | Detalle |
|---|---|
| Qwen3.8-27B | Buen punto de partida local para multilingüe y código. |
| Llama / Gemma | Ecosistema maduro y modelos pequeños más fáciles; Qwen compite bien en idiomas asiáticos y código. |
| DeepSeek / Kimi / GLM | También fuertes en contexto largo o razonamiento; conviene probar con tus datos. |
Instalación local
Conviene empezar por 27B o una versión cuantizada, no por la línea de 2.4T.
Ejemplo de instalación
pip install -U transformers accelerate torch safetensors python - <<'PY' from transformers import AutoModelForCausalLM, AutoTokenizer model_id = "Qwen/Qwen3.8-27B" tok = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True) model = AutoModelForCausalLM.from_pretrained( model_id, torch_dtype="auto", device_map="auto", trust_remote_code=True, ) PYRequisitos de GPU y VRAM
| Uso | VRAM | Nota |
|---|---|---|
| Qwen3.8-27B BF16 | 56GB+ | 80GB es cómodo; 48GB puede ser justo con contexto largo. |
| Qwen3.8-27B 4bit | 18-24GB+ | Puede probarse en una RTX 4090 con contexto moderado. |
| Qwen3.8-2.4T | Cluster | No es un modelo de escritorio; es para nube o empresa. |
Uso online si tu hardware no alcanza
sitio oficial de Qwen Chat sirve para probar el estilo del modelo antes de montar infraestructura local. La versión online puede incluir herramientas, visión o contexto largo que no están igual en los pesos locales.
Qwen 3.8-Flash-Next: una vista previa de la arquitectura de Qwen4
Qwen también publicó Qwen3.8-Flash-Next, un modelo open-weight experimental que adelanta varias ideas de arquitectura previstas para Qwen4. Es un MoE 125B-A6B que activa solo unos 6B parámetros por token, con una tabla adicional de embeddings N-gram de 51B parámetros pensada para residir en RAM y precargarse en vez de ocupar VRAM.
Aun así, no es un modelo pequeño para un PC normal. Los pesos BF16 oficiales rondan los 360GB, la versión FP8 unos 185GB, y las cuantizaciones GGUF de Unsloth ya se mueven aproximadamente entre 72,5GB y 111,3GB. Tiene más sentido verlo como un modelo para servidor, laboratorio local, SGLang, vLLM, TokenSpeed o pruebas GGUF.
Lo importante es la dirección de rendimiento. Según los benchmarks publicados por Qwen, supera a Qwen3.8-27B en la mayoría de pruebas de lenguaje y visión-lenguaje, y también supera a Claude Opus 4.6 Max en varias pruebas de trabajo como SWE-bench Pro, CoWorkBench y JobBench. Sus novedades clave son la atención híbrida GDN + QSA, Gated Residual, embeddings N-gram precargados desde RAM y la receta de entrenamiento basada en Muon.
La licencia Qwen Community License 1.0 permite un uso amplio y gratuito, incluido uso comercial en muchos casos, pero servicios MaaS, productos centrados en programación/ofimática con IA y productos muy grandes pueden tener obligaciones extra o necesitar un acuerdo separado.
Política NSFW y límites
El servicio online oficial de Qwen no es un chat NSFW sin límites. Contenido sexual explícito, usos ilegales, instrucciones peligrosas o daño a terceros pueden estar restringidos. Ejecutar pesos locales cambia la capa de interfaz, pero no elimina licencias, reglas de plataforma ni leyes locales.
Qwen3.8-27B Uncensored / Abliterated
Quien busque una variante local con menos restricciones también puede encontrar Huihui-Qwen3.8-27B-abliterated en Hugging Face. Es una versión uncensored / abliterated creada por la comunidad a partir de Qwen3.8-27B, no una publicación oficial de Qwen. En la práctica, un modelo “abliterated” suele reducir la tendencia a rechazar solicitudes, por lo que puede responder a prompts que el servicio oficial o los pesos alineados con seguridad rechazarían.
Puede servir para pruebas locales, investigación sobre alineamiento, escritura creativa o comparación de comportamiento entre modelos. La otra cara es que exige más responsabilidad: las salidas pueden estar menos filtradas y ser más fáciles de llevar hacia contenido adulto, inseguro o legalmente sensible. Antes de usarlo, conviene revisar la ficha del modelo en Hugging Face, la licencia, las reglas de la plataforma y la legislación aplicable.
Para la mayoría de usuarios, Qwen3.8-27B oficial o Qwen Chat siguen siendo el punto de partida más seguro. La versión abliterated encaja mejor como opción local avanzada para quienes ya entienden despliegue, moderación y gestión de riesgos.
Preguntas frecuentes
¿Qwen3.8-Max y 2.4T-A95B son lo mismo?
No exactamente. Max puede entenderse como la versión de servicio oficial basada en 2.4T-A95B, con funciones de producto como visión, herramientas y contexto largo.
¿Puede ejecutarse en una RTX 4090?
Una versión 4-bit de 27B puede probarse con contexto corto o medio; BF16 y la línea 2.4T no son realistas en una sola GPU de 24GB.
¿Se puede usar comercialmente?
27B aparece como Apache-2.0, más cómodo para evaluación comercial; 2.4T-A95B usa licencia qwen3.8-max y requiere revisar los términos.
Conclusión
El valor de Qwen 3.8 está en cubrir tanto la línea Max de gran escala como el 27B más práctico. La mayoría debería empezar por 27B o Qwen Chat antes de invertir en inferencia cloud pesada.
Información de referencia
Relacionados Reseñas
Análisis de GPT-6 Astra: precios, API, opiniones y límites

GPT-Image-2.5: análisis 2026 de Flare, Sunburst, precios y NSFW

YuE2-3B: música local con IA, Suno y ComfyUI
Review de DeepSeek V4: Flash, Pro, instalación local, Vision y política NSFW
Review de Ideogram 4.0: texto, ComfyUI, límites de censura y NSFW
Review de Gemma 4: instalación local, requisitos de GPU y política NSFW
