Gemini 4 Argon : avis, prix, programmation et limites NSFW
Notre analyse de Gemini 4 Argon : caractéristiques, retours utilisateurs, prix, comparaison avec GPT et Claude, utilisation de l’API et limites NSFW.

Gemini 4 Argon mérite un essai pour le développement complexe et les dossiers volumineux. Il associe de grandes entrées, du raisonnement et des outils. En contrepartie, il faut accepter une certaine attente, surveiller les quotas et vérifier les conclusions. Toutes les conversations ne justifient pas ce modèle.
Google a élargi son accès le 13 octobre 2026. Cet article distingue spécifications officielles, tests publiés et témoignages : les essais externes ne sont pas présentés comme des mesures réalisées par AirMore.
Informations et prix vérifiés le 16 octobre 2026.
À quels usages Gemini 4 Argon convient-il ?
Son meilleur terrain est une tâche accompagnée de sources et de critères vérifiables : modifier un dépôt de code, rapprocher des documents contradictoires ou produire une analyse recalculable. Un modèle plus léger peut suffire pour une extraction simple ou une courte reformulation.
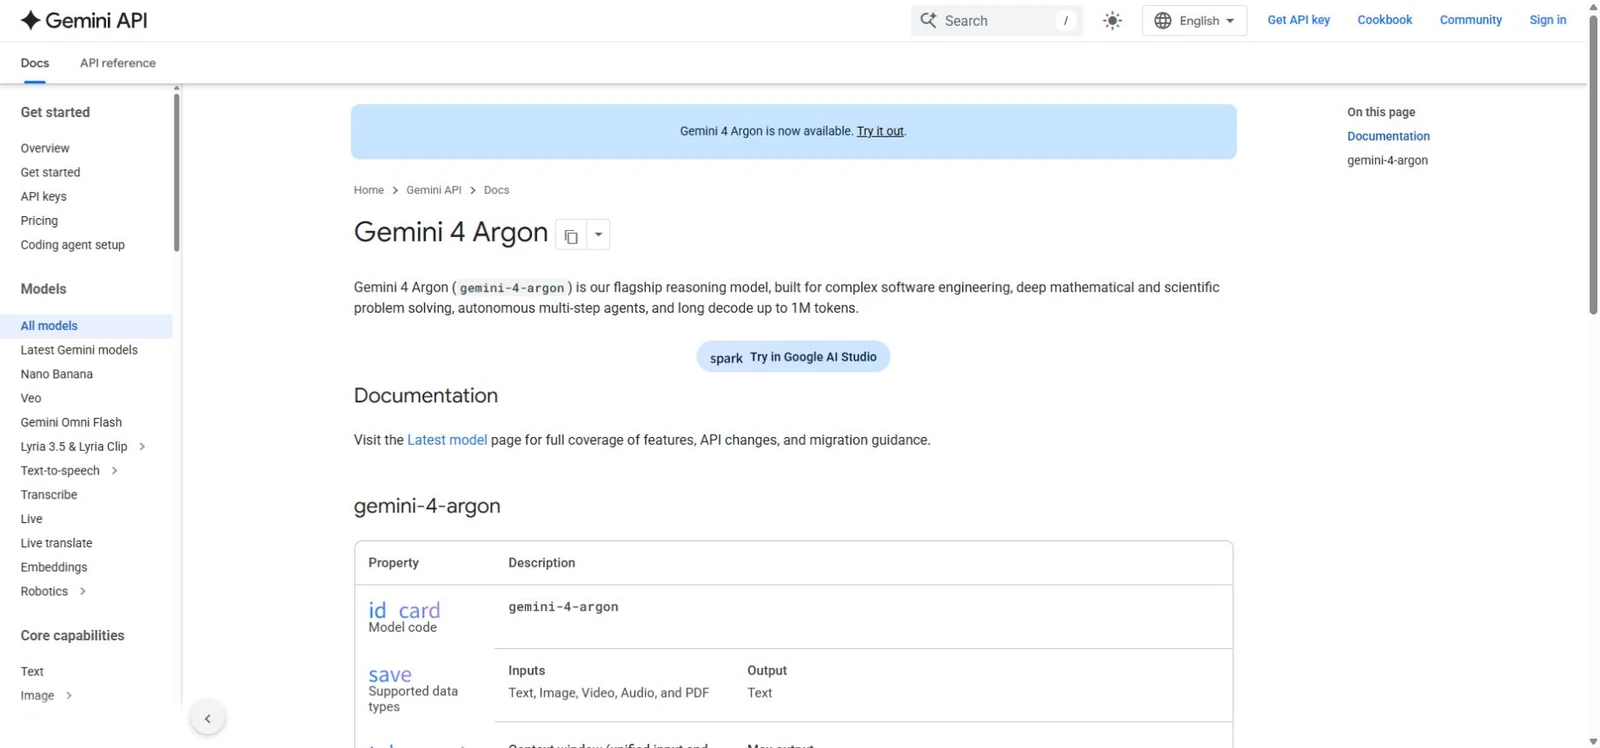
La fiche officielle décrit un nouveau Transformer à mélange clairsemé d’experts (MoE), et non un affinage d’un ancien Gemini. Le nombre de paramètres n’est pas publié. Aucun poids officiel n’est proposé pour une exécution locale.
| Caractéristique | Valeur |
|---|---|
| Identifiant | gemini-4-argon |
| Entrée | Texte, images, vidéo, audio et PDF |
| Sortie | Texte |
| Contexte : entrée + raisonnement + sortie | 1,048,576 tokens |
| Sortie synchrone par défaut | 65,536 tokens |
| Raisonnement | low / medium / high (défaut : medium) |
| Poids locaux | Non disponibles |
Sources: Gemini API · Gemini 4 Argon · Google DeepMind · Model Card
Où l’utiliser : Gemini, AI Studio et Antigravity
Application Gemini : connectez-vous au site officiel et vérifiez que Gemini 4 Argon apparaît dans le sélecteur. L’annonce vise les abonnés AI Pro et Ultra, avec des limites. Ce n’est pas un accès illimité à l’API.
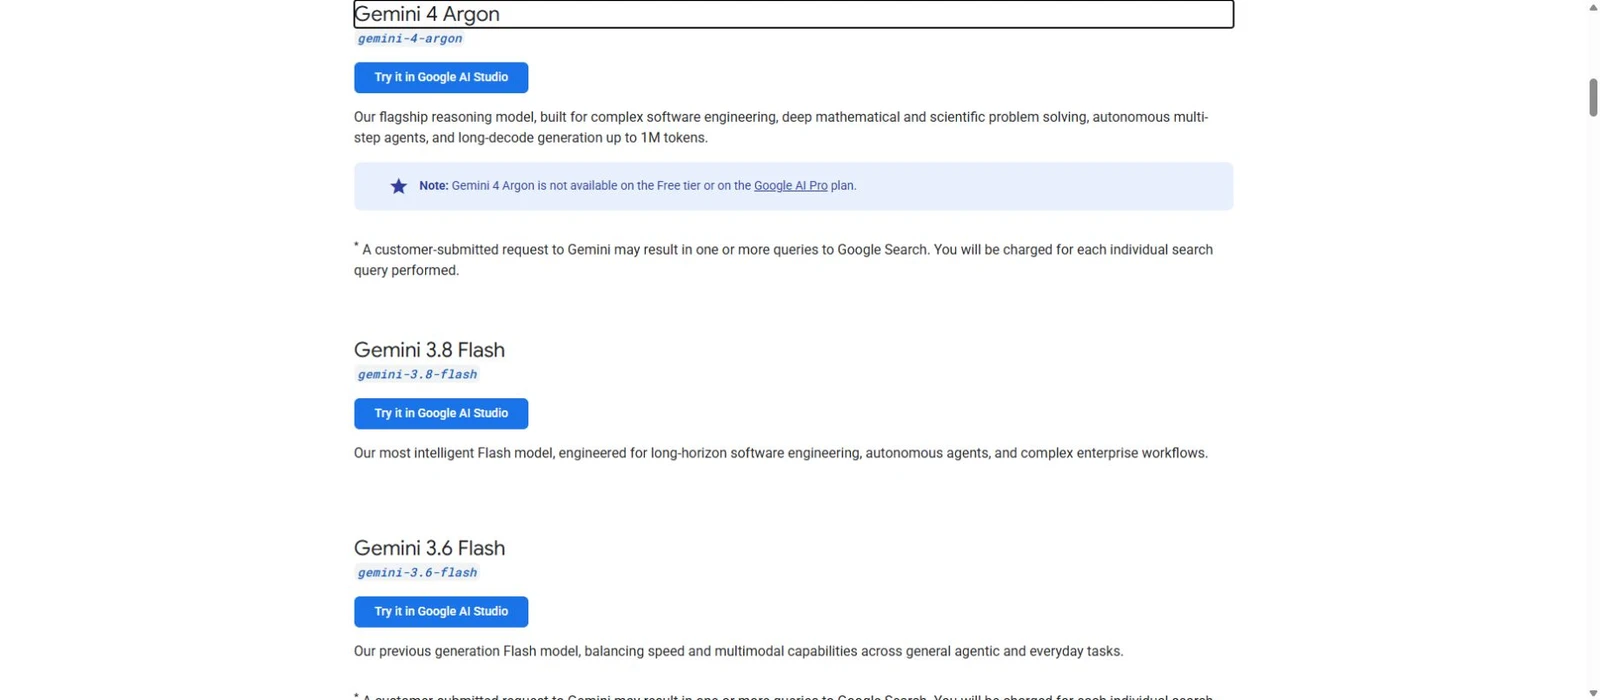
AI Studio et API : ces interfaces servent aux essais et aux intégrations. Argon est un modèle API payant ; la page développeur exclut le niveau gratuit et le droit d’accès Google AI Pro. Un abonnement Pro donnant Argon dans l’application ne finance donc pas automatiquement l’API et ne garantit pas le même accès dans AI Studio. Ultra et les projets payants ont leurs propres conditions.
Antigravity : c’est l’environnement d’agent de développement. L’accès s’étend aux offres payantes éligibles, mais la documentation distingue Pro payant et Pro en essai. Contrôlez le sélecteur et les quotas avant de souscrire pour cet usage. L’application peut compacter une conversation avant la limite théorique du modèle.
Sources: Gemini · Google AI Studio · Argon · Google Antigravity · Google AI Pro / Ultra
Prix en France et facturation de l’API
En France, Google AI Pro est affiché à 21,99 € par mois. Les promotions et conditions dépendent du compte ; vérifiez le montant au paiement. Cet abonnement concerne l’application. La consommation API est distincte.
Le tableau donne les tarifs Standard par million de tokens, en dollars américains. Le prix de lancement prend fin le 30 novembre 2026. Les tokens de raisonnement sont facturés dans la sortie, même lorsqu’ils ne figurent pas dans le texte reçu.
| API Standard / million de tokens | Jusqu’au 30/11/2026 | Dès le 1/12/2026 |
|---|---|---|
| Entrée sans cache | US$2.00 | US$4.00 |
| Sortie avec raisonnement | US$10.00 | US$20.00 |
| Entrée en cache | US$0.10 | US$0.20 |
Ainsi, 100 000 tokens d’entrée sans cache et 10 000 tokens de sortie facturable coûtent environ 0,30 $ US pendant l’offre, puis 0,60 $ US à partir du 1er décembre. Outils, taxes et nouvelles tentatives sont exclus. C’est un exemple calculé, pas une mesure du coût d’une tâche réussie.
Le cache implicite peut réduire les frais d’entrée ; le cache explicite n’est pas pris en charge. Batch ou Flex peuvent convenir à certains traitements. Comparez le coût du résultat accepté, corrections comprises, plutôt que celui d’une seule réponse.
Sources: Gemini API · Standard
Ce qui change par rapport aux précédents Gemini
La fenêtre de 1 048 576 tokens est partagée entre entrée, raisonnement et sortie. La sortie synchrone par défaut est limitée à 65 536 tokens. Long decode et l’exécution en arrière-plan permettent d’aller plus loin, mais les documents d’entrée consomment une partie du même budget.
Cela peut aider un agent à examiner les preuves, comparer des options et produire un livrable conséquent. Ce n’est pas une garantie de mémoire parfaite. Nommez les fichiers clairement, demandez des références précises et vérifiez les informations essentielles dans les originaux.
Pour migrer une intégration, retenez trois changements : raisonnement medium par défaut, paramètres temperature/top_p/top_k ignorés, et cache uniquement implicite. Un max_output_tokens trop faible peut couper la réponse parce que le raisonnement consomme aussi cette enveloppe.
Les outils créatifs de Gemini constituent une autre couche. Argon accepte images, vidéos et audio, mais son API produit du texte. Une vidéo créée dans l’application ne prouve pas qu’Argon la génère nativement.
Sources: Gemini API · Quickstart / Migration
Face à GPT-6 Astra et Claude : pas de vainqueur universel
La comparaison publiée par Google met en valeur le contexte long, tandis que le classement en développement varie selon le test. Ces chiffres proviennent du fournisseur, pas d’un benchmark indépendant d’AirMore.
| Évaluation | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| GraphWalks 256k–1M · BFS F1 | 84.2% | 71.8% | 65.0% | 66.8% |
Dans cette sélection, Argon mène sur DeepSWE, GPT-6 Astra sur FrontierSWE et Claude Opus 5.5 sur Terminal-bench. GraphWalks mesure un parcours de graphe en F1, pas la proportion de résumés ordinaires exacts. Les configurations et sources diffèrent : une moyenne de ces chiffres serait trompeuse.
Comparez les modèles sur le même dépôt, problème, outillage et tests d’acceptation. Mesurez les régressions, le temps de relecture et la dépense totale. Pour les documents, vérifiez que les affirmations importantes renvoient aux bonnes sources.
Sources: Google DeepMind · Model Card · Google DeepMind · Evaluation methodology
Ce que montrent les essais et les retours utilisateurs
Une bonne analyse peut déboucher sur une phrase non étayée. Dans son essai du 14 octobre, Analytics Vidhya a obtenu un prototype web utile et une analyse numérique correcte. Lors du rapprochement de documents, Argon a bien classé les affirmations, mais ajouté un détail sans preuve dans le résumé final. Il faut donc relire également la conclusion.
Les premiers avis sur le développement sont partagés. Un utilisateur d’Antigravity a comparé des plans pour un projet Python en production, puis demandé à un autre modèle de les évaluer : le concurrent a été préféré. Les niveaux de raisonnement différaient, et ce n’était pas un test des implémentations exécutées. La même discussion contient des appréciations positives sur les explications et les longues tâches, ainsi que des critiques des quotas et de la compression du contexte.
Ces témoignages ne permettent pas de calculer un taux de panne ni un nombre universel de requêtes par abonnement. Axios apporte le contexte du lancement, pas une mesure indépendante des performances de code. Un essai limité reste plus utile qu’un remplacement immédiat de tous vos outils.
Sources: Analytics Vidhya · 2026-10-14 · Reddit · r/google_antigravity · Axios · 2026-09-30
Comment le tester avec une consigne utile
Commencez par une tâche vérifiable et des documents non sensibles. La consigne suivante est une proposition d’évaluation, pas le compte rendu d’un essai déjà mesuré.
- Sélectionnez Argon dans Gemini ou gemini-4-argon dans AI Studio/API. Contrôlez facturation et outils disponibles.
- Commencez en medium ; réservez high aux problèmes justifiant une attente supplémentaire. Définissez objectif, sources autorisées, contraintes et critères de validation.
- Exécutez les tests, refaites les calculs et contrôlez les citations. Ne vous contentez pas de l’explication du modèle.
- Notez durée, nouvelles tentatives et consommation. Comparez la même tâche à votre modèle habituel.
Compare le plan approuvé joint et le brouillon ultérieur. Pour chaque affirmation modifiée, indique le fichier, le paragraphe, la différence et la présence d’une approbation documentée. Sépare faits confirmés et hypothèses. Un brouillon plus récent ne vaut pas approbation. Termine par trois questions à trancher par une personne.Pour le code, exigez une modification minimale et des tests précis. Pour les documents en français, ajoutez un glossaire et demandez de conserver les noms de produits. Des critères explicites facilitent davantage la vérification qu’une demande générale de bien faire.
Démarrer avec l’API et éviter les erreurs de migration
Installez google-genai à jour, activez un projet payant et placez votre clé dans la variable GEMINI_API_KEY. Ne la publiez pas dans du code navigateur ou un notebook partagé. Cet exemple suit le schéma officiel Interactions API ; il n’a pas été exécuté ici comme test payant de performances.
python -m pip install -U google-genaifrom google import genai
client = genai.Client()
interaction = client.interactions.create(
model="gemini-4-argon",
input="Compare le plan approuvé joint et le brouillon ultérieur. Pour chaque affirmation modifiée, indique le fichier, le paragraphe, la différence et la présence d’une approbation documentée. Sépare faits confirmés et hypothèses. Un brouillon plus récent ne vaut pas approbation. Termine par trois questions à trancher par une personne."
)
print(interaction.output_text)En cas de délai dépassé, examinez l’exécution en arrière-plan avant de renvoyer tout le dossier. Si la réponse est tronquée, vérifiez le budget commun de raisonnement et de sortie. Si le modèle manque, contrôlez les droits du produit et du projet, au-delà de l’abonnement à l’application.
Sources: Gemini API · Quickstart / Migration
NSFW : restrictions actuelles et perspectives
Argon n’est pas un modèle sans restrictions pour le jeu de rôle érotique. La politique Google interdit la pornographie et les contenus visant la gratification sexuelle. Les contextes éducatifs, scientifiques ou artistiques sont différents, sans constituer une autorisation générale de génération explicite.
Les filtres additionnels de l’API ne sont pas les protections internes du modèle. Le réglage Off par défaut de certains filtres des Gemini récents ne supprime ni les protections fondamentales ni les règles du service. Une baisse des refus injustifiés ne signifie pas une ouverture au NSFW explicite.
La romance non explicite, la construction de personnages et l’analyse de thèmes adultes peuvent être évaluées dans le cadre des règles applicables. L’API Argon ne produit pas d’images et aucun poids officiel ne permet d’en faire une version locale sans restrictions.
Nous n’avons trouvé aucune annonce officielle vérifiable d’un futur mode adulte Argon. Une meilleure écriture peut élargir les usages créatifs autorisés, mais une évolution de politique reste inconnue. Ne souscrivez pas en comptant sur une fonction non annoncée.
Sources: Google · Generative AI policy · Gemini API · Safety settings
Notre avis : privilégier les tâches difficiles et vérifiables
Argon est intéressant pour les développeurs, analystes et chercheurs dont les tâches justifient un raisonnement approfondi. Gardez un modèle rapide pour les demandes simples et un concurrent lorsqu’il réussit mieux vos tests.
Pour les agents de longue durée, examinez aussi permissions, contexte, quotas et reprise après erreur. Le modèle n’est qu’une partie du produit.
Est-il gratuit ?
L’API est payante. L’application propose Argon aux comptes AI Pro et Ultra éligibles, avec des limites.
Peut-on le télécharger pour Ollama ?
Aucun poids officiel ni paquet local n’est disponible. Utilisez l’application ou l’API officielle.
Un million de tokens signifie-t-il une conversation illimitée ?
Non. Entrée, raisonnement et sortie partagent le budget, et chaque application peut compacter le contexte.
Connexes Évaluations
Test de DeepSeek V4 : Flash, Pro, installation locale, Vision et politique NSFW

Test de Qwen 3.8 : performances, installation locale, GPU et politique NSFW
Top 10 des modèles d’IA en 2026 : classement Arena, prix et usages
Test de Wan 3.0 : vidéo IA 30 s, statut open source et limites NSFW
MiniMax H3 Image Studio : avis, images ComfyUI et références pour la vidéo
Qwen-Image-2.1 : avis sur la transparence, la retouche, les prix API et le NSFW