Test de Qwen 3.8 : performances, installation locale, GPU et politique NSFW
Qwen 3.8 se comprend mieux en deux lignes : Qwen3.8-2.4T-A95B / Max pour l’inférence à grande échelle, et Qwen3.8-27B pour les utilisateurs qui veulent tester…

Qwen 3.8 se comprend mieux en deux lignes : Qwen3.8-2.4T-A95B / Max pour l’inférence à grande échelle, et Qwen3.8-27B pour les utilisateurs qui veulent tester un LLM puissant en local ou dans une petite infrastructure. Le premier vise le plafond de performance ; le second est le point d’entrée le plus réaliste.
Si vous vous intéressez à l’installation locale, aux besoins GPU, aux liens de téléchargement, à l’usage commercial et à la politique NSFW, les benchmarks ne suffisent pas. Les versions de Qwen 3.8 diffèrent fortement en taille, licence, coût d’exécution et comportement entre service en ligne et poids téléchargeables.
Sommaire
- Qu’est-ce que Qwen 3.8 ?
- Versions du modèle et téléchargements
- Performances et retours d’usage
- Comparaison avec les LLM locaux populaires
- Installation locale
- Besoins GPU et VRAM
- Utilisation en ligne si le matériel ne suffit pas
- Politique NSFW et limites
- Qwen3.8-27B Uncensored / Abliterated
- Questions fréquentes
- Conclusion
- Informations de référence
Qu’est-ce que Qwen 3.8 ?
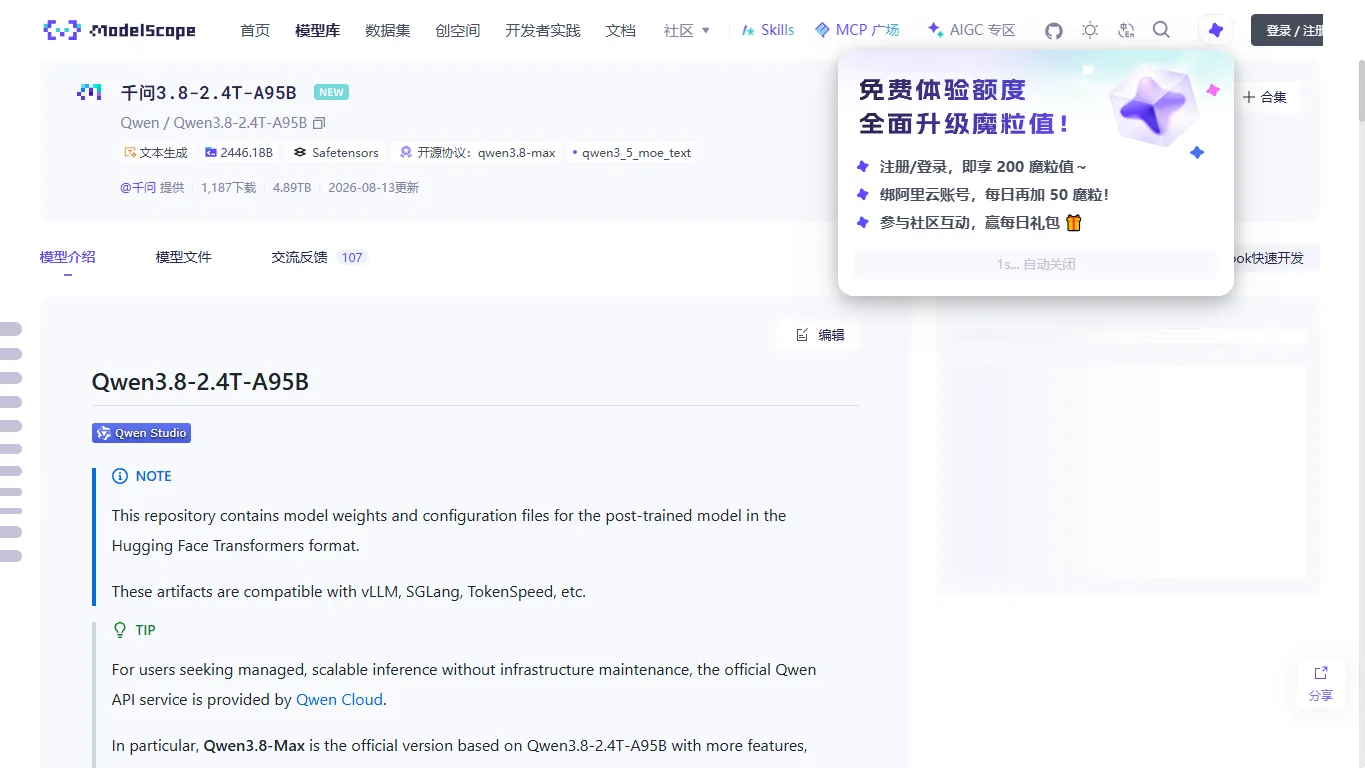
Qwen3.8-2.4T-A95B sert de base open weight à la ligne Max, avec 2,4T paramètres et une licence qwen3.8-max indiqués sur la page du modèle.

Qwen3.8-27B est l’option la plus pratique pour les utilisateurs locaux. La page l’indique comme un modèle d’environ 28B paramètres, BF16 et Apache-2.0, donc plus simple à tester et à envisager commercialement.

Versions du modèle et téléchargements
| Modèle | Positionnement | Meilleur usage |
|---|---|---|
| Qwen3.8-2.4T-A95B | Max / 2.4T | Entreprise, recherche, inférence cloud |
| Qwen3.8-2.4T-A95B-FP8 | FP8 | Réduire la mémoire en grande inférence |
| Qwen3.8-27B | 27B / Apache-2.0 | LLM local, RAG, aide au code |
| ModelScope | ModelScope | Environnements Chine/ModelScope |

Performances et retours d’usage
Qwen 3.8 se distingue par le multilingue, le code, le long contexte et l’usage d’outils. Les discussions portent surtout sur la vitesse du 27B, la qualité des versions quantifiées, la maturité vLLM/SGLang et le coût réel de la ligne Max.
Comparaison avec les LLM locaux populaires
| Point clé | Détail |
|---|---|
| Qwen3.8-27B | Bon point d’entrée local pour multilingue et code. |
| Llama / Gemma | Écosystème mûr et petits modèles faciles ; Qwen est fort sur langues asiatiques et code. |
| DeepSeek / Kimi / GLM | Également forts en contexte long ou raisonnement ; testez avec vos données. |
Installation locale
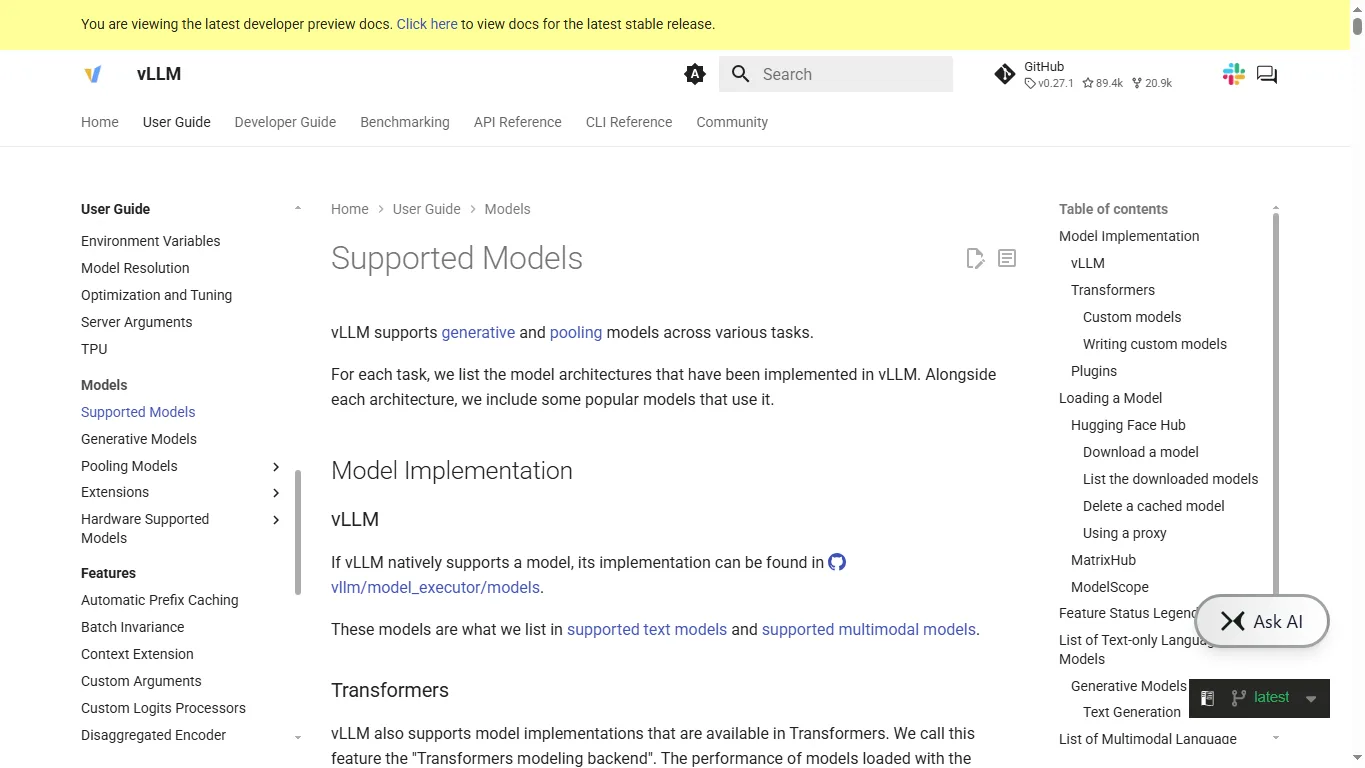
Il est plus raisonnable de commencer par 27B ou une version quantifiée, pas par la ligne 2,4T.
Exemple d’installation
pip install -U transformers accelerate torch safetensors python - <<'PY' from transformers import AutoModelForCausalLM, AutoTokenizer model_id = "Qwen/Qwen3.8-27B" tok = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True) model = AutoModelForCausalLM.from_pretrained( model_id, torch_dtype="auto", device_map="auto", trust_remote_code=True, ) PYBesoins GPU et VRAM
| Usage | VRAM | Note |
|---|---|---|
| Qwen3.8-27B BF16 | 56GB+ | 80 Go est confortable ; 48 Go peut être juste en long contexte. |
| Qwen3.8-27B 4bit | 18-24GB+ | Test possible sur RTX 4090 avec contexte modéré. |
| Qwen3.8-2.4T | Cluster | Pas un modèle de bureau ; plutôt cloud ou entreprise. |
Utilisation en ligne si le matériel ne suffit pas
site officiel Qwen Chat permet de tester le style du modèle avant d’investir dans l’infrastructure locale. La version en ligne peut intégrer outils, vision ou long contexte différemment des poids locaux.
Qwen 3.8-Flash-Next : un aperçu de l’architecture Qwen4
Qwen a aussi publié Qwen3.8-Flash-Next, un modèle open-weight expérimental qui préfigure plusieurs choix d’architecture attendus dans Qwen4. Il s’agit d’un MoE 125B-A6B qui n’active qu’environ 6B paramètres par token, avec une table séparée d’embeddings N-gram de 51B paramètres conçue pour rester en RAM système et être préchargée au lieu d’occuper la VRAM.
Ce n’est toutefois pas un petit modèle pour PC classique. Les poids BF16 officiels font environ 360GB, la version FP8 environ 185GB, et les builds GGUF d’Unsloth se situent déjà autour de 72,5GB à 111,3GB. Il faut plutôt le voir comme un modèle pour serveur, laboratoire local, SGLang, vLLM, TokenSpeed ou essais GGUF.
Son intérêt vient surtout de la direction des performances. D’après les benchmarks publiés par Qwen, Flash-Next dépasse Qwen3.8-27B dans la plupart des tests langage et vision-langage, et devance aussi Claude Opus 4.6 Max dans certains benchmarks de travail comme SWE-bench Pro, CoWorkBench et JobBench. Les nouveautés clés sont l’attention hybride GDN + QSA, Gated Residual, les embeddings N-gram préchargés depuis la RAM et la recette d’entraînement basée sur Muon.
La Qwen Community License 1.0 permet un usage large et gratuit, y compris commercial dans de nombreux cas, mais les fournisseurs MaaS, les produits centrés sur le coding/office assistant IA et les très grands produits peuvent avoir des obligations supplémentaires ou nécessiter un accord séparé.
Politique NSFW et limites
Le service en ligne officiel de Qwen n’est pas un chat NSFW sans limites. Contenus sexuels explicites, usages illégaux, instructions dangereuses ou nuisances envers autrui peuvent être restreints. Exécuter les poids localement change l’interface, mais pas les licences, règles de plateforme ni lois locales.
Qwen3.8-27B Uncensored / Abliterated
Les utilisateurs qui veulent tester une variante locale moins restrictive peuvent aussi trouver Huihui-Qwen3.8-27B-abliterated sur Hugging Face. Il s’agit d’une version uncensored / abliterated créée par la communauté à partir de Qwen3.8-27B, et non d’une version officielle de Qwen. En pratique, un modèle « abliterated » réduit généralement les comportements de refus, ce qui le rend plus susceptible de répondre à des requêtes que le service officiel ou des poids alignés sur la sécurité refuseraient.
Ce type de modèle peut être utile pour des tests locaux, des recherches sur l’alignement, l’écriture créative ou la comparaison de comportements. En contrepartie, il demande davantage de prudence : les sorties peuvent être moins filtrées et plus facilement orientées vers des contenus adultes, dangereux ou juridiquement sensibles. Avant de l’utiliser, il faut vérifier la fiche du modèle sur Hugging Face, la licence, les règles de la plateforme et la loi applicable.
Pour la plupart des lecteurs, Qwen3.8-27B officiel ou Qwen Chat reste le point de départ le plus sûr. La version abliterated convient plutôt à des utilisateurs avancés qui comprennent déjà l’hébergement local, la modération et la gestion des risques.
Questions fréquentes
Qwen3.8-Max et 2.4T-A95B sont-ils identiques ?
Pas exactement. Max peut être vu comme la version de service officielle basée sur 2.4T-A95B, avec vision, outils et long contexte.
Peut-on l’exécuter sur une RTX 4090 ?
Une version 4-bit du 27B peut se tester avec contexte court ou moyen ; BF16 et la ligne 2,4T ne sont pas réalistes sur une seule GPU 24 Go.
Peut-on l’utiliser commercialement ?
27B est indiqué en Apache-2.0, plus simple pour une évaluation commerciale ; 2.4T-A95B utilise la licence qwen3.8-max à lire avant déploiement.
Conclusion
La valeur de Qwen 3.8 tient à la fois à la ligne Max de grande échelle et au 27B plus pratique. La plupart des lecteurs devraient commencer par 27B ou Qwen Chat avant d’investir dans une inférence cloud lourde.
Informations de référence
Connexes Évaluations
Avis Hy4 Preview : Tencent Hunyuan 770B MoE, contexte 1M, API, matériel local et limites NSFW

Test de Kimi K3 : MoE open-weight 2,8T, déploiement local, benchmarks et NSFW
Avis GLM-5.3-Flash : Ox-Alpha, API, benchmarks et limites NSFW

Avis sur Step 5 Preview : prix, API, poids ouverts et limites NSFW
MiniMax H3 Image Studio : avis, images ComfyUI et références pour la vidéo
Qwen-Image-2.1 : avis sur la transparence, la retouche, les prix API et le NSFW