Top 10 des modèles d’IA en 2026 : classement Arena, prix et usages
Comparez les dix premières entrées d’Arena en octobre 2026 : Gemini, Claude et Muse, leurs tarifs API, caractéristiques, tests et accès officiels.

Gemini 4 Argon domine le classement général de Text Arena, mais le premier modèle à essayer dépend de votre travail. Claude Opus 5.5 constitue un bon point de départ pour le code et les documents complexes ; Gemini 3.8 Flash affiche les tarifs par token les plus bas de ce groupe ; Muse Wonder mérite un essai pour les agents travaillant sur la durée.
Il s’agit de dix configurations classées, pas de dix marques de chatbots. Plusieurs générations de Claude sont présentes et Opus 4.6 apparaît deux fois. Utilisez ce classement pour réduire votre sélection, puis décidez selon l’accès, le coût d’une tâche terminée et la qualité réelle du résultat.
Vérifié le 14 octobre 2026. Données du classement : 13 octobre 2026.
Les dix premières places d’Arena
La référence est Text → Overall sur Arena, et non les classements spécialisés en code, agents, images ou vidéo. Le score traduit les préférences entre réponses textuelles, pas un taux de bonnes réponses. Les intervalles se chevauchent : la plage de rang de Wonder va de 1 à 11. Sa deuxième place ne prouve donc pas une supériorité nette sur le troisième.
Les suffixes high, max et xHigh décrivent une configuration d’évaluation, pas un nombre de paramètres ni une option proposée dans toutes les applications. Ces dix entrées sont propriétaires et les spécifications officielles citées ne révèlent pas leur nombre de paramètres. Un contexte de 1M désigne environ un million de tokens de travail, pas la taille du modèle.
| Rang | Entrée Arena | Score et incertitude | Votes | API : USD par million de tokens, entrée / sortie | Contexte |
|---|---|---|---|---|---|
| 1 | gemini-4-argon-high | 1525 ±9 * | 4,903 | $2 / $10 | 1M |
| 2 | muse-wonder-max | 1513 ±13 | 1,944 | $4 / $20 | 1M |
| 3 | claude-opus-5.5-high | 1508 ±8 | 7,687 | $4 / $20 | 1M |
| 4 | claude-fable-5-high | 1503 ±4 | 41,439 | $10 / $50 | 1M |
| 5 | claude-opus-4-6-high | 1503 ±3 | 80,827 | $5 / $25 | 1M |
| 6 | claude-opus-4-7-high | 1501 ±4 | 65,125 | $5 / $25 | 1M |
| 7 | claude-fable-5.1-max | 1501 ±6 | 14,121 | $10 / $50 | 1M |
| 8 | claude-opus-4-6 | 1498 ±3 | 85,445 | $5 / $25 | 1M |
| 9 | gemini-3.8-flash-high | 1496 ±5 * | 35,670 | $0.75 / $3.75 | 1M |
| 10 | muse-spark-1.2 (xHigh) | 1495 ±7 | 7,611 | $1.25 / $4.25 | N/A |
Les montants sont les tarifs API standard en dollars américains par million de tokens, pas des abonnements mensuels ni des prix locaux en euros TTC. Raisonnement, cache, outils et longueur de sortie influencent la facture. Argon coûte $2/$10 jusqu’au 30 novembre 2026, puis $4/$20 ; les tarifs de lancement de Flash courent jusqu’au 31 décembre. * signale un score provisoire ; N/A signifie qu’Arena ne précise pas le contexte.
Ce que chaque modèle apporte
1. Gemini 4 Argon (high) — Le premier du classement pour le travail multimodal difficile
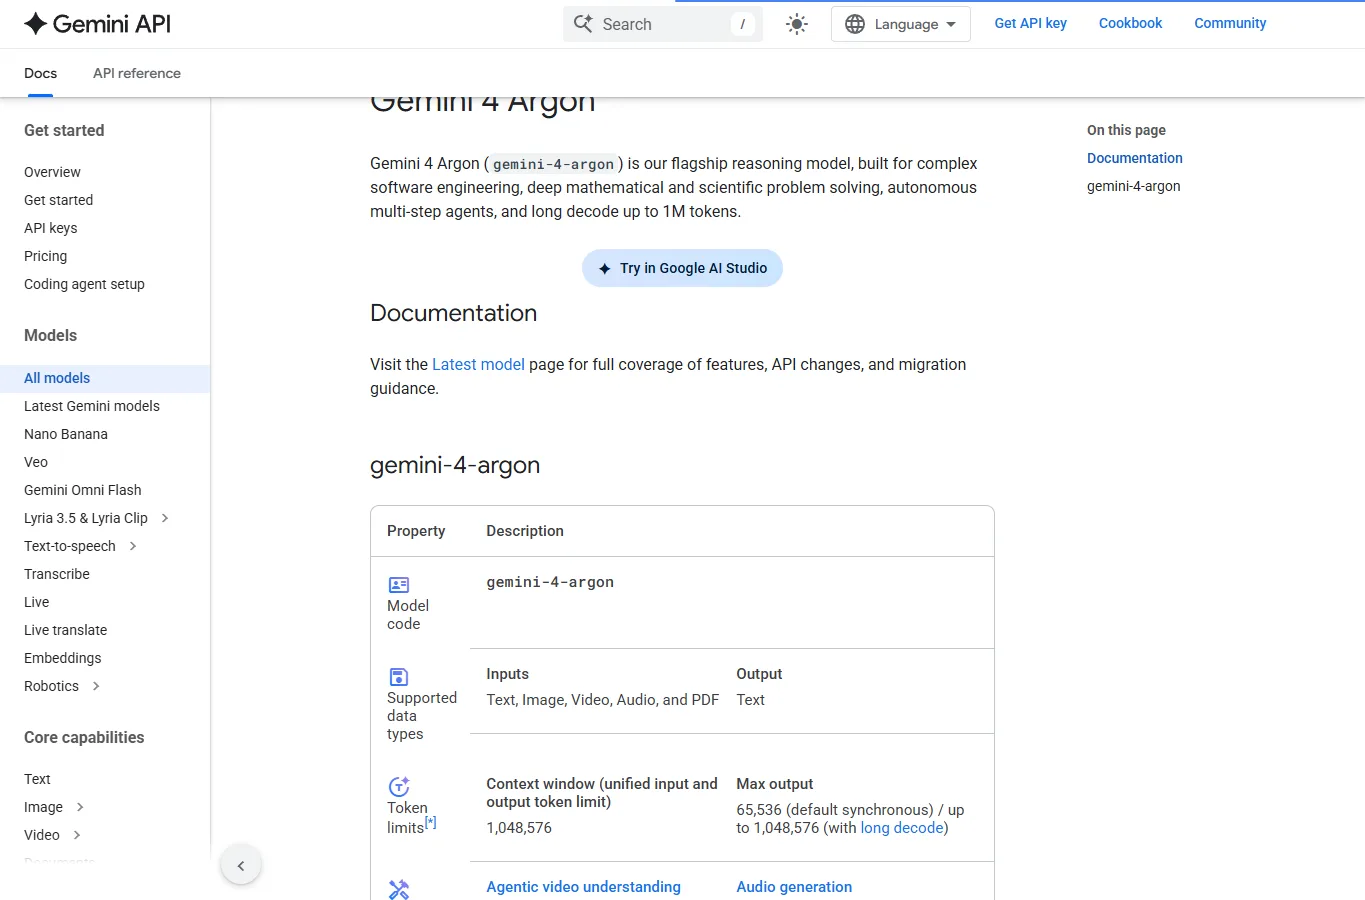
Caractéristiques clés: Nombre de paramètres non publié ; contexte unifié de 1 048 576 tokens ; texte, images, audio, vidéo et PDF en entrée, texte en sortie. Sortie synchrone habituelle : 65 536 tokens maximum.
Argon convient aux tâches mêlant documents, contenu visuel et raisonnement approfondi. Entrée, raisonnement et sortie partagent la fenêtre : un million de tokens d’entrée ne laisse pas un autre million indépendant pour la réponse. La sortie longue utilise le même budget. Le classement porte sur high ; le réglage API par défaut est medium.
Depuis le 13 octobre, les abonnés Google AI Pro et Ultra peuvent utiliser Argon dans Gemini. L’API payante est également ouverte ; l’annonce destinée aux développeurs détaille l’accès Ultra à AI Studio et Antigravity. L’abonnement grand public ne fournit pas une API illimitée.
Tests et compromis: Dans son essai en accès anticipé, Tim Simmons décrit un modèle persévérant sur des jeux, du montage et de l’écriture, avec une finition humaine encore nécessaire. C’est un retour sur des projets concrets, pas la promesse d’un résultat parfait en une instruction. Mesurez attente et consommation avant de choisir high partout.
Informations officielles · Utilisation en ligne / API · API / AI Studio
2. Muse Wonder (max) — Un nouveau candidat pour les agents de longue durée
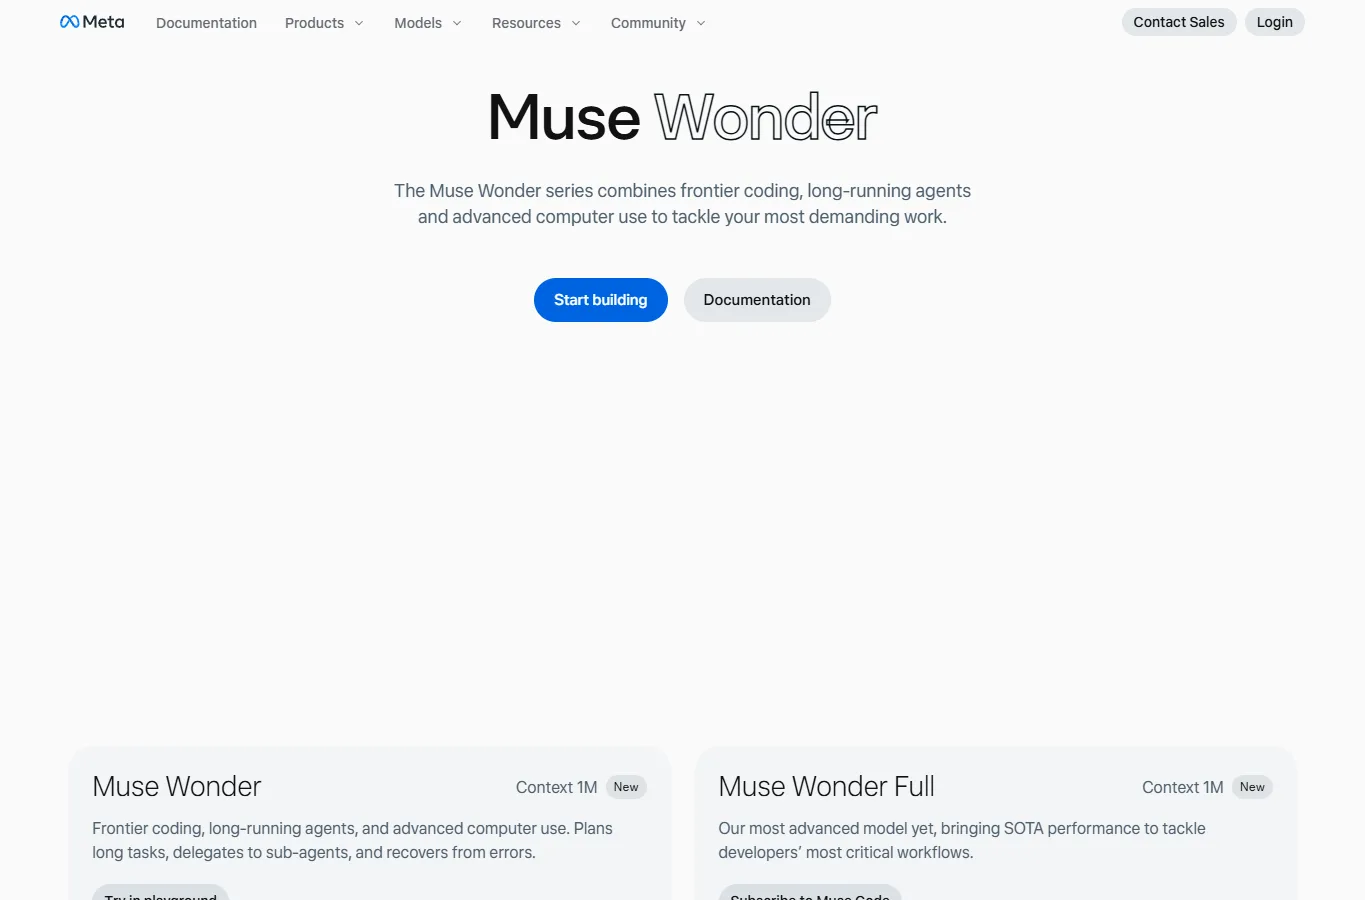
Caractéristiques clés: Paramètres non publiés ; contexte de 1M ; $4 en entrée / $20 en sortie. Il s’agit de Wonder max, pas de Wonder Full.
Meta met en avant la mémoire entre conversations et la persévérance sur des tâches longues. Les accès comprennent Meta Model API, Muse Code et le playground développeur. Wonder Full est distinct et lié aux abonnements Muse Code éligibles ; ses capacités ne doivent pas être attribuées à cette deuxième place.
Axios a couvert le lancement de ces nouveaux modèles. Les tests de Spring Prompt du 13 octobre montrent une bonne analyse de données fournies, mais des défauts de mise en page et des affirmations commerciales non étayées. Ils concernent principalement Wonder standard en medium, pas le max d’Arena.
Tests et compromis: Testez-le dans votre environnement d’agents réel. Mémoire et outils connectés influencent le résultat ; un classement de texte ne mesure pas tout le système.
Informations officielles · Utilisation en ligne / API · API / Meta
3. Claude Opus 5.5 (high) — Un point de départ raisonnable dans Claude
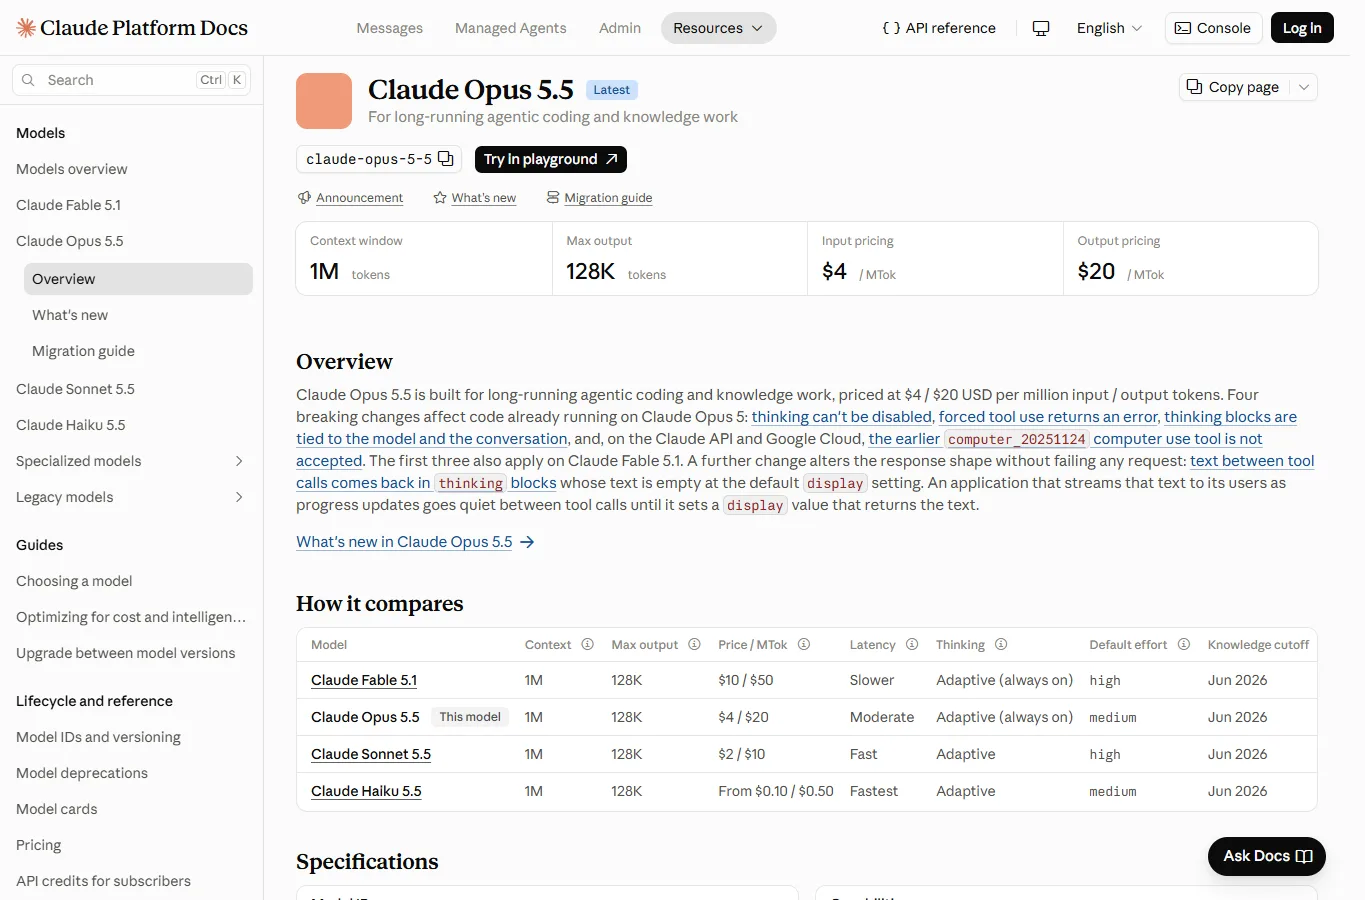
Caractéristiques clés: Paramètres non publiés ; contexte de 1M ; sortie maximale de 128K ; texte et images en entrée ; $4 / $20.
Il associe programmation difficile, recherche et rédaction professionnelle à des tarifs de base inférieurs à ceux des anciens Opus de la liste. Son identifiant API est claude-opus-5-5. Claude sert au chat, Claude Code aux dépôts de code et Claude Platform à l’intégration API ; leurs limites diffèrent.
MacRumors rapporte les améliorations annoncées par Anthropic, plutôt qu’un test comparatif indépendant. DataLLM Lab a réussi neuf petites tâches Python, mais des modèles moins chers ont aussi passé cette suite. Ce résultat ne justifie pas un modèle haut de gamme pour chaque tâche simple.
Tests et compromis: Pour un nouveau flux Claude, commencez par 5.5 et comparez Flash sur les opérations simples. Le rang voisin d’un ancien modèle ne suffit pas à justifier un tarif supérieur.
Informations officielles · Utilisation en ligne / API · API / Claude Platform
4. Claude Fable 5 (high) — Toujours bien placé, mais ce n’est plus le dernier Fable
Caractéristiques clés: Paramètres non publiés ; contexte de 1M ; $10 / $50 par million de tokens.
Fable 5 privilégie les projets de code prolongés, l’analyse et la compréhension visuelle. C’est l’offre publique avec garde-fous, distincte de l’accès restreint à Mythos. Vérifiez que cette ancienne version figure encore dans votre catalogue ou abonnement.
Un retour d’utilisation de Tom’s Guide souligne le passage de simples réponses à l’exécution de projets. Pour démarrer aujourd’hui, comparez néanmoins Fable 5.1 et Opus 5.5 en premier.
Tests et compromis: Il intéresse surtout ceux qui disposent déjà d’un flux validé avec Fable 5. Testez les régressions avant de migrer plutôt que de revenir à une ancienne version pour son rang.
Informations officielles · Utilisation en ligne / API · API / Claude Platform
5. Claude Opus 4.6 (high) — Une ancienne version avec beaucoup de votes
Caractéristiques clés: Paramètres non publiés ; contexte de 1M ; sortie habituelle jusqu’à 128K ; $5 / $25.
Cette configuration compte plus de 80 000 votes, davantage que certains nouveaux venus. La documentation actuelle la classe comme legacy et recommande d’envisager 5.5. Le contexte complet de 1M est aujourd’hui facturé au tarif standard.
Simon Willison expliquait en février utiliser très souvent Opus 4.6 dans Claude Code. C’est un témoignage daté, pas une recommandation d’octobre contre 5.5. Le mode high peut allonger inutilement les tâches simples.
Tests et compromis: Conservez-le si vos prompts et tests démontrent un avantage. Pour un nouveau projet, comparez le résultat et le coût total à ceux de 5.5.
Informations officielles · Utilisation en ligne / API · API / Claude Platform
6. Claude Opus 4.7 (high) — Code et vision améliorés, mais attention au comptage
Caractéristiques clés: Paramètres non publiés ; contexte de 1M ; $5 / $25 ; prise en charge d’images de résolution supérieure à 4.6.
Cette version met l’accent sur l’ingénierie complexe, la précision des instructions et la vérification du résultat. Interfaces, schémas et dépôts de code sont des cas utiles. Vérifiez l’identifiant disponible dans l’API : le modèle actuel par défaut de l’application peut être différent.
Willison a mesuré environ 1,46 fois plus de tokens sur un texte long avec le nouveau tokenizer. Ce n’est pas un multiplicateur universel de facture. Sa comparaison d’un pélican en SVG préférait même un petit modèle local, rappelant qu’une tâche créative peut donner un autre ordre.
Tests et compromis: Mesurez vos propres documents, tokens et coûts finaux. Des tarifs unitaires identiques ne garantissent pas une dépense identique ; quelques points de classement ne résument pas la mise à jour.
Informations officielles · Utilisation en ligne / API · API / Claude Platform
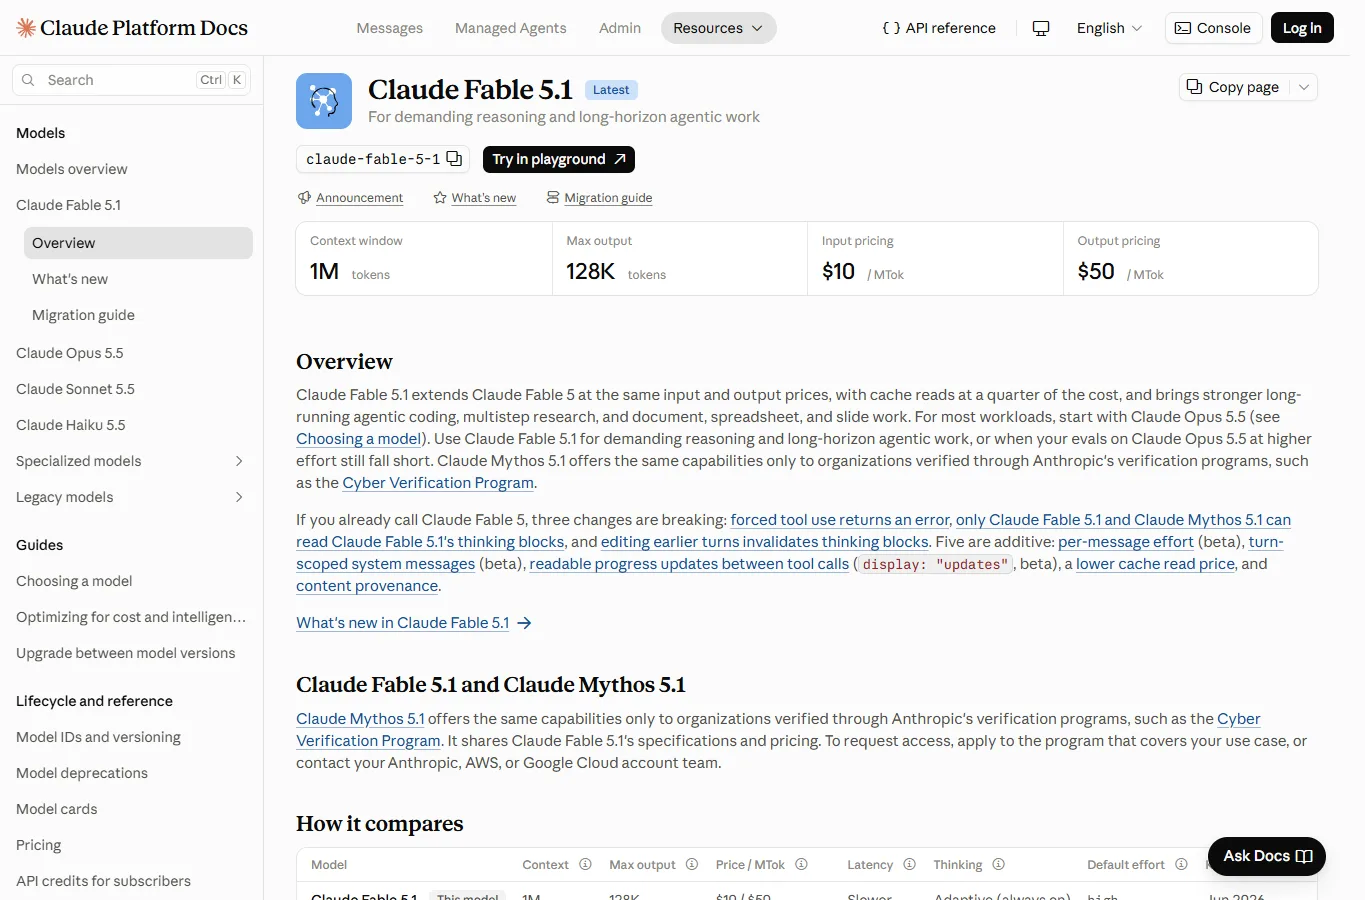
7. Claude Fable 5.1 (max) — Travail exigeant, avec un intérêt particulier pour le cache
Caractéristiques clés: Paramètres non publiés ; contexte de 1M ; sortie de 128K ; $10 / $50 ; lecture du cache à $0,25 par million.
Il devient pertinent si l’analyse, la rédaction ou les agents économisent beaucoup de révision humaine. La réduction concerne surtout les lectures du cache : les tarifs ordinaires d’entrée et de sortie restent ceux de Fable 5. Réutiliser un contexte long est différent d’envoyer de courtes questions nouvelles.
Fable 5.1 est généralement disponible, notamment via l’API Claude ; Mythos 5.1 reste restreint. Le test de No Code MBA avec un développeur pose la question du surcoût pour la création quotidienne d’applications.
Tests et compromis: Essayez d’abord une solution moins chère et payez davantage si le livrable le justifie. Tous les abonnements ne reproduisent pas nécessairement le max d’Arena.
Informations officielles · Utilisation en ligne / API · API / Claude Platform
8. Claude Opus 4.6 (autre entrée Arena) — La même famille, pas un autre produit
Caractéristiques clés: Famille Opus 4.6 ; paramètres non publiés ; contexte de 1M ; $5 / $25.
L’absence du suffixe high ne prouve pas que le raisonnement est désactivé : la ligne ne décrit pas tous les réglages. L’écart avec l’entrée high est de cinq points, avec une incertitude qui se chevauche.
Les accès et les retours sur la famille sont ceux du cinquième modèle. Cette ligne aide à réfléchir au niveau d’effort, pas à choisir un autre abonnement. Dix familles distinctes nécessiteraient une autre méthode de sélection.
Tests et compromis: Cette entrée ne constitue pas un nouveau produit avec sa propre fiche technique ou un test indépendant. Reportez-vous au numéro cinq et à la documentation Opus 4.6.
Informations officielles · Utilisation en ligne / API · API / Claude Platform
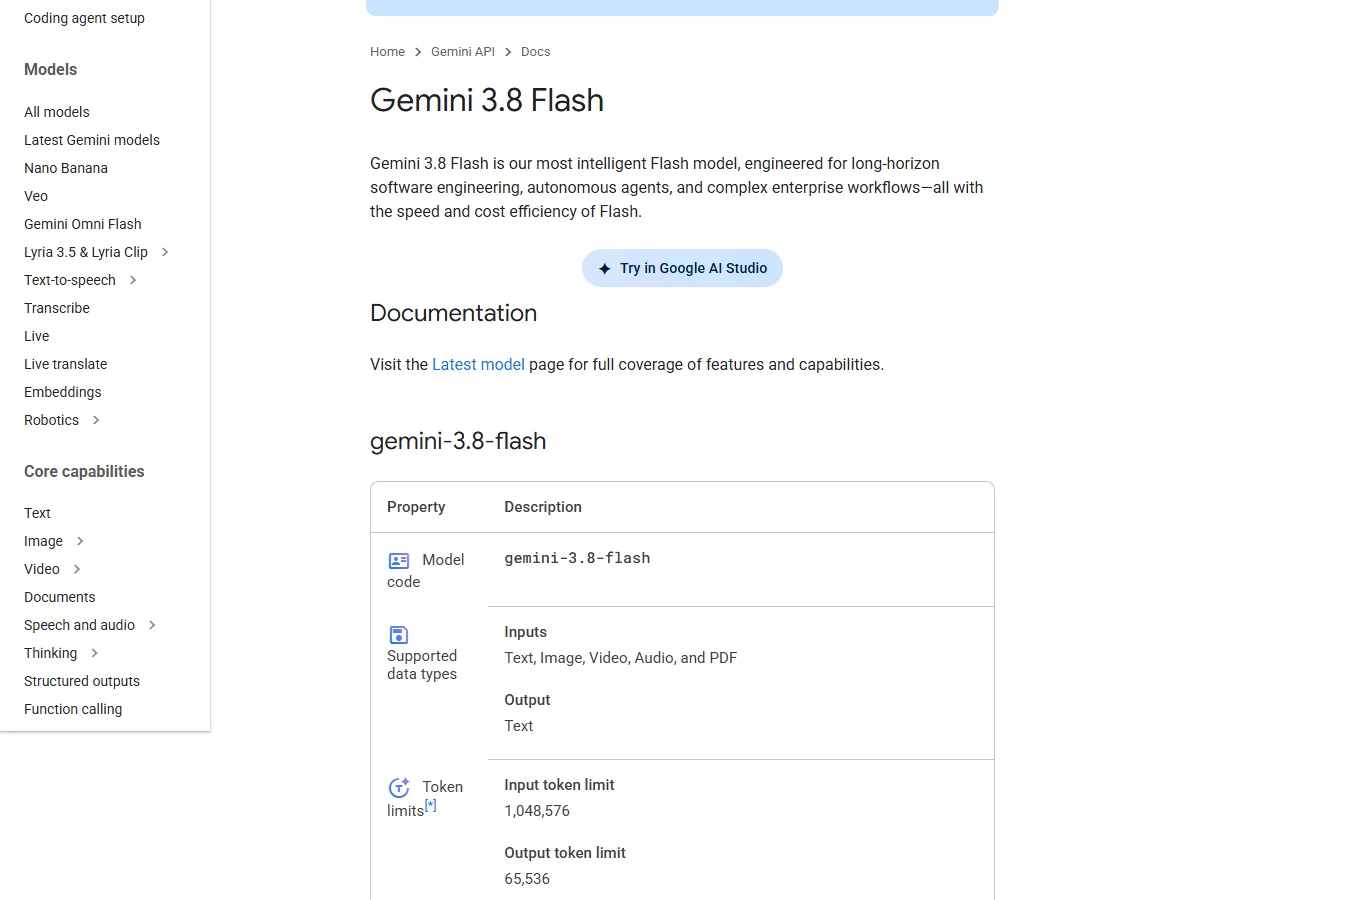
9. Gemini 3.8 Flash (high) — La référence économique de ce top 10
Caractéristiques clés: Paramètres non publiés ; entrée de 1 048 576 et sortie de 65 536 tokens ; images, audio, vidéo et PDF ; tarifs de lancement $0,75 / $3,75.
Il est intéressant pour traiter régulièrement des documents ou poser des questions sur des vidéos. Les accès passent par les offres Gemini compatibles, AI Studio et Gemini API. High ne garantit pas une réponse immédiate : mesurez la durée complète, pas seulement les tokens par seconde.
Tom’s Guide présente la compréhension native de vidéo comme une différence pratique. C’est une explication de capacité, pas une comparaison contrôlée de qualité globale. Pour des cours enregistrés ou des clips, ce critère peut compter davantage que quelques places.
Tests et compromis: Utilisez Flash comme base économique, puis réservez un autre modèle aux cas difficiles. Le score provisoire et les prix de lancement peuvent changer.
Informations officielles · Utilisation en ligne / API · API / AI Studio
10. Muse Spark 1.2 (xHigh) — Une ancienne version abordable : vérifiez le modèle exact
Caractéristiques clés: Paramètres non publiés ; contexte N/A dans Arena ; $1,25 / $4,25. Les spécifications de Spark 1.3 ne sont pas automatiquement celles de 1.2.
L’annonce d’origine met en avant la planification et le travail prolongé sur des dépôts, avec Muse Code et Meta Model API. La page principale promeut désormais 1.3 ; vérifiez si votre fournisseur propose encore exactement 1.2.
Dans un test publié sur Reddit, un développeur de service de revue de code a apprécié la vitesse et la détection de bugs. C’est un petit essai autodéclaré par un acteur intéressé, pas une preuve générale que xHigh égale tous les modèles haut de gamme.
Tests et compromis: À inclure dans une comparaison de coûts si la version reste accessible. Ne choisissez pas une ancienne version uniquement parce qu’elle devance 1.3 d’une place.
Informations officielles · Utilisation en ligne / API · API / Meta
Quel modèle essayer selon votre besoin ?
Documents, audio et vidéo : Argon pour les cas difficiles, Flash pour les opérations répétées. Nouveau flux Claude : Opus 5.5 d’abord, Fable 5.1 si sa qualité réduit réellement le travail humain.
Agents persistants : testez Wonder avec vos outils réels. Si vous utilisez déjà Opus 4.6/4.7 ou Fable 5, vérifiez les régressions avant une migration. Une ancienne version peut rester utile sans être le meilleur nouvel abonnement.
Répétez trois tests identiques : une question vérifiable, un vrai document ou changement de code, et une rédaction en français. Notez erreurs, corrections, durée et coût. Vérifiez le ton et les conventions françaises, qui ne sont pas garantis par les bons avis en anglais.
Questions avant de souscrire
Pourquoi ChatGPT, DeepSeek et Qwen sont-ils absents ?
La liste reprend les dix premières entrées de Text Arena Overall à la date indiquée. ChatGPT est une application ; les modèles OpenAI occupent d’autres rangs. Les places ne sont pas réparties par marque, et une autre catégorie donne un autre classement.
High et max indiquent-ils la taille du modèle ?
Non, ce sont des configurations de raisonnement ou d’évaluation. Les paramètres ne sont pas divulgués dans les spécifications citées ; contexte, sortie et tarifs sont des informations publiées plus utiles.
Peut-on tous les essayer gratuitement ?
Non. Arena permet des comparaisons, sans garantir l’accès gratuit à tous les modèles, réglages et outils. Abonnements, playgrounds et API suivent des conditions distinctes.
Pourquoi un ancien modèle dépasse-t-il son successeur ?
Préférences de texte, prompts, effort et échantillons diffèrent des tests de code ou d’agents. Un petit écart avec des intervalles superposés ne prouve pas une supériorité générale.
Quel est le moins cher ?
Flash affiche ici les tarifs de base les plus bas. Mais raisonnement, reprises, cache et longueur modifient la facture ; comparez le coût d’une tâche correctement terminée.
Peut-on les télécharger pour travailler hors ligne ?
Il s’agit de modèles propriétaires hébergés, pas de poids téléchargeables pour une exécution locale. Pour le hors-ligne, cherchez une sélection de modèles ouverts ; en ligne, vérifiez les contrôles de données du service.
Commencez par comparer deux modèles
Comparez d’abord Opus 5.5 et Argon en qualité, avec Flash comme référence économique. Ajoutez Wonder si les agents sont essentiels ; les anciennes versions de Claude et Spark servent surtout à comparer des systèmes déjà en place.
Gardez le modèle qui fournit un résultat juste et exploitable avec le moins de corrections coûteuses. Arena est un indicateur ; votre travail terminé tranche.
À lire aussi : modèles locaux et chatbots: LLM locaux · Chatbots IA
Connexes Évaluations
MiniMax H3 Image Studio : avis, images ComfyUI et références pour la vidéo

Krea 2 Edit : avis, téléchargements, workflows ComfyUI et exemples de prompts
Test d’Ideogram 4.0 : texte, ComfyUI, limites de censure et NSFW

Gemini 4 Argon : avis, prix, programmation et limites NSFW
Test de Gemma 4 : installation locale, GPU et politique NSFW
Test de Seedance 2.5 : fonctions, expérience réelle et limites du modèle vidéo IA