
LM Studio es un buen punto de partida si quieres descargar un modelo y conversar mediante una interfaz gráfica. Elige Ollama para conectar otras aplicaciones a un motor local; Jan si prefieres un chat de escritorio de código abierto; GPT4All para consultar carpetas sencillas, o AnythingLLM para organizar documentos en espacios de trabajo.
Estas aplicaciones se centran en modelos de lenguaje para redactar, consultar código y responder preguntas sobre documentos. No sustituyen a un entorno de generación de imágenes como ComfyUI. La aplicación administra el modelo, pero gran parte de la calidad depende del propio modelo: cambiar de interfaz no convierte uno pequeño en un sistema de nube de última generación.
Actualizado el 14 de octubre de 2026
Qué aplicación elegir según tu objetivo
Decide según la tarea, no según el número de modelos del catálogo. Las cinco permiten empezar con inferencia local gratuita; el equipo, la electricidad, el almacenamiento, los servicios remotos opcionales y la licencia del modelo son cuestiones aparte. Esta comparación es por usos, no un ranking de velocidad medido en el mismo equipo.
| Aplicación | Ideal para | Coste del uso local | Limitación principal |
|---|---|---|---|
| LM Studio | Buscar modelos y chatear con interfaz gráfica | Modalidad local gratuita | Revisar arquitectura del Mac y opciones de nube |
| Ollama | API local e integraciones | Motor local gratuito | Los documentos pueden requerir otra interfaz |
| Jan | Chat de escritorio de código abierto | Uso local gratuito | Compatibilidad entre modelo y motor |
| GPT4All | Colecciones sencillas de documentos | Aplicación gratuita | Las arquitecturas nuevas pueden no funcionar |
| AnythingLLM | Espacios de trabajo y consultas documentales | Desktop gratuito | Más configuración; Desktop es monousuario |
5 aplicaciones y cómo empezar
1. LM Studio: para empezar sin depender de la terminal
LM Studio reúne búsqueda, descarga, chat y servidor local. Ejecuta GGUF mediante llama.cpp y admite MLX en Apple Silicon. Es práctico para comparar dos modelos pequeños, revisar cómo redactan en español y ajustar el contexto sin montar otro servidor. También permite adjuntar documentos para hacer preguntas.
El sitio actual presenta además Bionic y servicios opcionales de inferencia en la nube. El uso de modelos locales está incluido en la modalidad gratuita; no necesitas contratar nube para una conversación local normal. Sin embargo, un modelo remoto o una herramienta de búsqueda web siguen enviando solicitudes fuera del equipo.
Sitio oficial · Documentación de configuración
Primeros pasos
- Descarga la versión para tu sistema. Comprueba el procesador del Mac: los requisitos publicados de LM Studio Desktop excluyen los Mac Intel.
- Busca un modelo pequeño ajustado para instrucciones y una cuantización que deje memoria libre para el sistema.
- Cárgalo y haz una pregunta breve. Si quieres conectar otra aplicación, inicia el servidor local y copia la dirección que muestre tu versión.
Los requisitos oficiales recomiendan 16 GB de RAM. En los Mac compatibles se necesita macOS 14 o posterior; Windows x64 requiere AVX2. Cumplirlos no garantiza que quepa cualquier modelo.
2. Ollama: para utilizar el mismo motor desde varias aplicaciones
Ollama resulta útil como servicio local para asistentes de programación, clientes de documentos y scripts. Ofrece instalación nativa en Windows y Mac, sin que Docker sea el primer paso obligatorio. También tiene interfaz de escritorio: no es correcto describirlo como una herramienta exclusivamente de terminal.
Su ventaja es reutilizar un mismo motor con distintos clientes. Una biblioteca documental completa puede depender de la aplicación que conectes. Selecciona expresamente un modelo local: los modelos de nube se ejecutan fuera del ordenador. La inferencia local no necesita una clave de API de nube.
Sitio oficial · Documentación de configuración
Primeros pasos
- Instala Ollama y elige un modelo local desde la aplicación o la biblioteca oficial, comprobando su tamaño.
- Usa los comandos siguientes para listar modelos descargados, ejecutar el nombre exacto y consultar su ubicación en CPU/GPU. Sustituye MODEL_NAME por un nombre de la lista.
- Configura el cliente con el endpoint local, normalmente http://localhost:11434. Para uso personal, conserva el acceso limitado al propio equipo.
ollama list
ollama run MODEL_NAME
ollama ps
La documentación contempla CPU en Mac Intel compatibles con macOS 14 o posterior, y aceleración GPU en Apple Silicon. Para desactivar las funciones de nube, configura OLLAMA_NO_CLOUD=1 y reinicia, siguiendo su FAQ.
3. Jan: para quienes prefieren una aplicación abierta
Jan combina una ventana de chat familiar con gestión de modelos locales en una aplicación de código abierto. Su Hub permite encontrar descargas y muestra orientaciones de ajuste al hardware. Elige archivos compatibles con el motor seleccionado: llama.cpp y MLX en Apple Silicon no utilizan necesariamente la misma ruta.
También puedes añadir proveedores remotos. Es cómodo, pero ver el nombre de un modelo en una aplicación instalada no demuestra que se ejecute localmente. Jan ofrece servidor API local; consulta la dirección en tu versión en lugar de copiar el puerto de un tutorial antiguo.
Sitio oficial · Documentación de configuración
Primeros pasos
- Instala Jan y descarga desde Hub un modelo local pequeño que se ajuste a tu equipo.
- Selecciona el modelo descargado en un chat nuevo y prueba un resumen o una reescritura en español.
- Activa el servidor solo si necesitas una API. Para trabajar sin conexión, prescinde de proveedores remotos y herramientas web.
Si falla la carga, revisa primero la arquitectura del modelo y el motor de inferencia; cambiar de cuantización repetidamente no resuelve una incompatibilidad de arquitectura.
4. GPT4All: para consultar una carpeta de documentos
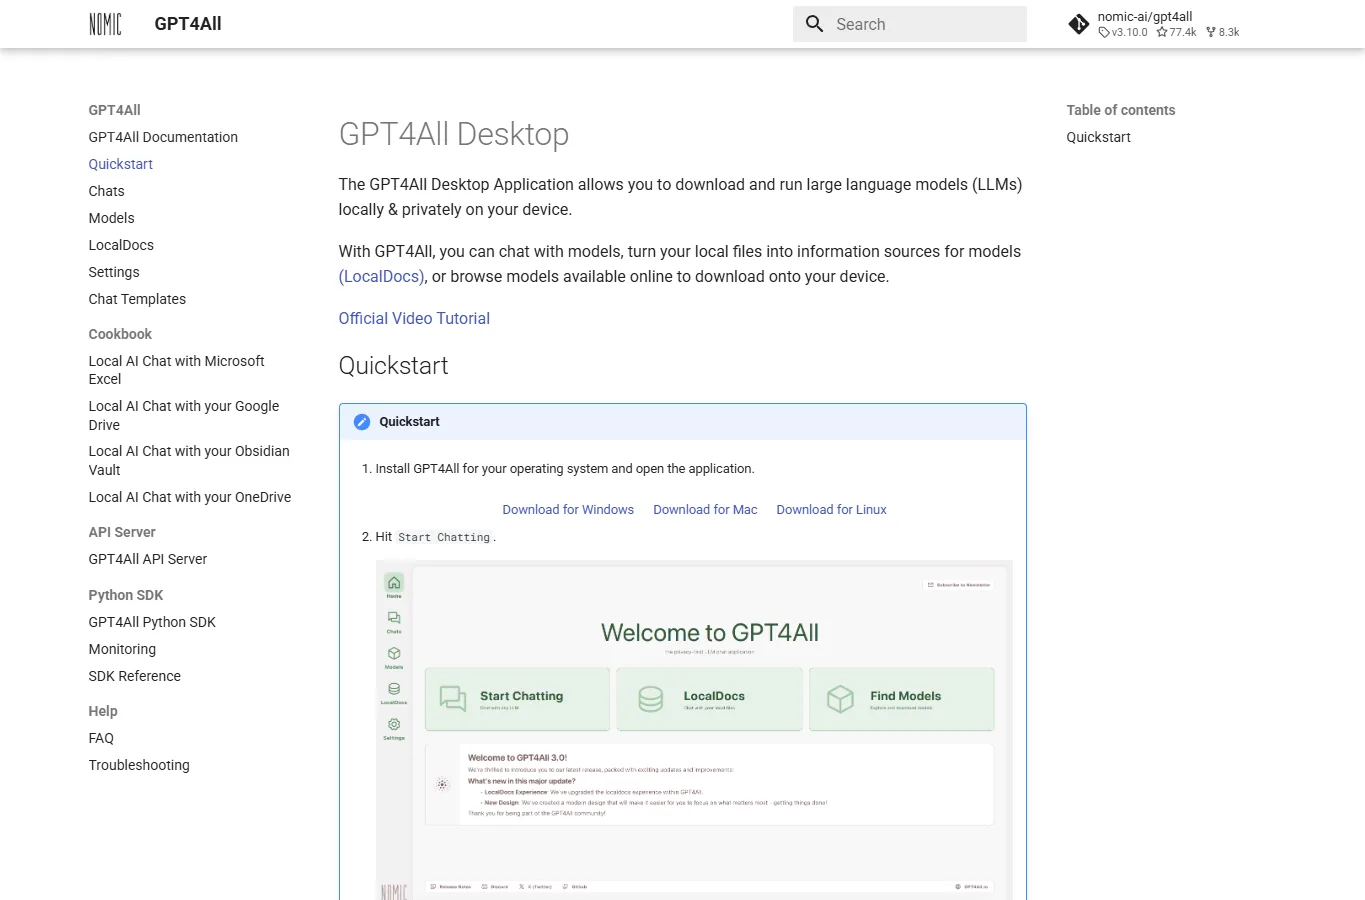
GPT4All incluye LocalDocs, una función que convierte carpetas seleccionadas en colecciones consultables. Encaja con manuales, apuntes o un pequeño archivo de investigación cuando no necesitas un servidor para varias personas. Descargas un modelo compatible y seleccionas la colección adecuada dentro del chat.
La recuperación de documentos no entrena permanentemente al modelo con cada página. Busca fragmentos relevantes y los incorpora al contexto. Una búsqueda incompleta o un PDF escaneado sin texto legible puede producir respuestas deficientes. Empieza por documentos cuyo contenido conozcas.
Sitio oficial · Documentación de configuración
Primeros pasos
- En Models, utiliza Add Model para descargar un modelo compatible y comprueba el chat.
- Crea una colección LocalDocs con una carpeta pequeña y espera a que termine la indexación. Descarga también el modelo local de embeddings necesario.
- Selecciona la colección, pregunta por un dato conocido y verifica el fragmento de apoyo. No atribuyas al documento una respuesta sin evidencia.
El nombre no significa que GPT-4 de OpenAI se ejecute en tu PC. Tampoco basta con que un archivo termine en GGUF: el motor debe admitir su arquitectura.
5. AnythingLLM: para organizar documentos por proyecto
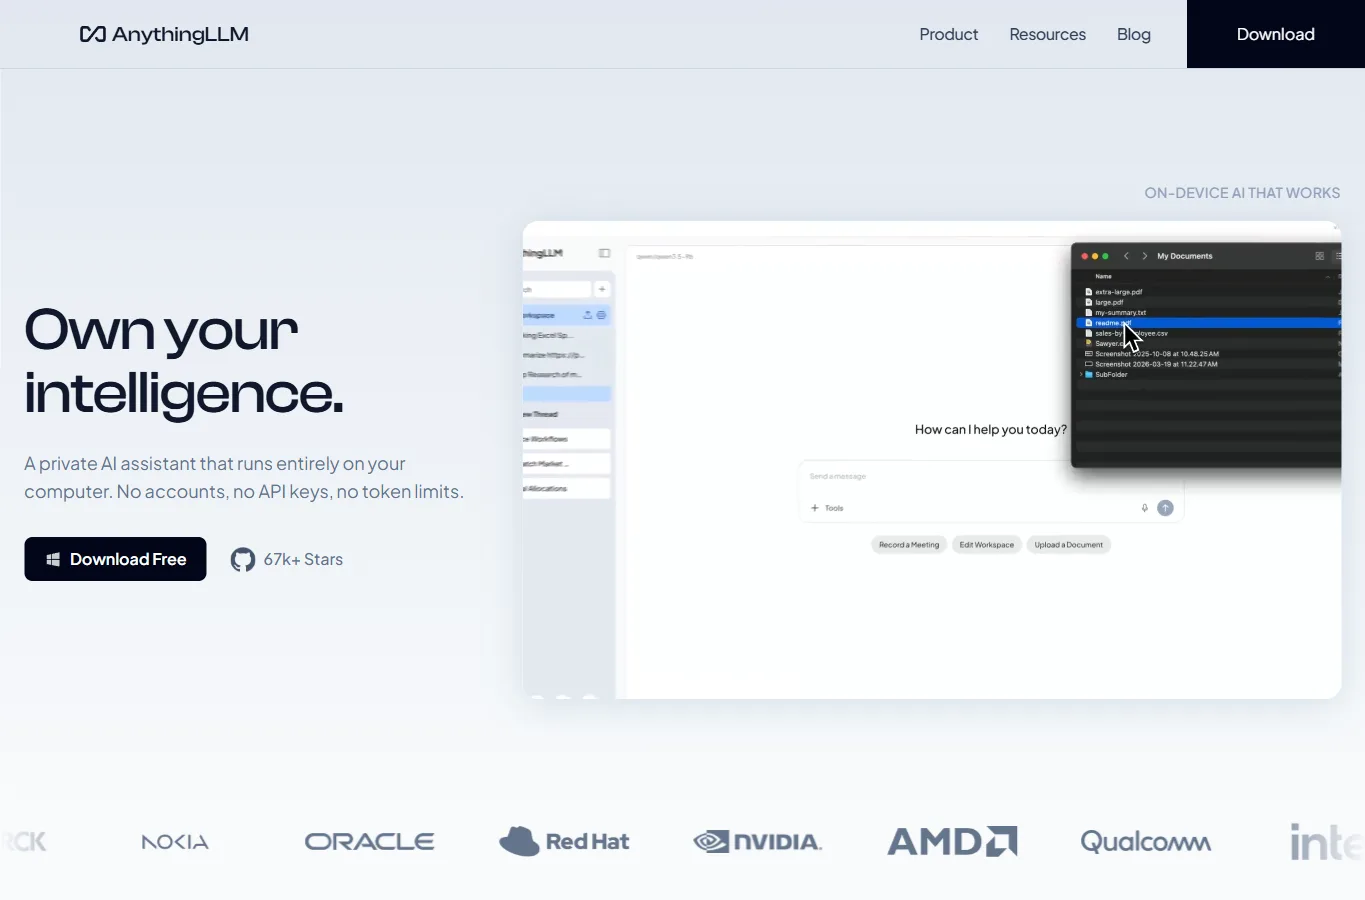
AnythingLLM estructura la información en espacios de trabajo: uno para especificaciones, otro para material de estudio, por ejemplo. Combina chat, recuperación documental y funciones opcionales de agentes. Desktop incluye una ruta de ejecución local y también puede conectarse a Ollama. Es especialmente útil cuando tu colección de documentos va creciendo.
Comprueba el modelo de chat, el proveedor de embeddings y el almacenamiento. Un chat local con embeddings enviados a una API remota no constituye un flujo totalmente local. Desktop está orientado a una sola persona; las cuentas y permisos compartidos corresponden a la alternativa de servidor/Docker.
Sitio oficial · Documentación de configuración
Primeros pasos
- Instala Desktop y selecciona proveedores locales para chat y embeddings. Si eliges Ollama, inícialo primero.
- Crea un espacio, añade unos pocos documentos legibles y completa la indexación. Separa proyectos no relacionados.
- Pide respuestas con pasajes de origen. Añade herramientas de agente después de comprobar la recuperación básica y revisar sus permisos.
Separar espacios mejora la organización, pero no equivale a disponer de autenticación y permisos de un servidor multiusuario.
Qué hardware necesitas realmente
Estas son sugerencias prudentes para empezar, no requisitos mínimos oficiales ni promesas de velocidad. Debes dejar memoria para el modelo, su trabajo temporal, el sistema y otras aplicaciones.
| Equipo disponible | Punto de partida sugerido |
|---|---|
| 8 GB de memoria | Prueba un modelo cuantizado pequeño de aproximadamente 1–3B y conversaciones cortas; cierra otras aplicaciones. |
| 16 GB de memoria | Un modelo de aproximadamente 4–8B en Q4 puede ser un primer experimento si su consumo real cabe con margen. |
| 32 GB o más | Explora modelos mayores o más contexto, calculando antes la memoria del modelo concreto. |
| Windows con poca VRAM | La descarga parcial de trabajo a CPU puede funcionar, pero ralentiza. RAM y VRAM no son una bolsa intercambiable. |
| Mac con Apple Silicon | La memoria unificada se comparte con el sistema y la GPU; no reserves toda la capacidad al modelo. |
Q4 reduce la precisión de los pesos para ahorrar memoria; no significa que basten cuatro gigabytes. Un contexto más largo exige recursos adicionales. Compara velocidad con el mismo modelo, cuantización, texto y contexto en el mismo ordenador.
Tu primera sesión de IA local
- Elige una aplicación y una tarea pequeña: redactar, explicar código o consultar un documento.
- Descarga conectado la aplicación, el motor, el modelo de lenguaje y los embeddings necesarios. Varias cuantizaciones pueden duplicar muchos gigabytes.
- Empieza con un modelo de instrucciones pequeño y contexto moderado. Pídele reescribir un párrafo sin cambiar nombres ni fechas.
- Para documentos, usa un archivo con texto seleccionable y pregunta por un dato verificable. Comprueba tildes, tablas y la variante de español que necesitas.
- Desconecta la red y repite en un chat nuevo. Es una comprobación práctica del funcionamiento sin conexión, no una auditoría completa de seguridad.
Utiliza únicamente el texto proporcionado. Enumera decisiones, plazos explícitos y preguntas pendientes. Incluye un breve fragmento de apoyo para cada punto. Si falta información, indícalo; no inventes fechas ni compromisos.Privacidad, funcionamiento sin conexión y costes
La inferencia local evita una factura por tokens del proveedor, pero no elimina el coste del ordenador, la electricidad o el almacenamiento. Los servicios alojados y las API remotas son opcionales y se cobran aparte. No necesitas una suscripción para probar un modelo local pequeño con estas opciones.
La privacidad depende del endpoint, los embeddings, las herramientas web, los conectores, los registros y las carpetas sincronizadas. Un historial local guardado en una carpeta sincronizada puede salir del equipo.
Ejecutar un modelo local no anula su licencia ni cambia automáticamente sus negativas. El roleplay y el contenido adulto dependen del modelo y de los servicios conectados, no del nombre del lanzador. Revisa las condiciones de ambos antes del uso comercial.
Problemas habituales y soluciones
El modelo no carga
Verifica formato, arquitectura y motor. Después prueba una cuantización menor, reduce contexto y libera memoria.
Las respuestas son lentas
Distingue la carga inicial de la generación. Revisa GPU, ahorro de energía y presión de memoria; en Ollama, consulta ollama ps.
Ignora el documento
Confirma que la indexación terminó y está seleccionada la colección correcta. Los PDF escaneados pueden necesitar OCR previo.
La API local no responde
Revisa servidor, puerto y nombre del modelo. Dentro de Docker, localhost no señala al mismo lugar que en el equipo anfitrión.
Preguntas frecuentes
¿Funcionan sin internet?
Sí, después de descargar todos los componentes y elegir un flujo local. La nube, las búsquedas web y los conectores remotos siguen necesitando internet; prepara también los embeddings para documentos.
¿Necesito una GPU NVIDIA?
No. Los modelos pequeños pueden utilizar CPU. Apple Silicon, AMD e Intel tienen rutas de aceleración según la aplicación y el motor; comprueba tu versión y controladores.
¿Qué opción sirve para Mac Intel?
LM Studio Desktop los excluye en sus requisitos publicados. Ollama documenta ejecución por CPU en Mac Intel compatibles con macOS 14 o posterior. Verifica el instalador antes de descargar modelos grandes.
¿Cambiar de aplicación mejora las respuestas?
Influyen más el modelo, su cuantización y las instrucciones. La interfaz puede mejorar recuperación y plantillas, pero no garantiza exactitud. Compara con tus propios textos.
¿También generan imágenes y vídeo?
Esta selección se centra en lenguaje. Comprender imágenes no equivale a generarlas: utiliza un flujo de generación compatible, como ComfyUI, con sus modelos y requisitos específicos.
¿Puedo conectar el motor a otra aplicación?
Sí, si las API son compatibles. Verifica URL base, nombre del modelo y funciones admitidas; compatibilidad con OpenAI no significa implementar todas sus funciones.
Empieza con una aplicación y un modelo pequeño
Empieza por LM Studio o Jan si buscas sencillez visual. Elige Ollama si tu integración ya lo utiliza. Para documentos, GPT4All encaja con una colección modesta y AnythingLLM con espacios de trabajo organizados.
Comprueba primero calidad en español, memoria y funcionamiento sin conexión con una tarea pequeña. Aumenta tamaño o documentos gradualmente. Si necesitas elegir el modelo, consulta la comparación enlazada a continuación.
Guías relacionadas: Mejores LLM locales de código abierto en 2026: rendimiento, NSFW y comparativa de hardware · Cómo montar una estación de IA con GPU en la nube: imágenes, vídeo, LLM y NSFW (2026) · SillyTavern: guía para principiantes en 2026, fichas de personaje y lorebooks
Relacionados
Top 7 potenciadores de fotos con IA para 2026: mejora tus imágenes al instante

Las mejores herramientas de imagen a texto en 2025: precisas, rápidas y gratuitas
Descargar música de YouTube: cómo bajar canciones de YouTube de forma segura y fácil
Mejores generadores de efectos de sonido con IA para vídeos, juegos y podcasts

Deepseek vs ChatGPT: La Comparativa Definitiva de Modelos de Lenguaje en 2025
Mejores sitios gratis para descargar YouTube Shorts