Cómo montar una estación de IA con GPU en la nube: imágenes, vídeo, LLM y NSFW (2026)
Monta ComfyUI y SillyTavern con una GPU alquilada. Guía de costes, VRAM, vídeo, modelos de lenguaje, almacenamiento y límites NSFW.

Puedes convertir un portátil corriente en el centro de control de una estación de IA: alquilas la GPU, ejecutas ComfyUI para imágenes y vídeo y conectas un modelo de lenguaje a SillyTavern. Evitas comprar una tarjeta cara para unas pocas sesiones, pero asumes la instalación, la seguridad, el almacenamiento y el apagado de la máquina.
Qué incluye realmente una GPU alquilada
Empieza con una GPU, almacenamiento persistente y una tarea cada vez. Los pesos y el cálculo están en el servidor; el navegador sirve para controlarlos. SillyTavern puede quedarse en tu ordenador, con sus personajes y conversaciones, mientras KoboldCpp ejecuta el modelo remoto.
Alquilar hardware no incluye automáticamente modelos, derechos comerciales, permiso para contenido adulto ni un escritorio remoto completo. ComfyUI organiza flujos; KoboldCpp sirve el LLM; SillyTavern es la interfaz de conversación. Si solo quieres unas imágenes terminadas, un servicio gestionado puede ahorrarte trabajo.
| Opción | Para quién | Coste o límite principal |
|---|---|---|
| Servicio de IA gestionado | Resultados rápidos | Modelos, cuotas y políticas del proveedor |
| GPU alquilada | Flujos y pesos personalizados | Instalación, almacenamiento y acceso |
| GPU propia | Uso frecuente y control local | Compra, electricidad, calor y VRAM |
Runpod y Vast.ai: dos formas de empezar
Runpod ofrece una plantilla oficial de ComfyUI y una guía de Pods, por lo que es un punto de partida claro. Para trabajar de forma interactiva, elige un Pod On-Demand. Un endpoint Serverless no equivale a una estación persistente. Las GPU Blackwell, como la RTX 5090, necesitan la plantilla correspondiente.
Vast.ai conviene a quien sabe comparar ofertas de máquinas. Revisa fiabilidad del host, ubicación, RAM, disco, transferencia y condiciones, además de la GPU. Una instancia interrumpible puede servir para lotes recuperables, pero no es la opción inicial para una sesión larga sin guardar. No existe una tarifa única para todas sus máquinas.
Comprueba el resumen antes de desplegar. Un disco lento, un entorno CUDA incompatible o descargar los pesos repetidamente pueden anular el ahorro. Reserva un primer uso corto con un presupuesto pequeño.
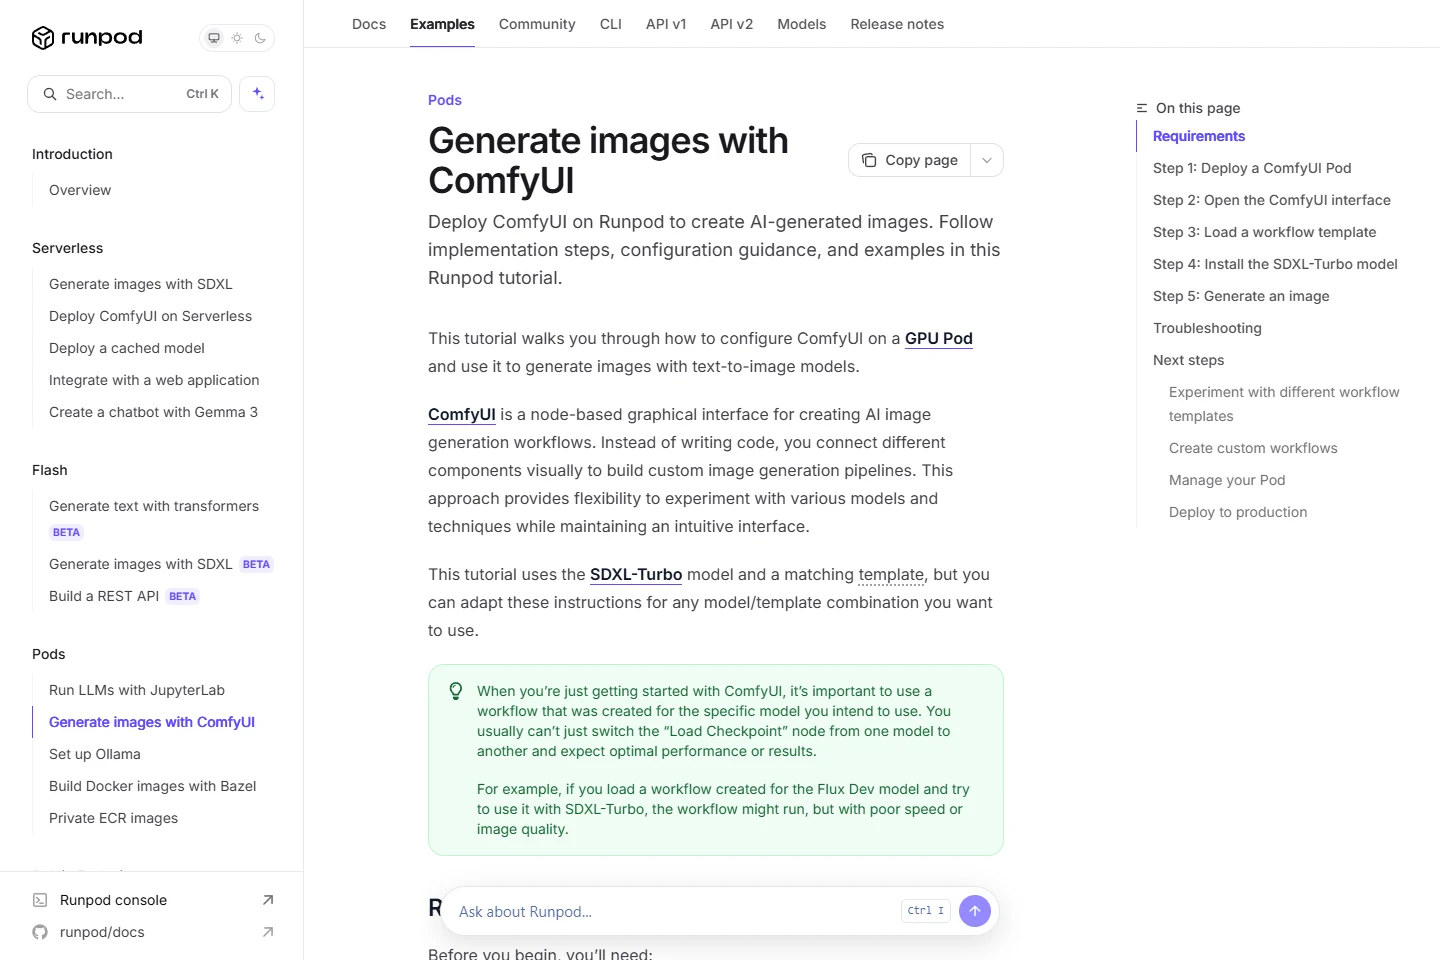
Runpod · ComfyUI · Vast.ai · Pricing
VRAM y disco: dimensiona el flujo, no solo el modelo
Estas cifras son orientativas. La cuantización, resolución, duración, lote y contexto cambian la memoria necesaria. La RAM del sistema no es VRAM: descargar parte del cálculo a CPU puede evitar un fallo y, a la vez, reducir mucho la velocidad.
Para una estación de uso mixto, 24 GB es un comienzo razonable. Calcula inicialmente 100–200 GB de disco para una selección de pesos, cachés y resultados, y verifica el tamaño real de los archivos. Dos modelos que caben por separado pueden no caber juntos.
| Uso | Punto de partida | Precaución |
|---|---|---|
| Imágenes básicas | 12–24 GB VRAM | Edición, ControlNet y lotes grandes añaden memoria |
| Wan2.2 TI2V-5B | 24 GB con el offload documentado | No se aplica a todos los modelos de vídeo |
| LLM cuantizado de 7B–14B | 16–24 GB, con margen | Reserva memoria para contexto y caché KV |
| Modelos mayores o vídeo largo | Valorar 48–80 GB | Verificar el flujo exacto |
Cuánto cuesta: también pagas mientras configuras
El 29 de septiembre de 2026, la página de Pods de Runpod muestra RTX A5000 24 GB a US$0,27/h, RTX 4090 24 GB a US$0,74/h y RTX 5090 32 GB a US$0,99/h. Son referencias públicas, no una garantía de disponibilidad ni el presupuesto final. Serverless tiene otra tabla.
Con la referencia del 28 de septiembre de 1 EUR = 1,1378 USD, equivalen aproximadamente a 0,24 €, 0,65 € y 0,87 €/h. La factura sigue expresada en dólares; cambio, impuestos y comisiones pueden modificar el cargo.
Ejemplo: 20 horas de 4090 a US$0,74 más 100 GB de volumen de red estándar a US$0,07/GB/mes suman US$21,80, unos 19,16 €, sin otros discos, impuestos ni transferencias aplicables. Dejar la GPU encendida 720 horas cuesta US$532,80 solo en cómputo. Descargar, instalar y dejarla inactiva también consume tiempo facturable.
Presupuesto = horas × tarifa + almacenamiento conservado + transferencia aplicable + impuestos/comisiones. Runpod diferencia disco de volumen en marcha (US$0,10/GB/mes), detenido (US$0,20) y volumen de red estándar inferior a 1 TB (US$0,07). Para comparar con comprar una GPU, utiliza tus horas reales y añade electricidad y mantenimiento.
Runpod · Pricing · Runpod · Storage · Banque de France · 28/09/2026
Primero consigue generar y guardar una imagen
Valida una imagen, su descarga y el archivo del flujo antes de instalar vídeo y chat. Es una guía de configuración, no un benchmark medido en una instancia de pago.
- Crea una cuenta y un recordatorio de gasto. Añade tu clave pública SSH si usarás un túnel; confirma región y disponibilidad.
- Elige la plantilla oficial ComfyUI de Runpod, o Blackwell Edition para RTX 5090/B200. Revisa GPU, RAM, discos y puertos del Pod On-Demand.
- Conecta almacenamiento persistente antes de descargar. Comprueba el punto de montaje y guarda allí modelos, flujos y resultados: llamarse /workspace no garantiza persistencia.
- Espera a la inicialización y revisa los registros. Comprueba la autenticación del acceso HTTP; una URL difícil de adivinar no protege el servicio. Para trabajo privado, usa un túnel SSH y retira los puertos HTTP públicos innecesarios.
- Abre Workflow → Browse Templates o importa un flujo oficial específico del modelo. Instala sus checkpoints, codificadores y VAE en el servidor, no solo en tu portátil.
- Ejecuta una imagen con dimensiones predeterminadas. Descarga el resultado y el JSON del flujo, confirma dónde se guardaron y después detén el Pod.
Prueba de imagen
Una tetera de cerámica sobre una mesa de madera junto a una ventana, luz suave de mañana, fondo neutro, fotografía de producto realista.
Runpod · ComfyUI · ComfyUI · Text to Image · Runpod · SSH
Selecciona el network volume al crear el Pod; no se añade después a uno existente. Este túnel de ComfyUI presupone que el servidor SSH alcanza 127.0.0.1:8188. Sustituye los marcadores, deja la terminal abierta y visita http://127.0.0.1:8188 en ese ordenador. ComfyUI debe estar ejecutándose: no inicies otra copia en el mismo puerto.
ssh -N -L 127.0.0.1:8188:127.0.0.1:8188 -p SSH_PORT -i KEY_PATH USER@POD_IPAñade vídeo con un flujo completo de Wan2.2
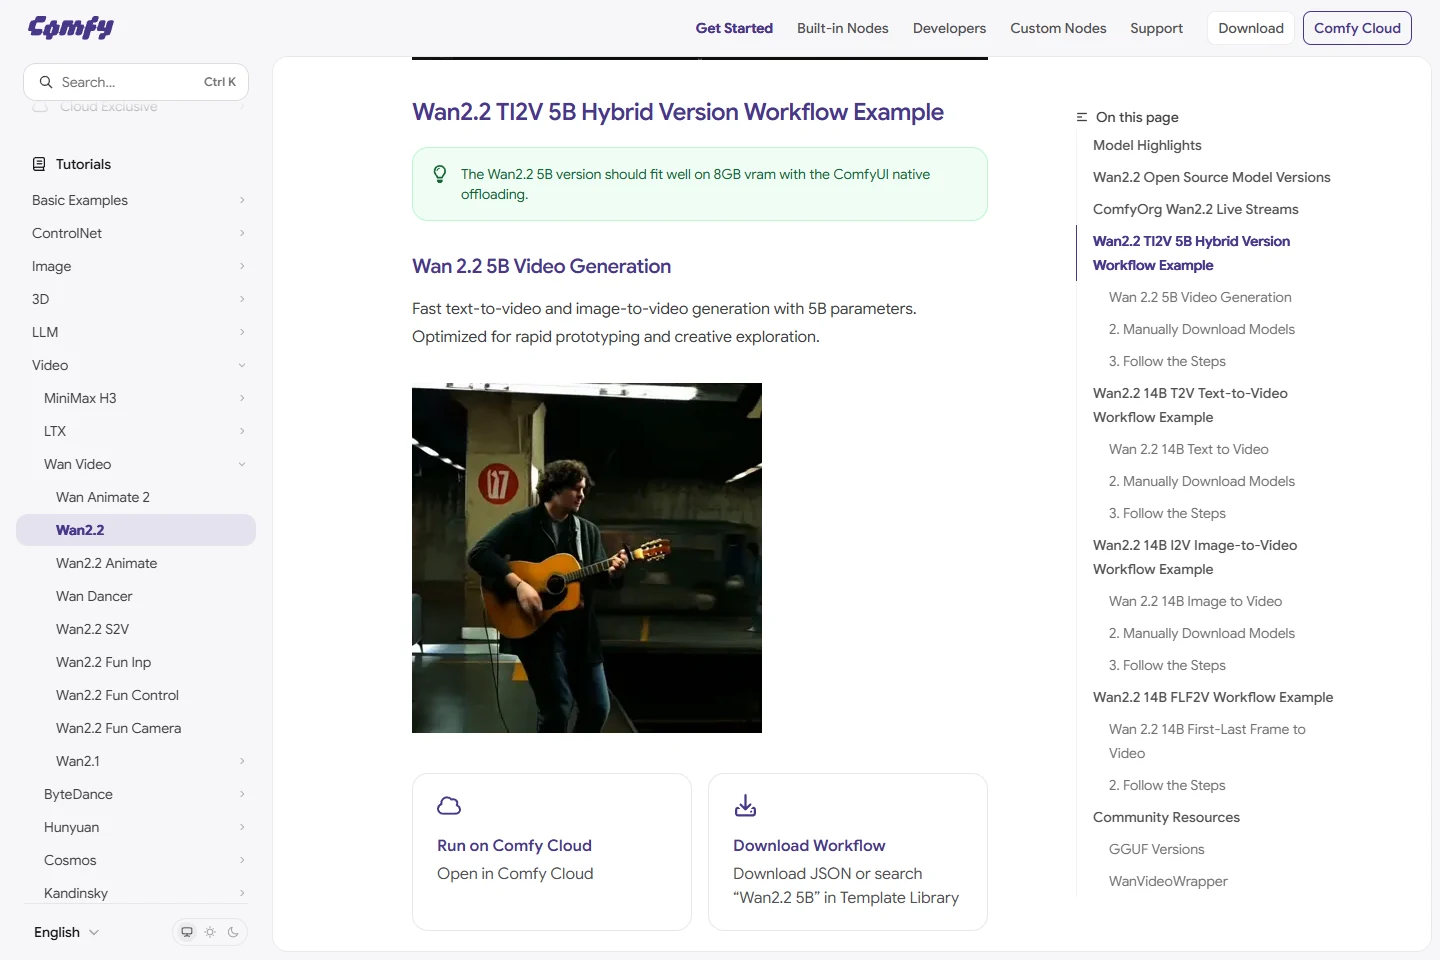
ComfyUI publica flujos y enlaces a los componentes de Wan2.2. El repositorio de TI2V-5B documenta una ruta 720p con al menos 24 GB, offload del modelo y codificador de texto en CPU. No significa que un flujo de vídeo 14B distinto tenga los mismos requisitos.
Importa el ejemplo TI2V-5B, coloca todos los componentes en sus carpetas y conserva las dimensiones y los fotogramas compatibles durante la primera prueba. Genera un clip corto antes de lanzar una cola. En imagen a vídeo, utiliza una imagen que puedas subir y describe el movimiento de la escena.
Guarda semilla, nombres de modelos, flujo y salida. Compara GPU con los mismos ajustes y separa la descarga/carga inicial de la generación. Los nodos Partner/API pueden llamar a un servicio externo de pago; no necesariamente usan la GPU alquilada.
ComfyUI también documenta una ruta optimizada con offload nativo para el modelo 5B con 8 GB. Es una configuración distinta al ejemplo de 24 GB del repositorio; menos memoria no garantiza la misma velocidad.
Movimiento para el vídeo
La cámara se acerca lentamente a la tetera. El vapor asciende suavemente; la mesa y el fondo permanecen inmóviles. Luz natural constante.
Conecta SillyTavern a un LLM remoto
Mantener SillyTavern en tu ordenador facilita conservar personajes y chats al cambiar de servidor. Sin embargo, las peticiones siguen procesándose en infraestructura ajena.
En Linux compatible con CUDA, descarga la versión Linux oficial de KoboldCpp y un GGUF de procedencia verificable. Revisa licencia y arquitectura compatible. El ejemplo supone que renombraste el ejecutable como koboldcpp-linux-x64 y el modelo como /workspace/models/model.gguf. Empieza con 4096 tokens y ajuste automático de capas; confirma en los registros que utiliza GPU.
chmod +x ./koboldcpp-linux-x64 ./koboldcpp-linux-x64 --model /workspace/models/model.gguf --usecuda --gpulayers -1 --contextsize 4096 --host 127.0.0.1 --port 5001El servidor escucha en su loopback. En tu ordenador, adapta el siguiente túnel con los datos completos SSH/TCP del proveedor. SSH_PORT, KEY_PATH, USER y POD_IP son marcadores. SSH y KoboldCpp deben compartir el espacio de red para este destino.
ssh -N -L 127.0.0.1:5001:127.0.0.1:5001 -p SSH_PORT -i KEY_PATH USER@POD_IP- Mantén la terminal SSH abierta. Prueba http://127.0.0.1:5001 en tu ordenador y envía un mensaje corto antes de configurar SillyTavern.
- En Windows, instala Node.js LTS y Git; descarga la rama release de SillyTavern en una carpeta escribible y ejecuta Start.bat sin permisos de administrador.
- En API Connections, selecciona Text Completion → KoboldCpp, introduce http://127.0.0.1:5001/ y pulsa Connect. Esta ruta no lleva /v1.
- Crea un personaje sencillo. Usa la plantilla de instrucciones adecuada al modelo y no superes el contexto del backend. Haz copia local de personajes y chats.
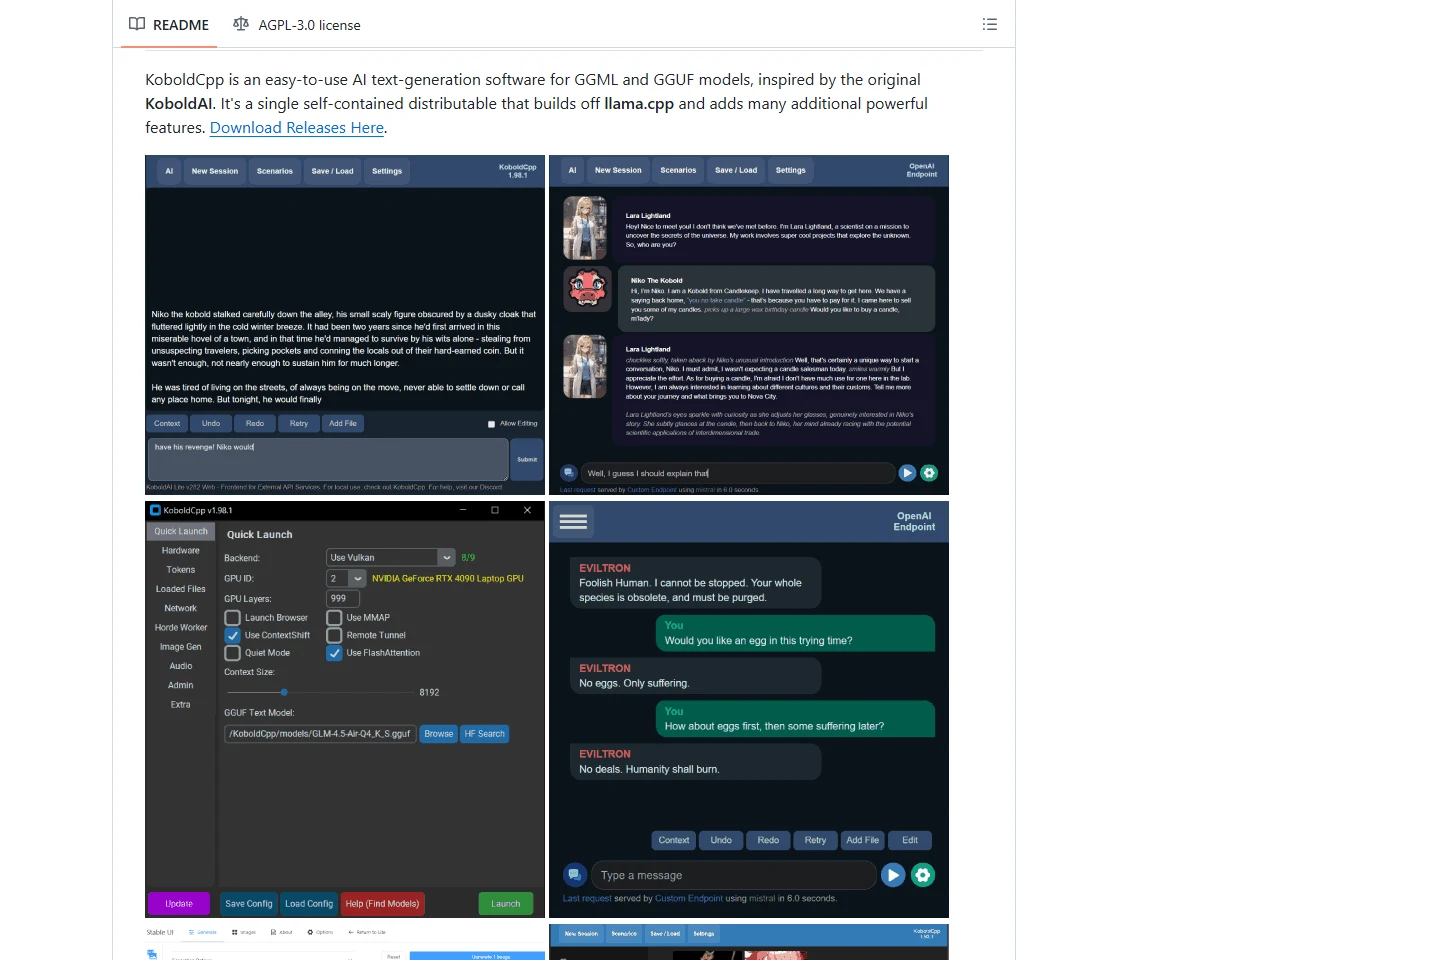
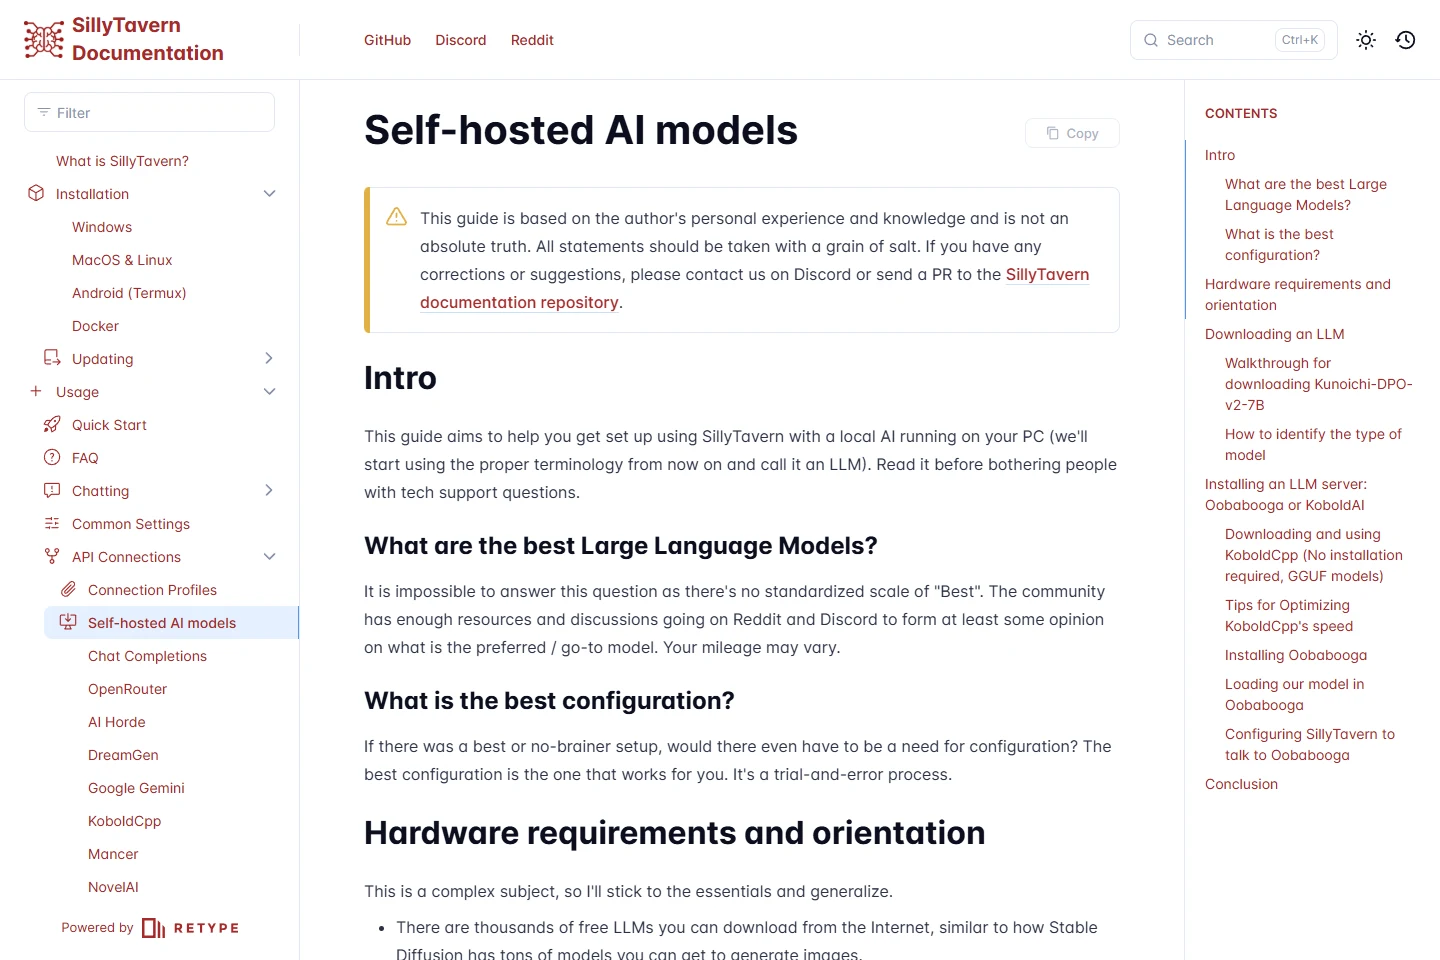
KoboldCpp · Releases · KoboldCpp · SillyTavern · Windows · SillyTavern · API · Runpod · SSH
NSFW: capacidad técnica y permiso son cosas distintas
Elegir tus propios pesos da flexibilidad, pero no crea un modo NSFW universal. El modelo puede rechazar contenido adulto, representarlo mal o imponer restricciones de licencia. Una ficha de personaje no cambia las condiciones del host ni de una API.
Runpod restringe contenido obsceno y lascivo en sus términos; Vast.ai también prohíbe almacenar o transmitir contenido obsceno mediante el servicio. No recomendamos ninguno como alojamiento adulto sin restricciones. Consulta el caso concreto con el proveedor antes de pagar.
Comprueba por separado las reglas del host, la licencia del modelo, las API externas y el lugar donde publicarás. Un equipo completamente local elimina la capa del proveedor de GPU, no el resto de obligaciones.
| Pregunta | Evaluación |
|---|---|
| ¿ComfyUI o SillyTavern garantizan NSFW? | No: son interfaces, depende del modelo y backend. |
| ¿Pesos abiertos significa uso ilimitado? | No: hay que leer la licencia concreta. |
| ¿La nube es totalmente privada? | No: protege el acceso y evita subir datos sensibles innecesarios. |
Runpod · Terms · Vast.ai · Terms
Copias, apagado y errores frecuentes
Conserva JSON, versiones de nodos, nombres y licencias de modelos, semillas, instrucciones y resultados útiles. No compartas claves API en un flujo. Descarga las copias antes de eliminar la máquina.
En Runpod, el disco del contenedor puede perder datos al detenerse; el volume disk sobrevive a la parada, pero se elimina con el Pod. Un network volume tiene su propio ciclo y factura. Detén cómputo y revisa aparte los volúmenes conservados. Reiniciar no garantiza que siga habiendo GPU disponible.
| Problema | Primera comprobación |
|---|---|
| Memoria insuficiente | Descarga otros modelos y reduce lote, contexto o fotogramas |
| Faltan nodos o pesos | Versión del flujo y rutas exactas |
| SillyTavern no conecta | Backend, túnel SSH y URL, en ese orden |
| Lentitud | Uso de GPU, offload a CPU, carga y disco |
| Sigue cobrando | Cerrar el navegador no detiene la instancia |
Preguntas frecuentes y recomendación
¿Necesito un PC potente?
No para este esquema remoto. Sí necesitas una conexión estable, espacio para copias y un equipo capaz de ejecutar la interfaz. Los vídeos grandes hacen importante la velocidad de transferencia.
¿Una GPU sirve para todo?
Puedes alternar tareas si cada modelo cabe. Ejecutarlas simultáneamente exige más VRAM; descarga el modelo anterior al cambiar de uso.
¿Dos GPU de 24 GB equivalen a una de 48 GB?
No automáticamente. El programa debe repartir el modelo y hay costes de comunicación. Una sola GPU suficiente simplifica la primera instalación.
¿Puedo usar el móvil?
Sí con una interfaz web protegida, pero el localhost del túnel pertenece al ordenador que lo ejecuta. Prepara acceso seguro específico; no publiques el servicio sin autenticación.
¿Puedo vender los resultados?
Depende de la licencia, los materiales, las condiciones del host y el uso final. Pagar cómputo no compra derechos comerciales sobre todos los modelos.
¿Es más barato que una suscripción?
Puede serlo para uso ocasional concentrado. Suma instalación, inactividad y almacenamiento; un servicio gestionado puede compensar si no quieres mantener software.
Empieza con un flujo de imagen reproducible en 24 GB y comprueba persistencia y coste por resultado útil. Después incorpora vídeo, cuando puedas distinguir un problema del modelo de uno del entorno.
Para personajes, conserva SillyTavern y las copias en tu equipo y conecta un backend protegido. Amplía la GPU cuando el trabajo lo exija, y decide el permiso NSFW por separado.
Relacionados Reseñas
Análisis de Qwen Image: 3.0 vs 2.0, LoRA/GGUF y soporte NSFW

Reseña de Gemini Omni 1.1 Flash: video IA de Google, 4K, API y límites NSFW
Reseña de Pony V7: AuraFlow, LoRA, comparación con V6 y NSFW

Reseña de GLM-5.3-Flash: Ox-Alpha, API, benchmarks y límites NSFW
Reseña de Hy4 Preview: Tencent Hunyuan 770B MoE, contexto 1M, API, hardware local y límites NSFW
OpenClaw 2.0 Review: agente local, ClawHub, despliegue y límites NSFW