2026 最新 AI 大模型 TOP 10:Arena 排名、價格與用途比較
整理 2026 年 10 月 Arena 前十名:比較 Gemini、Claude、Muse 的規格、API 價格、使用入口與真實評測,快速找出適合你的 AI。

Gemini 4 Argon 目前位居 Text Arena 綜合榜首,但首選仍取決於工作內容。複雜開發與文件工作可先試 Claude Opus 5.5;大量重複處理、重視費用時可先試 Gemini 3.8 Flash;長時間代理工作則值得比較 Muse Wonder。
這份榜單排名的是模型設定,不是十家聊天服務。同一系列可能占多個位置,Opus 4.6 更有兩個項目。先把排行當成候選清單,再以存取條件、完成一件工作的總成本,以及自己的測試結果做決定。
查核日期:2026 年 10 月 14 日。榜單資料日期:2026 年 10 月 13 日。
Arena 最新前十名一覽
以下採用 Arena 的 Text → Overall,並非程式、代理、圖片或影片專榜。分數代表文字回答比較中的偏好,不是正確率。相鄰名次的誤差常重疊;例如 Wonder 的名次範圍是 1–11,第二名並不代表明確勝過第三名。
high、max、xHigh 是評測設定,不是參數量,也不保證每個聊天介面都能選到。這十項皆為專有模型,所引用的官方規格並未公開參數數量。1M 上下文代表約百萬 tokens 的工作空間,不是百萬個模型參數。
| 名次 | Arena 項目名稱 | 分數與誤差 | 票數 | API 美元/百萬 tokens:輸入/輸出 | 上下文 |
|---|---|---|---|---|---|
| 1 | gemini-4-argon-high | 1525 ±9 * | 4,903 | $2 / $10 | 1M |
| 2 | muse-wonder-max | 1513 ±13 | 1,944 | $4 / $20 | 1M |
| 3 | claude-opus-5.5-high | 1508 ±8 | 7,687 | $4 / $20 | 1M |
| 4 | claude-fable-5-high | 1503 ±4 | 41,439 | $10 / $50 | 1M |
| 5 | claude-opus-4-6-high | 1503 ±3 | 80,827 | $5 / $25 | 1M |
| 6 | claude-opus-4-7-high | 1501 ±4 | 65,125 | $5 / $25 | 1M |
| 7 | claude-fable-5.1-max | 1501 ±6 | 14,121 | $10 / $50 | 1M |
| 8 | claude-opus-4-6 | 1498 ±3 | 85,445 | $5 / $25 | 1M |
| 9 | gemini-3.8-flash-high | 1496 ±5 * | 35,670 | $0.75 / $3.75 | 1M |
| 10 | muse-spark-1.2 (xHigh) | 1495 ±7 | 7,611 | $1.25 / $4.25 | N/A |
價格為標準 API 每百萬 tokens 的輸入/輸出美元單價,不是台灣月費或含稅新台幣售價。推理用量、快取、輸出長度及工具費用都影響帳單。Argon 的 $2/$10 優惠至 2026 年 11 月 30 日,之後為 $4/$20;Flash 導入價至 12 月 31 日。*代表 Arena 暫定分數,N/A 代表榜單未列出上下文值。
各模型的特點與選擇理由
1. Gemini 4 Argon(high) — 適合複雜多模態工作的榜首
重點規格: 參數量未公開。1,048,576 tokens 共用上下文;文字、圖片、音訊、影片、PDF 輸入,文字輸出。一般同步輸出上限 65,536 tokens。
適合把長文件、視覺資料與推理放在同一個任務中處理。長輸出也占用共用額度,不能將百萬 tokens 輸入與百萬 tokens 輸出視為互不影響。榜上是 high 設定,API 預設則為 medium。
10 月 13 日起,Google AI Pro/Ultra 訂閱者可在 Gemini App 使用。開發者可用付費 Gemini API;官方開發者公告另說明 AI Studio、Antigravity 的 Ultra 存取方式。App 訂閱不等於無限 API 額度。
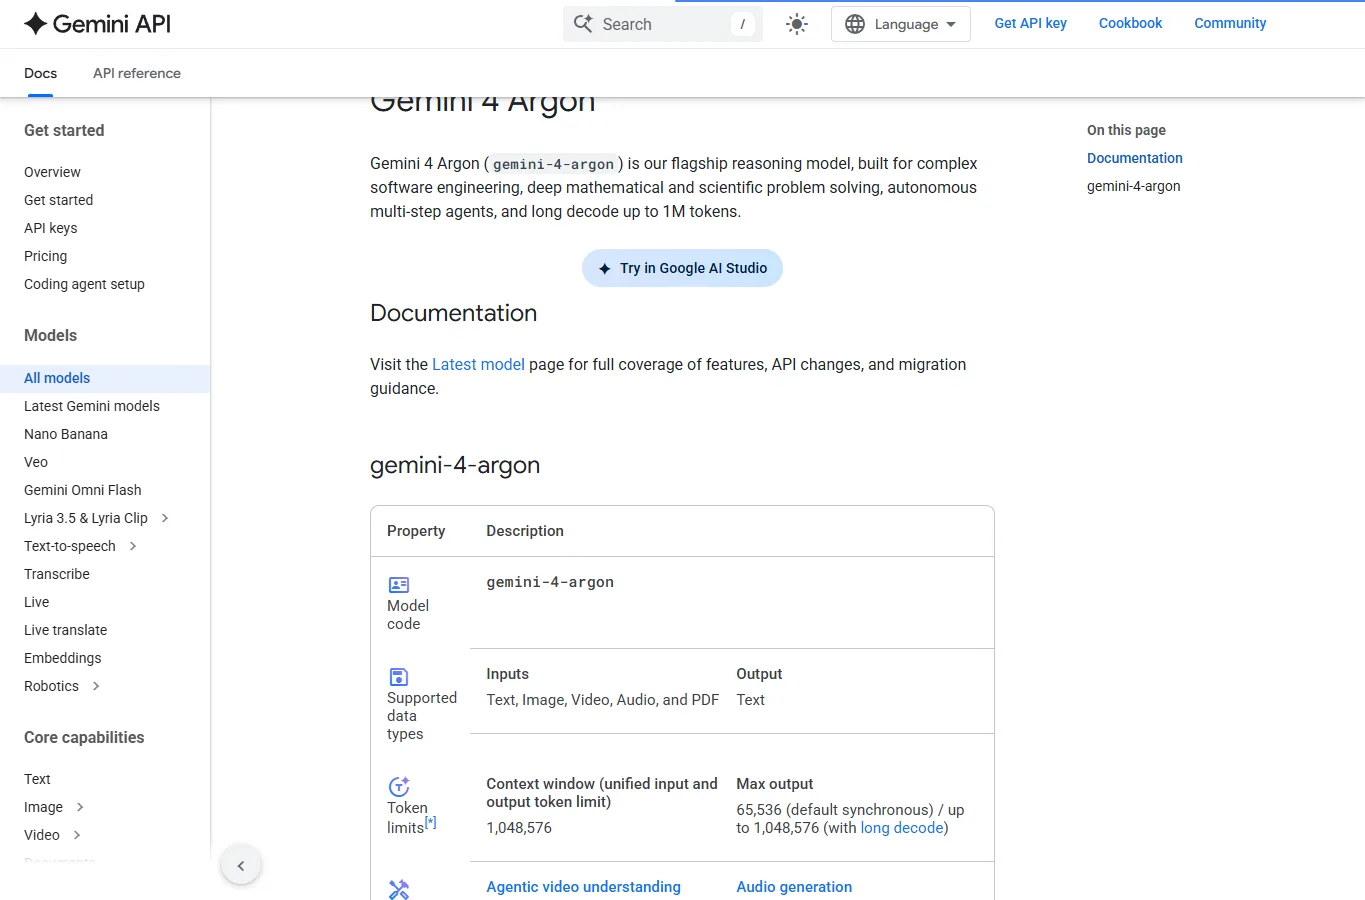
評測與取捨: 創作者 Tim Simmons 的先行體驗顯示它能持續處理遊戲、剪輯與寫作專案,但仍需要人工收尾。這是具體工作流程的經驗,不是一句提示詞就能完工的保證。常用 high 前,先測等待時間與總費用。
官方模型資訊 · 線上使用/API · API / AI Studio
2. Muse Wonder(max) — 長時間 AI 代理的新選項
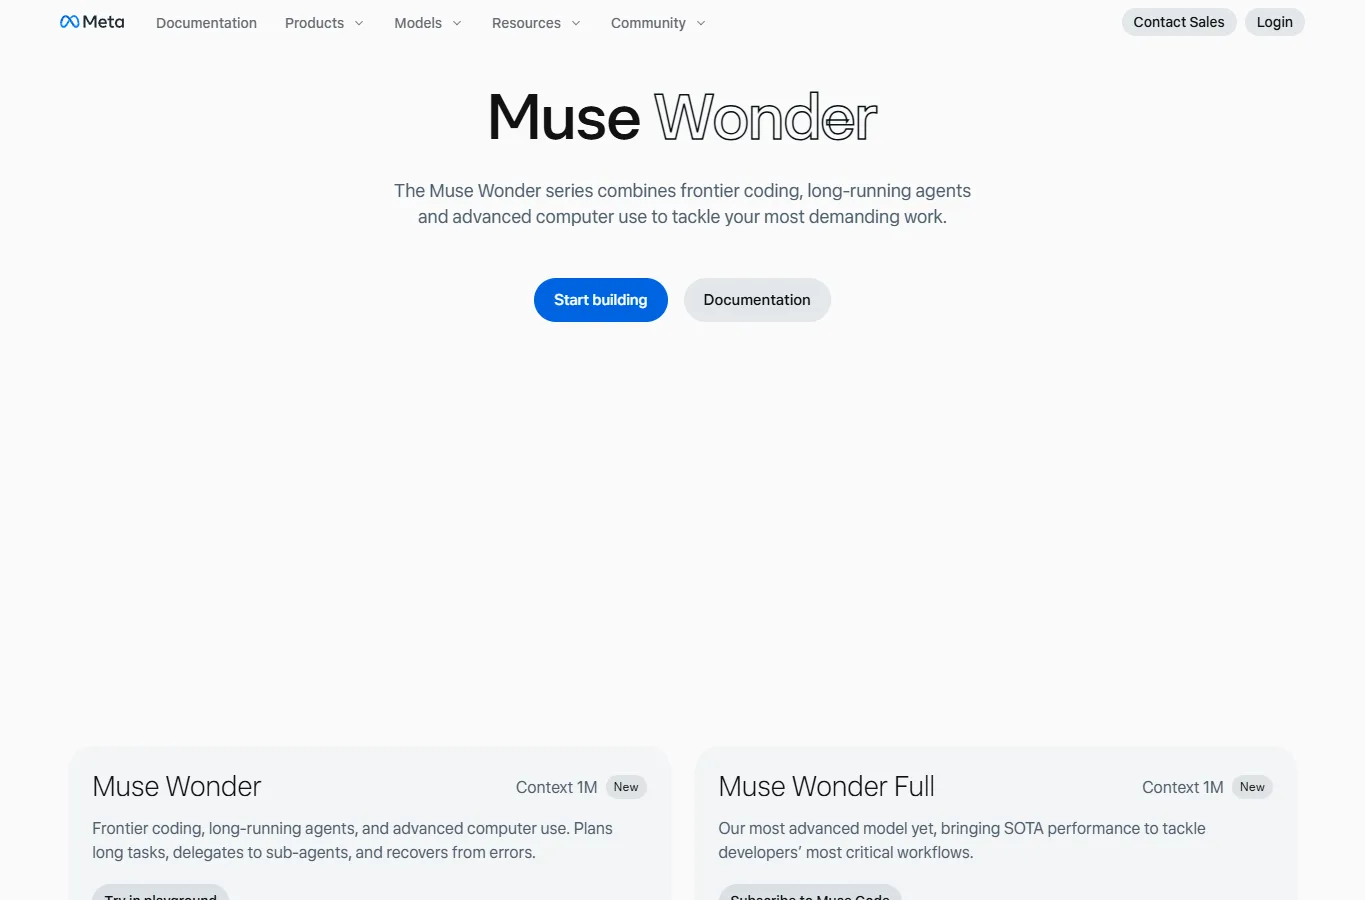
重點規格: 參數量未公開;1M 上下文;輸入 $4/輸出 $20。榜上是 Wonder max,不是 Wonder Full。
Meta 主打跨對話記憶與長任務的持續執行能力。入口包括 Meta Model API、Muse Code 與開發者 Playground。Wonder Full 是另外的版本,需要符合條件的 Muse Code 訂閱,不能把它的能力套到第二名這一列。
Axios 報導了這次前沿模型發布;Spring Prompt 的 10 月 13 日測試則發現資料分析表現好,但簡報排版與銷售文案的無依據主張仍有問題。該測試主要使用標準 Wonder 的 medium,並非 Arena 的 max。
評測與取捨: 用實際要採用的代理環境,檢查修正次數與成品。文字榜單不能完整代表記憶、工具串接和整個代理系統的表現。
官方模型資訊 · 線上使用/API · API / Meta
3. Claude Opus 5.5(high) — 新用戶值得先試的 Claude
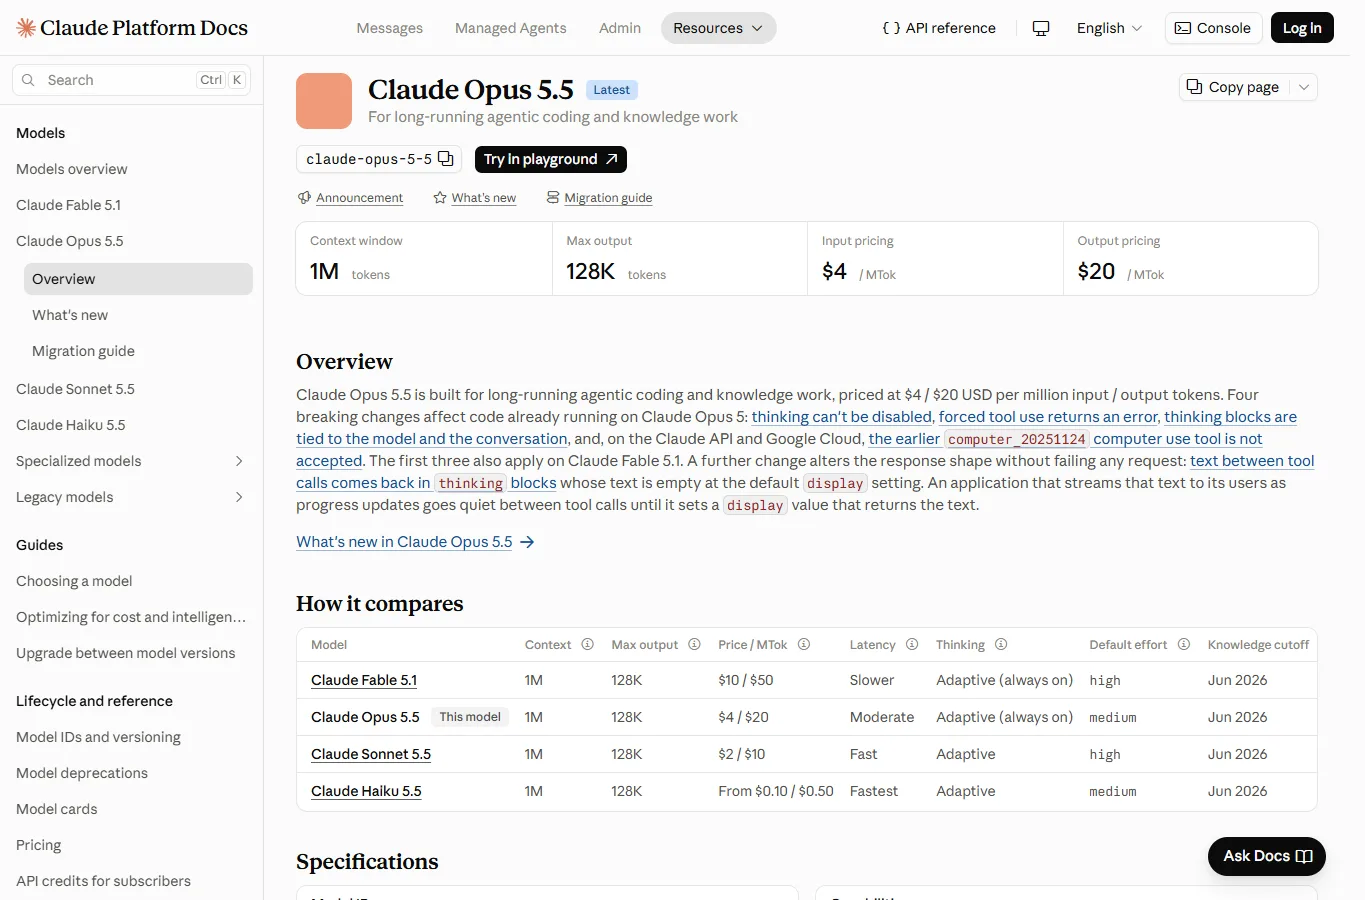
重點規格: 參數量未公開;1M 上下文;128K 最大輸出;文字/圖片輸入;$4/$20。
適合困難程式開發、研究與專業寫作,標準單價也低於表中的舊 Opus。API ID 為 claude-opus-5-5;聊天用 Claude,程式專案用 Claude Code,系統串接用 Claude Platform。各入口的配額與工具不同。
MacRumors 的發布報導主要轉述 Anthropic 的能力與降價主張。DataLLM Lab 的九題小型 Python 實測雖全部通過,但更便宜的模型也能過關,因此不宜把簡單題目當成支付旗艦費用的理由。
評測與取捨: 新建 Claude 工作流程可從 5.5 開始,簡單任務再與 Flash 比價。舊版的排名接近,不代表新用戶應付更高單價。
官方模型資訊 · 線上使用/API · API / Claude Platform
4. Claude Fable 5(high) — 仍在前段,但不是最新 Fable
重點規格: 參數量未公開;1M 上下文;輸入 $10/輸出 $50。
Fable 5著重持續開發、知識工作與視覺理解,是公開提供、附安全限制的版本,不等於受限的 Mythos。想用舊版,須確認當前模型清單與帳戶是否仍提供。
Tom’s Guide 的體驗重點是從單次問答走向持續完成專案。不過新訂閱應先比較 Fable 5.1 與 Opus 5.5,而非單憑第四名就選舊版。
評測與取捨: 適合已有驗證過的 Fable 5 流程者。升級前用實際任務做回歸測試,比照名次降級更有意義。
官方模型資訊 · 線上使用/API · API / Claude Platform
5. Claude Opus 4.6(high) — 樣本較多的舊世代實力派
重點規格: 參數量未公開;1M 上下文;一般最大輸出 128K;$5/$25。
這個設定累積逾八萬票,樣本比新進榜模型多。現行官方文件已將其列為 legacy,建議考慮 5.5;完整 1M 上下文目前採標準單價。
開發者 Simon Willison 二月的使用報告提到大量使用 Claude Code 的 Opus 4.6。這是當時的實際經驗,不是十月仍優於 5.5 的結論。
評測與取捨: 若現有提示詞與測試證明它更合適,可以保留。high 是否值得用在簡單日常工作,仍要看多出的推理時間。
官方模型資訊 · 線上使用/API · API / Claude Platform
6. Claude Opus 4.7(high) — 開發與視覺能力升級,注意 token 計算
重點規格: 參數量未公開;1M 上下文;$5/$25;高解析度圖片理解較 4.6 改善。
重點是複雜開發、精準遵循指示與自行檢查輸出。圖表、介面與程式庫任務都可比較,但目前的 Claude 預設不一定是這個舊版,應確認 API 的指定版本。
Willison 測量一份長文字,新 tokenizer 產生的 tokens 約為 1.46 倍;不代表每項工作的帳單都會如此增加。其鵜鶘 SVG 比較也偏好小型本地模型的結果,提醒我們單一任務與綜合排名可能不同。
評測與取捨: 用自己的文件比較 tokens 與完工成本。相同單價不等於相同總額,排名微差也不能直接否定升級價值。
官方模型資訊 · 線上使用/API · API / Claude Platform
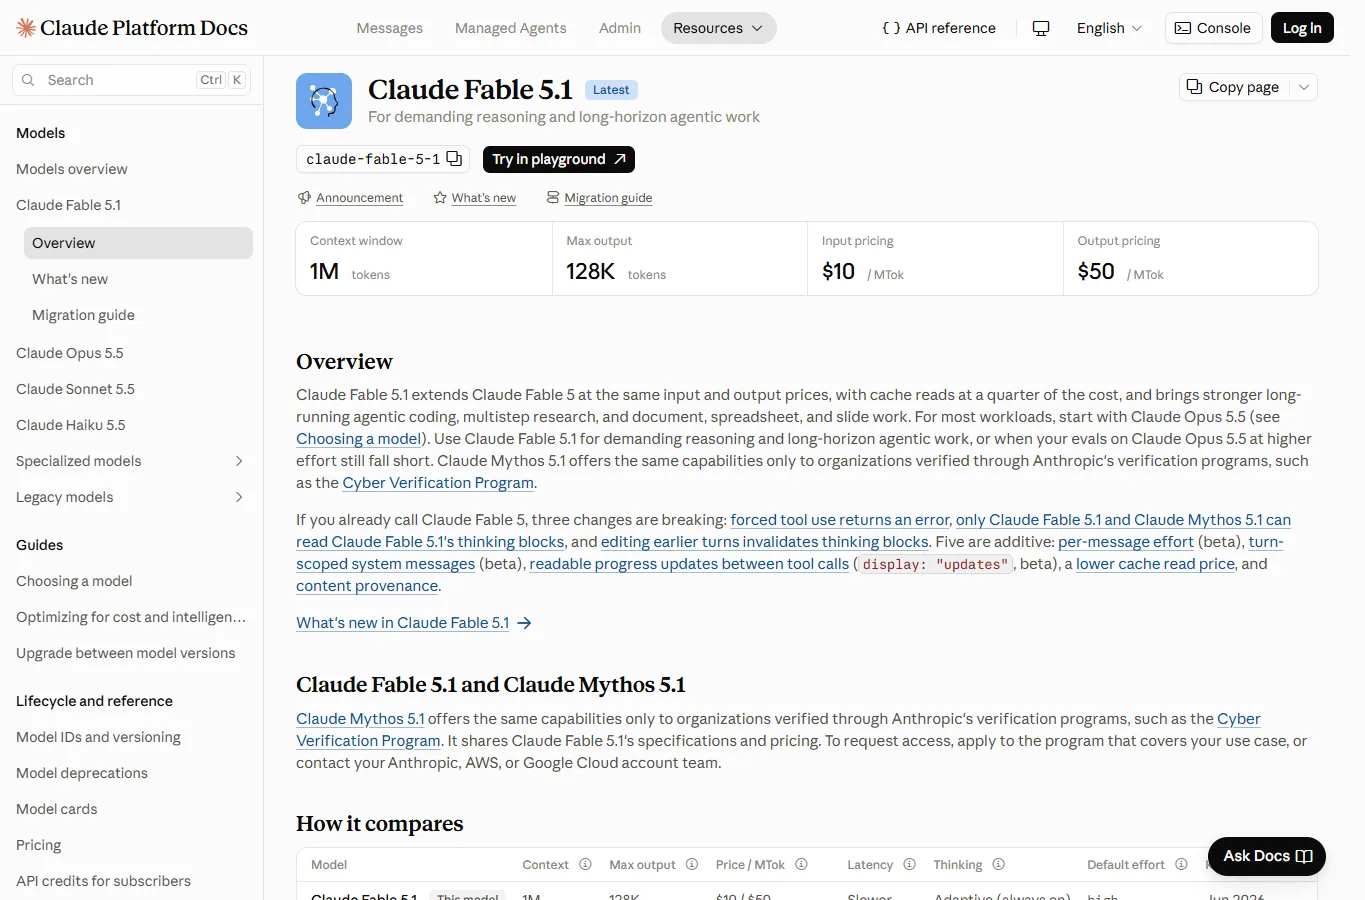
7. Claude Fable 5.1(max) — 高階長文工作,快取影響成本
重點規格: 參數量未公開;1M 上下文;128K 輸出;$10/$50;快取讀取 $0.25/百萬 tokens。
適合能大幅省下人工修改時間的分析、寫作與代理工作。降價重點是快取讀取,基本輸入/輸出單價與 Fable 5 相同;重複使用長上下文,比每次短小的新問題更能受惠。
Fable 5.1 已一般提供,可透過 Claude API 等平台使用;Mythos 5.1 仍是受限版本。No Code MBA 的評測與開發者測試也聚焦日常 App 開發是否真的需要這個溢價。
評測與取捨: 先測較便宜的模型,品質差異夠大再升級。Arena 的 max 並不保證所有方案都有相同控制。
官方模型資訊 · 線上使用/API · API / Claude Platform
8. Claude Opus 4.6(另一個榜單項目) — 同一系列,不是另一個產品
重點規格: 同屬 Opus 4.6;參數量未公開;1M 上下文;$5/$25。
這列沒有 high 後綴,但不能因此說它完全不推理;榜單單行未交代完整測試設定。與 high 項目差五分,誤差範圍重疊。
官方入口與系列評測和第五名相同。這更適合用來思考推理設定,而非多買一套服務。若要十種不同模型系列,就不能稱為原始榜單前十列。
評測與取捨: 沒有另一套獨立產品規格或專屬評測。可直接參考第五名與官方 Opus 4.6 文件。
官方模型資訊 · 線上使用/API · API / Claude Platform
9. Gemini 3.8 Flash(high) — 這份前十名中的低價基準
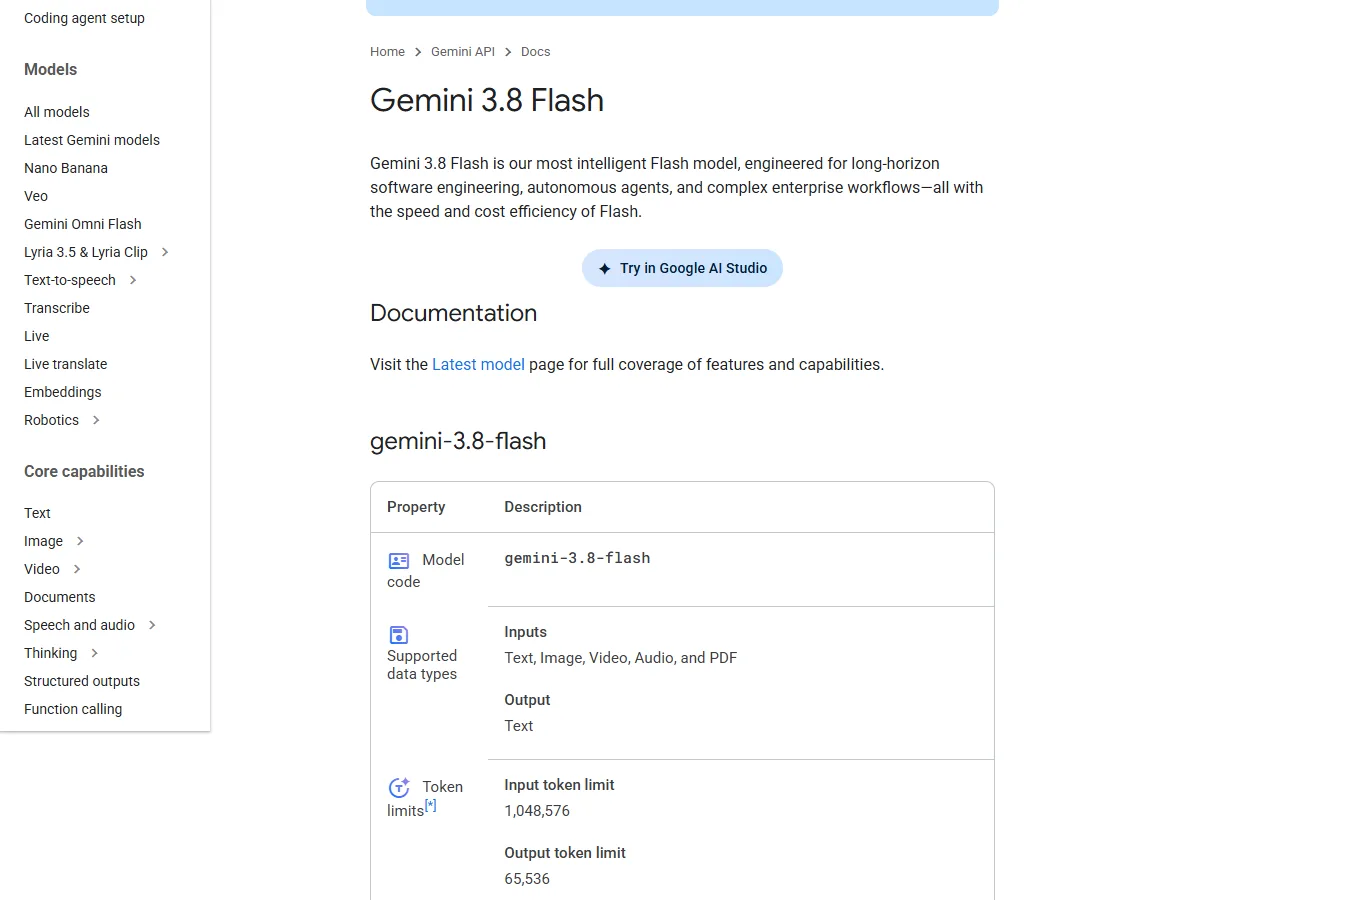
重點規格: 參數量未公開;輸入 1,048,576/輸出 65,536 tokens;圖片、音訊、影片、PDF 輸入;導入價 $0.75/$3.75。
適合反覆處理文件與影片問題,入口為 Gemini App 的適用方案、AI Studio 與 Gemini API。high 不代表立即回覆,應測完整任務時間,而不只看每秒輸出量。
Tom’s Guide指出原生影片理解是實用差異。這不是整體品質對照試驗,但講座筆記、影片分析與批次工作可能比排名差距更重視這項能力。
評測與取捨: 先用 Flash 建立低成本基準,再把困難任務交給較高價模型。暫定分數與導入單價都可能改變。
官方模型資訊 · 線上使用/API · API / AI Studio
10. Muse Spark 1.2(xHigh) — 舊版低價選項,先確認版本
重點規格: 參數量未公開;Arena 上下文為 N/A;$1.25/$4.25。不要直接套用 Spark 1.3 規格。
原始公告將規劃、整個程式庫與長時間開發列為重點,提供 Muse Code、Meta Model API 入口。主頁目前介紹 1.3,必須確認供應商還能否指定 1.2。
Reddit 上的公開使用者測試由程式碼審查服務開發者分享,肯定速度與抓 bug 的表現。這是規模小、帶產品背景的自述,不能代表 xHigh 全面等同旗艦模型。
評測與取捨: 若仍可取得,適合納入成本比較;不要僅因它比 1.3 高一名就選舊版,也要衡量實際修正時間。
官方模型資訊 · 線上使用/API · API / Meta
依需求,先試哪一款?
多媒體與長文件:難題試 Argon,重複工作試 Flash。新建 Claude 流程:先 Opus 5.5,當 Fable 5.1 的品質確實減少人工工作時再付溢價。
長時間代理:用實際的應用程式與工具比較 Wonder。已有 Opus 4.6/4.7、Fable 5 的系統,先測移轉是否造成退步。
同樣測三種內容:可驗證答案的問題、真正的文件或程式修改、繁體中文寫作。記錄事實錯誤、用詞、修改次數、時間與費用,並重複執行。英文好評不等於符合台灣讀者的語氣與用語。
訂閱前的常見問題
為什麼沒有 ChatGPT、DeepSeek、Qwen?
這是指定日期的 Text Arena Overall 原始前十項,不是刻意分配廠牌名額。ChatGPT 是應用程式名稱,其 OpenAI 模型在榜單其他位置;不同日期或分類會有不同排名。
high、max 是參數量嗎?
不是,是推理/評測設定。官方未公開這些專有模型的參數量,應比較已知的上下文、輸出限制與成本。
十項都能免費試用嗎?
不能保證。Arena 的比較功能不是所有模型、設定與工具都免費開放的帳號。App 訂閱、開發者平台與 API 是不同計費體系。
舊版為什麼比新版高?
文字偏好、題目、推理設定與票數,和開發或代理測試不同。誤差重疊的微小排名差異不能證明全面優勢。
哪款最便宜?
表中基本 API 單價是 Flash 最低,但推理用量、重試、快取與輸出長度會影響總額。比較完成任務的費用更實際。
可以下載到本機離線執行嗎?
這些是專有託管模型,不是可下載權重的本機模型。離線需求應另外選開放權重模型;線上則要確認服務的資料使用設定。
先比較兩款,不必訂閱十種服務
先用 Opus 5.5 與 Argon 比品質,以 Flash 當低成本基準;代理工作再加測 Wonder。舊 Claude 與 Spark 對既有系統的比較仍有價值。
留下能以最少修改交付正確成果的模型。排行榜提供線索,繁體中文實際工作與完成成本才是最後的判斷依據。
相關 評測
NovelAI V5 評測|NSFW 支援、提示詞、價格與使用限制

Seedance 2.5 評測:AI 影片生成模型的功能、使用體驗與限制

MiniMax M3.1 Flash 評測:程式能力、API 費用、公開權重與硬體需求
Kimi K3 評測:2.8T 開放權重 MoE、本機部署、效能與 NSFW 政策
Krea 3 評測:圖片編輯、Ultra、真實費用、繁中文字與本機支援
Ideogram 4.0 評測:文字生成、ComfyUI、審查限制突破與 NSFW