2026 年最佳本地開源 LLM:效能、NSFW 與硬體對比

最好的本地 LLM(大型語言模型)不再是參數規模最大的那一個。到了 2026 年,真正需要關心的是更具體的問題:哪一款開源或公開權重(open-weight)模型能在效能品質、NSFW 彈性、硬體成本、授權條款以及本地控制之間取得最佳平衡?
對多數讀者來說,實用的精選名單其實很單純。若要應付多語言任務、程式碼編寫與 RAG(檢索增強生成),建議選擇 Qwen 3.8;若偏好具備完善官方文件的 Google 公開權重模型,可選 Gemma 4;當低拒絕率、NSFW 與角色扮演(roleplay)的彈性最重要時,Dolphin 3.0 是理想選擇;至於評估長文本(long-context)、智慧代理(agentic)或企業級工作負載,而非一般的桌面聊天模型時,則建議看看 DeepSeek V4。
快速推薦
| 需求 | 最佳推薦 | 理由 |
|---|---|---|
| 適合多語言與程式碼的最佳全方位本地 LLM | Qwen 3.8 27B | 具備優秀的多語言處理、程式碼編寫與工具呼叫能力,且對追求實效的本地用戶來說,27B 的規模相當好上手。 |
| Google 生態系與更清晰的安全文件 | Gemma 4 | 擁有出色的模型卡、官方文件、多種尺寸選擇,且官方對齊(alignment)機制更安全。 |
| NSFW、角色扮演與低拒絕率寫作 | Dolphin 3.0 | 經典的未審查微調系列,專為系統提示詞(system-prompt)控制與減少拒絕回覆而打造。 |
| 長文本與企業級規模評估 | DeepSeek V4 | 公開權重,朝百萬級 Token 上下文發展,並提供 Pro/Flash 選擇,但對硬體要求較高。 |
| 微調模型陣容最龐大的生態系 | Llama 4 / Llama 家族 | 擁有龐大社群、GGUF 變體,以及各種角色扮演與未審查的衍生版本。 |
| 適合大型伺服器的公開權重 MoE 模型 | Mistral Large 3 | 相當優秀的歐洲公開權重選項,但硬體需求遠超一般家用桌機。 |
| 專注於智慧代理(Agent)與工具呼叫的模型 | Kimi K2 / Kimi K2 Thinking | 對程式碼代理與工具工作流程很有幫助,主要並非針對 NSFW。 |
| 長文本程式碼與代理工作 | GLM-4.6 | 當 200K 上下文與代理風格程式碼編寫比未審查行為更重要時的不錯候選者。 |
Performance
評測跑分(Benchmarks)固然有參考價值,但挑選本地 LLM 時,還是應該從你的實際工作負載出發。在處理程式碼、日/中/英文寫作、長文本 RAG、角色扮演以及智慧代理工作流程時,不同模型往往會有不同的排名表現。只要量化(quantization)得宜,小模型在放進 GPU 且回應速度更快的情況下,有時反而能超越大模型。
諸如 Artificial Analysis 和 LMArena 等公開排行榜能提供大方向的參考,但無法取代實際的本地測試。舉例來說,某個在一般聊天項目中得分很高的模型,在面對你的私有文件、工具呼叫、日文語氣控制或 NSFW 創意寫作時,表現可能依然偏弱。
| 模型 | 效能特點 | 主要取捨 |
|---|---|---|
| Qwen 3.8 | 在多語言、程式碼與實用本地工作之間取得最佳平衡的選擇。 | 官方模型並非作為未審查的 NSFW 模型而設計。 |
| Gemma 4 | 文件齊全的公開權重系列,提供 12B/26B/31B 等多種選擇。 | 安全對齊傾向較強,靈活性可能不及未審查的微調版本。 |
| Dolphin 3.0 | 具備出色的系統提示詞遵循能力、寫作與角色扮演表現。 | 較不依賴跑分榜單,需要使用者自行負擔安全規範。 |
| DeepSeek V4 | 對長文本、智慧代理與大規模服務很有吸引力。 | 不太適合作為單張 GPU 的舒適桌面模型。 |
| Llama 4 / Llama 家族 | 擁有最龐大的社群微調生態系、GGUF 建置與本地實驗資源。 | 官方版本非主打 NSFW,品質高度取決於所選的微調版本。 |
| Mistral Large 3 | 具備極高伺服器部署上限的公開權重 MoE 模型。 | 675B 級別的模型不適合當作日常家用桌機的目標。 |
| Kimi K2 Thinking | 非常適合程式碼代理、工具呼叫與多步驟長任務。 | 偏向智慧代理導向,而非角色扮演或 NSFW 導向。 |
| GLM-4.6 | 在長文本、程式碼編寫與智慧代理方面有所提升,並提供親民的開源模型分發。 | 在國際上的知名度不如 Llama 或 Qwen,但值得針對程式碼工作流程進行測試。 |
NSFW 與未審查行為
NSFW 是本地 LLM 與雲端助理差異最大的領域。託管模型通常會加上平台審查機制,而本地公開權重模型則允許擁有者自行挑選執行工具、系統提示詞與額外的過濾器。不過,這並不代表每一個本地模型都具備相同的開放程度。
在這群模型中,Dolphin 3.0 是最明確支援 NSFW 的選擇。它繼承了經典的未審查微調傳統,在私人角色扮演、小說創作、成人寫作以及提示詞控制實驗中相當受歡迎。它的強大之處在於將更多的責任轉交給使用者。
Qwen 3.8 與 Gemma 4 的官方版本皆經過安全對齊,但社群也會製作去限制(abliterated)或未審查的衍生版本。這些版本雖然能減少拒絕回覆的情況,但它們並非官方版本,應被視為需獨立評估信任度與授權的個體。DeepSeek V4 則更適合被視為長文本或智慧代理模型,而非主打 NSFW 的模型。
硬體與 VRAM 需求
玩本地 LLM 最常犯的錯誤,就是下載了紙面規格看起來最棒的模型,結果卻發現它在自己的機器上跑得像龜速。VRAM(顯示記憶體)、量化程度、上下文長度以及 KV 快取(KV cache)的重要性,一點也不亞於模型本身的規模。
| 硬體 | 切合實際的模型選擇 | 備註 |
|---|---|---|
| 8GB-12GB VRAM | 7B/8B GGUF、Dolphin 3.0 8B、小型 Llama/Mistral 變體 | 適合日常聊天與寫作測試,但不適合吃重的 RAG 或大型代理任務。 |
| 16GB VRAM | 12B 級別模型、有條件限制的 Q4/Q5 20B-27B 模型 | 若能接受較短的上下文,是相當實用的進階玩家級距。 |
| 24GB VRAM | Qwen 27B 量化版、Gemma 31B/26B 量化版、Dolphin 24B GGUF | 認真投入的家用用戶的甜蜜點(最佳平衡點)。 |
| 48GB-80GB VRAM | 較大的 BF16 模型、長文本、更好的吞吐量 | 更適合伺服器部署、RAG 以及多用戶作業。 |
| 多 GPU / 伺服器 | DeepSeek V4 Pro/Flash、超大型 MoE 模型 | 屬於企業或研究領域,不適合一般的本地日常聊天。 |
模型逐一評測
Qwen 3.8:最佳平衡的本地選擇
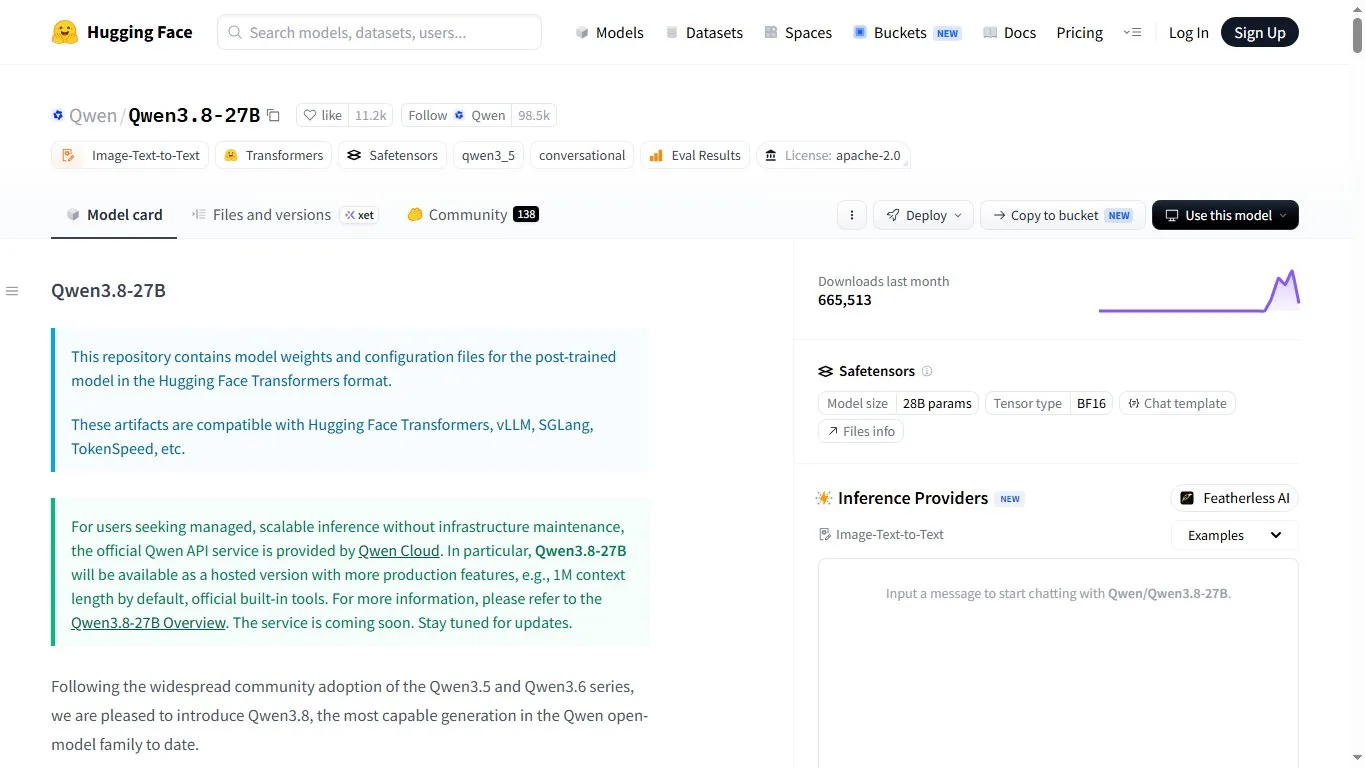
如果要在多語言處理、程式碼編寫、RAG 以及日常本地助理任務中挑選一個模型家族作為起點,Qwen 3.8 會是首選。其中的 27B 分支比龐大的 Max 級別分支實際得多,同時在能力上也明顯優於小型 7B/8B 模型。
它的弱點不在於品質,而在於定位。官方的 Qwen 模型並未被設計成未審查的 NSFW 模型。如果你的主要目的是減少成人角色扮演時的拒絕回覆,除非你刻意挑選並測試社群的去限制版本,否則 Qwen 不會是第一選擇。
Gemma 4:最佳文件支援與 Google 生態系
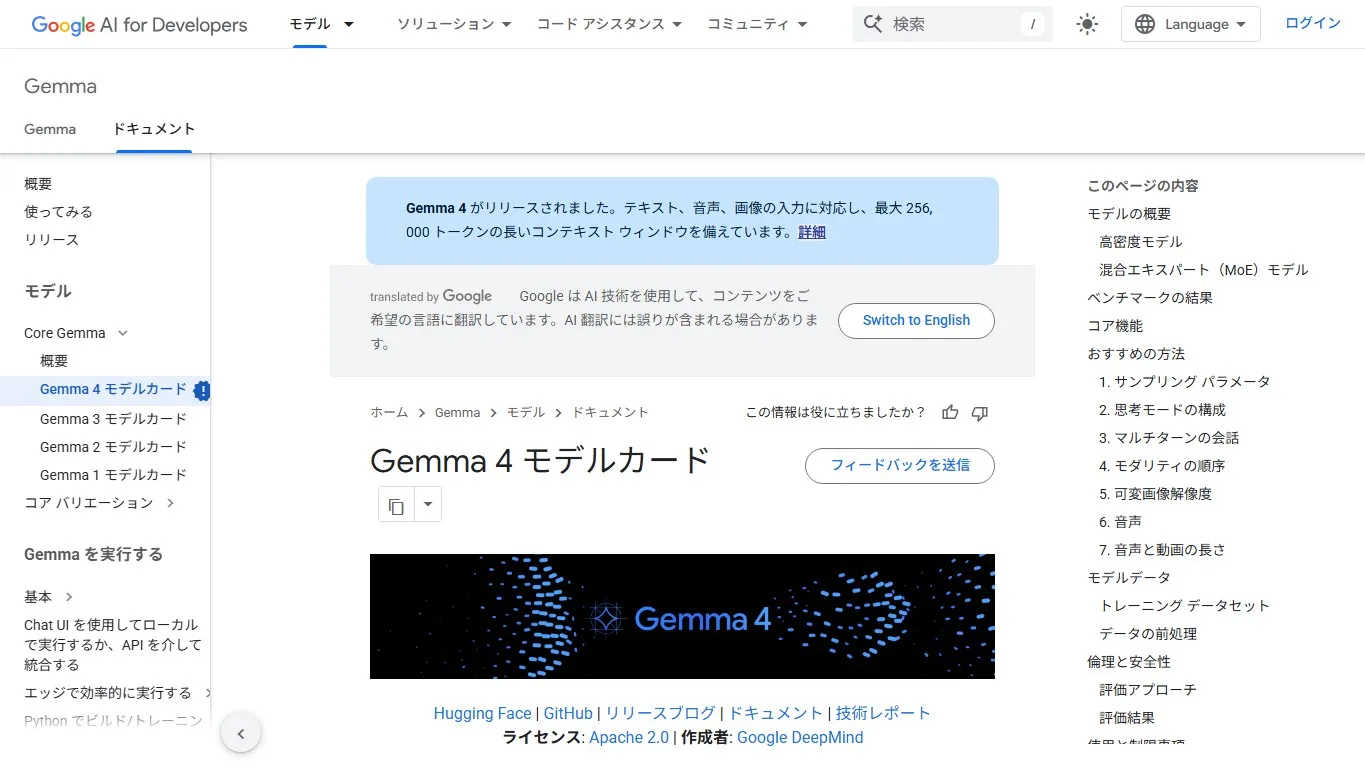
當你想要公開權重、官方文件以及乾淨的模型家族時,Gemma 4 相當具有吸引力。12B 版本是最容易上手的起點,而 26B-A4B 與 31B 則是效能更強大硬體的理想品質目標。
在 NSFW 方面,Gemma 4 的官方版本表現得較為保守。雖然市面上有未審查/異端(heretic)以及去限制的社群模型讓生態系變得很有趣,但這些不應與 Google 的官方對齊或安全立場混為一談。
Dolphin 3.0:未審查 NSFW 與角色扮演的最佳選擇
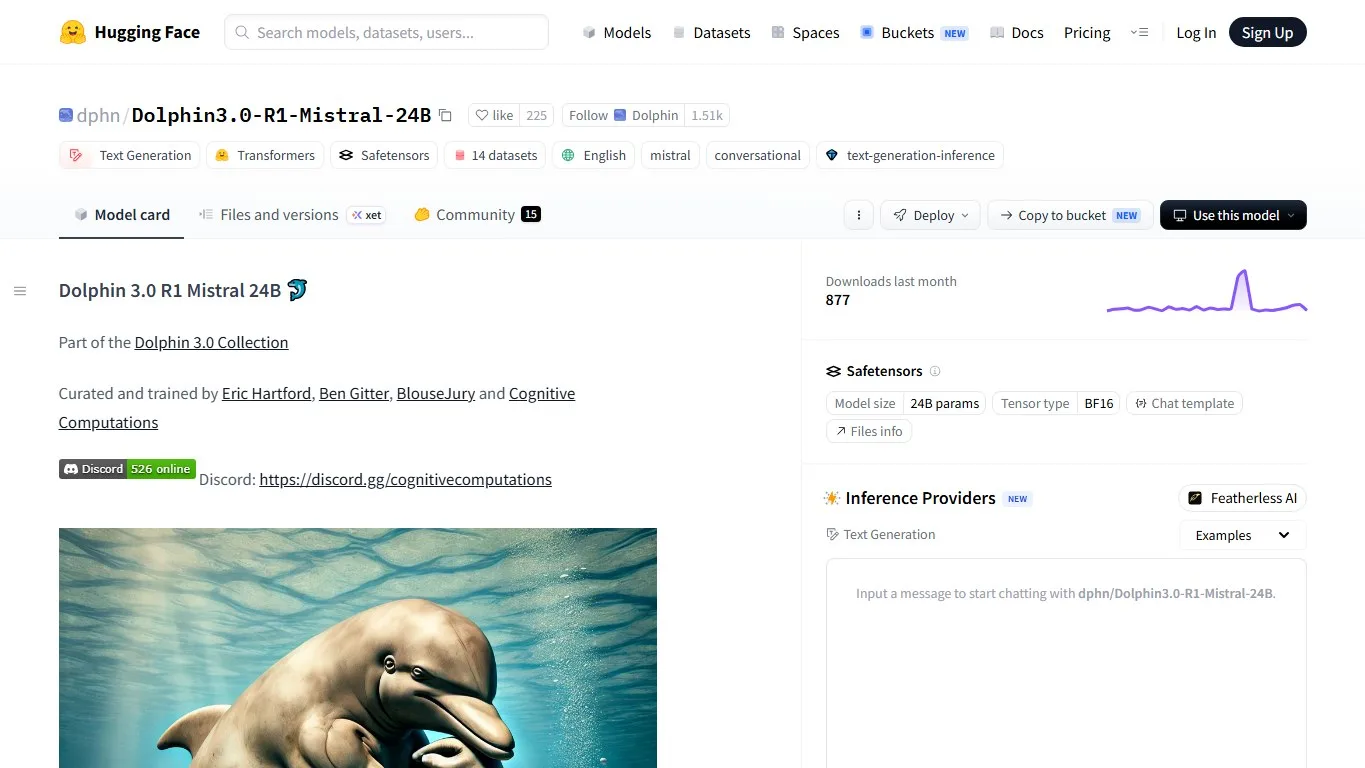
當你的搜尋意圖包含未審查、NSFW、角色扮演或低拒絕率寫作時,Dolphin 3.0 依然是最清晰的推薦。它並未試圖成為最講究安全對齊的通用助理,而是致力於成為一個可由系統擁有者決定行為的本地可控模型。
如果你使用的是一般桌機,可以從 8B 或 GGUF 路徑開始;當你希望獲得更好的寫作與推理能力,且能負擔硬體成本時,則可升級至 Mistral 24B。若要進行公開部署,請記得加上你自己的審查機制與使用規則。
DeepSeek V4:表現強勁但硬體需求高
DeepSeek V4 在技術上令人印象深刻,值得持續關注,特別是在長文本、智慧代理與伺服器端任務方面。Pro 與 Flash 的劃分相當實用,能讓團隊在更強的輸出與更便宜的吞吐量之間做出取捨。
對一般本地用戶而言,問題在於硬體。DeepSeek V4 並不是那種能輕鬆塞進單張 GPU 的推薦模型。它更適合能夠執行 vLLM/SGLang 風格服務、管理成本,並針對實際工作負載進行評估的團隊。
Llama 4 與 Llama 微調系列:最強大的生態系
Llama 家族依然是不容忽視的存在。Llama 4 Scout 與 Maverick 將 Meta 的開源模型線進一步推向多模態與 MoE 領域,而更廣泛的 Llama 生態系依然是尋找 GGUF 建置、角色扮演微調、程式碼變體與部署指南最容易的地方。
缺點在於 Llama 並非單一模型。原生的官方版本、程式碼微調版、角色扮演微調版以及未審查的衍生版,其表現可能完全不同。對於追求極致選擇權的讀者來說,Llama 非常棒;但對於想要明確推薦的讀者來說,Qwen 或 Gemma 可能比較不會讓人眼花撩亂。
Mistral Large 3:面向嚴肅基礎架構的公開權重模型
值得一提的是 Mistral Large 3,因为它代表了另一種本地/公開權重的大志向。它是一款旨在實現前沿級開源部署的大型 MoE 模型,對基礎架構的要求遠高於 12B 或 27B 的桌面模型。
對個人用戶而言,Mistral Large 3 很少是第一個下載的本地模型。但對擁有伺服器級 GPU 的團隊來說,它絕對值得與 DeepSeek V4 及其他超大型 MoE 模型一同列入考慮清單。其 NSFW 行為應該透過確切的指令(instruct)檢查點、供應商層級與部署政策來評估,而不僅僅是看模型名稱。
Kimi K2:代理與工具呼叫專家
Kimi K2 Thinking 對於重視工具呼叫、程式碼代理與多步驟長任務的用戶來說相當有趣。它或許不是簡單桌面聊天的顯然之選,但在建置代理系統或評估複雜任務執行時會很有吸引力。
與 Dolphin 相比,Kimi 並非主要走未審查角色扮演路線的模型;與 Qwen 相比,它更偏向專門的代理/程式碼競爭者。如果你正在編寫程式碼代理、瀏覽器代理或工作流程自動化工具,它值得進行獨立測試,而不是被埋沒在一般聊天分數之下。
GLM-4.6:長文本與程式碼候選者
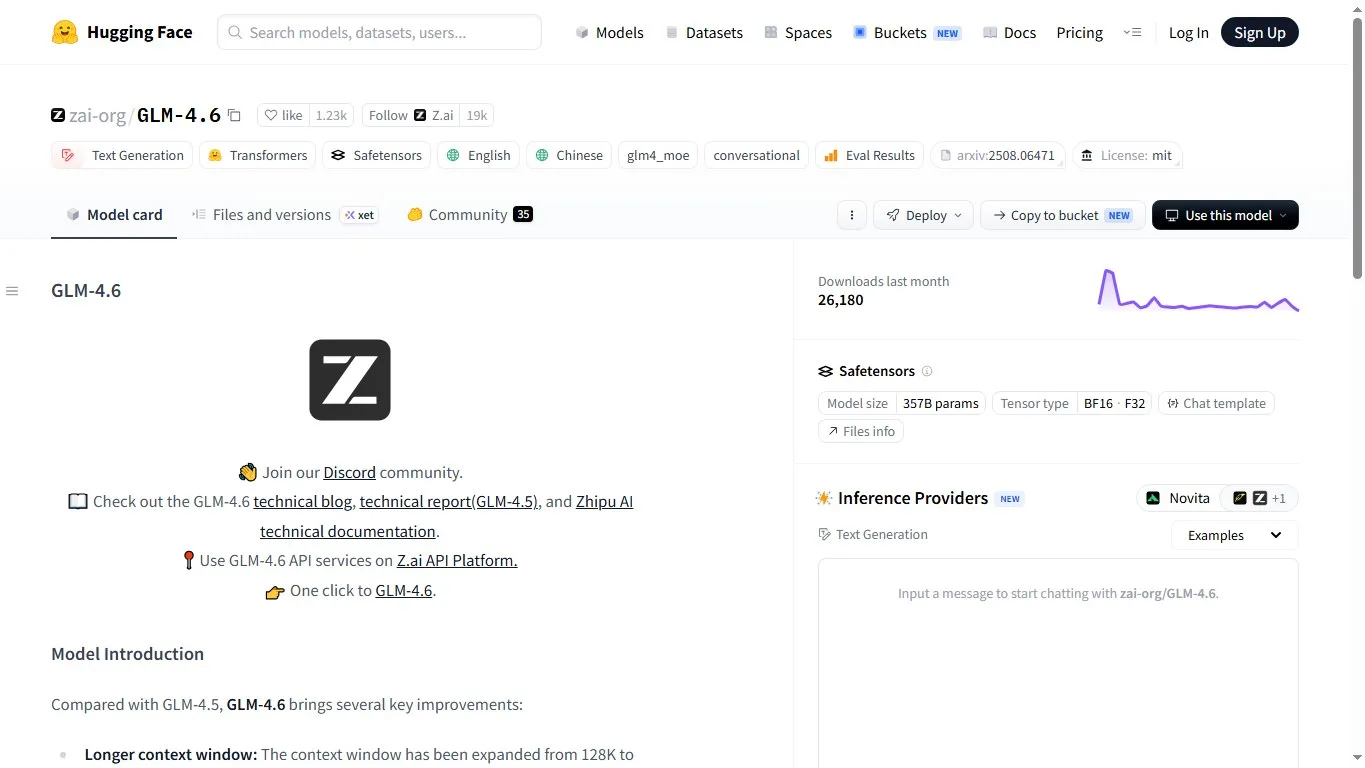
GLM-4.6 是另一款在 2026 年的實際評比中不可或缺的模型系列。雖然它對許多西方讀者來說不如 Llama 或 Mistral 那麼熟悉,但在長文本、程式碼與代理工作負載方面相當重要,特別是對於那些會對比中文開源模型生態系的用戶而言。
從某個角度來看,它扮演的實際角色與 Kimi 和 Qwen 類似:在你的程式碼、多語言與文件任務上親自測試它。不要只因為跑分好看就選擇它,而是要在它處理實際上下文長度、工具呼叫與本地服務堆疊的表現優於替代方案時才選它。
如何選擇
- 從你的實際任務出發:程式碼編寫、寫作、RAG、角色扮演、長文本文件或智慧代理。
- 挑選能在你的硬體上足夠流暢運行的最大模型,而不是技術上勉強能載入的最大模型。
- 桌面測試時使用 GGUF 或 4-bit 量化,只有在必要時才切換到 BF16 或伺服器部署。
- 針對 NSFW 或低拒絕率的創意寫作,請將 Dolphin 與 Llama 微調類型的模型與官方安全對齊模型分開測試。
- 若是商業用途,請務必確認確切的授權條款、基礎模型規定,以及社群微調版本是否可被接受。
常見問題
整體而言,最好的本地開源 LLM 是哪一個?
對於多數認真的本地用戶來說,Qwen 3.8 27B 是平衡性最好的起點。它具備強大的多語言能力、程式碼表現與實用的本地部署選項。如果你的首要任務是 NSFW 角色扮演,那麼 Dolphin 3.0 會更合適。
在 RTX 4090 24GB 上應該執行什麼模型?
建議使用量化版本的 Qwen 27B、Gemma 31B/26B、Dolphin 24B 或類似模型。如果你想要更流暢的速度與更長的上下文,可以降級到 12B 或 8B。一個能夠順暢運行的模型,通常比一個勉強塞進去卻跑不動的模型更有用。
開源 LLM 用於商業用途安全嗎?
可以,但前提是必須經過授權檢查、隱私設計、日誌記錄決策以及輸出審查。公開權重並不代表能自動解決合規問題。針對機密文件,本地部署確實能提升隱私,但團隊依然需要做好治理。
哪一款本地 LLM 最適合 NSFW?
在本文涵蓋的模型中,Dolphin 3.0 是最明確的選擇。雖然 Qwen 與 Gemma 也有社群提供的未審查變體,但它們的官方版本並非主打 NSFW 的模型。
我該使用 Ollama、LM Studio、vLLM 還是 SGLang?
Ollama 與 LM Studio 最適合桌面端測試;而 vLLM 與 SGLang 風格的服務則更適合 API 伺服器、批次處理、長文本實驗與團隊協作。
總結
世上並沒有一款適用於所有人的「最佳本地開源 LLM」。Qwen 3.8 是最實用的全能選手,Gemma 4 是最乾淨的 Google 旗下公開權重系列,Dolphin 3.0 最適合未審查的 NSFW 與角色扮演,DeepSeek V4 與 Mistral Large 3 是嚴肅的伺服器端選擇,而 Llama、Kimi 與 GLM 則帶來了豐富的生態系、代理與長文本深度。
最聰明的方法雖然枯燥卻很可靠:從符合你 GPU 規格的量化模型開始,用你的真實提示詞進行測試,對比拒絕行為、上下文穩定性與延遲表現,只有在小模型明顯不夠力時再往上升級。當本地 AI 的速度快到足以讓人每天使用時,它才會真正變得有趣。
參考資料
相關 評測
Dolphin 3.0 評測:適用於成人內容、角色扮演與程式碼編寫的無審查本地 LLM

Nucleus Image 評測:17B 稀疏 MoE、本地架構、NSFW 支援與 Apache 2.0 開放權重

Seedream 5.0 Pro 深度評測:AI 圖像模型、API 存取與 NSFW 政策
FLUX 3 評測:影片、圖片、開源權重與 NSFW 政策
Qwen Image Edit 評測:文字編輯、局部重繪、ComfyUI 與 NSFW 政策