Dolphin 3.0 評測:適用於成人內容、角色扮演與程式碼編寫的無審查本地 LLM

Dolphin 3.0 是不受審查本地 LLM(大型語言模型)領域中的經典名稱之一。它不只是另一個跑分模型:人們尋找 Dolphin,是因為他們希望模型能更聽從系統提示詞、在寫作與角色扮演上更有彈性,且比主流的雲端助理受到更少的過濾限制。
整體表現的總結是:如果你有足夠的 GPU 記憶體,Dolphin 3.0 R1 Mistral 24B 是更強大的旗艦選擇;而 Dolphin 3.0 Llama 3.1 8B 則是針對 Ollama、LM Studio 與快速本地實驗更易上手的桌面模型。它相當適合創意寫作、角色扮演、程式碼編寫、數學計算以及代理(Agent)風格的本地工作流程,但公開部署仍需搭配你自己的安全規範。
什麼是 Dolphin 3.0?
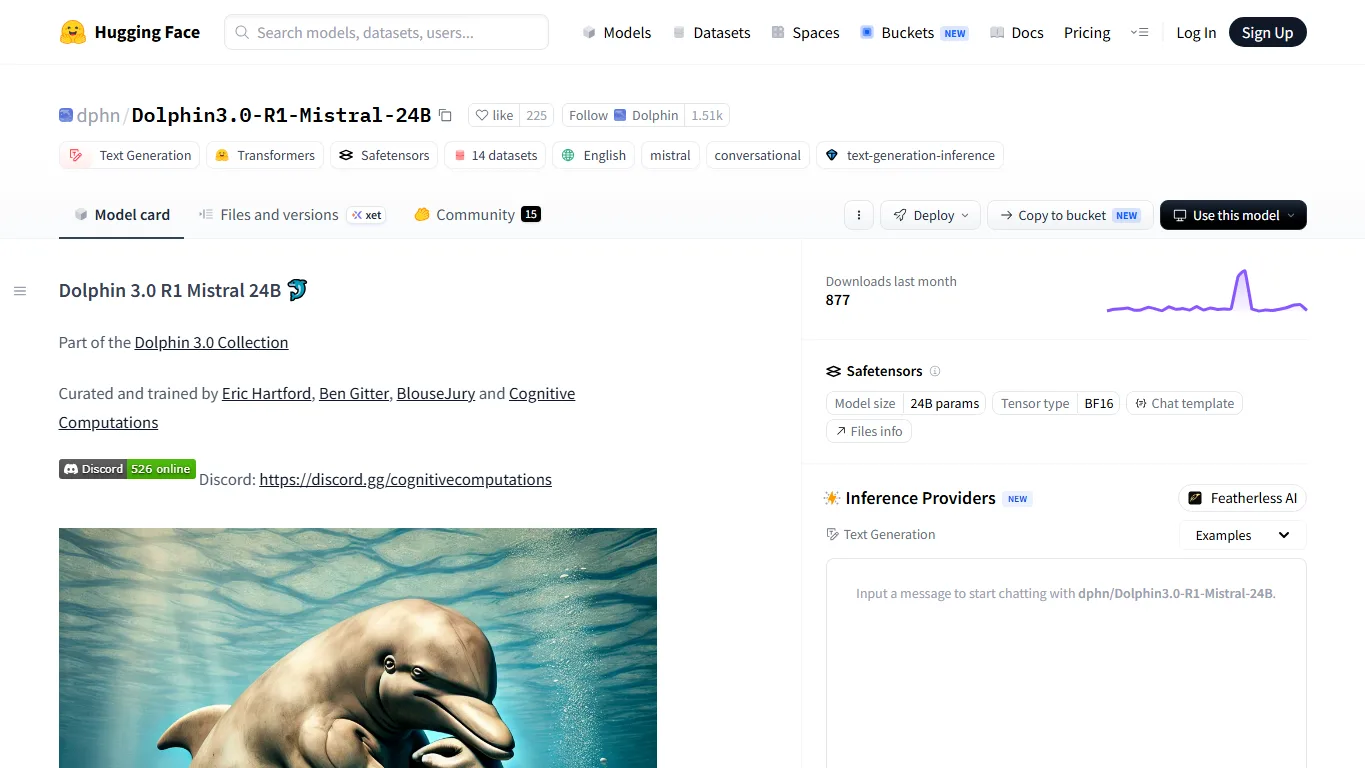
Dolphin 3.0 是一系列由 Eric Hartford、Ben Gitter、BlouseJury 與 Cognitive Computations 共同策劃的指令微調本地模型。Dolphin3.0-R1-Mistral-24B 的模型卡片將其描述為適用於程式碼編寫、數學、代理工作、函式呼叫與廣泛對話用途的通用本地模型。它也闡明瞭 Dolphin 的核心理念:系統擁有者而非模型發布者,才應該決定系統提示詞與對齊政策。
這項理念正是 Dolphin 在本地社群中持續受到歡迎的原因。對於那些覺得主流重視安全對齊的助理在處理小說、私人角色扮演、本地實驗或提示詞行為研究時過於受限的使用者來說,它是不錯的選擇。同時,Dolphin 畢竟只是一個模型:它仍可能產生幻覺、遵循不良的提示詞,且若未經審查控管,也可能會產生不適合公開產品的內容。
官方下載
| 模型 | 最佳適用情境 | 下載連結 |
|---|---|---|
| Dolphin 3.0 R1 Mistral 24B | 經典 Dolphin 3.0 系列中整體的最佳品質;適用於程式碼、數學、角色扮演與代理任務 | Hugging Face 24B |
| Dolphin 3.0 Llama 3.1 8B | 消費級 GPU 測試、桌面本地對話、快速角色扮演與寫作 | Hugging Face 8B |
| Dolphin 3.0 Llama 3.1 8B GGUF | llama.cpp、LM Studio、KoboldCPP、Ollama 風格的本地使用 | 官方 GGUF 8B |
| Dolphin 3.0 R1 Mistral 24B GGUF | 量化版 24B 桌面或伺服器測試 | Bartowski GGUF 24B |
| Ollama dolphin3 | 針對 8B 的快速單一指令本地設定 | Ollama dolphin3 |
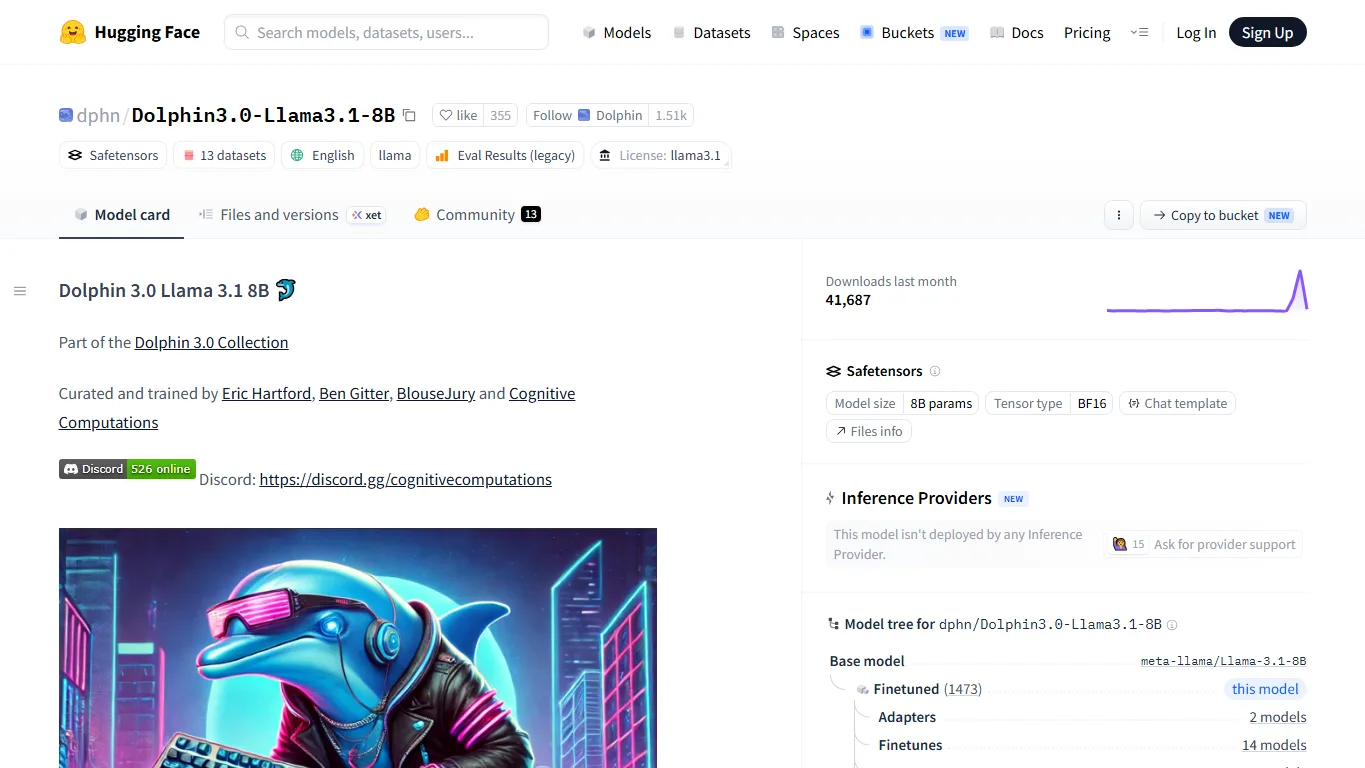
如果你剛接觸 Dolphin,建議從 8B 版本或 Ollama 開始。當你熟悉自己的提示詞、上下文長度與硬體極限後,再進階到 24B 模型。24B 模型是更具看點的評測目標,但 8B 模型才是大多數人不需要更換工作站就能實際執行的選擇。
用戶評價與優勢
社群對 Dolphin 的關注通常集中在三個優勢上:提示詞遵從度、寫作/角色扮演的穩定性,以及較少的拒絕回應。該模型並不是要成為最安全的通用助理,而是要成為一個可控的本地模型,讓使用者能透過系統提示詞來定義其行為。
相較於許多官方對話模型,Dolphin 通常給人更直接、較不囉嗦的感覺。這使得它在進行小說寫作、角色對話、私人腦力激盪、本地代理以及需要強大指令遵從度的程式碼輔助時相當實用。代價是它需要使用者具備更高的自律性:如果提示詞寫得不好,產出的結果也可能會非常直觀地呈現出缺點。
與其他本地 LLM 的比較
| 模型 | 與 Dolphin 3.0 的比較 | 誰適合選擇它 |
|---|---|---|
| Dolphin 3.0 | 經典的不受審查微調路線,具備強大的系統提示詞掌控能力,在寫作與角色扮演領域相當受歡迎。 | 希望擁有本地彈性且減少拒絕回應的使用者。 |
| Qwen 3.8 | 具備更強大的廣泛多語系/程式碼生態系統與更新的大型模型系列;在官方管道中具有更高的安全對齊性。 | 需要處理日文、中文、英文工作、程式碼編寫與 RAG 的使用者。 |
| Gemma 4 | Google 支援的模型系列,具備更清晰的官方文件與多模態焦點;預設情況下較少屬於不受審查類型。 | 偏好主流開源權重與安全文件的使用者。 |
| Llama 3.1 / Llama 4 微調版 | 龐大的生態系統與許多不受審查的衍生版本;Dolphin 則是一個具備高辨識度的策劃系列。 | 希望有最大社群模型選擇空間的使用者。 |
| Mistral Small 24B | 24B 路線背後的基礎風格相當強悍,但 Dolphin 改變了指令遵從與拒絕回應的特性。 | 希望使用更常規指令模型的使用者可能會偏好 Mistral。 |
| Nous / Hermes 模型 | 在角色扮演與指令遵從方面同樣表現出色;通常較少明確以不受審查作為行銷訴求。 | 正在比較創意寫作與代理行為的使用者。 |
本地安裝設定
針對 8B 模型,最簡單的路徑是使用 Ollama。它隱藏了大部分的安裝設定細節,足以應付快速對話測試、提示詞實驗與本地寫作工作流程。
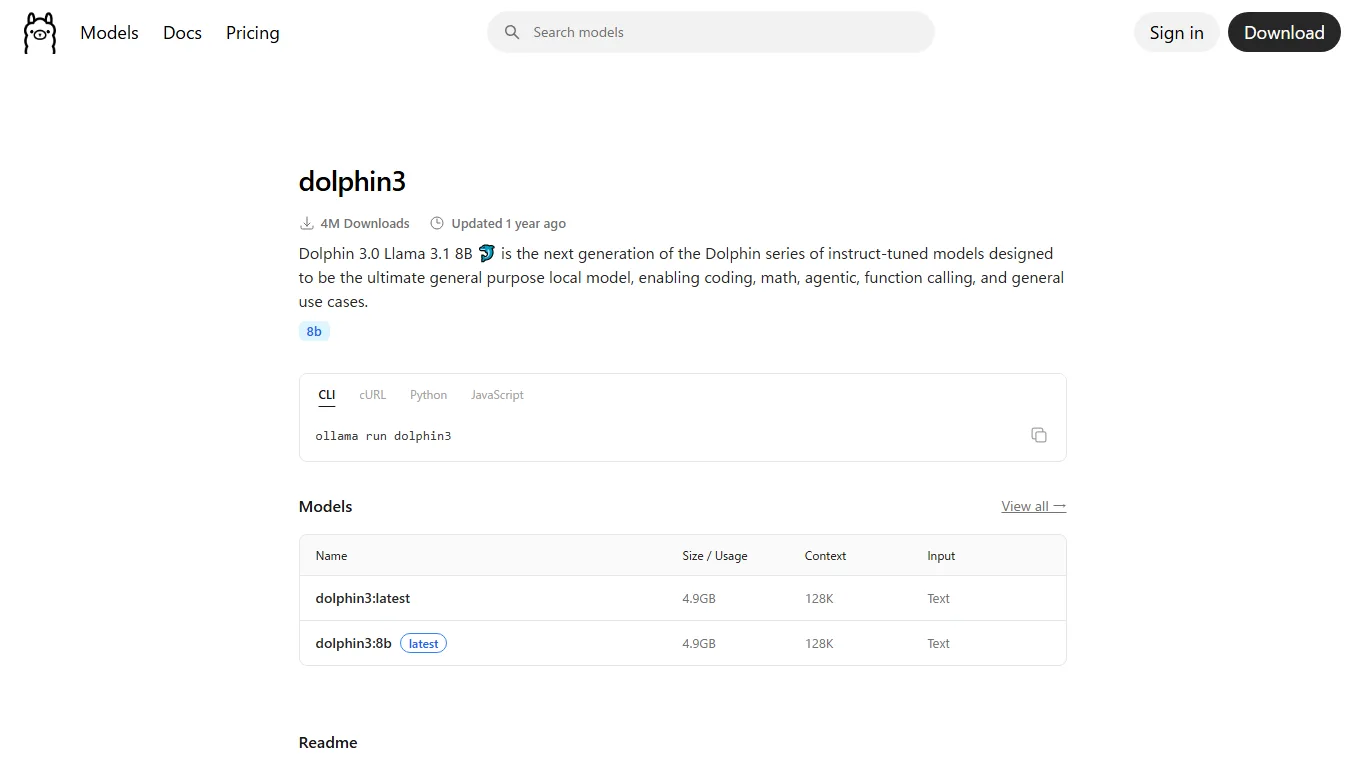
ollama pull dolphin3 ollama run dolphin3至於 GGUF 檔案,請使用 LM Studio 或 llama.cpp。如果是完整的 24B Safetensors 模型,如果你的硬體已經準備就緒,則可使用 Transformers 或諸如 vLLM 等服務堆疊。
pip install -U transformers accelerate torch safetensors python - <<'PY' from transformers import AutoModelForCausalLM, AutoTokenizer model_id = "dphn/Dolphin3.0-R1-Mistral-24B" tok = AutoTokenizer.from_pretrained(model_id) model = AutoModelForCausalLM.from_pretrained( model_id, torch_dtype="auto", device_map="auto", ) PYGPU 硬體需求
| 模型 | BF16 估算 | 實用路徑 | 備註 |
|---|---|---|---|
| Dolphin 3.0 Mistral 24B | 權重大約需要 48GB+,若搭配長上下文與 KV 快取則需更多 | 若使用 4-bit GGUF/量化版本並縮短上下文,24GB GPU 是可行的 | 品質最佳,但並非最容易落地的本地模型。 |
| Dolphin 3.0 Llama 3.1 8B | 16GB+ 對於 BF16 風格的使用而言相當舒適 | 透過 GGUF 量化,6GB 至 12GB 即可運作 | 最適合家用 GPU 的首選模型。 |
| 純 CPU GGUF | 不需要 VRAM,但速度較慢 | 配合 llama.cpp 或 LM Studio 使用 Q4/Q5 GGUF | 適合寫作測試,對大型代理不太理想。 |
| 線上 API/對話 | 無需本地 GPU | 使用 Dolphin 網頁版、OpenRouter 或其他供應商 | 在下載前進行評估的好選擇。 |
實際的記憶體需求取決於量化方式、上下文長度、批次大小、KV 快取、GPU 卸載設定以及你所使用的執行工具。若是進行長上下文的角色扮演或寫作,記憶體消耗會快速增加。如果模型載入後變得緩慢或當機,請在假設模型無法使用之前先調降上下文長度。
當硬體不足時的線上使用方式
Dolphin 官方的網頁入口為 dphn.ai/chat,且 Dolphin 的 Hugging Face 組織頁面也會引導使用者前往官方專案管道。如果你想在下載本地模型前先了解該專案,這裡是最佳的起點。
若要進行 API 測試,OpenRouter 的 Cognitive Computations 頁面會相當實用。它列出了 Cognitive Computations 的模型,並讓開發者能夠比較價格、上下文視窗與功能。Venice 則是另一項備受注重隱私與較少限制對話的用戶青睞的線上 AI 對話服務,不過它應該被視為獨立服務,而非官方的 Dolphin 網站。
NSFW 與不受審查的表現
Dolphin 3.0 是知名度較高的不受審查本地模型系列之一。在私人的本地使用情境下,它比主流的雲端助理更願意配合成人、角色扮演或敏感的創意提示詞。這也是為什麼人們會用 NSFW、不受審查、角色扮演和免越獄本地 LLM 等關鍵字來搜尋 Dolphin 的主要原因。
不過,不受審查並不代表無害或毫無限制。如果給予特定的提示,Dolphin 仍然可能生成成人內容、不安全的建議、帶有偏見的內容或在法律上敏感的輸出。模型無法自動取代政策設計。如果你將其部署給其他人使用,你需要建立自己的規範、過濾機制、日誌記錄選項與濫用處理流程。如果是個人使用,請將其保留在本地,並留意你所在當地的法律與平臺規則。
看待 Dolphin 最健康的態度,不是把它當成一個沒有後果的奇蹟模型,而是把它視為一個可控的本地微調模型。當你希望系統提示詞能發揮作用,並且願意為自己的要求承擔責任時,它會有極佳的表現。
常見問題
Dolphin 3.0 真的完全不受審查嗎?
它比主流的雲端助理産生拒絕回應的情況少得多,並被廣泛認為是屬於不受審查微調傳統的一部分。但其表現仍取決於模型變體、提示詞、執行工具以及你所加入的任何審查防護層。
我應該從哪個 Dolphin 3.0 模型開始入門?
如果你使用的是一般桌機,建議透過 Ollama 或 GGUF 從 Dolphin 3.0 Llama 3.1 8B 開始。當你追求更好的品質且擁有充足的 VRAM 或量化版本時,再去嘗試 Dolphin 3.0 R1 Mistral 24B。
RTX 4090 24GB 可以執行 24B 模型嗎?
完整的 BF16 24B 模型對於 24GB 的環境來說過於龐大而難以舒適運行,但透過 4-bit GGUF 或其他量化版本,在較短的上下文與謹慎的設定下是可行的。
Dolphin 擅長處理日文嗎?
它可以以日文回應,但它並非主要以日文聞名的模型。若要產出流暢的日文寫作,Qwen 或其他多語系模型可能會更強大。Dolphin 的吸引力在於其提示詞遵從度與不受審查的角色扮演行為。
線上使用 Dolphin 安全嗎?
線上服務商都有各自的隱私規則、日誌記錄、審查機制與條款。對於敏感的提示詞,在本地使用會更安全。若只是進行快速評估,只要不上傳機密資料,線上網站還是相當方便的。
我可以商業使用 Dolphin 嗎?
請檢查你所下載的具體模型、任何基礎模型或 GGUF 轉換版本的授權條款。授權與可接受的使用條款可能會在基礎權重、微調版和量化上傳版本之間有所不同。
總結
Dolphin 3.0 依然是經典不受審查本地微調路線中最乾淨的範例之一。當讀者追求創意寫作、角色扮演、代理風格提示詞、程式碼協助,且希望比主流對話助理獲得更少的拒絕回應時,它相當值得推薦。
最好的第一步是透過 Ollama 或 GGUF 使用 8B 模型。如果你擁有更強大的硬體,24B Mistral 模型則是追求更高品質的目標。針對 NSFW 與不受審查的使用情境,該模型之所以強大,正是因為它將更多的控制權交還給使用者,這也意味著使用者必須承擔更多的責任。
參考資料
相關 評測
FLUX 3 評測:影片、圖片、開源權重與 NSFW 政策

Qwen Image Edit 評測:文字編輯、局部重繪、ComfyUI 與 NSFW 政策

Nucleus Image 評測:17B 稀疏 MoE、本地架構、NSFW 支援與 Apache 2.0 開放權重
2026 年最佳本地開源 LLM:效能、NSFW 與硬體對比
Seedream 5.0 Pro 深度評測:AI 圖像模型、API 存取與 NSFW 政策