MiniMax M3.1 Flash 評測:程式能力、API 費用、公開權重與硬體需求
解析 MiniMax M3.1 Flash 的 428B/23B MoE、程式與代理基準、API 費用、推理設定、本機硬體、商用授權與幻覺風險。

更新:2026年10月23日
MiniMax M3.1 Flash 值得列入低成本程式設計與 AI 代理的試用清單。低 API 單價、百萬 Token 上下文與新公開的權重,對需要反覆修正程式、串接工具的團隊有吸引力;取捨則是推理無法完全關閉、事實回答容易過度自信,以及本機部署並不輕量。
我們的判斷是:適合有人驗收的開發及業務自動化,先比較通過測試的成果與整體成本,再決定是否切換。23B 啟用參數不等於小模型,Space Bunny 的流量也不能取代正確率。
428B/23B 是什麼意思?
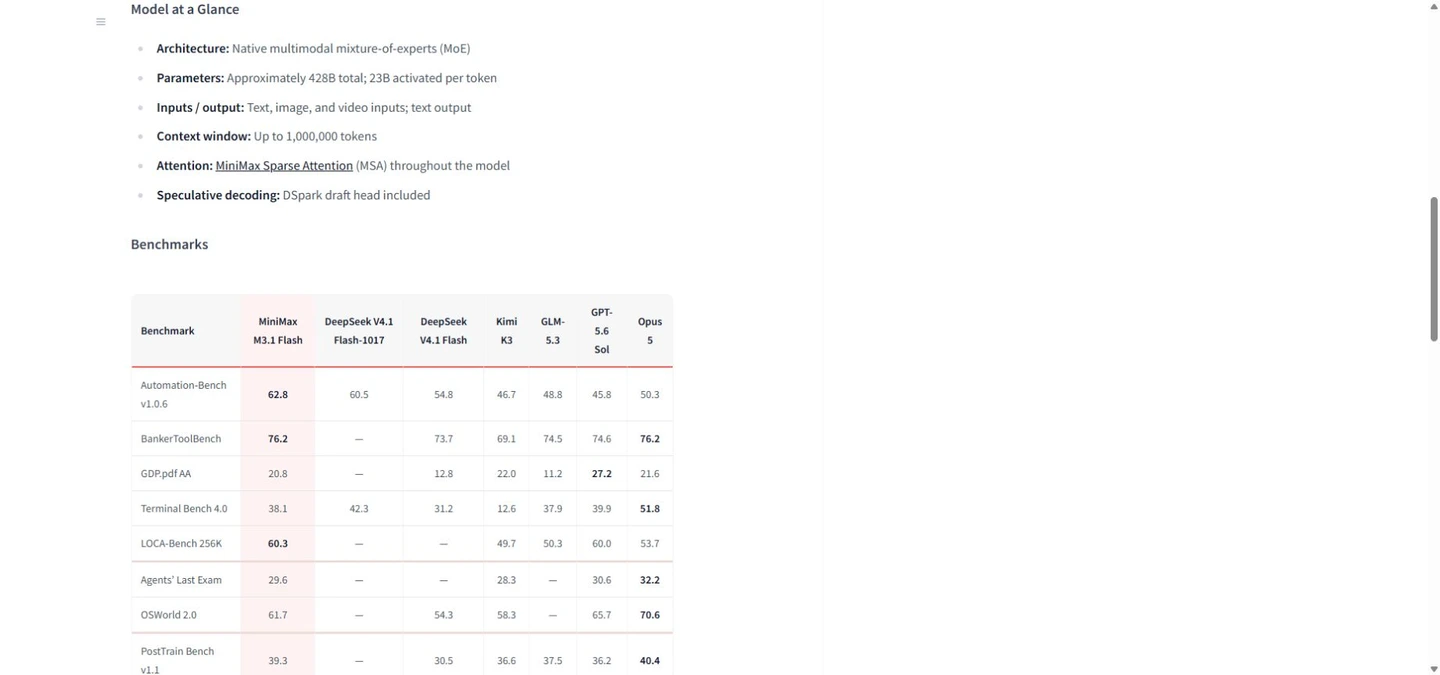
託管服務於10月19日推出,權重於10月23日公開。MiniMax M3.1 Flash — Hugging Face列出約4,280億總參數、每個 Token 啟用約230億的 MoE 架構,接受文字、圖片、影片輸入,輸出文字。它不是 MiniMax H3,也不是直接生成圖片、影片或語音的模型。
新版本沿用 M3 系列架構,改為全層稀疏注意力、量化感知訓練,並附 DSpark 推測解碼草稿頭。這些設計減少推理計算量,但未啟用的專家權重仍須儲存。不能用23B直接推算完整模型所需記憶體。
| 項目 | 目前規格 |
|---|---|
| 架構 | 總參數428B/每個Token啟用23B;MoE |
| 上下文/生成上限 | 託管:1,000,000/524,288 Token,仍受請求預算限制 |
| 輸入 → 輸出 | 文字、圖片、影片 → 文字 |
| 推理 | 持續啟用;low/medium/high/xhigh/max |
| 權重/授權 | 可下載;MiniMax Community License |
公開權重與商用授權條件
官方權重已可下載,但MiniMax Community License是 MiniMax Community License,並非 MIT 或 Apache。商用時須顯示「Built with MiniMax M3.1-Flash」。相關產品或服務年營收超過2,000萬美元,須事先取得書面授權;低於門檻則須依指定方式寄送一次通知。
條款另有禁止用途,商用定義涵蓋微調後部署和商業 API。非商用使用同樣受條款約束。較精確的說法是附條件的公開權重;不能把它解讀成完全不受限制的開源,也不能以權重授權取代雲端 API 或訂閱的服務條款。
72小時、106兆與200兆 Token 如何解讀?
OpenCode原始公告將 Space Bunny 連續12天排名第一、累計106兆 Token,與新提供3天免費使用分開敘述。OpenRouter則說連續10天第一、56.7兆 Token,接著宣布72小時免費活動。這是不同平台、不同期間的數字。
MiniMax — M3.1 Flash的超過200兆 Token 指匿名運作的早期版本累計,不能據此寫成正式版「72小時處理超過100兆」。流量可能包含輸入、輸出、重複上下文與大量使用者並行,反映採用量,並非單一請求速度或有用答案的數量。免費期限與配額須查看實際供應商。
基準成績:自動化突出,程式並非全面領先
10月23日模型卡列出 Automation-Bench v1.0.6 62.8、DeepSWE v1.1 73.7、Terminal Bench 4.0 38.1。初期報導曾引用62.2;下表採最新模型卡,避免混用版本。這些比較是廠商公布的測試,不是本文自行重跑的數據。
MiniMax 在所選自動化項目領先,但 DeepSeek V4.1 Flash-1017 在 DeepSWE、Terminal Bench、NL2Repo 較高,Opus 5 的 Terminal Bench 也明顯較高。DeepSWE 使用 mini-SWE-agent 2.4.5 與512K上下文,Terminal Bench 使用 Codex 0.149.1。不同代理框架、工具、步數和基準版本會改變結果,不宜拿來排單一總名次。
| 基準(廠商公布) | M3.1 Flash | DeepSeek V4.1 Flash-1017 | Opus 5 |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 | 50.3 |
| DeepSWE v1.1 | 73.7 | 77.0 | 74.0 |
| Terminal Bench 4.0 | 38.1 | 42.3 | 51.8 |
| NL2Repo-Bench | 61.2 | 68.2 | 75.3 |
| BankerToolBench | 76.2 | — | 76.2 |
| CyberGym | 82.2 | — | — |
| BabyVision (with tools) | 91.0 | 92.5 | 94.1 |
採目前官方模型卡。破折號是未公布,並非零分;BabyVision 為使用工具的結果。
速度也須分清條件:MiniMax 宣稱輸出超過200 Token/秒、中位數超過170;核對時 Artificial Analysis 頁面顯示92.5 Token/秒。不同服務與量測條件不能當同條件對決。輸出吞吐不包含所有輸入處理、推理、工具與重試等待,應以自己的上下文和並行量測到可用成果的時間。
程式修正與代理工作的實際價值
適合優先試用的任務包括依日誌重現錯誤、實作範圍清楚的功能、核對試算表與來源文件,以及讓多個工具中的資料保持一致。MiniMax Code — M3.1 Flash展示支援工單介面效能分析等案例,但展示個案並不保證其他系統有相同改善幅度。
交付儲存庫、重現步驟、失敗測試和不可變更的資料,要求先解釋根據,再做最小修正並回報真實測試輸出。工具呼叫須由宿主執行;模型本身不會自動獲得電腦或企業系統權限。把可寫入範圍限制在任務所需,並驗收外部操作與程式變更。
圖片、影片與百萬 Token 上下文
介面截圖能提供畫面證據,錄影能表達互動順序。輸入圖片、影片不代表原生生成媒體;圖表、簡報或 Three.js 場景是透過程式與工具建立。這個權重的規格並未列出音訊輸入或語音輸出。
官方託管上下文上限為1,000,000 Token,API 生成上限524,288 Token,仍受請求及總預算限制,不宜直接當預設值。文件、圖片、工具歷史與推理都消耗資源。長視窗不保證記得每個細節;先提供相關檔案,要求標明來源位置,再核對跨文件一致性。公開資料未清楚標示知識訓練截止日。
推理強度與 API 整合細節
MiniMax API提供 low、medium、high、xhigh、max,預設 max,無法完全停用思考。Anthropic 相容介面使用 output_config.effort;OpenAI Chat Completions 使用 reasoning_effort;Responses 使用 reasoning.effort。客戶端若刪除不認識的欄位,可能與預期設定不同;none 或 disabled 也不受支援。
依MiniMax Tool Use保留完整助理訊息、reasoning_content 與工具呼叫 ID,再接續下一輪。部分直接工具回覆可能沒有推理欄位,程式須容許缺省。JSON 外觀仍須解析與 Schema 驗證,不代表嚴格結構保證。一般工作可從 medium 比較,難題再提高,同時限制輸出、輪數與重試。
價格與成功完成任務的成本
官方每百萬 Token 單價為未快取輸入 US$0.15、輸出 US$0.60、快取輸入 US$0.015。輸入100萬加輸出10萬,模型費用 US$0.21;若所有輸入符合快取命中,則為 US$0.075。計算不含工具、主機、稅費或重試,快取也非一律適用。這是美元價格,並非固定新臺幣收費。
應計入課金推理 Token,並以驗收成功的結果計算平均成本。便宜模型若重試多次,總費用可能反而較高。廠商稱代理任務成本減少70%,不等於所有 API 單價打三折。M Plan、MiniMax Code 與第三方免費端點有各自配額、日期和服務規則。
| Token 類型 | 每百萬Token/美元 |
|---|---|
| 未快取輸入 | 0.15 |
| 輸出 | 0.60 |
| 快取輸入 | 0.015 |
本機部署需要多大的硬體?
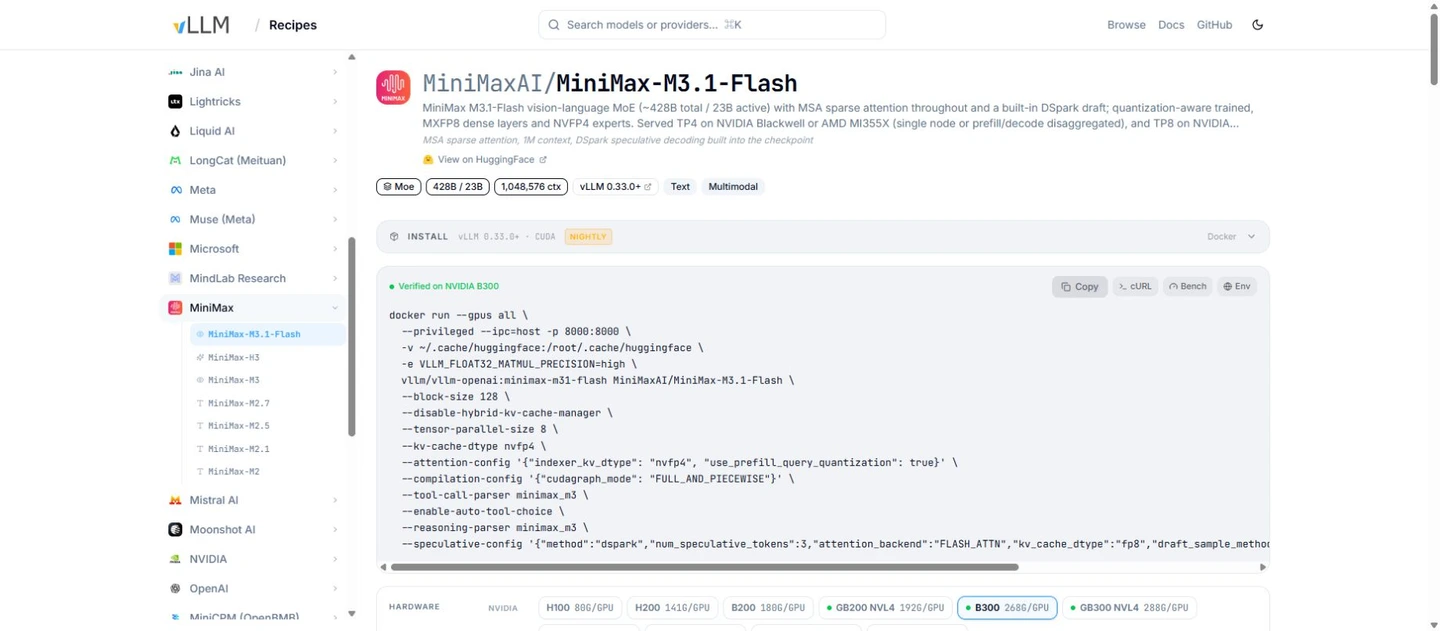
官方發布包含 MXFP8 路徑及 NVFP4 MoE 專家的混合量化,並非單純 BF16。10月23日檔案列表中的48個主要 safetensors 合計約250.1GB(十進位),另有約2.3GB DSpark 權重及其他檔案。這是下載容量加總,不是實測顯存。打包 U8 張量的元素數也不能用來否定架構標示的428B。
vLLM列出支援 Blackwell、AMD MI355X 的 TP4,以及 H100/H200 的 TP8 等伺服器方案。Hopper 範例將上下文限制到262,144、停用影片與 DSpark,顯示功能須按部署確認。還要保留 KV cache、影像處理、並行請求與執行額外空間,不能宣稱單張24/32GB完整載入。SGLang也是官方連結的路線;更低位量化與卸載需另測品質及速度。
幻覺、多語言、NSFW 與社群反應
10月23日Artificial Analysis頁面顯示 Intelligence Index 43、評測平均每任務約 US$0.22。發表時的 max 評估為42,AA-Omniscience 答對56%,幻覺率93%。依AA-Omniscience,幻覺率分母是全部非正確回覆,包含部分回答與未回答,並不是所有答案93%錯誤;它提醒我們模型遇到不知道的問題仍傾向作答。
Reddit — LocalLLaMA既有期待,也有對下載容量、推理支援的疑慮;Reddit — OpenCode有免費使用到期的使用者回報,屬個案而非控制實驗。七種語言尚沒有同樣完整的獨立結果。繁中使用者應另測臺灣用語、人名、日期、數字、程式註解及文件措辭,不要把英文基準當成繁中正確率保證。
公開權重不等於無審查或可靠的 NSFW 能力,授權有禁止用途,託管服務另有審核政策。雲端推理也不是本機處理。傳送內部程式或客戶資料前,應確認所選服務的保留、處理地區與帳戶條款;能回答繁中,不代表有繁中介面、臺幣帳單或指定地區服務。
切換前的實務試用方法
準備兩個附失敗測試的真實錯誤、一次截圖 UI 診斷、多文件數值核對,以及一個來源不足的問題。使用相同檔案、工具權限與時間預算比較,並加入繁中規格或客服內容,才能知道語言是否適合團隊。
提示詞可寫:「先重現錯誤,為每個診斷提供檔案和行號,做最小可行修正,執行相關測試並回報未解決失敗。缺少事實時請說明不足,不要猜測。」記錄通過驗收數、重試、輸入/快取/推理/輸出 Token、第一個可用結果與總耗時。這是建議測試流程,並非 AirMore 已執行的實測。
常見問題
M3.1 Flash 是完全開源嗎?
權重已公開,但 Community License 有商用標示、通知/事先授權及用途限制。部署前應讀目前版本的完整授權,用「附條件的公開權重」較精確。
一張24GB顯卡可以跑嗎?
官方完整權重遠大於此。23B指每個 Token 的啟用計算規模;卸載後能載入,不保證有可用速度、長上下文或完整多模態功能。
可以關閉推理嗎?
不行。降低 effort 可減少等待與 Token 使用,並須使用協定對應欄位。none、disabled 不是這個模型可用的無思考模式。
可以直接生成影片或配音嗎?
這個模型接受文字、圖片、影片,回傳文字。MiniMax 其他產品或外部工具可生成媒體,不能把它們的能力算成本模型輸出。
是否永久免費?
限時活動不代表永久無限使用。官方隨用隨付、M Plan 配額及第三方試用須分開查看,使用前確認目前價格及限制。
一定比 DeepSeek 或 Claude 好嗎?
不一定。廠商表格也顯示自動化部分勝出、程式部分落後。以相同工具和重試次數比較驗收結果,會比只看單一分數更有意義。
結論與資料來源
M3.1 Flash 的優勢是低價代理工作、長上下文及可下載權重。最務實的導入方式是先以託管服務做有限範圍試用,檢查正確性、測試結果及完成成本,再評估是否部署到自有硬體。自建方案還須符合 GPU、維運與授權條件。
如果需要小型桌機模型、原生影音生成、嚴格 Schema 保證或無需驗證的事實答案,它不會自動滿足這些需求。影像創作用途可另看屬不同類別的MiniMax H3,避免把模型和工具環境混為一談。
資料核對日期2026年10月23日:MiniMax M3.1 Flash — Hugging Face、MiniMax Community License、MiniMax — M3.1 Flash、MiniMax API、MiniMax Tool Use、vLLM、SGLang、Artificial Analysis及Artificial Analysis — 2026-10-19、AA-Omniscience、OpenCode、OpenRouter、Reddit — LocalLLaMA。VentureBeat亦關注費用與事實可靠性的取捨。本篇是公開資料技術評估,不是 AirMore 自行執行的 GPU 速度測試或程式模型對戰。
相關 評測
Strata 評測:本機 AI 的模型支援、安裝、效能與隱私

Gemma 4 評測:本機部署、GPU 需求與 NSFW 政策
MOSS-Image 評測:文字、構圖、NSFW、顯存需求與 ComfyUI 設定
HiDream O1 評測:圖片生成AI、LoRA、本機部署與 NSFW 對應
Grok 4.6 評測:xAI 推理模型、Agent、價格與 NSFW 政策

HunyuanVideo 1.5評測:畫質、VRAM、ComfyUI、價格與NSFW限制