Strata 評測:本機 AI 的模型支援、安裝、效能與隱私
了解 Strata 桌面程式、支援模型、硬體需求、程式工具連接、使用者回饋與 DeepSeek 的 12GB 方案。

Strata 是免費開源的本機 AI 軟體,可執行指定語言模型,並連接聊天或程式開發工具。它的特色是利用 GPU 顯存、系統 RAM,必要時再搭配 SSD,讓一般電腦也有機會運行較大的相容模型。適合願意管理硬體與下載內容、希望掌握本機環境的使用者。
它的吸引力在於把模型選擇、本機聊天與程式工具連接整合到同一個環境。日常是否順暢,取決於能否選到符合 RAM 與儲存空間的相容模型,以及硬體和設定是否合適。
目錄
Strata 如何運作
Strata 提供桌面程式與 Terminal 啟動器,以及針對相容模型系列的本機推論引擎。對混合專家模型,它將部分元件放在 GPU、CPU 與 RAM;記憶體不足時可從 SSD 讀取更多資料,通常會犧牲速度。回答品質仍受模型、量化和設定影響。
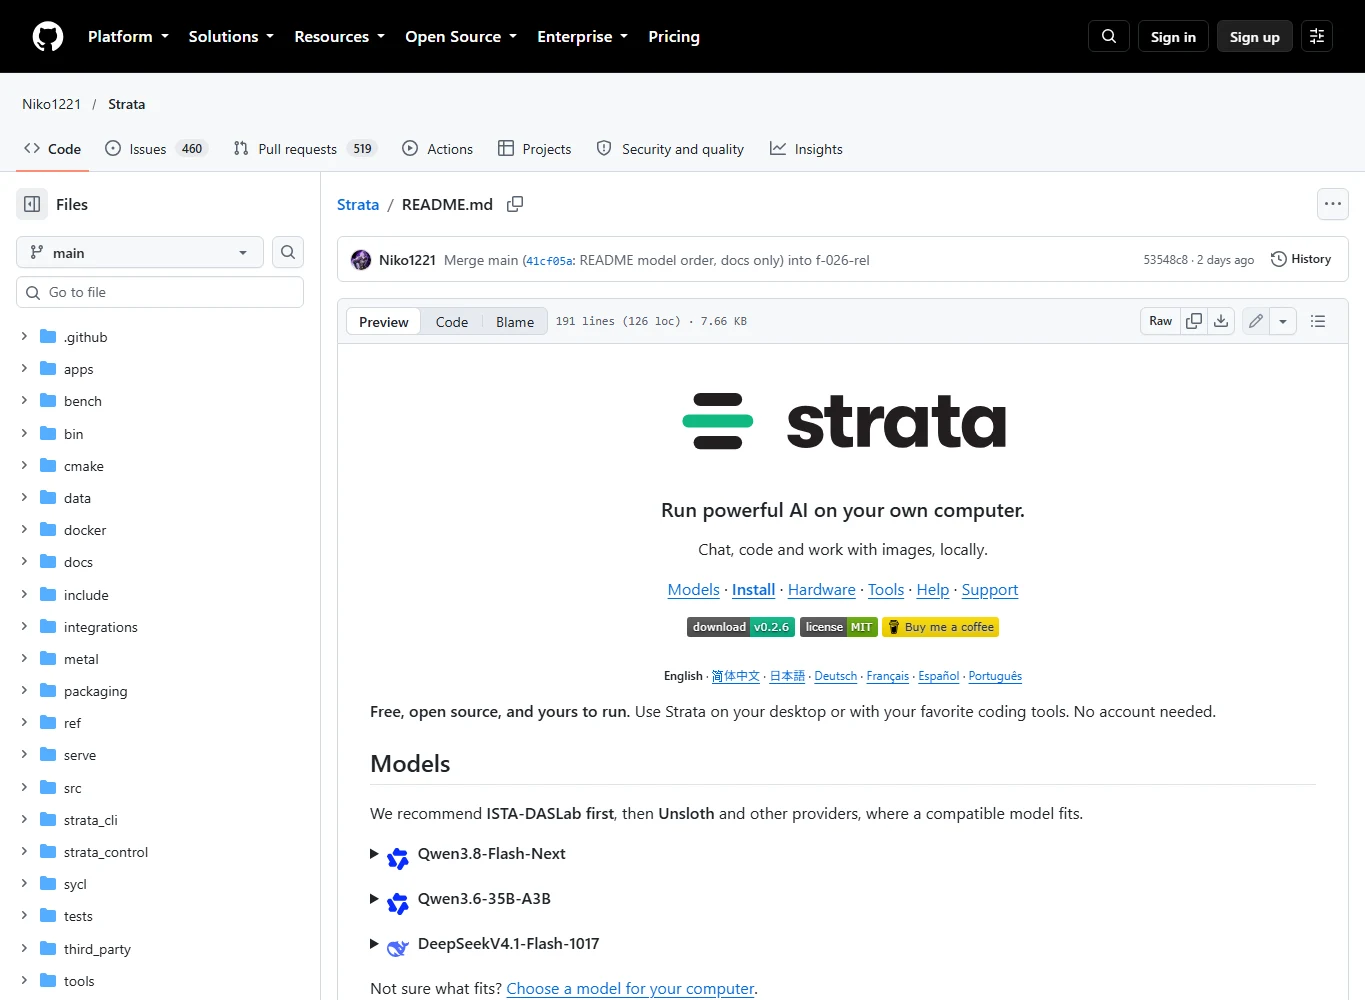
官方表示本體免費、採 MIT 授權且不需帳號。0.2.10 提供 Windows、Linux 及 Apple Silicon macOS 安裝程式,但個別模型與引擎的硬體及系統支援範圍可能更窄。
支援模型與硬體
官方列出 Qwen3.8-Flash-Next 的 ISTA-DASLab、Unsloth 等相容套件;Qwen3.6-35B-A3B 的 Unsloth 套件;以及使用獨立引擎的 DeepSeek V4.1-Flash-1017。模型檔不能任意互換,必須選擇相容系列與套件。
官方估計 Qwen3.8-Flash-Next Q2_0 權重需 RAM+VRAM 共 37.6GB,IQ3_S 約 54.8GB,尚未包含作業系統和上下文開銷;不足時某些路徑可從 SSD 讀取但較慢。Strata 整體列出 NVIDIA RTX、部分 AMD Radeon、Linux 的 Intel Arc、Apple Silicon 與 Ryzen AI Max;實際仍依模型和後端而定。
安裝與日常使用
0.2.10 官方流程是下載系統對應的安裝程式;Windows/Linux 首次啟動時取得對應 GPU 引擎,選擇模型與儲存位置後下載、準備並開始聊天。Mac 安裝檔包含 Metal 引擎,Intel Arc 使用 Linux Terminal。首次下載與初始化可能耗費相當時間。
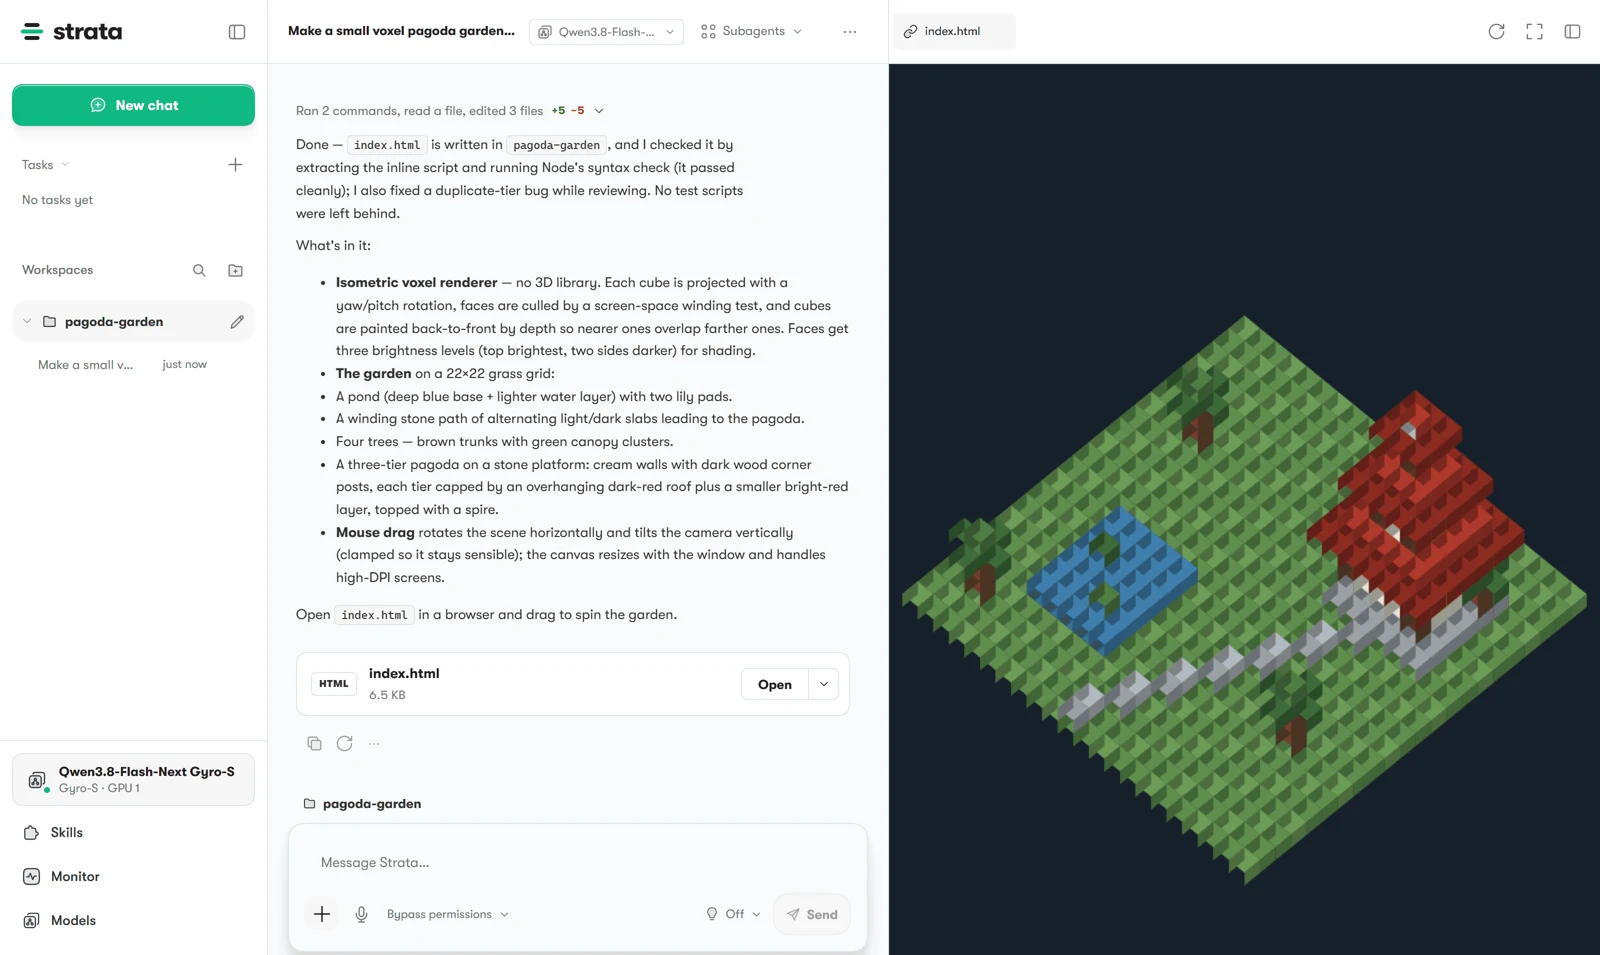
桌面程式提供聊天、檔案及程式碼即時預覽;Terminal 提供引導設定和監控。這些是官方描述,並非本站實際操作測試。下載大型模型前,先確認驅動、空間、模型授權及疑難排解文件。
Strata 0.2.10 最新版本:功能、升級與硬體取捨
截至 2026 年 11 月 4 日,最新版本為 Strata 0.2.10。桌面應用與 Terminal 是 0.2.10,Control 與引擎套件是 0.1.56,版本號不同屬正常。重點是記憶體配置、推測解碼、符合條件的 Linux 多 GPU 與代理操作改善,並非所有電腦都能一律快兩倍。
DFlash2 成為單一請求的預設選項
Qwen3.8 的 Drafting 設為 Auto 時,支援的引擎通常為單一請求選擇 DFlash2,由小模型先預測、主模型批次驗證。開發者在 Q4_0 selector 配置下記錄 GPU 記憶體 625MiB,首次下載與準備約 1.2GB。不再下載的 MTP 層約為 5.2GB 檔案,不能直接換算成所有配置都固定省下 4GB VRAM。
同時兩個以上請求、DeepSeek/Coder、不支援 DFlash2 的引擎及全卡分割仍由 Auto 選 MTP;一次只載入一個 drafter。速度增益也有差異:RTX PRO 5000 IQ3_S 的一般採樣短回答比 MTP 快 6.23%、長回答快 1.38%,Arc A750 卻慢 2.6%。Auto 並非每種工作都最快。
8GB 啟動 128K,不等於保證高速
預設上下文為 131,072 token。獨立顯卡顯存不足時,會縮小 GPU 內 KV 視窗、必要時省略 MTP、減少輸入緩衝,最後才將輸出頭移至鎖定的主機 RAM,保留使用者要求的上下文。最後一步可能讓生成慢約三倍;Apple 統一記憶體與整合式 Strix Halo 不套用同一個獨顯流程。
下表是開發者測試,並非 AirMore 實測。高速的 NVIDIA/Radeon「8GB」數據來自大容量 RAM 工作站上手動限制的大卡,家用電腦記憶體不足時可能更依賴 SSD、速度更低。
| 測試條件 | 公開結果 | 正確解讀 |
|---|---|---|
| Qwen3.8 IQ3_S、模擬 8GB、128K、DFlash2 | 63–73 tok/s;32K 輸入 19.8 秒 | 不是 RTX 3060 8GB 實機結果 |
| 真實 Intel Arc A750 8GB、128K 啟動 | 12.7–14.8 tok/s | 真實 8GB 卡,引擎與記憶體路徑不同 |
| RTX 5070 12GB 限制至約 8GB | 比完整顯存慢 17–27% | 保留上下文仍可能犧牲吞吐 |
128K 表示可請求的容量,不代表整段資訊召回與推理正確率已有保證。
多 GPU 加速有明確適用條件
全卡分割讓每張 GPU 分擔每一層。0.2.10 在符合條件的 Linux Terminal/伺服器自動啟用;桌面應用仍使用逐層分割+DFlash2,全卡分割的桌面整合列為 0.2.10.1 計畫,不能視為已發布。
Auto 條件包括:恰好兩張 compute capability 8.6 或 12.0 的 NVIDIA,或四張 R9700 配指定 UD-Q4_K_XL 類型套件;支援的 Qwen3.8;所有路由專家能放進 GPU 總顯存;RAM 端資料約需 43GiB 空間;上下文不超過 128K。開發者測過 A6000/PRO Blackwell 配對,未測 GeForce 雙卡。其他配置通常保留逐層分割。
以下是開發者以 Linux、兩張 RTX A6000、UD-Q4_K_XL、128K 交替測試、各三次中位數的比較,不能套用到單張 12GB 卡。
| 任務 | 0.2.9 逐層分割 | 新全卡分割 |
|---|---|---|
| 程式碼編輯 | 195 tok/s | 377–394 tok/s |
| 新增程式碼 | 139–144 tok/s | 189–232 tok/s |
| 一般文章 | 93 tok/s | 139–146 tok/s |
ISTA-DAS Coder 與 Mac 圖片輸入
ISTA-DAS Coder 是 DeepSeek-V4.1-Flash 的剪枝版本,每層保留 384 個專家中的 192 個,並非完全不影響原始能力的加速開關。全新下載約 191GB,含模型 72.1GB、共用 Engram 表 110.6GB、drafter 8GB。既有相同 Engram 可重用,新增下載約 80GB;圖片檔另需空間。請以 plan 計畫估算,不要只看權重大小。
它面向程式與代理工作,公開比較顯示一般文字與多語任務取捨較大。開發者某項測試的一張 R9700 為 22.8 tok/s;本版 Windows NVIDIA 的 Coder 路徑則僅確認計畫,尚未實跑測速。顯示 12GB 能配置,不代表速度已有保證。
Mac 的 DeepSeek 引擎新增圖片理解。M5 Max 的八項圖片請求可讀取,但發票代碼仍有一字誤讀。這是看圖,不是生圖;首張圖編譯多花 6.0–8.7 秒,M1–M3 未測。M4 32GB 的視覺編碼器單獨測試,也不證明完整 DeepSeek 能裝進該 Mac。
桌面介面及程式工具的實用改善
- 長回答捲動時 Approve/Deny 仍停在輸入框上方,較容易確認待批准動作。
- Subagents 可收後續指令並回報送達或拒絕;生成中的 Enter 可設定等待、排隊傳送或中斷。
- 舊對話摘要改為要求使用者的語言,路徑、命令及名稱保留;可引用既有回合或選取文字。
- 改善 Anthropic/Responses 工具處理;/v1/messages 的上下文超限錯誤讓 Claude Code 能嘗試壓縮或縮短輸出,而非反覆送同一超長請求。仍須依客戶端確認。
- Windows 低優先背景啟動不再繼承極低磁碟優先權而拖慢載入;更新後的引擎儲存路徑也能追蹤。
如何升級、確認版本與回復
先卸載運行中的模型並保存執行設定,再替換引擎。桌面用內建更新功能,Terminal 可用下列命令檢查及升級。
升級後確認應用/Terminal 0.2.10、Control/引擎 0.1.56。若專門從 0.2.9 更新 DeepSeek,需要執行兩次:第一次更新啟動器、Control、Qwen,第二次才取得 DeepSeek 套件;期間舊 DeepSeek 引擎仍能運作。低於 0.2.0 的 Terminal 應重跑官方安裝程式。
strata update --check
strata update
strata --version
strata doctor --live
strata launch --family qwen --model iq3_s --plan
strata launch --model ISTA-DAS-Coder --plan相容的既有模型檔會重用,毋須因更新刪除數百 GB 權重。若新引擎異常,停止模型後回復保留的舊元件,再測短聊天、檔案/工具呼叫及長提示詞。
strata components rollbackRAM、常駐模型與 SSD 壽命
12GB VRAM 並未裝下完整 125B 模型,工作由 GPU、CPU/RAM、SSD 分攤。原始 Qwen3.8 套件權重估算,Q2_0 的 RAM+VRAM 約 37.6GB,IQ3_S 約 54.8GB,尚須 OS 與上下文空間;量化、RAM 頻寬與 PCIe 都影響體感。
若用於 ComfyUI 提示詞增強,可先完成文字,再卸載 Strata 模型,把 GPU 交還產圖流程。使用 GPU memory for other apps 或 Leave room for my work,不要把桌面顯示保留量硬設為零。Terminal 背景伺服器需另外檢查狀態並停止。
SSD 存取不等於同量磨損:Engram/查表主要讀取資料,TBW 衡量寫入。但下載、準備、紀錄與 OS 交換檔仍可能增加寫入。以實際工作觀察主機寫入量、SMART、可用 RAM、swap、溫度及磁碟延遲;沒有可驗證的「Strata 固定幾個月耗盡 SSD」壽命。
strata launch --status
strata launch --stop
RTX 3060 漲價趣聞:證據到哪裡?
Strata 讓舊 12GB 卡更值得研究,但不能證實「Strata 導致 RTX 3060 漲價」的市場因果。Tom’s Hardware 在 2026 年 8 月、這次 11 月更新之前已報導新品 3060 漲價。供貨、記憶體成本、地區與二手卡狀態,無法靠少數貼文和 Strata 需求分離。
關注背後有實例:10 月一則社群測試以單張 RTX 3060 12GB、無螢幕雙 Xeon、64GB RAM、引擎 0.1.47,回報生成約 50 tok/s、輸入約 1,000 tok/s。這是舊版自述,不是 0.2.10 測試,更不代表只換 3060 就能重現;預算需一起考慮 RAM、SSD、供電、散熱及模型。
更新後仍須留意的限制
本版仍列出:DeepSeek 大量從 SSD 串流時工具呼叫可能損壞,temperature 0 也可能每次啟動答案不同。全卡分割不支援 logprobs/logit_bias,部分長提示詞讀取反而較慢。較早 0.2.8 曾因重複輸出回報,將低 VRAM 路由加速預設關閉;不要直接照抄舊的「12GB 加速」參數。從 Auto 起步,分別比較輸入吞吐、首 token 延遲、生成速度和正確性。
最新版本小節於 2026 年 11 月 4 日確認,依 0.2.10 發布紀錄、模型/安裝文件及具名社群回報整理;數字為開發者或用戶測量,非 AirMore 硬體實測。
程式工具與 API
Strata 提供與 OpenAI、Anthropic 相容的本機 API,可連接 Claude Code、Codex CLI 和 OpenCode 等工具;`strata connect` 可查看連接指引。API 相容不代表所有雲端服務的參數與工具呼叫行為都完全相同。
建議先以短提示詞和簡單工具呼叫測試實際用戶端,再投入大型程式工作流程。上下文、圖片、並行請求與工具功能依模型和引擎而異,不能把 Qwen 的功能直接套用到 DeepSeek。
效能與實際使用者回饋
一位使用者以 RTX 5070 Ti 16GB、64GB RAM、Qwen3.8-Flash-Next IQ2_XS 和 Strata 0.1.38–0.1.43,將 28 個 DevOps 題目各測兩次,其中一種設定回報 49/56。這是本人回報的有限任務,不能視為目前 0.2.10 的認證或所有任務的品質保證。
另一位使用者在 RTX 4080+3060 配置回報單卡約 55 tokens/s、雙卡約 45 tokens/s;另有討論提及回答迴圈與連接埠困擾。這些是個別經驗,不代表一般故障率或公平對照。外部整理型評測也提醒硬體、大型下載與代理工作流程的取捨。
DevOps user report · Dual-GPU user report · User discussion · External review
大型模型應用案例:以12GB顯存執行DeepSeek
DeepSeek V4.1 Flash 1017 的 12GB GPU 執行只是 Strata 的其中一項能力。開發者案例另需 46–64GB 系統 RAM;2.00-bit 約下載 257GB,NVMe 建議約有 265GB 空間。本站未重現測速。
DeepSeek 指南以 8,192 token 為基準,圖片輸入與並行處理應依引擎、後端分別確認;0.2.10 已加入 Mac Metal 圖片輸入,詳見最新版本章節。Qwen 的 128K 結果不是 DeepSeek 上下文保證。Faster 可能使用六個專家中的五個,Full quality 使用六個。開發者 0.2.5 的歷史結果為 RTX 5070 輸出 4–6、RTX 3060 為 9–11 tokens/s,PC 條件不同,並非 0.2.10 新測量。
隱私、安全與費用
開發者表示 Strata 不傳送使用遙測,伺服器預設僅在本機監聽。下載模型與引擎、檢查更新需要網路;選用網頁搜尋、外部模型、分享或通道後,資料也可能傳送到外部。請依實際流程檢查設定與權限。
軟體免費且採 MIT 授權,但模型及依賴元件有各自條款;電力和儲存空間也有成本。本機推論不自動保證絕對安全,模型回答仍可能不正確。
替代工具與限制
與 Ollama 或 LM Studio 等本機模型管理工具相比,Strata 更著重相容模型系列和分層記憶體推論。各產品的模型及後端支援會變動,選用前應重新確認。較小的本機模型可能更容易部署且更快;雲端 API 不需大型下載,但會傳送請求並按使用量計費。
優點包括本機 API、針對模型的最佳化及桌面/終端選擇;限制包括相容模型範圍、大型下載、受硬體影響的速度、更新頻繁,以及相對成熟工具較少的獨立驗證。
適合誰使用
如果你有相容 GPU、足夠 RAM 與 SSD,且願意調整設定,本機聊天或程式開發可以考慮 Strata。先從相容的小型套件和規劃工具開始,用自己的常見任務測試,再決定是否下載大型量化版。
本文參考截至 2026 年 10 月 27 日的官方資料、以公開資料整理的外部評測及使用者回報,並以 AI 協助撰寫。本站未安裝 Strata,也未獨立測量速度、穩定性或品質。
相關 評測
SillyTavern 入門指南 2026:建立 AI 酒館、角色卡與世界書

MiniMax M3.1 Flash 評測:程式能力、API 費用、公開權重與硬體需求
Matrix-Game 4.0 評測:單張 RTX 5090 的 AI 遊戲、部署與 NSFW 限制
Step 5 Preview 評測:價格、API、開放權重與 NSFW 限制
Krea 3 評測:圖片編輯、Ultra、真實費用、繁中文字與本機支援
NovelAI Diffusion 4.5 評測|免費 30 張、圖生圖、局部重繪與擴圖功能解析