雲端 GPU AI 工作站架設指南:生圖、影片、LLM、酒館與 NSFW 限制(2026)
租用 GPU 執行 ComfyUI、生影片、LLM 與 SillyTavern:比較費用、顯存需求、架設步驟、資料保存及 NSFW 限制。

不用先買高階顯示卡,也能用一般筆電操作 AI 生圖、影片生成、大模型對話與 AI 酒館:把運算交給租來的雲端 GPU,自己透過瀏覽器或 SillyTavern 控制。偶爾集中創作很適合這種方式,但環境安裝、儲存費、安全連線及用完後關機,都需要自己管理。
你租的是運算環境,不是全包式 AI 服務
初次架設建議一張 GPU、一份持久儲存空間,一次執行一類工作。ComfyUI 負責影像與影片工作流程,KoboldCpp 執行語言模型,SillyTavern 管理角色卡、對話與世界資訊。酒館可以留在自己的電腦上,只把模型放到雲端。
租 GPU 不等於附送模型、商用授權、成人內容許可或完整遠端桌面。它適合想自選權重與工作流程的人;若只是偶爾要幾張成品,線上生圖服務通常更省事。
| 方式 | 適用情境 | 主要代價 |
|---|---|---|
| 線上 AI 服務 | 快速取得結果 | 模型、額度與內容規範由平台決定 |
| 雲端 GPU | 客製模型與可重現流程 | 自行安裝、保存與管理連線 |
| 自己的 GPU | 高頻使用、資料留在本機 | 硬體費、電費、散熱及顯存上限 |
Runpod 與 Vast.ai 怎麼選?
Runpod 有官方 ComfyUI Pod 範本與教學,適合作為第一次架設的起點。互動操作選一般 On-Demand Pod;Serverless 端點並不是同一種常駐工作站。RTX 5090 等 Blackwell 顯卡需要對應的範本。
Vast.ai 比較適合願意逐筆比較機器條件的人。除了 GPU,也要看主機可靠性、地區、系統記憶體、硬碟、傳輸費和租用條件。可中斷執行個體適合能重跑的批次,不適合初次安裝或尚未存檔的長時間生成;沒有所有主機通用的固定時薪。
啟動前核對最後報價。便宜的 GPU 若搭配慢速硬碟、不相容 CUDA 或反覆下載模型,整體未必划算。先以小額、短時間確認環境可以完成自己的工作。
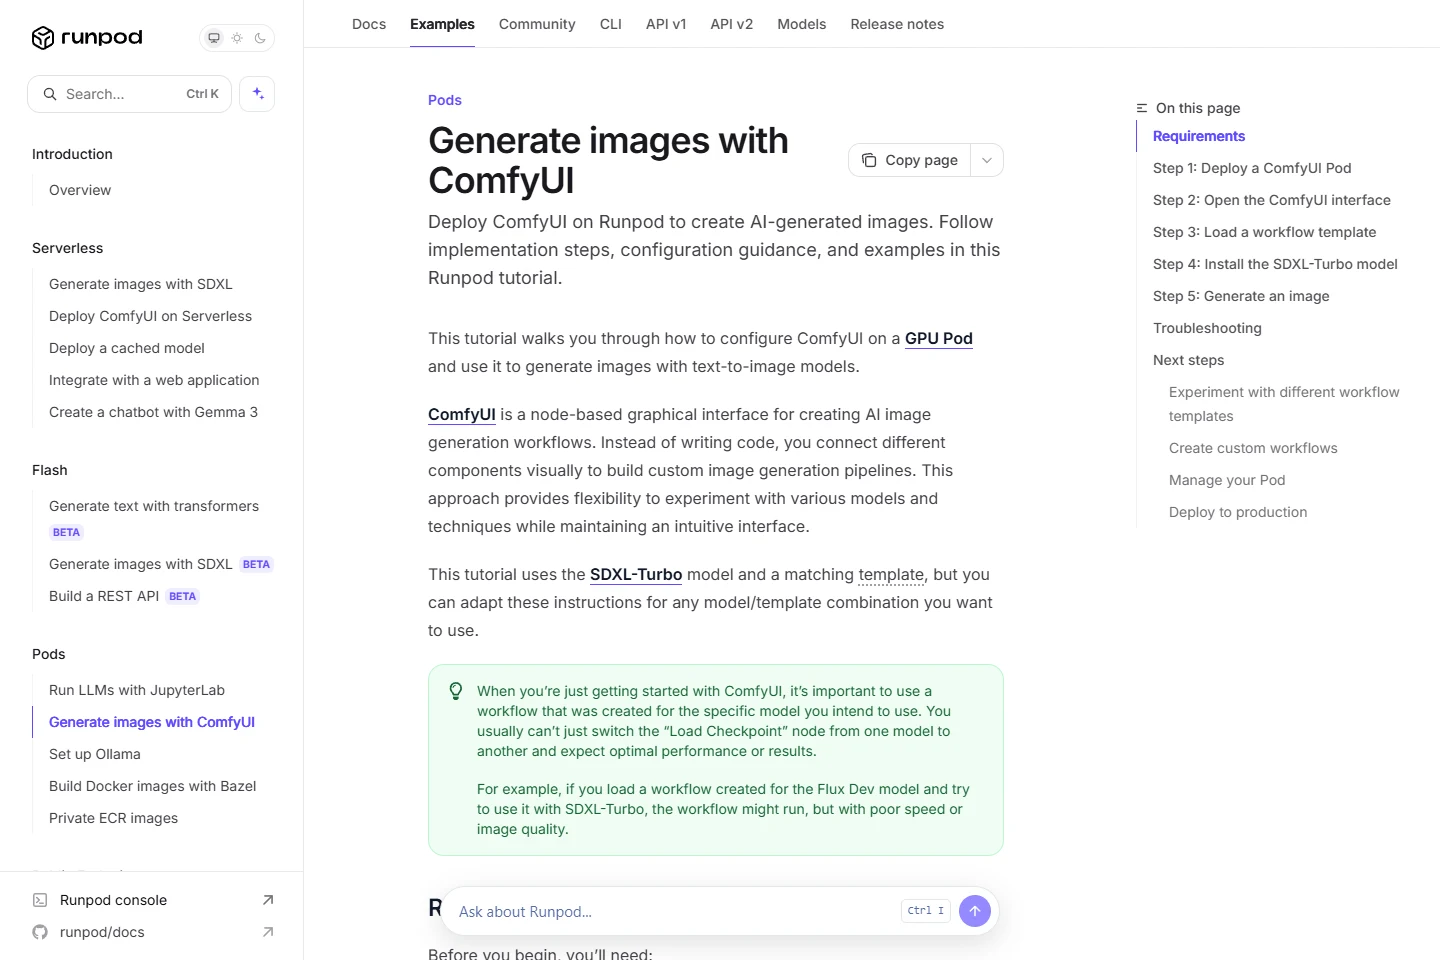
Runpod · ComfyUI · Vast.ai · Pricing
要租多少顯存與硬碟?
以下是規劃起點,不是每個模型的保證需求。量化、解析度、影片幀數、批次、上下文長度與 offload 都會改變記憶體用量。系統 RAM 不等於 VRAM;移到 CPU 運算雖可能避免錯誤,也可能明顯變慢。
混合用途可先考慮 24GB VRAM,磁碟以 100~200GB 作為少量模型、快取與輸出的初始預算,再依檔案總量調整。影片模型和 LLM 分別放得下,不代表能同時載入。
| 用途 | 初始規劃 | 注意事項 |
|---|---|---|
| 基本生圖 | 12~24GB VRAM | 編輯、ControlNet、大批次可能需要更多 |
| Wan2.2 TI2V-5B | 搭配官方 offload 設定的 24GB | 不能套用到所有影片模型 |
| 7B~14B 量化聊天模型 | 保守從 16~24GB 規劃 | 模型以外還需 KV cache |
| 大型模型或長影片 | 可能需要 48~80GB | 以實際模型配置為準 |
費用要算整段開機時間
2026 年 9 月 29 日 Runpod 的 Pods 公開標價:RTX A5000 24GB 為 US$0.27/小時,RTX 4090 24GB 為 US$0.74/小時,RTX 5090 32GB 為 US$0.99/小時。這是頁面參考價,不保證庫存或最終報價,也不是 Serverless 費率。
以方便抓預算的假設匯率 US$1=NT$32 計算,分別約 NT$8.6、NT$23.7、NT$31.7/小時。這不是即時匯率或台幣官方定價;實付仍依刷卡匯率、海外交易手續費與稅金計算。
例如 4090 執行 20 小時,加上 100GB 標準網路磁碟按 US$0.07/GB/月保存,合計 US$21.80,按上述假設約 NT$698,未含其他磁碟、稅與適用傳輸費。若開滿 720 小時,光 GPU 就是 US$532.80。安裝、下載與等待時,只要機器在運作就計費。
總預算=GPU 時數×單價+保留儲存空間+適用傳輸費+稅費。Runpod 的 volume disk 運作中為 US$0.10/GB/月、停止時 US$0.20;1TB 以下的標準 network volume 為 US$0.07。比較買顯卡時,也要把每月實際使用時數、電費與維護算進去。
Runpod · Pricing · Runpod · Storage
先建立能產生一張圖片的工作站
先確認出圖、下載和保存工作流程成功,再加入影片與 LLM。以下是架設指南,並非付費租機後量測的速度實測。
- 建立帳號與預算提醒,若要使用 SSH 通道就登錄公開金鑰。確認適合的機房地區與 GPU 庫存。
- 選 Runpod 官方 ComfyUI 範本;RTX 5090/B200 選 Blackwell Edition。部署 On-Demand 前確認 GPU、RAM、磁碟與連接埠。
- 下載模型前先掛載持久儲存空間。確認模型、workflow、output 真正寫入掛載位置;資料夾叫 /workspace 不代表一定會保留。
- 看初始化日誌再開啟 ComfyUI。HTTP proxy 要確認驗證機制,難猜的網址不是權限保護。私人工作建議走 SSH 通道,關閉不需要公開的 HTTP 埠。
- 從 Workflow → Browse Templates 或官方範例載入模型專用流程。把 checkpoint、文字編碼器和 VAE 放在遠端指定位置;瀏覽器下載有時只會存到自己的電腦。
- 用單張、預設尺寸試跑。完成後下載圖片和 workflow JSON,核對遠端保存位置,再停止 Pod。
第一張圖片的提示詞
窗邊木桌上的陶瓷茶壺,柔和晨光,簡潔中性背景,寫實商品攝影。
Runpod · ComfyUI · ComfyUI · Text to Image · Runpod · SSH
network volume 要在建立 Pod 時選擇,不能事後直接加到既有 Pod。以下 ComfyUI SSH 通道假設 SSH 伺服器能連到同一環境的 127.0.0.1:8188。替換連線資訊、保持終端機開啟,再由本機開 http://127.0.0.1:8188。ComfyUI 必須已啟動,不要在同一連接埠重複啟動第二份。
ssh -N -L 127.0.0.1:8188:127.0.0.1:8188 -p SSH_PORT -i KEY_PATH USER@POD_IP加入影片生成:模型與 workflow 必須成套
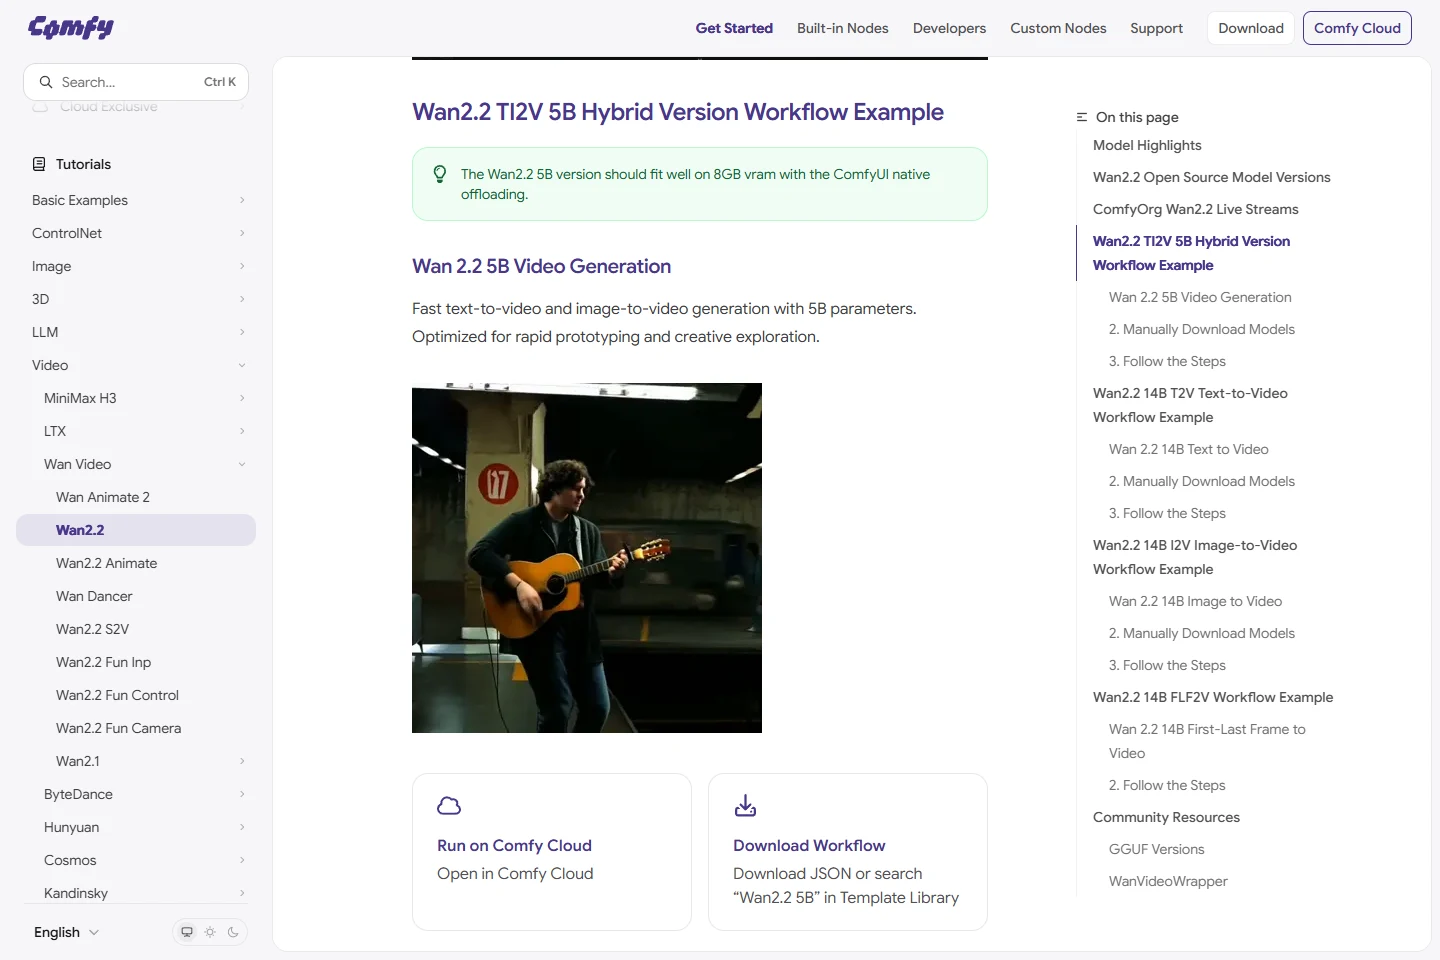
ComfyUI 官方提供 Wan2.2 工作流程和模型連結,可作為具體入門範例。Wan2.2 TI2V-5B 官方文件說明了至少 24GB VRAM、搭配模型 offload 與 CPU 文字編碼器的 720p 路線,不代表其他 14B 工作流程也能照搬。
載入 TI2V-5B 範例,把所有元件下載到指定資料夾,先維持支援的尺寸與幀數,跑一段短片。圖生影片使用你有權上傳的圖片,提示詞描述動作與鏡頭,而非只重述畫面。
保存 seed、模型檔名、流程與結果。比較速度時固定設定,區分首次下載、載入與暖機後生成。ComfyUI 的 Partner/API 節點可能另外呼叫付費雲端服務,不一定在你租的 GPU 上運算。
ComfyUI 也說明了 5B 模型透過原生 offload 在 8GB VRAM 執行的路線。它與上游 24GB 範例的設定不同;較低顯存可執行,不等於速度相同。
影片動態提示詞
鏡頭緩慢靠近茶壺,蒸氣輕輕上升,桌面與背景保持不動,日光穩定。
架設 LLM 後端,連接本機 SillyTavern
角色卡與對話留在自己的電腦,模型推論放在雲端,能降低更換 GPU 執行個體時的搬遷負擔。但遠端推論仍使用別人的設備,不等同完全本機隱私。
在相容 CUDA 的 Linux 環境下載官方 KoboldCpp Linux 執行檔及來源可信的 GGUF 模型,核對模型授權與架構支援。以下假設執行檔命名為 koboldcpp-linux-x64,模型存成 /workspace/models/model.gguf。先以 4096 上下文、自動分配 GPU 層數啟動,從日誌確認 GPU 確實參與運算。
chmod +x ./koboldcpp-linux-x64
./koboldcpp-linux-x64 --model /workspace/models/model.gguf --usecuda --gpulayers -1 --contextsize 4096 --host 127.0.0.1 --port 5001
後端只監聽自己的 loopback。回到你的電腦,使用供應商提供的完整 SSH/TCP 資訊建立下列通道。SSH_PORT、KEY_PATH、USER、POD_IP 都要替換;範例假設 SSH 與 KoboldCpp 位於同一網路命名空間。
ssh -N -L 127.0.0.1:5001:127.0.0.1:5001 -p SSH_PORT -i KEY_PATH USER@POD_IP- 保持 SSH 視窗開啟,在本機瀏覽器開 http://127.0.0.1:5001,先試一段短對話。若失敗,先修後端和通道,不要急著調酒館。
- Windows 先裝 Node.js LTS 與 Git,再依官方方式取得 SillyTavern 的 release 分支,放在可寫入資料夾,以非系統管理員權限執行 Start.bat。
- 在 API Connections 選 Text Completion → KoboldCpp,網址輸入 http://127.0.0.1:5001/,按 Connect。這個連線方式用根網址,不加 OpenAI 的 /v1。
- 建立簡單角色測試,套用適合模型的提示格式;SillyTavern 的上下文設定不要超過後端。把角色卡與對話另做備份。
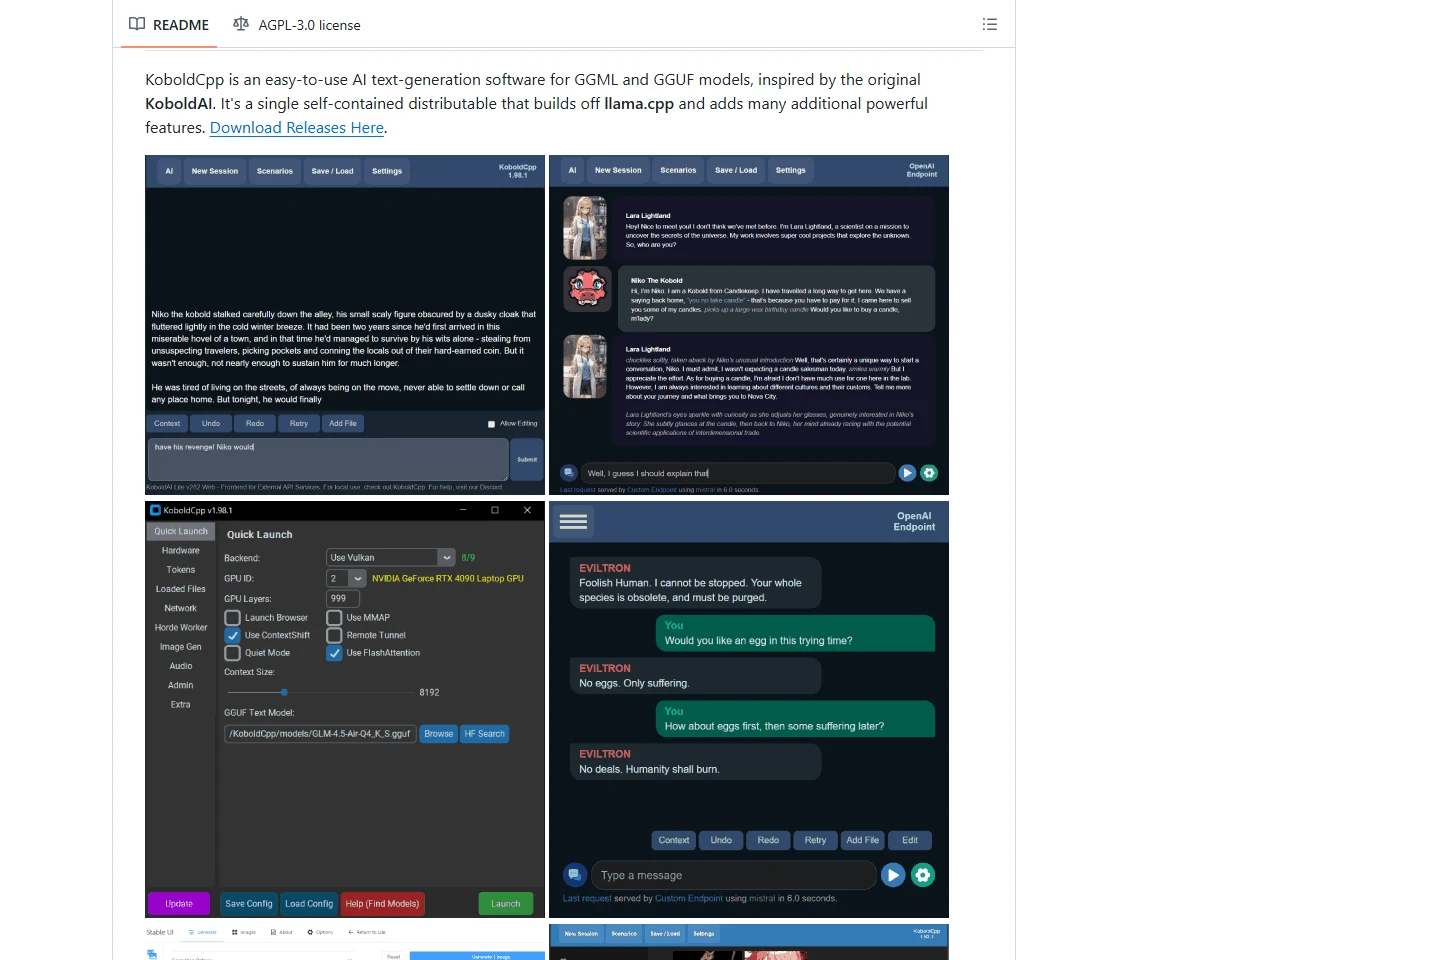
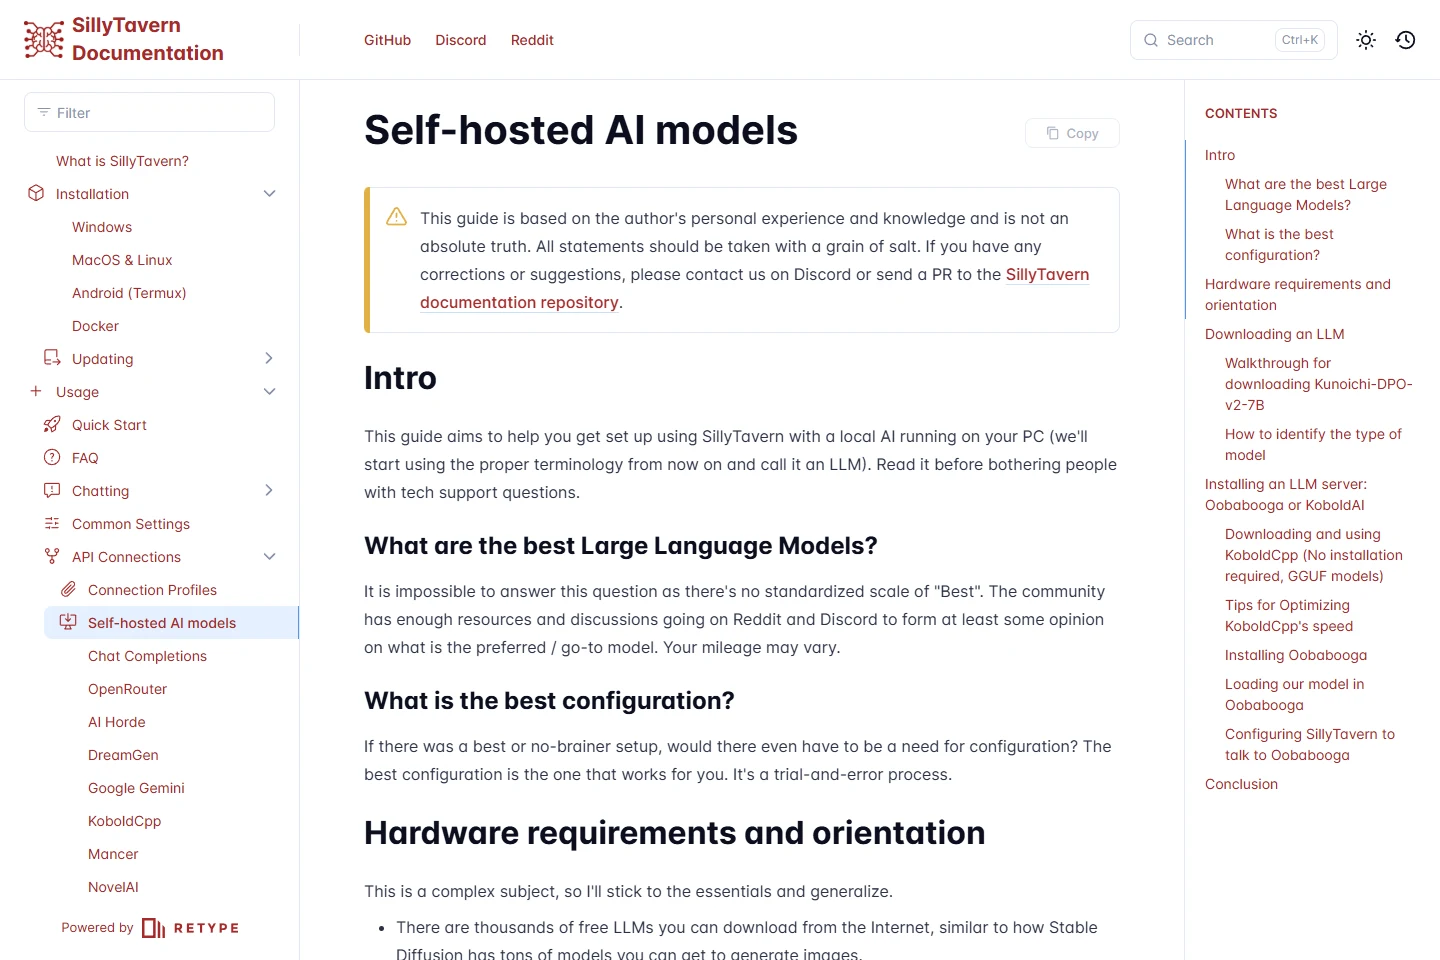
KoboldCpp · Releases · KoboldCpp · SillyTavern · Windows · SillyTavern · API · Runpod · SSH
NSFW 評價:能生成,不等於平台允許
自架能自由選模型和元件,卻沒有通用的 NSFW 開關。模型可能拒絕成人提示、表現不佳,或受授權條款限制。角色卡不會覆蓋模型、API 或 GPU 主機商的規則。
Runpod 條款限制淫穢等內容,Vast.ai 也禁止透過服務儲存或傳送淫穢內容,因此都不能推薦為「成人內容無限制」的平台。即使是合法成人用途,也應在付款前取得供應商的明確答覆。
分開確認主機條款、模型授權、外部 API 規則與公開平台規範。完全本機執行可以少掉雲端主機這一層,並不會消除其他義務。
| 問題 | 實際判斷 |
|---|---|
| ComfyUI 或酒館保證 NSFW? | 不保證,取決於模型和後端。 |
| 開放權重就是無限制? | 不是,仍要看個別授權和使用條件。 |
| 雲端 GPU 是完全私密? | 不是本機運算;保護連線,避免不必要的敏感資料上傳。 |
Runpod · Terms · Vast.ai · Terms
備份、停止與常見錯誤
整理可搬移的專案:workflow JSON、節點版本、模型檔名與授權、seed、提示詞、角色卡及重要結果。分享流程時不要夾帶 API 金鑰,刪除機器前先下載備份。
Stop 和 Terminate 不同。Runpod container disk 在停止時可能遺失內容;volume disk 可跨停止保存,但刪除 Pod 時移除;network volume 有自己的生命週期與帳單。停止 GPU 後另外確認保留的磁碟;重新啟動也不保證原 GPU 還有空位。
| 狀況 | 先做什麼 |
|---|---|
| 顯存不足 | 卸載其他模型,降低批次、上下文或幀數 |
| 缺模型或節點 | 確認流程版本與元件路徑,不要亂裝節點包 |
| 酒館無法連線 | 依序測後端、SSH 通道、前端網址 |
| 速度很慢 | 檢查 GPU 使用率、CPU offload、初次載入與硬碟 |
| 費用繼續增加 | 關閉瀏覽器不是關機;分別查 GPU 與保存磁碟 |
常見問題與建議
本機需要高階顯卡嗎?
這種遠端後端架構不需要。但仍需穩定網路、能執行前端的電腦與備份空間,影片的下載速度也會影響體驗。
一張 GPU 可以做全部用途嗎?
可以輪流使用各自放得下的模型。同時載入是另一回事,切換任務時先釋放不需要的模型。
兩張 24GB 等於一張 48GB 嗎?
不會自動合併。軟體須支援模型拆分,且有通訊成本;初次架設用一張足夠大的 GPU 比較簡單。
手機能用嗎?
可以操作受保護的網頁介面,但本篇 localhost 通道屬於執行它的電腦。手機需另設安全連線,不要為了方便公開無驗證服務。
生成作品可以商用嗎?
看模型授權、素材權利、主機條款與用途。付 GPU 租金不代表取得每個模型的商用授權。
比訂閱便宜嗎?
集中、偶爾使用可能划算,仍要計入安裝、閒置與儲存費。不想維護環境的人,線上服務可能更合適。
初次使用,先以 24GB 等級跑通一套生圖流程,確認停止、重啟後資料仍在,再計算每個可用結果的成本。基礎穩定後才加影片,比一次堆滿所有工具容易排錯。
酒館則從本機前端加上受保護的遠端後端開始,角色卡與對話自行備份。硬體按實際需要升級;NSFW 許可與模型技術能力要分開決定。
相關 評測
Krea 3 評測:圖片編輯、Ultra、真實費用、繁中文字與本機支援

2026 年 5 款最佳線上白板推薦|免費、多人協作工具比較
2026 年 6 款最佳免費 QR Code 產生器推薦

HiDream O1 評測:圖片生成AI、LoRA、本機部署與 NSFW 對應
Seedance 2.5 評測:AI 影片生成模型的功能、使用體驗與限制
2026 年 10 大 AI 聊天機器人推薦