Test de MOSS-Image : texte, composition, NSFW, VRAM et ComfyUI
MOSS-Image Base et SFT : texte, anime, composition JSON, VRAM, vitesse, ComfyUI, quantification, LoRA, NSFW, licence et limites de la retouche.

MOSS-Image est particulièrement intéressant pour les affiches, les fiches illustrées et les scènes qui exigent du texte et une composition explicite. Son intérêt tient aux prompts longs, au rendu des lettres et au contrôle par JSON, plutôt qu’à une promesse de surpasser tous les modèles spécialisés dans l’anime.
Base et SFT sont disponibles depuis le 16 octobre 2026. SFT constitue un point de départ logique pour les créations riches en texte ; Base mérite une comparaison pour explorer un style ou entraîner un adaptateur. Il faut toutefois prévoir un gros encodeur, un flux standard à 50 étapes et une vérification des détails. Le modèle publié ne retouche pas directement une photo de référence.
Verdict et caractéristiques
| Équipe et sortie | OpenMOSS · 16 octobre 2026 |
|---|---|
| Composants | DiT 5B + encodeur Qwen3.5-9B + VAE FLUX.2 à petit décodeur |
| Entrées | Langage naturel, tags et JSON · jusqu’à 4 096 tokens |
| Point de départ | 1024×1024 ; 1–2 MP conseillés ; dimensions multiples de 16 |
| Échantillonnage | Euler · 50 étapes · CFG 3 · shift 5 · uncond skip 22 |
| Poids et accès | Apache-2.0 · exécution locale et démonstration officielle |
Les raisons de l’essayer
- Placement explicite des objets et des mots par des cadres.
- Photographie, illustration et anime avec descriptions ou tags.
- Poids Base/SFT téléchargeables et adaptations communautaires.
Les raisons de garder d’autres modèles
- Les 5B excluent le gros encodeur de texte.
- Personnages précis, noms d’artistes et détails fins restent variables.
- Pas de retouche native par image ; accélérateurs à configurer séparément.
Base ou SFT : quelle version choisir ?
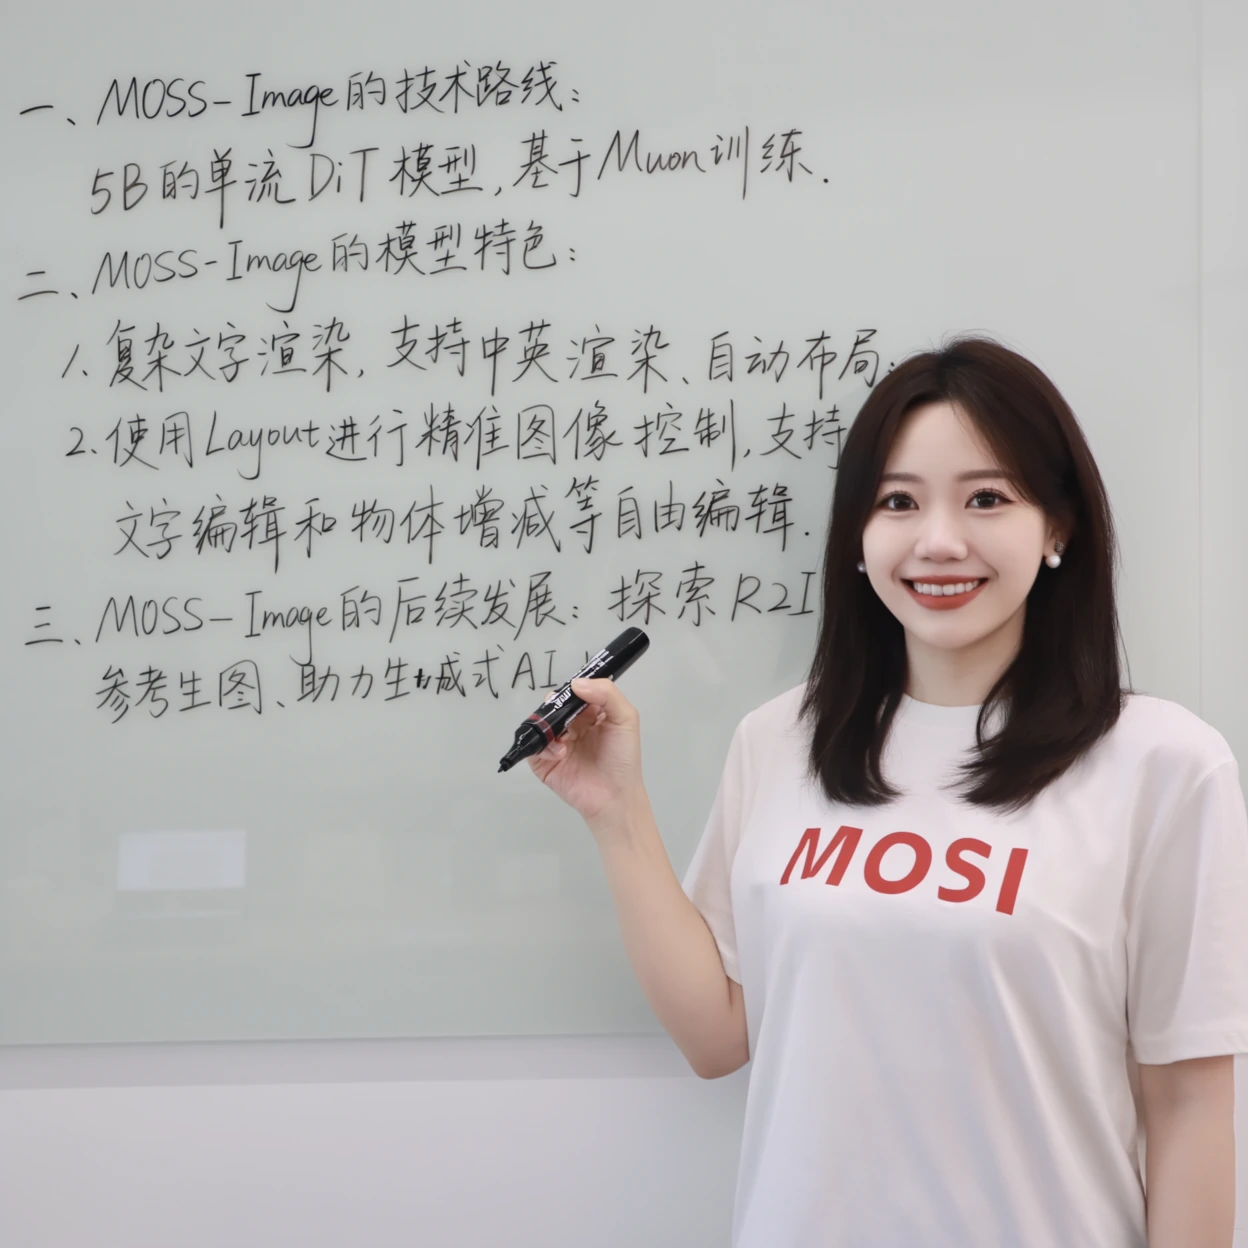
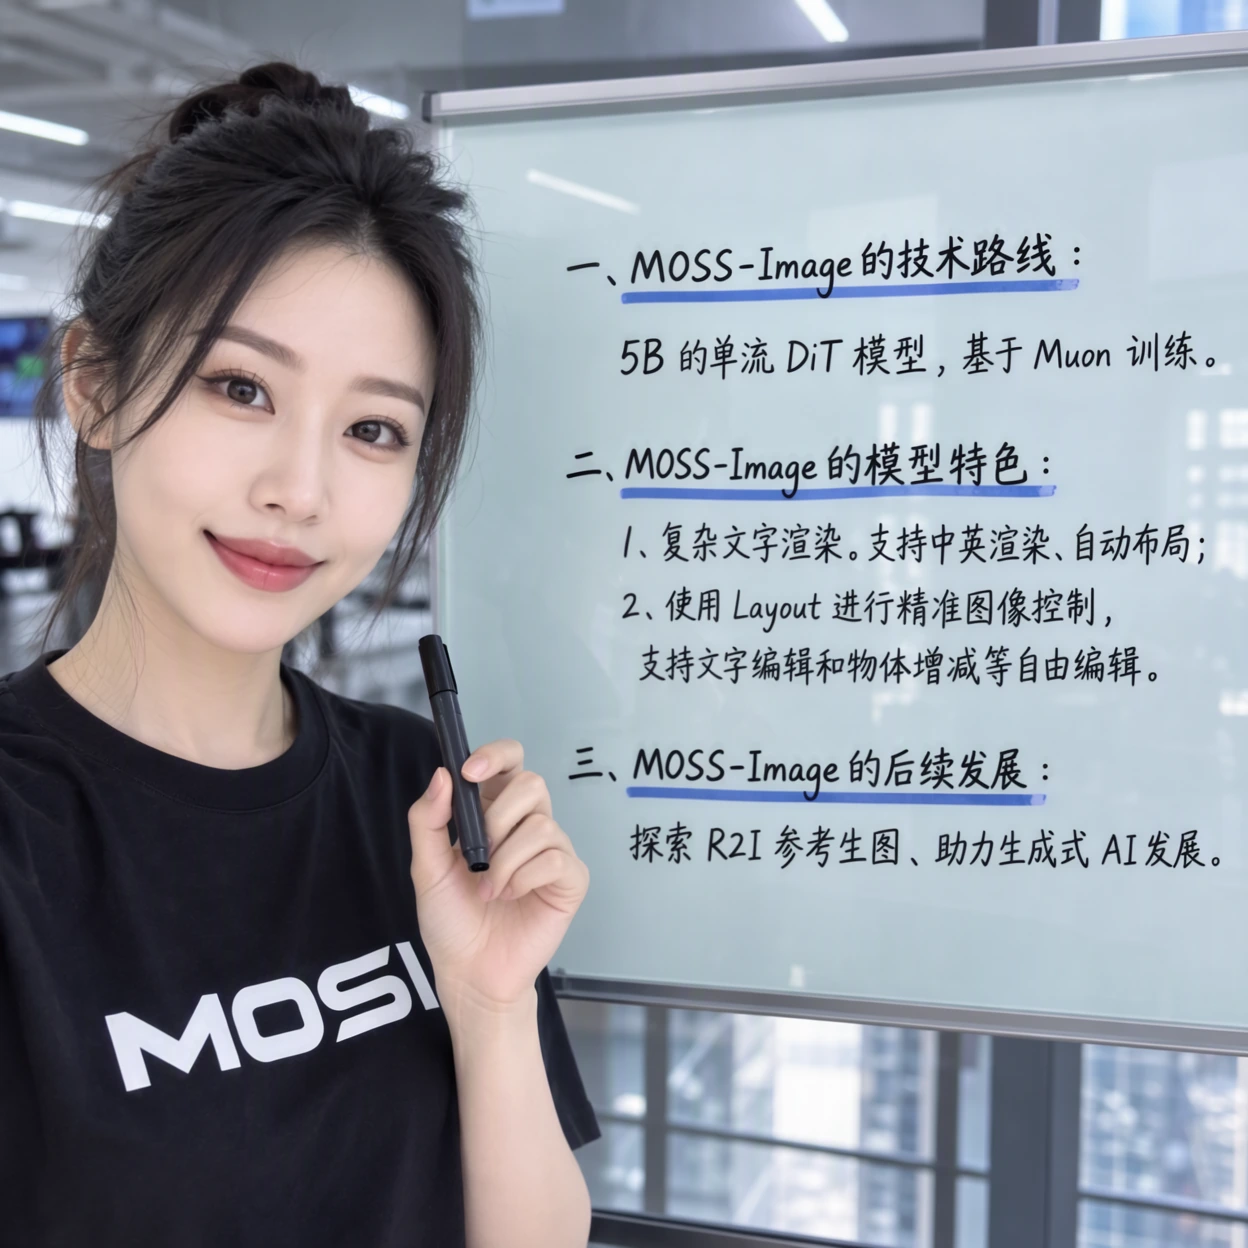
SFT affine Base sur des données sélectionnées. Les exemples officiels de tableau montrent des blocs de texte mieux organisés : c’est une entrée raisonnable pour affiches et diagrammes, sans démontrer une supériorité dans tous les styles. Fiche SFT
Base conserve une distribution moins affinée et sert de point de départ recommandé pour l’adaptation. Un développeur préfère personnellement son rendu réaliste. « Plus libre » ne garantit ni qualité ni politique de contenu. Les deux images ci-dessous sont des exemples choisis par l’équipe : personne et composition diffèrent, donc ce n’est pas un test d’identité constante. Fiche Base
Qualité, anime et texte multilingue
Le rapport annonce un score Mean-6 de couverture textuelle de 96,3 sur LongLongTextBench, soit 240 tâches en anglais et en chinois. Ce résultat vient du développeur : il ne garantit ni orthographe parfaite ni qualité typographique, et ne mesure pas le français. Le deuxième rang du système sur RealLayoutArena et le premier du générateur avec prompts enrichis partagés relèvent de protocoles différents. Rapport et méthode
Les retours sur le japonais et les accents sont encourageants, sans prouver une fiabilité générale. En français, testez réellement accents, cédilles, apostrophes et retours à la ligne. La documentation privilégie l’anglais pour décrire la scène ; vous pouvez conserver le titre français exact entre guillemets. Essai communautaire documenté
Les tags de type Danbooru ne prouvent pas une connaissance exhaustive des personnages ou artistes. Des utilisateurs du fil AMA signalent une faible réponse aux noms d’artistes ; un essai japonais constate des écarts selon la formulation du style. Vérifiez mains, petits visages, négations et attributs de plusieurs sujets. Un bon décor ne suffit pas à déclarer Anima dépassé. Discussion AMA Essai japonais
Un aspect « proche de GPT » reste une impression esthétique, pas une preuve de données synthétiques. Le rapport décrit déduplication et détecteur interne, réduisant environ cinq milliards d’images à trois milliards. Ce n’est ni un audit indépendant ni une certification des droits de tout le corpus. Préparation des données
Composition par JSON et boîtes englobantes
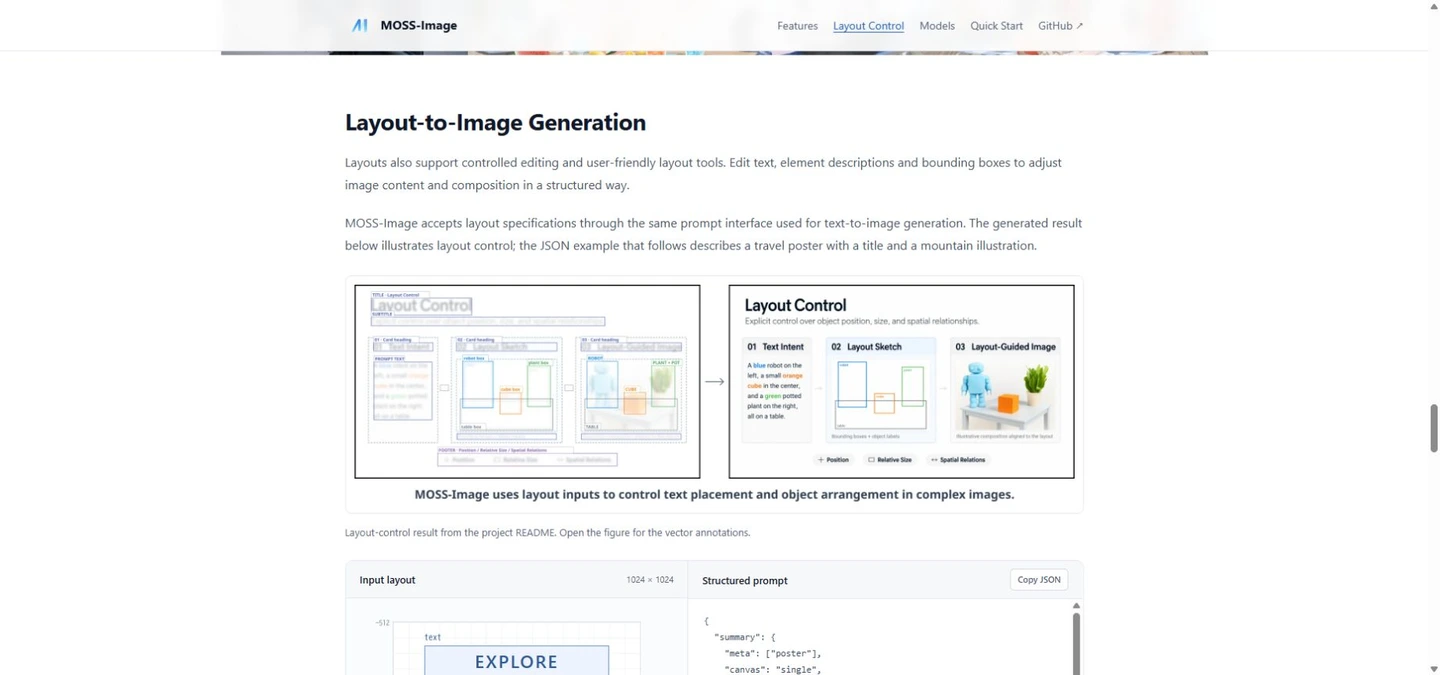
Le JSON décrit la scène puis affecte une description et une boîte à chaque élément. Il permet de réserver un titre, séparer deux personnages ou organiser des panneaux. Ce format reste facultatif : une description naturelle suffit pour les scènes simples. Guide officiel
Avec abs_centralized et yxyx, l’ordre est [y_min, x_min, y_max, x_max], en pixels depuis le centre. Sur 1024×1024, chaque axe va de −512 à +512. Ne mélangez pas ce schéma avec une origine en haut à gauche ou une échelle communautaire 0–1000.
L’exemple original ci-dessous place un titre au-dessus d’une montagne. Collez tout le JSON dans le prompt positif et réglez 1024×1024. Les cadres orientent la génération ; ils ne créent pas des calques vectoriels ni une position garantie au pixel. Modifier le JSON puis régénérer ne conserve pas une photo importée : le modèle publié n’est pas un éditeur conditionné par image.
{
  "summary": {
    "meta": [
      "poster"
    ],
    "canvas": "single",
    "caption": "A minimalist travel poster with a cream background, a blue mountain illustration below, and the exact title Été à Lyon at the top."
  },
  "items": [
    {
      "label": "text",
      "caption": "Large dark-blue title centered at the top.",
      "text": "Été à Lyon",
      "bbox": [
        -416,
        -384,
        -288,
        384
      ]
    },
    {
      "label": "object",
      "caption": "A flat blue mountain illustration in the lower center.",
      "bbox": [
        -192,
        -288,
        384,
        288
      ]
    }
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
VRAM, téléchargements et vitesse
Poids téléchargés et pic de VRAM sont distincts. Au 20 octobre, les fichiers Comfy-Org indiquent environ 10,16 Go pour le DiT BF16, 19,31 Go pour l’encodeur et 0,25 Go pour le petit VAE : 29,72 Go de poids, hors environnement et cache. Le déchargement vers le CPU évite de tout garder simultanément sur le GPU. Fichiers actuels
Sur 8–12 Go, commencez avec une quantification compatible, du déchargement CPU et une seule image d’environ 1 MP. Une carte de 16 Go ne garantit pas le confort ; même 32 Go peuvent être justes pour tout BF16 résident et la mémoire de travail. RAM, longueur du prompt et décodage comptent aussi.
Un utilisateur de RTX 3060 12 Go rapporte un pic de 9,7 Go, 137 s à 1 MP/50 étapes et environ 24 s avec un premier DMD. Il utilisait une quantification tierce dont l’auteur a ensuite conseillé Comfy-Org. Ce sont les chiffres de cet ancien montage, pas des mesures AirMore ni des garanties pour les fichiers actuels. Configuration et résultats
| Composant | Fichier BF16 | INT8 ou autre option |
|---|---|---|
| DiT | 10,16 Go | 5,41 Go · INT8 ConvRot |
| Qwen3.5-9B | 19,31 Go | 9,75 Go · INT8 ; 7,34 Go · W4A8 GPTQ |
| Petit VAE | 0,25 Go | Composant séparé |
Go décimaux approximatifs sur disque, pas une VRAM minimale. W4A8 désigne ici l’encodeur, pas toute la chaîne.
Bien démarrer dans ComfyUI
Mettez à jour ComfyUI, son interface et ses modèles de workflows. Cherchez MOSS-Image et associez le flux Base/SFT aux fichiers Comfy-Org correspondants. La prise en charge native a été fusionnée le 16 octobre, même si certains anciens textes parlent encore d’intégration en cours. Fusion dans ComfyUI
Le module OpenMOSS constitue une autre route : son HF Loader attend un dossier Diffusers local contenant transformer/, text_encoder/, tokenizer/ et vae/. Un identifiant Hub ou un DiT isolé n’est pas ce dossier. Évitez les assemblages de graphes et chargeurs incompatibles. Instructions du module
Partez de 1024×1024, 50 étapes, CFG 3, shift 5, Euler/sgm_uniform et saut négatif 22 si le flux l’expose. Ne superposez pas un SLG standard sans raison. En cas de bruit ou taches, vérifiez d’abord le petit VAE recommandé et le workflow intact, avant les accélérateurs.
Emplacement des fichiers pour la route native ; une précision compatible de chaque composant suffit.
ComfyUI/models/
  diffusion_models/
    moss_image_sft_bf16.safetensors
    # OR moss_image_sft_int8_convrot.safetensors
  text_encoders/
    qwen3.5_9b_bf16.safetensors
    # OR qwen3.5_9b_int8_convrot.safetensors
  vae/
    flux2-vae_small.safetensors
Rédiger des prompts plus précis
Précisez sujet, action, perspective, relations, lumière, style et mots visibles. Inutile de remplir 4 096 tokens : résolvez d’abord les contradictions.
L’ordre conseillé des tags est Quality→Score→Meta→Year→Character→Series→Artist→General. « 8K » ne modifie pas les pixels configurés et un nom d’artiste n’est pas un sélecteur garanti. Décrivez aussi l’apparence d’un personnage important. Conseils de prompt
Pour une affiche française, essayez une scène décrite en anglais avec le titre français exact entre guillemets. Gardez la graine pendant les modifications, puis testez plusieurs graines. Relisez les accents dans l’image exportée plutôt que de juger seulement son allure.
Prompt original à adapter
A clean editorial summer market illustration. Two adult vendors stand at separate stalls: a woman in a red apron on the left holding one yellow lemon, a man in a blue apron on the right holding one green pear. Warm morning light, restrained colours. A clear title area reads exactly "Été à Lyon", preserving both accents. No additional words.
Quantification, GGUF, LoRA et accélération
Comfy-Org propose INT8 ConvRot ; la communauté fournit GGUF et d’autres précisions. GGUF, GPTQ et BF16 ne sont pas interchangeables. Suivez chargeur, encodeur et VAE de la fiche concernée, puis comparez petits caractères et textures. Fiche GGUF communautaire
Le DMD huit étapes est un projet communautaire en cours, pas un Turbo officiel. Sa fiche actuelle décrit un chargement LoRA et marque comme obsolète une ancienne section de sampler spécial/FP32. Ne recopiez pas cette ancienne recette et ne réduisez pas simplement un sampler standard à huit étapes. Spectrum et les variantes quatre étapes demandent aussi leur propre comparaison. Instructions à jour
Pour entraîner, le guide recommande Base et un encodeur de texte gelé. Préservez les mots visibles dans les légendes. Les LoRA Anima, SDXL ou FLUX ne fonctionnent pas automatiquement : architecture, clés et workflow doivent correspondre.
NSFW, licence commerciale et coût
Des utilisateurs rapportent une génération adulte/NSFW locale. Cela ne décrit pas les règles de chaque hébergeur ou enrichisseur de prompts. La capacité ne garantit ni anatomie correcte ni droits sur une identité. Pour le SFW, consultez les tags négatifs officiels et contrôlez les images. Discussion Conseils officiels
Poids et code indépendant de la chaîne sont sous Apache-2.0, permettant un usage commercial du modèle selon ses conditions. Composants et adaptateurs gardent leurs propres licences. Cela ne libère pas automatiquement personnages, marques ou portraits pour une campagne. Licence
Il n’existe pas de prix officiel unique par image locale : comptez GPU, stockage, énergie et essais rejetés. La démonstration ne promet pas une capacité gratuite permanente ; les hébergeurs fixent leurs tarifs. Identifiez les téléchargements depuis le projet OpenMOSS plutôt qu’un site au nom similaire.
Face à Anima, Krea, Qwen et FLUX
Une comparaison communautaire utilise MOSS à 50 étapes sur H100 et Krea à quatre étapes sur Mac : elle ne classe pas la vitesse. Rien ne démontre non plus l’abandon d’Anima. Choisissez selon la tâche. Conditions du comparatif
| Alternative | Pourquoi la garder | Place de MOSS |
|---|---|---|
| Anima | Spécialiste anime 2B, Turbo officiel et limite reconnue pour le texte long. Fiche | MOSS pour composition et texte ; Anima pour une palette et des ressources déjà réglées. Notre analyse d’Anima |
| Krea 2 | RAW/Turbo privilégient l’exploration esthétique. Annonce | Séparez préférence de style et respect des consignes. |
| Qwen-Image-2.1 | Génération, retouche et transparence natives. Dépôt | Plus pertinent pour préserver une image d’entrée. Notre analyse de Qwen |
| FLUX 3 Image Klein | Génération, retouche et références multiples, avec autre licence. Annonce | MOSS offre une autre voie de composition ; une préférence NSFW n’est pas un classement général. Notre analyse de FLUX |
La version anime reste un projet
Dans l’AMA, le développeur donne la priorité à une version anime et indique que ce domaine représentait une faible part des données. C’est une orientation, sans date de sortie ni nouveaux poids téléchargeables dans cette réponse. AMA
Évaluez la version disponible. N’achetez pas du matériel en supposant que spécialisation anime, éditeur par référence ou Turbo officiel sont déjà prêts. Chaque nouveauté demandera une évaluation distincte.
Questions avant le téléchargement
Est-il gratuit pour un usage commercial ?
Les poids sont Apache-2.0, mais l’exécution a un coût. Hébergement, composants et LoRA peuvent ajouter des conditions. Gardez licence et révision du modèle avec le projet.
Base ou SFT pour débuter ?
SFT pour texte et organisation ; Base pour un autre style ou l’adaptation. Comparez le même prompt sur plusieurs graines plutôt qu’une seule image choisie.
Peut-il fonctionner avec 12 Go ?
Un utilisateur le documente avec quantification et déchargement. Cela ne signifie ni BF16 complet ni toute résolution. Commencez à 1 MP et surveillez aussi la RAM.
Le français est-il toujours bien écrit ?
Non. Testez accents, cédilles, apostrophes et retours à la ligne. Le benchmark long couvre anglais/chinois ; conservez une étape de mise en page pour les mots qui doivent être exacts.
Peut-il retoucher une photo en gardant l’identité ?
Le modèle publié ne conditionne pas directement sur une référence. Graine identique et JSON ne garantissent pas conservation de photo ou de personnage. Utilisez un modèle de retouche pour cette exigence.
Pourquoi huit étapes peuvent-elles dégrader le résultat ?
Vérifiez checkpoint, précision et échantillonnage. Gardez une référence de 50 étapes et suivez la fiche actuelle ; l’accélération peut perdre éclairage, détails ou fidélité du texte.
À qui conseiller MOSS-Image ?
MOSS-Image mérite un essai pour produire localement des visuels riches en texte avec une composition explicite. SFT est une entrée pour les affiches ; Base garde de l’intérêt pour l’adaptation. Aucun ne remplace automatiquement tous les spécialistes.
Testez un titre accentué, deux personnages, une composition fixe et de petits détails. Notez encodeur, VAE, précision, graine et durée complète. La répétabilité compte davantage qu’une image de lancement flatteuse.
Périmètre et sources
Analyse du lancement à partir des fichiers, exemples officiels, documents et essais communautaires paramétrés, vérifiés jusqu’au 20 octobre 2026. Il ne s’agit pas d’un benchmark GPU réalisé par AirMore ; images et durées sont attribuées à leurs auteurs.
Documents pour vérifier les fonctions et résultats
Connexes Évaluations
Test de Qwen Image : 3.0 vs 2.0, LoRA/GGUF et NSFW

Les 5 meilleurs outils d'édition d'images par IA en 2026
Avis sur GPT-6 Astra : prix, API, usages et limites

GPT-Image-2.5 : avis 2026, Flare, Sunburst, tarifs et limites NSFW
HunyuanVideo 1.5 : avis sur la qualité, VRAM, ComfyUI, prix et limites
Avis GLM-5.3-Flash : Ox-Alpha, API, benchmarks et limites NSFW