MiniMax M3.1 Flash : avis, code, prix API, poids et limites
Notre analyse de MiniMax M3.1 Flash : MoE 428B/23B, code et agents, tarifs API, raisonnement, GPU, licence commerciale et fiabilité des réponses.

Mis à jour le 23 octobre 2026
MiniMax M3.1 Flash mérite un essai si vous multipliez les tâches de programmation et les appels d’outils tout en surveillant leur coût. Son API peu chère, son contexte d’un million de tokens et ses poids téléchargeables sont attractifs. Le raisonnement obligatoire, une tendance à répondre avec trop d’assurance et une infrastructure locale importante constituent les principaux compromis.
Notre avis : un candidat pour le développement et l’automatisation avec validation humaine. Comparez les livrables acceptés, les reprises et la dépense totale. Les 23B paramètres actifs ou le trafic de Space Bunny ne suffisent pas à prédire la réussite sur votre projet.
Ce que propose réellement M3.1 Flash
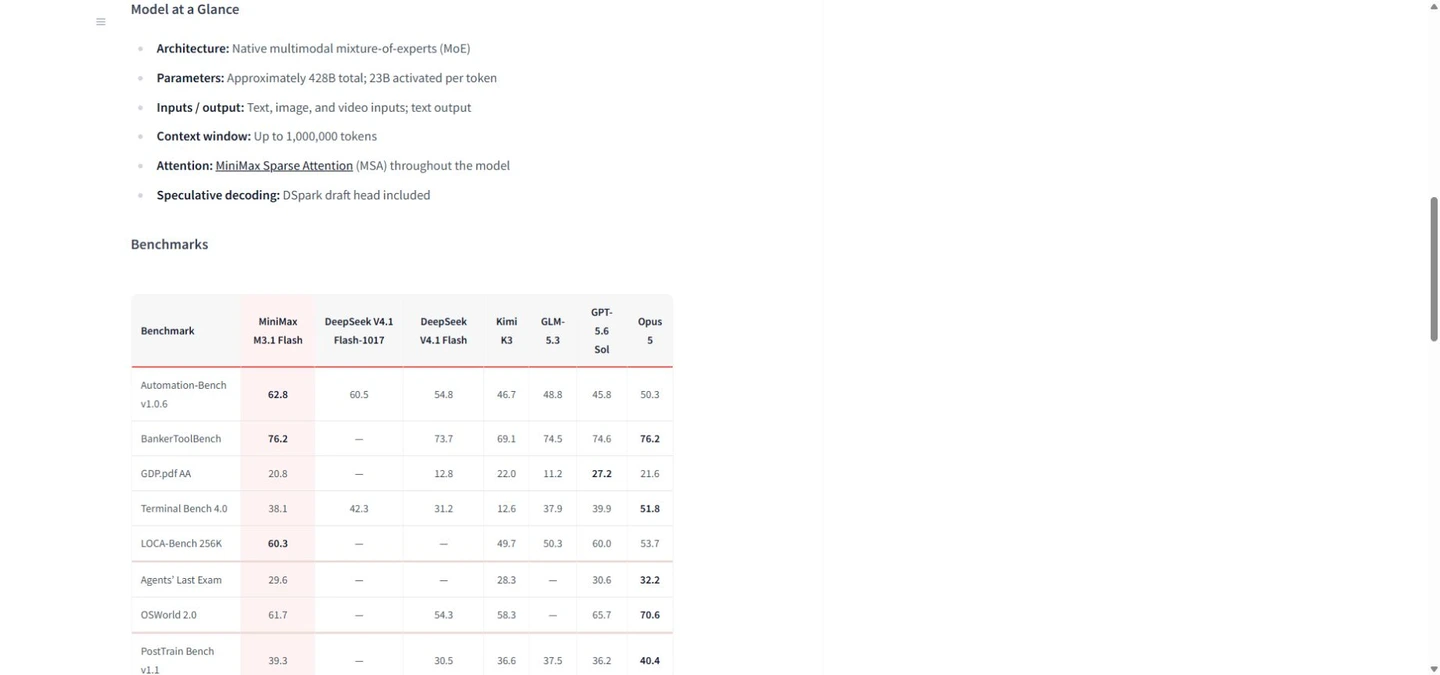
Le service hébergé a été lancé le 19 octobre et les poids ont été publiés le 23 octobre. La MiniMax M3.1 Flash — Hugging Face décrit un MoE multimodal natif d’environ 428 milliards de paramètres, dont 23 milliards activés par token. Il accepte texte, images et vidéo et produit du texte. Il ne s’agit ni de MiniMax H3, ni d’un générateur natif d’images, de vidéos ou de voix.
L’architecture reste celle de la famille M3, avec une attention clairsemée dans toutes les couches, un entraînement tenant compte de la quantification et une tête de brouillon DSpark pour le décodage spéculatif. Moins d’experts actifs réduit le calcul, mais ne supprime pas les autres poids. Les besoins mémoire ne correspondent donc pas à ceux d’un petit modèle de 23B.
| Spécification | Version actuelle |
|---|---|
| Architecture | 428B au total / 23B actifs par token ; MoE |
| Contexte / sortie maximale | Hébergé : 1 000 000 / 524 288 tokens ; selon les budgets |
| Entrée → sortie | Texte, images, vidéo → texte |
| Raisonnement | Toujours actif ; low / medium / high / xhigh / max |
| Poids / licence | Téléchargeables ; MiniMax Community License |
Poids ouverts et licence commerciale
Le téléchargement officiel est disponible. La MiniMax Community License est une MiniMax Community License, et non MIT ou Apache. L’utilisation commerciale impose la mention “Built with MiniMax M3.1-Flash”. Les produits ou services générant plus de 20 millions de dollars américains de chiffre d’affaires annuel nécessitent une autorisation écrite préalable ; en dessous du seuil, la notification unique prévue est requise.
La licence contient aussi des usages interdits et encadre les usages non commerciaux. Sa définition commerciale inclut les API et les modèles modifiés. Parlez de poids ouverts sous conditions, plutôt que d’open source sans restrictions. Les conditions d’une API hébergée ou d’un abonnement restent distinctes de la licence des poids.
72 heures et 106 000 milliards de tokens : ne pas confondre
L’annonce originale d’OpenCode distingue 12 jours consécutifs en tête et 106 000 milliards de tokens servis, puis trois jours gratuits pour M3.1 Flash. OpenRouter annonce dix jours en tête, 56 700 milliards de tokens et ensuite une promotion de 72 heures. Les plateformes et périodes diffèrent.
MiniMax — M3.1 Flash attribue plus de 200 000 milliards de tokens à la période anonyme d’une version préliminaire. Cela ne prouve pas que le modèle final ait traité 100 000 milliards en 72 heures. Le volume peut inclure entrées, sorties, contexte répété et utilisateurs simultanés. Il indique l’adoption, pas la vitesse d’une requête ni une qualité indépendante. Vérifiez la durée et les quotas de l’offre choisie.
Benchmarks : automatisation solide, code plus contrasté
La fiche du 23 octobre indique 62,8 sur Automation-Bench v1.0.6, 73,7 sur DeepSWE v1.1 et 38,1 sur Terminal Bench 4.0. Certaines publications initiales citaient 62,2 pour Automation-Bench. Notre tableau utilise la fiche actuelle et identifie ces chiffres comme des résultats du fabricant, pas comme nos propres mesures.
MiniMax mène la ligne d’automatisation sélectionnée, mais DeepSeek V4.1 Flash-1017 le dépasse sur DeepSWE, Terminal Bench et NL2Repo ; Opus 5 conserve un avantage plus important sur Terminal Bench. DeepSWE utilise mini-SWE-agent 2.4.5 et un contexte de 512K, Terminal Bench Codex 0.149.1. Versions, outils et budgets peuvent changer le classement.
| Évaluation (fabricant) | M3.1 Flash | DeepSeek V4.1 Flash-1017 | Opus 5 |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 | 50.3 |
| DeepSWE v1.1 | 73.7 | 77.0 | 74.0 |
| Terminal Bench 4.0 | 38.1 | 42.3 | 51.8 |
| NL2Repo-Bench | 61.2 | 68.2 | 75.3 |
| BankerToolBench | 76.2 | — | 76.2 |
| CyberGym | 82.2 | — | — |
| BabyVision (with tools) | 91.0 | 92.5 | 94.1 |
Comparaison de la fiche officielle actuelle. Un tiret indique un résultat non publié, pas zéro ; BabyVision utilise des outils.
MiniMax annonce plus de 200 tokens/s en sortie et une médiane supérieure à 170 ; Artificial Analysis affichait 92,5 lors de la consultation. Les conditions de service diffèrent : ce n’est pas une comparaison contrôlée. Le débit de sortie ne couvre pas toute l’attente liée aux entrées, au raisonnement, aux outils et aux reprises. Mesurez le délai jusqu’au résultat utile avec votre contexte et votre concurrence.
Code et agents : les tâches pertinentes
Reproduire un bug depuis des journaux, réaliser une fonction bien délimitée, rapprocher un tableur de documents sources et synchroniser des informations entre outils sont de bons essais. MiniMax Code — M3.1 Flash montre notamment le diagnostic d’une interface de support lente. Ce sont des cas documentés par le fournisseur, sans garantie de reproduire le même gain dans toute application.
Fournissez dépôt, reproduction, tests en échec et contraintes sur les données. Demandez un diagnostic étayé, une modification ciblée et la sortie réelle des tests. Un programme hôte doit exécuter les outils : le modèle n’accède pas seul à votre ordinateur ou aux applications de l’entreprise. Restreignez les droits d’écriture et contrôlez les actions externes.
Images, vidéo et contexte long
Une capture d’écran peut documenter un défaut visuel ; une vidéo décrit une suite d’interactions. La sortie reste textuelle. Graphiques, présentations et scènes Three.js reposent sur du code et des outils, pas sur une génération native de médias. Les spécifications de ces poids n’annoncent pas d’entrée ou de sortie audio.
Le guide hébergé prévoit jusqu’à 1 000 000 de tokens de contexte ; la référence API autorise jusqu’à 524 288 tokens générés, sous réserve du budget de la requête et du contexte. Ce plafond n’est pas un réglage universel. Fichiers, images, historique et raisonnement consomment des ressources. Commencez par les documents pertinents et exigez des références localisables ; une grande fenêtre ne garantit pas une lecture parfaite. Les documents examinés ne précisent pas clairement la date de coupure des connaissances.
Raisonnement et intégration API
MiniMax API propose low, medium, high, xhigh et max ; max est la valeur par défaut et le raisonnement ne peut pas être désactivé. Utilisez output_config.effort en protocole compatible Anthropic, reasoning_effort en OpenAI Chat Completions et reasoning.effort en Responses. Un client qui supprime les champs inconnus peut modifier la configuration ; none et disabled ne sont pas pris en charge.
MiniMax Tool Use demande de conserver le message complet de l’assistant et les identifiants d’appels d’outils pour la suite. Séparez reasoning_content du texte final et gérez son éventuelle absence. Un JSON apparent nécessite parsing et validation de schéma ; response_format ne garantit pas un schéma strict. Comparez medium pour les tâches courantes et high/max pour les échecs difficiles, avec des plafonds de sortie, d’essais et de tours.
Prix de l’API et coût d’un résultat accepté
Les tarifs officiels par million de tokens sont de 0,15 USD en entrée non mise en cache, 0,60 USD en sortie et 0,015 USD en entrée depuis le cache. Un million en entrée et 100 000 en sortie coûtent 0,21 USD ; si toute l’entrée est éligible au cache, 0,075 USD. Outils, hébergement, taxes et reprises sont exclus. Le cache n’est pas automatique et ces montants ne sont pas des tarifs fixes en euros.
Comptez le raisonnement facturable et divisez les dépenses par les livrables validés. Dix appels bon marché peuvent coûter davantage qu’une réponse correcte au premier essai. Le gain de 70% annoncé porte sur des tâches dans certaines conditions, pas sur tous les tokens. M Plan, MiniMax Code et les offres gratuites de tiers ont leurs propres quotas et dates.
| Catégorie de tokens | USD par million |
|---|---|
| Entrée hors cache | 0.15 |
| Sortie | 0.60 |
| Entrée depuis le cache | 0.015 |
Auto-hébergement : mémoire et matériel
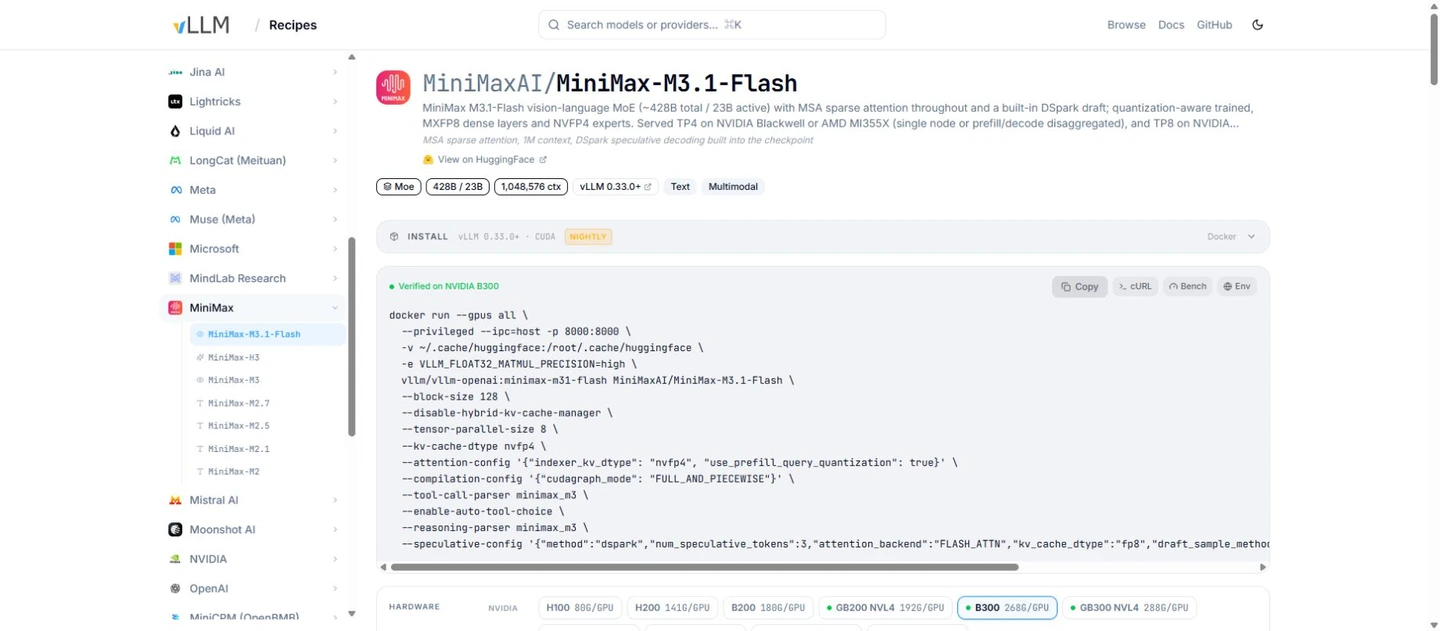
Le dépôt mélange des chemins MXFP8 et des experts MoE NVFP4 ; ce n’est pas une distribution BF16 simple. Les 48 fragments safetensors principaux du catalogue du 23 octobre totalisent environ 250,1 Go décimaux, auxquels s’ajoutent environ 2,3 Go de poids DSpark et d’autres fichiers. Ce calcul porte sur le téléchargement, pas sur une VRAM mesurée. Les éléments U8 empaquetés ne sont pas un décompte direct des paramètres logiques.
vLLM décrit notamment TP4 sur Blackwell ou AMD MI355X compatibles et TP8 sur H100/H200. Son exemple Hopper limite le contexte à 262 144, désactive la vidéo et n’active pas DSpark. Chaque déploiement doit donc vérifier ses fonctions. Prévoyez cache KV, traitement visuel, concurrence et surcharge. Une seule carte de 24/32 Go n’est pas une solution démontrée pour placer tout le modèle en GPU. SGLang est une autre voie officielle ; quantifications alternatives et déport mémoire exigent leurs propres tests.
Fiabilité, français, NSFW et retours
Le 23 octobre, Artificial Analysis affichait un Intelligence Index de 43 et environ 0,22 USD par tâche d’évaluation. L’évaluation de lancement à effort max indiquait 42, 56% de bonnes réponses sur AA-Omniscience et 93% d’hallucinations. La AA-Omniscience définit cette dernière mesure comme les réponses incorrectes parmi toutes les réponses non correctes, y compris partielles et non tentées. Elle ne signifie pas que 93% de toutes les réponses sont fausses, mais signale une faible propension à reconnaître son ignorance.
Reddit — LocalLLaMA mêle enthousiasme et interrogations sur le volume et le support ; Reddit — OpenCode rapporte la fin de l’accès gratuit constatée par des utilisateurs. Ce sont des témoignages. Il n’existe pas de résultats indépendants équivalents pour les sept langues. En français, testez accents, vouvoiement, noms, virgules décimales, dates et terminologie technique. Une réponse française n’implique pas une interface traduite, une facture locale ou une résidence des données dans l’UE.
Les poids ouverts ne garantissent ni absence de modération ni capacité NSFW fiable. La licence interdit certains usages et les hébergeurs appliquent leurs règles. Un endpoint cloud n’est pas un traitement local. Pour des documents internes ou clients, vérifiez région, conservation et conditions du fournisseur ; ne déduisez pas la disponibilité en France ou la conformité de la seule langue de sortie.
Un protocole utile avant de migrer
Choisissez deux bugs réels avec tests en échec, un diagnostic sur capture, un rapprochement de documents et une question impossible à résoudre avec les sources fournies. Gardez fichiers, outils, permissions et temps identiques. Ajoutez un cas dans le français de votre activité.
Exemple : « Reproduis le défaut. Cite le fichier et la ligne pour chaque diagnostic. Applique le changement minimal, exécute les tests utiles et signale les échecs restants. Si une information manque, précise laquelle au lieu de deviner. » Mesurez livrables acceptés, reprises, tokens d’entrée/cache/raisonnement/sortie et durée totale. Il s’agit d’un protocole proposé, pas d’un essai déjà mené par AirMore.
Questions fréquentes
Est-il entièrement open source ?
Les poids sont téléchargeables, mais la Community License impose attribution commerciale, notification ou autorisation et restrictions d’usage. Lisez la licence de cette version ; poids ouverts sous conditions est plus exact.
Une carte de 24 Go suffit-elle ?
Les poids officiels complets sont beaucoup plus volumineux. Les 23B concernent le calcul actif par token. Un chargement avec déport mémoire ne garantit ni vitesse utile, ni long contexte, ni toutes les fonctions visuelles.
Peut-on couper le raisonnement ?
Non. Réduisez effort pour chercher à diminuer latence et consommation, avec le bon champ pour le protocole. none et disabled ne constituent pas un mode sans raisonnement compatible.
Peut-il générer vidéo et voix ?
Ce modèle accepte texte, images et vidéo et rend du texte. Les médias produits par d’autres services MiniMax ou des outils externes ne sont pas ses sorties natives.
L’API restera-t-elle gratuite ?
Une offre de lancement ne donne pas un droit permanent illimité. API à l’usage, quotas M Plan et essais tiers sont différents ; vérifiez les tarifs et limites actuels.
Surpasse-t-il DeepSeek ou Claude ?
Cela dépend du travail. Le tableau MiniMax montre des avantages en automatisation et des retards dans plusieurs tests de code. Comparez des livrables vérifiés avec les mêmes outils et limites de reprise.
Notre verdict et les sources
M3.1 Flash est un candidat sérieux pour des agents et du code à faible coût, avec contexte long et poids disponibles. Un essai hébergé sur des tâches délimitées permet de décider selon exactitude, tests et dépense totale. L’auto-hébergement suppose une infrastructure et une licence adaptées.
Il ne répond pas automatiquement aux besoins d’un petit modèle de bureau, de génération native de médias, de schéma strict ou de faits sans vérification. Pour la création visuelle, notre MiniMax H3 traite une autre catégorie. Distinguez les capacités du modèle et celles des outils qui l’entourent.
Sources vérifiées le 23 octobre 2026 : MiniMax M3.1 Flash — Hugging Face, MiniMax Community License, MiniMax — M3.1 Flash, MiniMax API, MiniMax Tool Use, vLLM, SGLang, Artificial Analysis, Artificial Analysis — 2026-10-19, AA-Omniscience, OpenCode, OpenRouter et Reddit — LocalLLaMA. VentureBeat souligne le compromis entre coût et fiabilité. Cette analyse repose sur des données publiques, pas sur une mesure GPU ni une compétition de programmation réalisée par AirMore.
Connexes Évaluations
Manus 2.0 : avis sur Studio, les tarifs, l’API et les nouveautés

YuE2-3B : musique IA en local, Suno et ComfyUI
Avis Gemini Omni 1.1 Flash : IA vidéo Google, 4K, API et limites NSFW

HunyuanVideo 1.5 : avis sur la qualité, VRAM, ComfyUI, prix et limites
Avis sur Step 5 Preview : prix, API, poids ouverts et limites NSFW
Claude Fable 5.1 et Mythos 5.1 : avis 2026, prix, API, NSFW et comparaison GPT–Gemini