Dolphin 3.0 : Test et avis sur le LLM local et non censuré pour le NSFW, le jeu de rôle et le code
Dolphin 3.0 s’impose comme une référence incontournable dans l’univers des LLM locaux et sans censure. Loin d’être un simple modèle de benchmark classique, Dolphin séduit…

Dolphin 3.0 s’impose comme une référence incontournable dans l’univers des LLM locaux et sans censure. Loin d’être un simple modèle de benchmark classique, Dolphin séduit les utilisateurs en quête d’une IA capable de respecter scrupuleusement les consignes du système, plus souple pour la rédaction et le jeu de rôle, et surtout moins bridée que les assistants hébergés traditionnels.
En résumé : Dolphin 3.0 R1 Mistral 24B constitue le choix phare si votre carte graphique dispose d’une mémoire suffisante, tandis que Dolphin 3.0 Llama 3.1 8B s’avère plus accessible pour une utilisation sur bureau avec Ollama, LM Studio ou pour des tests locaux rapides. C’est une excellente option pour l’écriture créative, le jeu de rôle, le code, les mathématiques et les flux de travail de type agent, bien qu’un déploiement public nécessite toujours l’application de vos propres règles de sécurité.
Sommaire
Qu’est-ce que Dolphin 3.0 ?
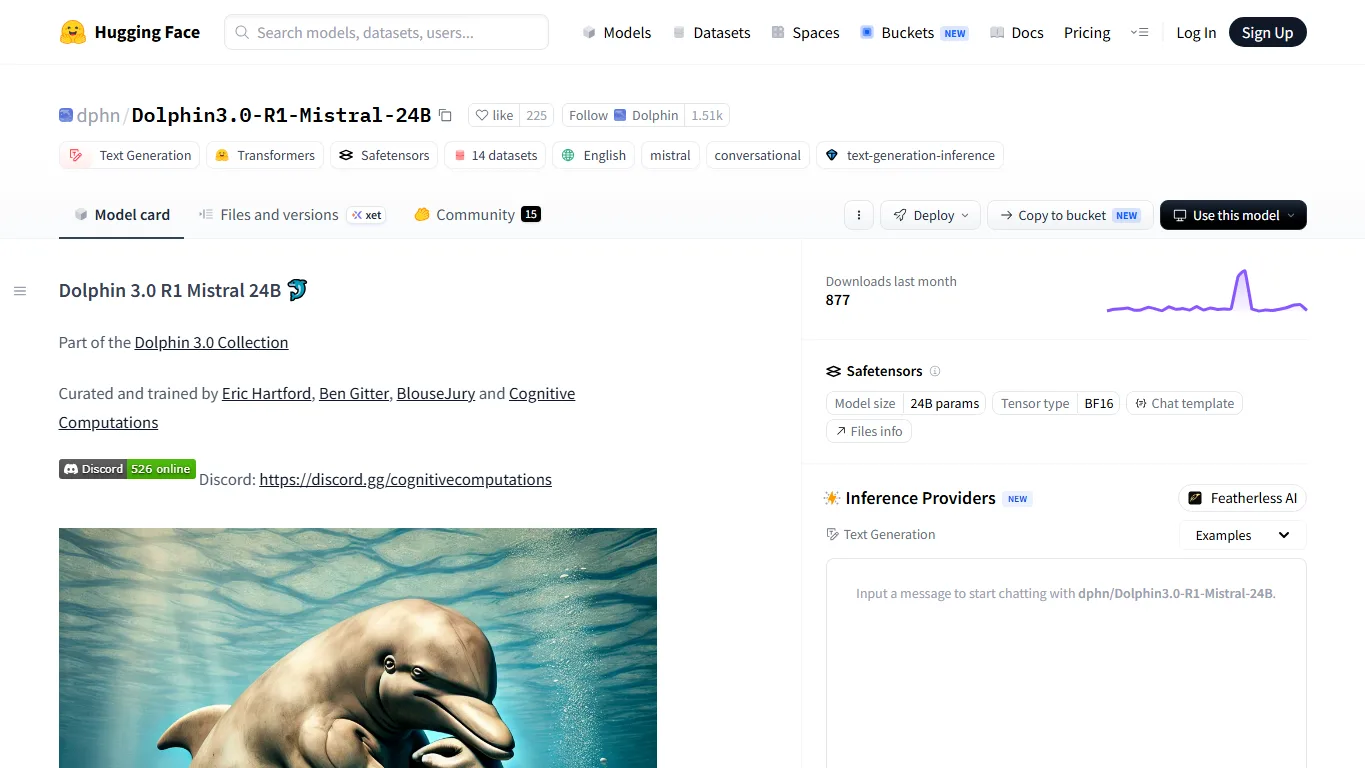
Dolphin 3.0 est une famille de modèles locaux optimisés pour le suivi d’instructions, conçus par Eric Hartford, Ben Gitter, BlouseJury et Cognitive Computations. La fiche descriptive de Dolphin3.0-R1-Mistral-24B le présente comme un modèle local généraliste adapté au code, aux mathématiques, aux tâches d’agents, à l’appel de fonctions et aux conversations générales. Elle résume également la philosophie du projet : c’est au propriétaire du système, et non à l’éditeur du modèle, de définir l’invite système (system prompt) et la politique d’alignement.
C’est précisément cette approche qui assure à Dolphin une popularité durable au sein de la communauté. Il est souvent plébiscité par les utilisateurs qui trouvent les assistants grand public trop restrictifs pour la fiction, le jeu de rôle privé, l’expérimentation locale ou la recherche sur les comportements d’invites. Néanmoins, Dolphin reste un modèle linguistique : il peut commettre des erreurs (hallucinations), suivre de mauvaises consignes et générer des contenus inappropriés pour des applications publiques en l’absence de modération.
Téléchargements officiels
| Modèle | Idéal pour | Téléchargement |
|---|---|---|
| Dolphin 3.0 R1 Mistral 24B | Qualité globale optimale de la gamme Dolphin 3.0 ; code, mathématiques, jeu de rôle et tâches d’agents | Hugging Face 24B |
| Dolphin 3.0 Llama 3.1 8B | Tests sur GPU grand public, chat local sur bureau, jeu de rôle rapide et écriture | Hugging Face 8B |
| Dolphin 3.0 Llama 3.1 8B GGUF | Utilisation locale avec llama.cpp, LM Studio, KoboldCPP ou Ollama | GGUF 8B officiel |
| Dolphin 3.0 R1 Mistral 24B GGUF | Tests sur serveur ou station de travail via un modèle 24B quantifié | GGUF 24B par Bartowski |
| Ollama dolphin3 | Installation locale rapide en une seule commande (version 8B) | Ollama dolphin3 |
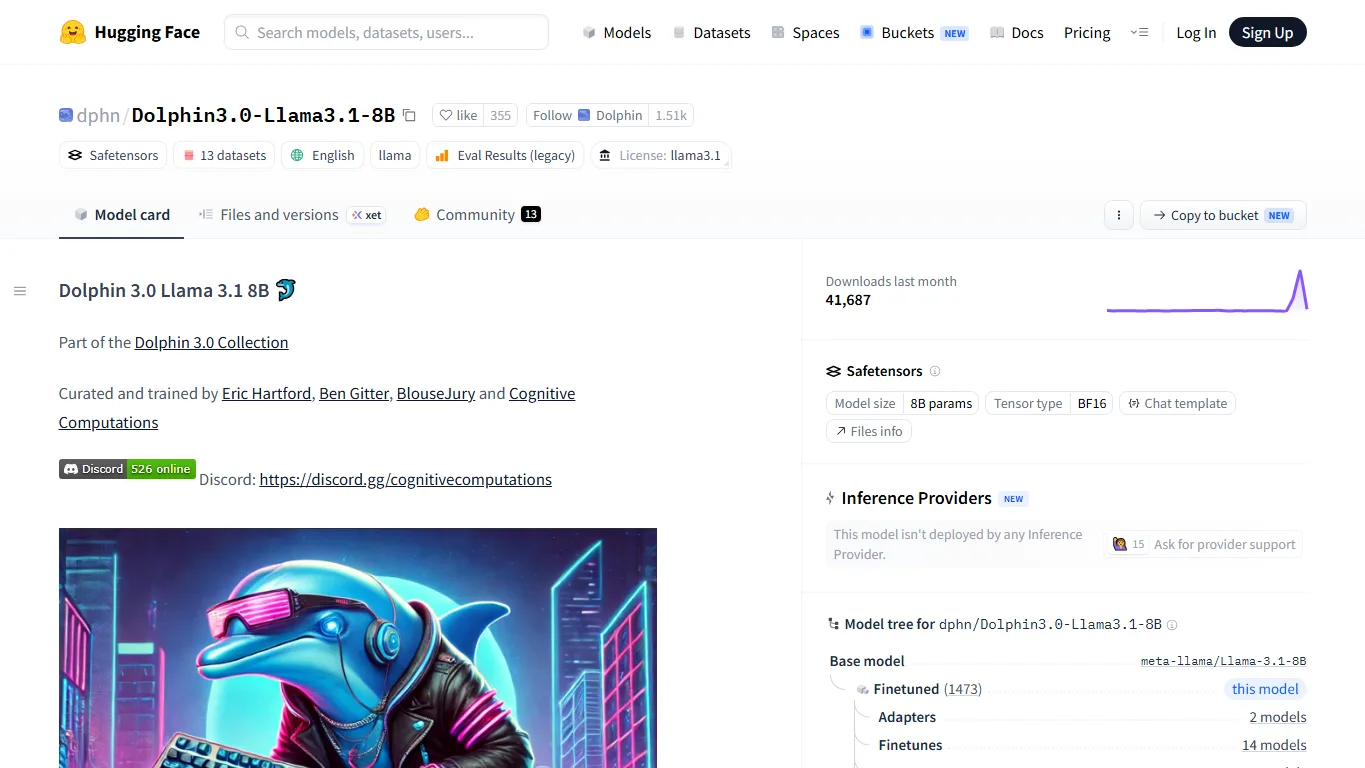
Si vous découvrez Dolphin, commencez par la version 8B ou via Ollama. Passez au modèle 24B une fois que vous maîtrisez vos invites, la longueur du contexte et les limites de votre matériel. Le modèle 24B s’avère plus intéressant à évaluer, mais la version 8B reste celle que la grande majorité des utilisateurs peut faire tourner sans modifier sa configuration matérielle.
Avis des utilisateurs et points forts
L’intérêt de la communauté pour Dolphin repose essentiellement sur trois piliers : l’obéissance aux consignes, la stabilité en écriture et en jeu de rôle, et un taux de refus très faible. Ce modèle ne cherche pas à se positionner comme l’assistant le plus sûr, mais plutôt comme une IA locale hautement paramétrable qui permet à l’utilisateur de définir le comportement souhaité directement via l’invite système.
Comparé à de nombreux modèles de chat officiels, Dolphin se montre souvent plus direct et moins directif. Cette caractéristique le rend particulièrement utile pour l’écriture de fiction, les dialogues de personnages, le brainstorming privé, les agents locaux et l’assistance au code, là où le créateur exige un strict respect des consignes. En contrepartie, il demande plus de rigueur de la part de l’utilisateur : si l’invite est imprécise, le résultat le sera tout autant.
Comparaison avec d’autres LLM locaux
| Modèle | Comparaison avec Dolphin 3.0 | À qui s’adresse-t-il ? |
|---|---|---|
| Dolphin 3.0 | Approche classique de fine-tuning sans censure, contrôle étendu via l’invite système, très populaire pour l’écriture et le jeu de rôle. | Utilisateurs recherchant une flexibilité locale et un minimum de refus. |
| Qwen 3.8 | Écosystème multilingue et de codage plus vaste, nouvelle famille de grands modèles ; approche plus sécurisée par défaut. | Utilisateurs travaillant en japonais, chinois ou anglais, ou ayant besoin de code et de RAG. |
| Gemma 4 | Famille de modèles soutenue par Google, documentation officielle plus claire et orientation multimodale ; moins orienté « sans censure » par défaut. | Utilisateurs privilégiant les poids ouverts grand public et la documentation de sécurité. |
| Fins-tuning Llama 3.1 / Llama 4 | Écosystème gigantesque et nombreux dérivés sans censure ; Dolphin reste une gamme organisée et identifiable. | Utilisateurs souhaitant un choix maximal de modèles communautaires. |
| Mistral Small 24B | Le modèle de base de la version 24B est performant, mais Dolphin modifie le profil de suivi des consignes et de refus. | Utilisateurs préférant un modèle d’instruction plus conventionnel. |
| Modèles Nous / Hermes | Également très efficaces pour le jeu de rôle et le suivi d’instructions, mais généralement moins commercialisés comme « sans censure ». | Utilisateurs comparant l’écriture créative et le comportement des agents. |
Installation locale
Pour le modèle 8B, Ollama représente l’option la plus simple. Cet outil masque la plupart des complexités techniques et s’avère amplement suffisant pour des tests de conversation rapides, des expériences d’invites et des flux d’écriture locaux.
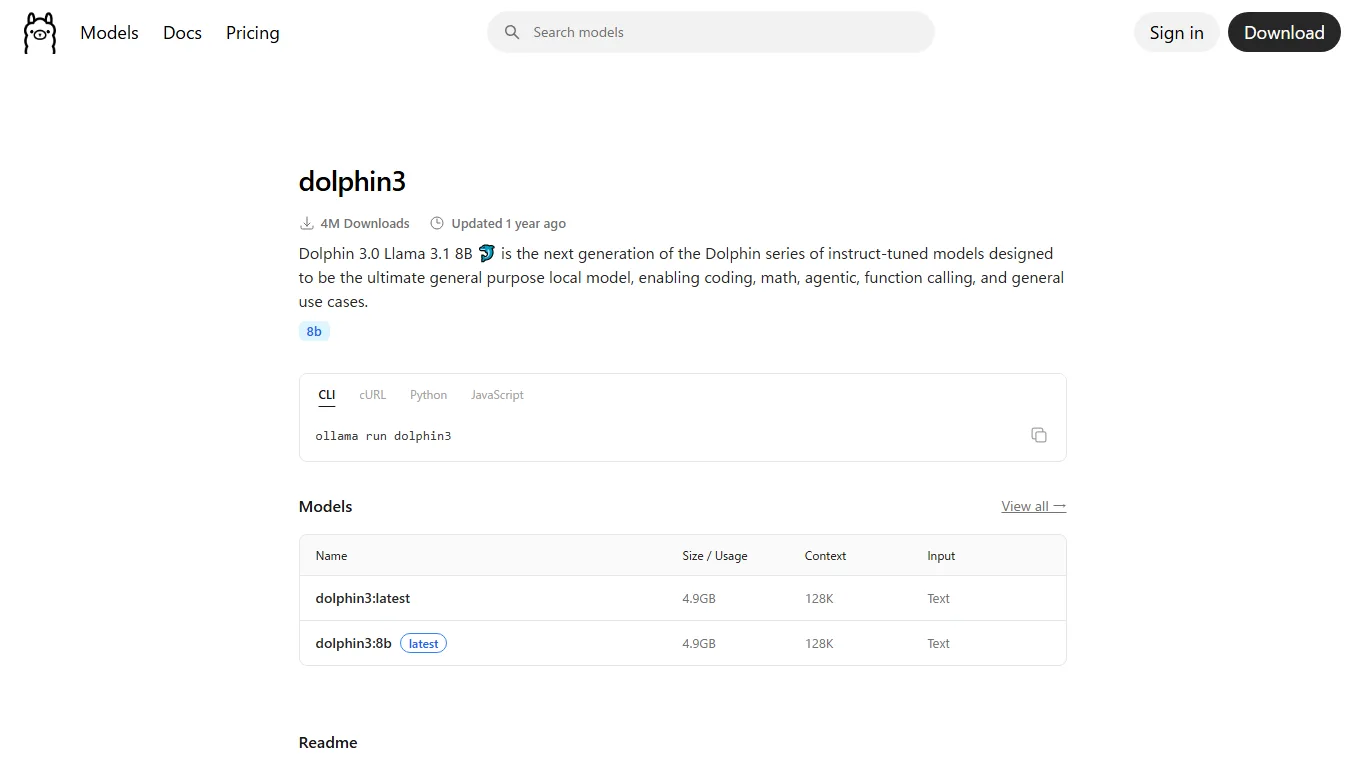
ollama pull dolphin3 ollama run dolphin3Pour les fichiers au format GGUF, tournez-vous vers LM Studio ou llama.cpp. Quant au modèle complet 24B au format Safetensors, utilisez Transformers ou une pile de service comme vLLM si votre matériel le permet.
pip install -U transformers accelerate torch safetensors python - <<'PY' from transformers import AutoModelForCausalLM, AutoTokenizer model_id = "dphn/Dolphin3.0-R1-Mistral-24B" tok = AutoTokenizer.from_pretrained(model_id) model = AutoModelForCausalLM.from_pretrained( model_id, torch_dtype="auto", device_map="auto", ) PYConfiguration matérielle requise (GPU)
| Modèle | Estimation BF16 | Approche pratique | Remarques |
|---|---|---|---|
| Dolphin 3.0 Mistral 24B | Environ 48 Go+ pour les poids, davantage avec un contexte long et un cache KV | Un GPU de 24 Go peut convenir avec des versions GGUF 4 bits / quantifiées et un contexte réduit | Excellente qualité, mais configuration locale plus exigeante. |
| Dolphin 3.0 Llama 3.1 8B | 16 Go+ garantissent un confort d’utilisation en BF16 | 6 à 12 Go suffisent avec une quantification GGUF | Le meilleur modèle pour débuter sur un GPU domestique. |
| GGUF sur processeur (CPU) | Aucune VRAM nécessaire, mais exécution plus lente | Utiliser un GGUF Q4/Q5 avec llama.cpp ou LM Studio | Idéal pour tester l’écriture, moins adapté aux agents complexes. |
| API / Chat en ligne | Aucun GPU local requis | Utiliser le chat web de Dolphin, OpenRouter ou un autre fournisseur | Pratique pour évaluer le modèle avant de le télécharger. |
Les besoins réels en mémoire dépendent de la quantification, de la longueur du contexte, de la taille des lots (batch size), du cache KV, du déchargement sur le GPU (offload) et du logiciel d’exécution choisi. Pour le jeu de rôle ou la rédaction avec un contexte étendu, la consommation de mémoire augmente rapidement. Si un modèle se charge mais ralentit fortement ou plante, réduisez la longueur du contexte avant de conclure qu’il est inutilisable.
Utilisation en ligne lorsque votre matériel est insuffisant
Le point d’accès web officiel de Dolphin se trouve à l’adresse dphn.ai/chat, et l’organisation Hugging Face de Dolphin oriente également les utilisateurs vers ses canaux communautaires officiels. C’est l’endroit idéal pour découvrir le projet avant d’installer un modèle en local.
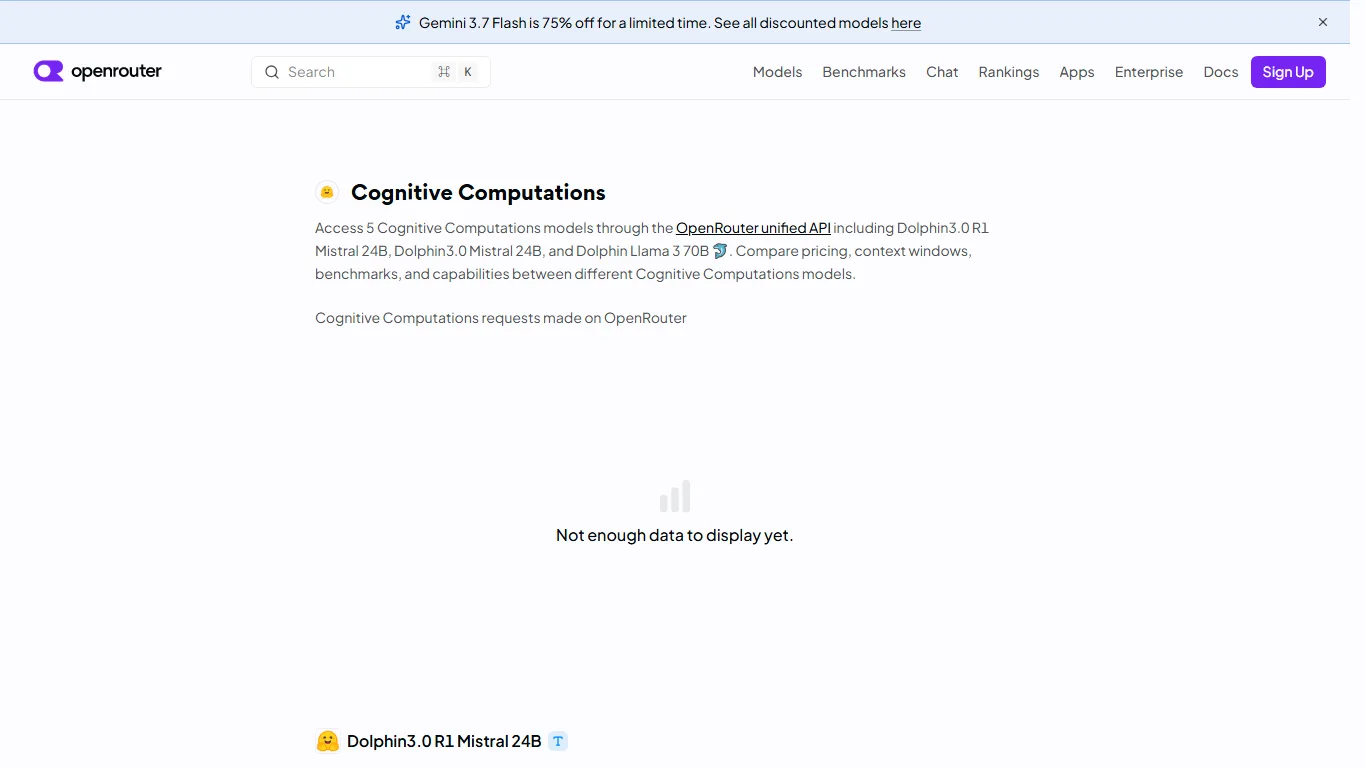
Pour des tests via API, la page Cognitive Computations d’OpenRouter s’avère très utile. Elle répertorie les modèles de Cognitive Computations et permet aux développeurs de comparer les tarifs, les fenêtres de contexte et les performances. Venice est une autre alternative de chat en ligne prisée par les utilisateurs attachés à la confidentialité et recherchant moins de restrictions, bien qu’il s’agisse d’un service tiers distinct du site officiel de Dolphin.
NSFW et comportement sans censure
Dolphin 3.0 fait partie des familles de modèles locaux sans censure les plus réputées. Pour un usage privé et local, le modèle se montre généralement beaucoup plus enclin à accepter des consignes pour adultes, des jeux de rôle ou des scénarios créatifs sensibles que les assistants hébergés grand public. C’est la raison principale pour laquelle les utilisateurs recherchent Dolphin en utilisant des termes tels que NSFW, sans censure, jeu de rôle ou LLM local sans verrouillage (jailbreak-free).
Néanmoins, absence de censure ne signifie pas absence de risques ou limites infinies. Dolphin peut générer des contenus pour adultes, des suggestions non sécurisées, des biais ou des propos sensibles d’un point de vue juridique si l’invite le pousse en ce sens. Le modèle ne remplace en aucun cas la mise en place d’une politique de modération. Si vous le déployez pour un public tiers, vous devez instaurer vos propres règles, filtres, systèmes de journalisation et procédures de gestion des abus. Pour un usage personnel, privilégiez une exécution locale tout en respectant la législation et les règles applicables dans votre pays.
La meilleure façon d’aborder Dolphin n’est pas de le voir comme un modèle magique sans conséquences, mais plutôt comme un modèle local finement accordé et contrôlable. Il excelle lorsque vous souhaitez que l’invite système joue un rôle prépondérant, tout en acceptant la responsabilité des requêtes que vous lui soumettez.
FAQ
Dolphin 3.0 est-il réellement sans censure ?
Il oppose beaucoup moins de refus que les assistants hébergés traditionnels et s’inscrit pleinement dans la tradition des modèles affinés sans censure. Cependant, le comportement final dépend toujours de la variante du modèle, de l’invite, du logiciel d’exécution et des éventuelles couches de modération que vous ajoutez.
Par quel modèle Dolphin 3.0 dois-je commencer ?
Débutez avec Dolphin 3.0 Llama 3.1 8B via Ollama ou au format GGUF si vous disposez d’un ordinateur de bureau standard. Tournez-vous vers Dolphin 3.0 R1 Mistral 24B si vous recherchez une meilleure qualité et possédez assez de VRAM ou utilisez une version quantifiée.
Une carte RTX 4090 de 24 Go peut-elle faire tourner le modèle 24B ?
Le modèle complet 24B en BF16 est trop volumineux pour tenir confortablement dans 24 Go de VRAM, mais les versions GGUF 4 bits ou d’autres formats quantifiés peuvent fonctionner avec un contexte réduit et des réglages minutieux.
Dolphin est-il performant en français ?
Il est capable de générer des réponses en français, bien qu’il ne soit pas initialement spécialisé pour cette langue. Qwen ou d’autres modèles multilingues s’avèrent parfois plus robustes pour une rédaction soignée en français. Dolphin se distingue avant tout par son obéissance aux consignes et son comportement en jeu de rôle sans censure.
Est-il sûr d’utiliser Dolphin en ligne ?
Les fournisseurs en ligne appliquent leurs propres règles de confidentialité, politiques de journalisation, modération et conditions d’utilisation. Pour des requêtes sensibles, l’utilisation locale reste l’option la plus sûre. Pour des évaluations rapides, les plateformes en ligne se révèlent pratiques, à condition de ne pas y téléverser de données confidentielles.
Puis-je utiliser Dolphin à des fins commerciales ?
Vérifiez la licence du modèle exact ainsi que celle du modèle de base ou de la conversion GGUF que vous téléchargez. Les conditions d’utilisation et les licences peuvent varier sensiblement entre les poids d’origine, les versions affinées et les publications quantifiées.
Notre verdict
Dolphin 3.0 demeure l’un des exemples les plus aboutis de la démarche classique d’affinage local sans censure. Il s’impose naturellement lorsque vous recherchez un outil pour l’écriture créative, le jeu de rôle, la création d’agents, l’assistance au code, et que vous souhaitez éviter les refus systématiques des assistants conversationnels traditionnels.
Le point de départ idéal réside dans la version 8B via Ollama ou GGUF. Le modèle Mistral 24B s’adresse quant à lui aux utilisateurs disposant d’un matériel plus puissant en quête de performances supérieures. Pour un usage NSFW et sans censure, le modèle tire toute sa force de sa capacité à redonner le contrôle à l’utilisateur, ce qui implique également que ce dernier assume l’entière responsabilité de ses requêtes.
Références
Connexes Évaluations
Avis sur Grok 4.6 : raisonnement, agents, prix et politique NSFW

Avis Mistral AI : modèles locaux, Large 3, Small 4 et politique NSFW
Test Z-Image : Turbo, Base, VRAM, LoRA et usage local NSFW

Test de FLUX 3 : Image, Klein, retouche, VRAM et licence
Meilleurs LLM open-source locaux en 2026 : performances, NSFW et matériel comparés
Test Seedream 5.0 Pro : modèle d'image IA, accès API et politique en matière de contenu explicite