Análisis de Strata: modelos de IA local, instalación, rendimiento y privacidad
Conoce Strata: modelos compatibles, instalación, hardware, API, experiencias de usuarios y la opción DeepSeek con 12 GB.

Strata es una aplicación gratuita y de código abierto para ejecutar modelos de lenguaje compatibles en el ordenador y conectarlos a herramientas de chat o programación. Su propuesta combina VRAM, RAM y, cuando hace falta, SSD para hacer accesibles modelos grandes en equipos de consumo. Es útil para quienes quieren control local y aceptan gestionar hardware y descargas.
Su atractivo es reunir selección de modelos, chat local y conexión con herramientas de programación en una sola aplicación. La experiencia depende de elegir un modelo compatible con la RAM y el almacenamiento disponibles, además del hardware y los ajustes.
Contenido
Cómo funciona Strata
Ofrece una aplicación de escritorio, un lanzador Terminal y motores adaptados a familias concretas. En modelos de mezcla de expertos distribuye componentes entre GPU y CPU/RAM; si falta RAM, puede leer más desde SSD, normalmente con penalización de velocidad. La calidad también depende del modelo, la cuantización y los ajustes.
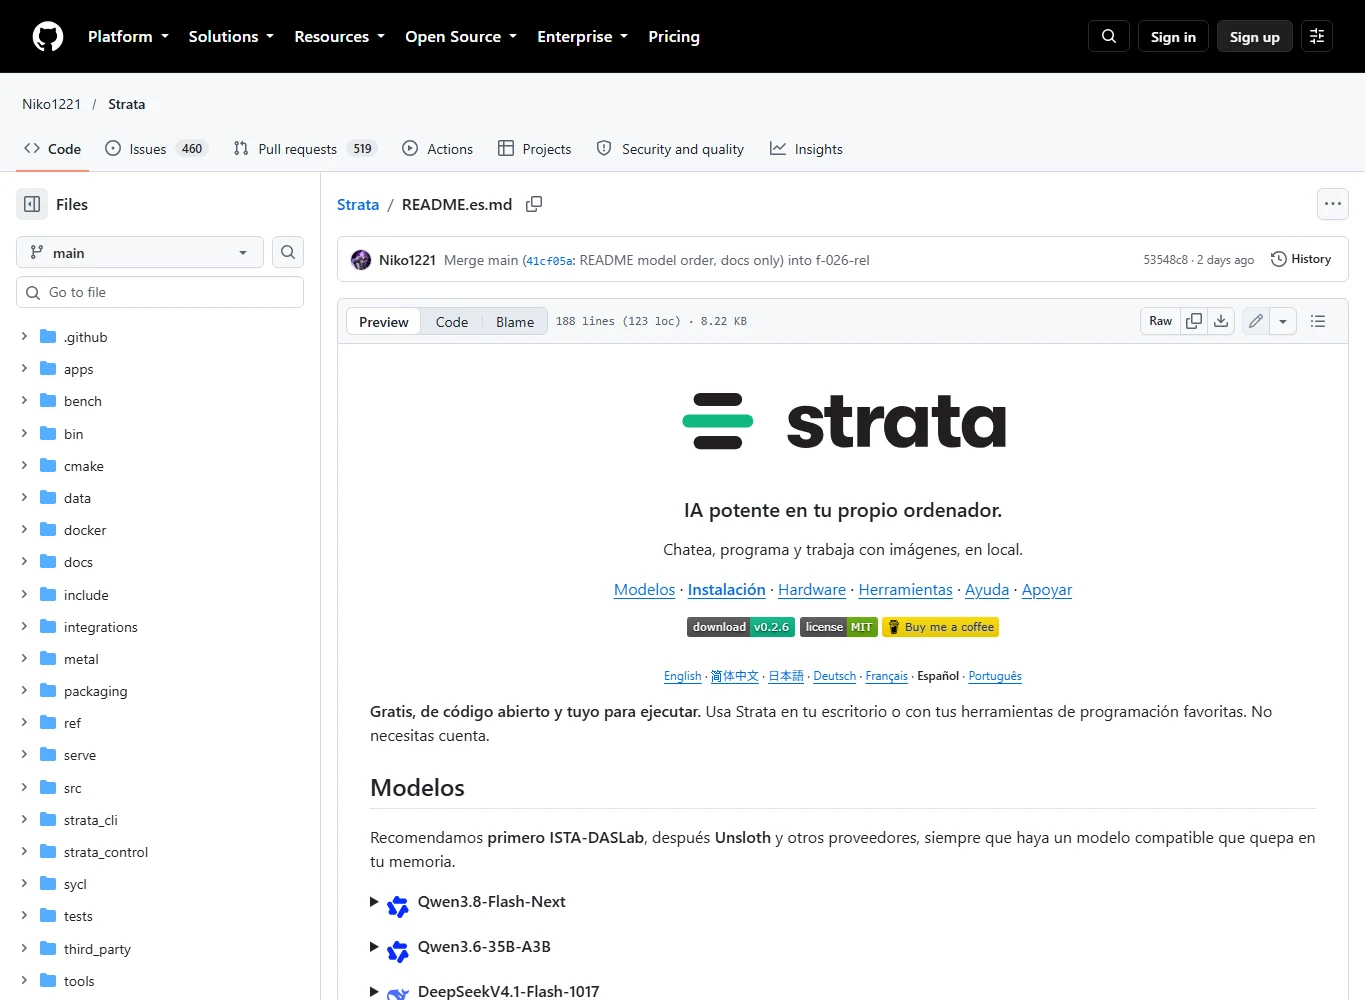
Según el proyecto, el software es gratuito, tiene licencia MIT y no exige cuenta. La versión 0.2.10 ofrece instaladores para Windows, Linux y macOS con Apple Silicon, pero cada motor tiene compatibilidad específica.
Modelos y hardware compatibles
La lista oficial incluye Qwen3.8-Flash-Next con paquetes compatibles de ISTA-DASLab y Unsloth, Qwen3.6-35B-A3B con paquetes Unsloth documentados y DeepSeek V4.1-Flash-1017 con motor separado. Los archivos no son intercambiables sin comprobar la familia y el formato.
El proyecto estima 37,6 GB de RAM más VRAM para los pesos Q2_0 de Qwen3.8-Flash-Next y 54,8 GB para IQ3_S, sin contar el sistema ni el contexto. Son estimaciones; algunas rutas usan SSD más lentamente. Strata enumera NVIDIA RTX, ciertas AMD Radeon, Intel Arc en Linux, Apple Silicon y Ryzen AI Max, con límites por modelo y motor.
Instalación y uso diario
En 0.2.10, la guía indica descargar el instalador del sistema, obtener el motor adecuado en el primer arranque de Windows/Linux, elegir modelo y carpeta y esperar la preparación. El instalador de Mac incluye el motor Metal; Intel Arc usa Terminal en Linux. La descarga inicial puede ser considerable.
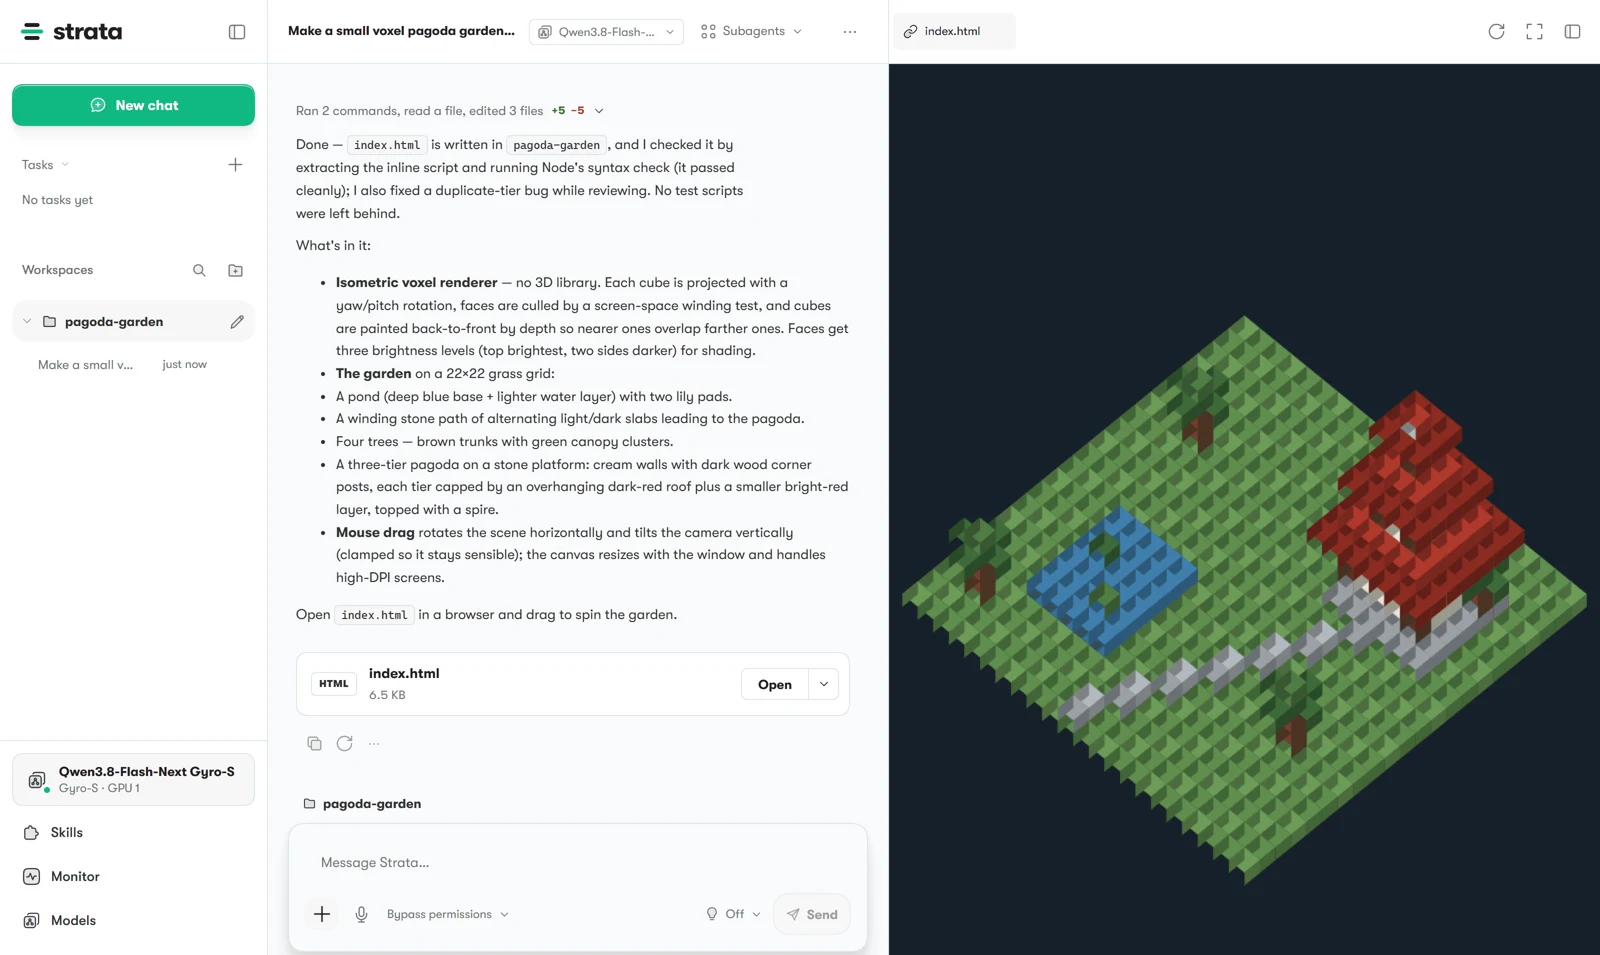
La aplicación ofrece chat, archivos y vista previa de código; Terminal aporta configuración guiada y monitorización. Son funciones documentadas, no una prueba propia de usabilidad. Comprueba controladores, espacio, licencia del modelo y guía de problemas antes de descargar.
Strata 0.2.10: novedades, actualización y límites reales
A 4 de noviembre de 2026, la versión más reciente es Strata 0.2.10. Aplicación y Terminal usan 0.2.10; Control y motores, 0.1.56. Es normal que difieran. Cambian la gestión de memoria, la generación especulativa, ciertas configuraciones Linux multi-GPU y los controles del agente; no se duplica universalmente el rendimiento.
DFlash2 pasa a ser habitual para una solicitud
Con Qwen3.8 y Drafting en Auto, los motores compatibles suelen elegir DFlash2 para una solicitud. Un auxiliar predice tokens y el modelo principal los verifica. El desarrollador registra 625 MiB de VRAM con selector Q4_0 y unos 1.2 GB de descarga/preparación inicial. La capa MTP evitada es un archivo de unos 5.2 GB; no equivale a ahorrar siempre 4 GB de VRAM.
Auto mantiene MTP con dos o más solicitudes simultáneas, DeepSeek/Coder, motores sin DFlash2 y el nuevo reparto entre todas las tarjetas. Solo carga un auxiliar. Frente a MTP, RTX PRO 5000 IQ3_S ganó 6.23% en respuestas cortas muestreadas y 1.38% en largas; Arc A750 perdió 2.6%. Auto no siempre es la opción más rápida.
128K en 8 GB: arrancar no garantiza velocidad
El contexto predeterminado es 131,072 tokens. Si falta VRAM en una GPU discreta, reduce la ventana KV residente, omite MTP si hace falta, reduce búferes y, como último recurso, mueve la cabeza de salida a RAM fijada. Así conserva el contexto solicitado, aunque el último recurso puede hacer la generación unas tres veces más lenta. Esta secuencia no se aplica igual a Apple o Strix Halo con memoria compartida.
Son pruebas del desarrollador, no de AirMore. Los resultados NVIDIA/Radeon rápidos con “8 GB” proceden de tarjetas mayores limitadas en estaciones con mucha RAM; un PC doméstico puede depender más del SSD.
| Condición | Resultado | Interpretación |
|---|---|---|
| Qwen3.8 IQ3_S, 8 GB simulados, 128K, DFlash2 | 63–73 tok/s; prompt 32K en 19.8 s | No es una RTX 3060 de 8 GB medida |
| Intel Arc A750 real de 8 GB, arranques 128K | 12.7–14.8 tok/s | Hardware real, motor y ruta de memoria distintos |
| RTX 5070 de 12 GB limitada a ~8 GB | 17–27% más lenta | Mantener contexto puede reducir rendimiento |
128K expresa capacidad de contexto, no una garantía medida de recuerdo o razonamiento perfecto en toda su longitud.
La aceleración multi-GPU tiene condiciones
El reparto all-cards asigna a cada GPU parte de cada capa. En 0.2.10 se activa automáticamente en Terminal/servidor Linux elegible; la aplicación conserva reparto por capas y DFlash2. La integración gráfica se anunció para 0.2.10.1, no como función ya entregada.
Auto exige exactamente dos NVIDIA con capacidad de cómputo 8.6 o 12.0, o cuatro R9700 con el paquete UD-Q4_K_XL indicado; Qwen3.8 compatible; todos los expertos en las GPUs; unos 43 GiB libres de RAM para la parte residente; y contexto de hasta 128K. Se probaron pares A6000/PRO Blackwell, no GeForce. Otras configuraciones suelen conservar reparto por capas.
Mediciones del desarrollador: dos RTX A6000, Linux, UD-Q4_K_XL, 128K, pruebas alternadas y medianas de tres ejecuciones. No describen una sola tarjeta de 12 GB.
| Tarea | Reparto por capas de 0.2.9 | Nuevo all-cards |
|---|---|---|
| Editar código | 195 tok/s | 377–394 tok/s |
| Código nuevo | 139–144 tok/s | 189–232 tok/s |
| Prosa | 93 tok/s | 139–146 tok/s |
ISTA-DAS Coder y entrada de imágenes en Mac
ISTA-DAS Coder poda DeepSeek-V4.1-Flash y conserva 192 de 384 expertos por capa. Es otro modelo, no un interruptor sin pérdida de capacidades. La descarga nueva ronda 191 GB: modelo 72.1 GB, tabla Engram compartida 110.6 GB y auxiliar 8 GB. Si ya existe el Engram compatible, la descarga adicional ronda 80 GB; los archivos visuales añaden espacio. Comprueba el plan, no solo el tamaño de pesos.
Está orientado a código y agentes; las comparaciones publicadas muestran mayor sacrificio en texto general y multilingüe. Una prueba del desarrollador registró 22.8 tok/s en una R9700, pero la ruta Windows NVIDIA de Coder solo se planificó, no se midió en esa publicación. Compatibilidad prevista con 12 GB no garantiza velocidad.
DeepSeek en Mac añade comprensión de imágenes. En M5 Max se leyeron ocho solicitudes visuales, con un error de carácter documentado en un código de factura. Es lectura, no generación de imágenes. La primera compilación añade 6.0–8.7 s; M1–M3 no se midieron. Probar solo el codificador visual en M4 de 32 GB no demuestra que quepa todo DeepSeek.
Mejoras prácticas de interfaz y clientes de código
- Approve/Deny permanecen sobre la caja de texto con respuestas largas, facilitando revisar acciones pendientes.
- Subagents recibe instrucciones posteriores y confirma envío o rechazo; Enter puede esperar, poner en cola o interrumpir según Settings.
- Los resúmenes de historial se solicitan en tu idioma conservando rutas, comandos y nombres; puedes citar un turno o selección.
- Mejora el manejo de herramientas Anthropic/Responses. El error de contexto en /v1/messages permite a Claude Code compactar o acortar salida en vez de repetir la misma petición; conviene verificar el cliente concreto.
- Windows corrige la prioridad de disco demasiado baja heredada de procesos en segundo plano, que ralentizaba cargas, y actualiza rutas guardadas del motor.
Actualizar, comprobar y volver atrás
Descarga de memoria los modelos activos y guarda la configuración antes de sustituir el motor. Usa la actualización integrada de la aplicación o los comandos siguientes en Terminal.
Comprueba aplicación/Terminal 0.2.10 y Control/motor 0.1.56. Al venir específicamente de 0.2.9 con DeepSeek, actualiza dos veces: primero lanzador/Control/Qwen, después paquete DeepSeek. Mientras tanto funciona el motor anterior. Un Terminal anterior a 0.2.0 requiere ejecutar de nuevo el instalador oficial.
strata update --check
strata update
strata --version
strata doctor --live
strata launch --family qwen --model iq3_s --plan
strata launch --model ISTA-DAS-Coder --planSe reutilizan archivos compatibles; actualizar no exige borrar cientos de GB. Ante una regresión, detén el modelo, recupera el componente retenido y repite pruebas cortas de conversación, archivo/herramienta y prompt largo.
strata components rollbackRAM, modelos residentes y desgaste del SSD
12 GB de VRAM no contienen todo el modelo de 125B. GPU, CPU/RAM y SSD comparten el trabajo. Los pesos Qwen3.8 originales se estiman en 37.6 GB combinados para Q2_0 y 54.8 GB para IQ3_S, más sistema y contexto. Cuantización, ancho de banda de RAM y PCIe afectan la respuesta.
Para ampliar prompts antes de ComfyUI, redacta primero y descarga el modelo Strata de memoria antes de generar imágenes. Usa GPU memory for other apps o Leave room for my work; no fuerces la reserva gráfica a cero. Un servidor de Terminal en segundo plano debe comprobarse y detenerse aparte.
Tráfico SSD no equivale a desgaste de escritura: Engram/consultas leen filas; TBW mide escrituras. Descargas, preparación, registros y swap sí pueden escribir. Observa escrituras del host/SMART, RAM libre, swap, temperatura y latencia con tu carga real. No hay una vida útil fija verificada de “X meses usando Strata”.
strata launch --status
strata launch --stop
El rumor del precio de la RTX 3060
Strata da interés a GPUs antiguas de 12 GB, pero no está demostrado que cause la subida de la RTX 3060. Tom’s Hardware ya informaba de precios nuevos al alza en agosto de 2026, antes de esta versión de noviembre. Oferta, memoria, región y estado de segunda mano no se separan de la demanda Strata con unas anécdotas.
El interés tiene ejemplos técnicos: un usuario de octubre informó de unos 50 tok/s de generación y 1,000 tok/s de entrada con una RTX 3060 12 GB, doble Xeon sin pantalla, 64 GB RAM y motor 0.1.47. Es un relato antiguo, no un benchmark 0.2.10 ni prueba de que comprar solo la tarjeta reproduzca el resultado. Cuenta RAM, SSD, energía, refrigeración y modelo.
Límites que siguen presentes
Persisten llamadas DeepSeek malformadas cuando casi todo llega del SSD y variaciones incluso a temperatura cero. All-cards rechaza logprobs/logit_bias y algunos prompts largos se leen más despacio. En 0.2.8 se desactivó por defecto una aceleración de rutas para poca VRAM tras casos de repetición; no copies parámetros antiguos de “12 GB más rápidos” sin comprobar calidad. Empieza en Auto y separa entrada, primer token, generación y corrección.
Sección comprobada el 4 de noviembre de 2026 con la publicación 0.2.10, documentación y testimonios identificados. Las cifras son mediciones del desarrollador o usuarios; AirMore no hizo pruebas propias de hardware.
Programación y API
Strata documenta API locales compatibles con OpenAI y Anthropic para clientes como Claude Code, Codex CLI y OpenCode; `strata connect` muestra instrucciones. La compatibilidad de API no garantiza que cada parámetro o llamada a herramientas coincida con un servicio alojado.
Prueba un prompt corto y una llamada sencilla con tu versión de cliente. Contexto, imágenes, concurrencia y herramientas dependen del motor; las funciones de Qwen no deben atribuirse automáticamente a DeepSeek.
Rendimiento y experiencias de usuarios
Un usuario informó de una semana de tareas DevOps con Qwen3.8-Flash-Next IQ2_XS, RTX 5070 Ti de 16 GB, 64 GB de RAM y Strata 0.1.38–0.1.43. Ejecutó 28 tareas dos veces y comunicó 49/56 en una configuración. Es un resultado autodeclarado y limitado, no una certificación de 0.2.10 ni una equivalencia general.
Otro usuario con RTX 4080 y RTX 3060 comunicó unos 55 tokens/s con una tarjeta y 45 con ambas; otra discusión menciona bucles y confusión de puertos. Son experiencias individuales, no tasas de fallo verificadas. Una reseña externa basada en fuentes públicas también advierte de los requisitos, las descargas y los compromisos para agentes.
DevOps user report · Dual-GPU user report · User discussion · External review
Un ejemplo de modelo grande: DeepSeek con 12 GB
DeepSeek V4.1 Flash 1017 es una opción, no el único propósito del producto. El proyecto publica ejemplos con GPU de 12 GB y 46–64 GB de RAM; el paquete 2.00-bit descarga unos 257 GB y requiere unos 265 GB libres en NVMe. No hemos repetido la medición.
La guía DeepSeek usa una base de 8,192 tokens; imágenes y concurrencia dependen del motor y backend. 0.2.10 añade imágenes al motor Mac Metal, explicado en la sección nueva; los 128K de Qwen no garantizan ese contexto en DeepSeek. Faster puede usar cinco de seis expertos; Full quality usa seis. Las mediciones históricas del desarrollador en 0.2.5 fueron 4–6 tokens/s en RTX 5070 y 9–11 en RTX 3060, con equipos distintos, no pruebas nuevas de 0.2.10.
Privacidad, seguridad y costes
El desarrollador afirma que Strata no envía telemetría de uso y que el servidor escucha localmente por defecto. Las descargas y actualizaciones requieren red; búsqueda web, proveedores externos, compartición o túneles pueden transmitir datos fuera del equipo. Revisa permisos y ajustes.
El programa es gratuito y MIT, pero cada modelo y dependencia tiene condiciones propias. Hardware, electricidad y almacenamiento cuestan; la ejecución local no garantiza seguridad absoluta ni respuestas correctas.
Alternativas y limitaciones
Frente a gestores locales como Ollama o LM Studio, Strata se centra en familias compatibles y en la distribución de memoria; revisa la compatibilidad actual de cada producto. Un modelo más pequeño puede ser más rápido; una API en la nube evita descargas, pero envía datos al proveedor y cobra por uso.
Sus ventajas son las API locales, la optimización específica y las dos interfaces. Sus límites incluyen catálogo restringido, descargas grandes, velocidad dependiente del equipo, cambios frecuentes y menos evidencia independiente que herramientas maduras.
Para quién es Strata
Conviene a usuarios con hardware compatible, RAM y SSD suficientes, dispuestos a ajustar un entorno local de chat o programación. Empieza con un paquete compatible más pequeño, usa el planificador y prueba tareas propias.
Información consultada el 27 de octubre de 2026: fuentes oficiales, una reseña externa basada en fuentes públicas y experiencias de usuarios. Se utilizó IA en la redacción; no instalamos Strata ni medimos velocidad, estabilidad o calidad.
Relacionados Reseñas
5 mejores herramientas para mejorar un PDF en 2026

Reseña de ERNIE-Image: IA de imagen open source, LoRA, uso local y NSFW
Los 8 mejores software de base de conocimientos en 2026

Las 8 Mejores Plataformas de Cursos Online en 2026
Los 5 mejores creadores de collages en 2026
6 mejores herramientas para convertir fotos en dibujos (2026)