MiniMax-Music3 Review: Open-Weight AI Music Model for 5-Minute Songs
MiniMax-Music3 es un modelo de generación de música mediante IA con pesos abiertos capaz de crear canciones completas de hasta cinco minutos de duración a…

MiniMax-Music3 es un modelo de generación de música mediante IA con pesos abiertos capaz de crear canciones completas de hasta cinco minutos de duración a partir de la letra y una descripción musical detallada. En lugar de centrarse únicamente en bucles cortos o clips de fondo, su objetivo es lograr una estructura de canción completa: intro, verso, estribillo, puente, solo instrumental y outro.
El veredicto rápido es sencillo: MiniMax-Music3 no ofrece la misma inmediatez que Suno o Udio para la creación casual en el navegador, pero resulta mucho más interesante para desarrolladores, usuarios de ComfyUI, investigadores y creadores que buscan flujos de trabajo locales. Sus puntos fuertes son la estructura de larga duración, el control mediante letra y descripción, y las rutas documentadas para SGLang-Omni, Diffusers y ComfyUI.
Contenido
- Qué es MiniMax-Music3
- Características principales y especificaciones
- Experiencia práctica y calidad de los resultados
- Descarga y configuración local
- Requisitos de VRAM y hardware
- Comparativa con los principales modelos de música por IA
- Licencia, uso comercial y derechos de autor
- Ejemplo de prompt
- Preguntas frecuentes
- Referencias
- Resumen
Qué es MiniMax-Music3
MiniMax-Music3 es un modelo de texto a música desarrollado por MiniMax. La ficha oficial en Hugging Face lo describe como un modelo de generación musical de alto rendimiento para canciones completas de hasta cinco minutos, condicionado por la letra y una descripción musical detallada. Produce voces expresivas, arreglos en evolución y audio estéreo WAV de 32 kHz y 16 bits.
A nivel arquitectónico, el modelo combina un LLM global de 8B parámetros para la estructura musical a largo plazo con un LLM local de 0,6B para los detalles acústicos a nivel de fotograma. Para la síntesis de audio se emplean Flow Matching y Flow-VAE. Esta división es fundamental porque generar canciones completas no consiste solo en producir buenos fragmentos de audio; el modelo debe mantener los temas, el ritmo, la identidad vocal y la progresión de los arreglos a lo largo de varios minutos.
Características principales y especificaciones
| Elemento | Detalles |
|---|---|
| Nombre del modelo | MiniMax-Music3 / MiniMax Music 3 |
| Uso principal | Generación de canciones basadas en letras, música vocal, música de fondo corta y generación instrumental |
| Entradas | Letra de la canción y descripción musical / etiqueta estructurada |
| Duración máxima | Hasta cinco minutos aproximadamente |
| Formato de salida | Estéreo WAV de 32 kHz y 16 bits |
| Etiquetas de estructura | [Intro], [Verse], [Pre-Chorus], [Chorus], [Bridge], [Instrumental], [Solo], [Outro] |
| Rutas de ejecución | SGLang-Omni, Diffusers, ComfyUI |
| Plataforma del modelo | Hugging Face y GitHub |
| Licencia | Licencia comunitaria de MiniMax-Music3 |
El flujo de trabajo gira en torno a dos entradas. La letra define las palabras que se van a cantar, mientras que la descripción musical define el género, subgénero, BPM, tonalidad, arco emocional, estilo vocal, instrumentación, arreglos y perfil de producción. Para un control más preciso, la ficha del modelo recomienda utilizar una descripción estructurada con metadatos globales, detalles vocales y arreglos.
Esta es una de las diferencias más útiles respecto a los generadores de música más simples. Un prompt flojo se limita a decir «canción pop alegre». Una descripción más completa especifica «dance pop, 124 BPM, voz femenina brillante, bajo de sintetizador con compresión side-chain, verso con punteos sutiles, estribillo con percusión amplia y armonías en capas, mezcla limpia lista para la radio». MiniMax-Music3 ofrece un marco para redactar ese nivel de detalle de forma explícita.
Experiencia práctica y calidad de los resultados
La forma más sencilla de comprender el modelo es visitar su página de demostración oficial. Incluye ejemplos de géneros como pop, rock, R&B, hip-hop, dance pop, country, soul, funk, blues, bossa nova y música urbana. Varios ejemplos emplean títulos en inglés, y también hay muestras en chino, lo que resulta muy útil para comprobar tanto la musicalidad general como la gestión de otros idiomas.
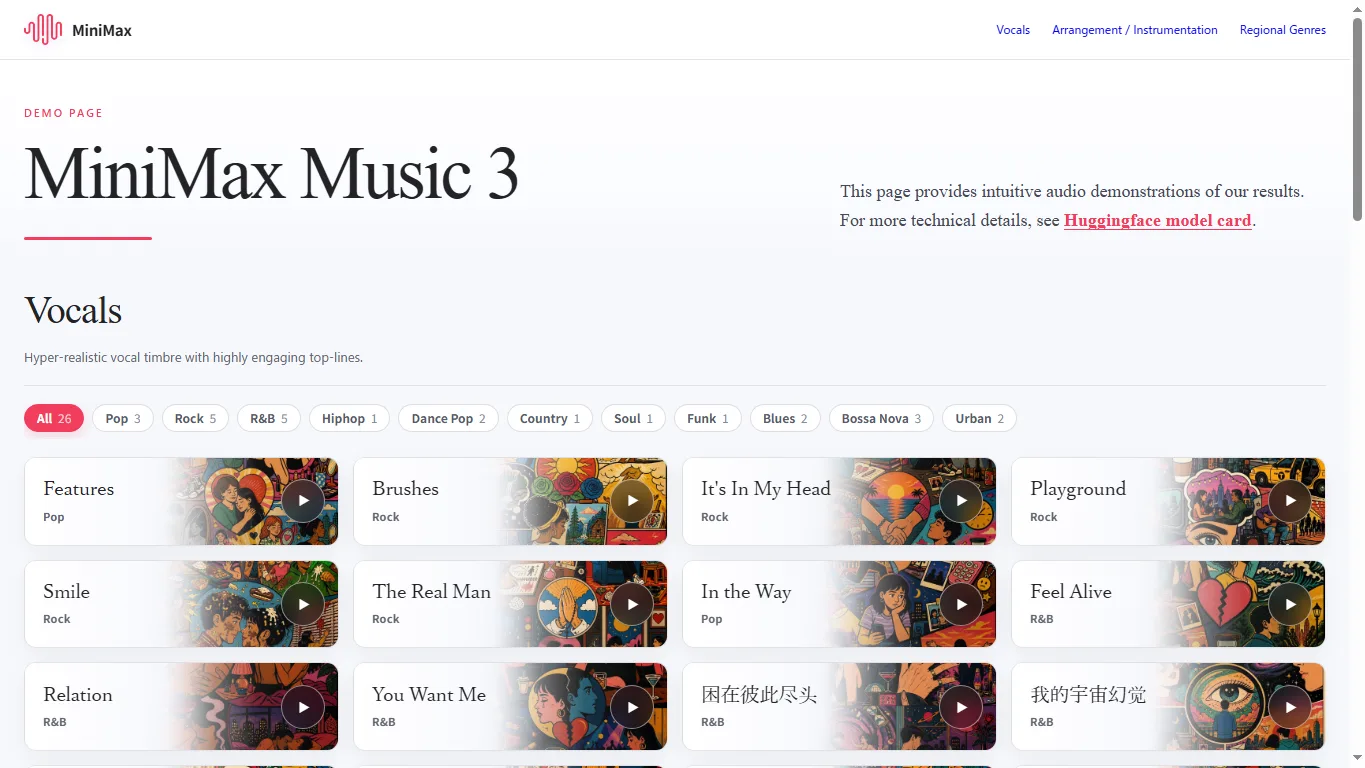
A la hora de escuchar las canciones generadas, conviene ir más allá del primer gancho. Es necesario comprobar si la transición del verso al estribillo resulta natural, si el timbre vocal se mantiene constante, si la letra se entiende con claridad, si los arreglos evolucionan con el tiempo y si la canción concluye de manera orgánica. Muchos sistemas de IA son capaces de crear un clip de 20 segundos impresionante; el verdadero reto es mantener la coherencia en una canción entera.
Las primeras impresiones de la comunidad son entusiastas pero realistas. En los debates de Hugging Face se valora positivamente el lanzamiento con pesos abiertos, al tiempo que se plantean dudas sobre la compatibilidad con ComfyUI, las configuraciones con poca VRAM, las licencias y la velocidad de generación. Esto dota al lanzamiento de un carácter muy definido: es un modelo impresionante y prometedor, pero orientado a usuarios dispuestos a probar, ajustar y leer la documentación, más que a un producto de consumo de un solo clic.
Descarga y configuración local
El modelo oficial está disponible en MiniMaxAI/MiniMax-Music3 en Hugging Face, y el repositorio del proyecto se encuentra en MiniMax-AI/MiniMax-Music3 en GitHub. Para realizar inferencias en un servidor, la ficha del modelo señala SGLang-Omni. Un comando de servidor básico tiene este aspecto:
sgl-omni serve --model-path MiniMaxAI/MiniMax-Music3 --port 8000Las solicitudes de generación utilizan el formato de punto final de voz compartido: la letra se introduce en input y la descripción musical en instructions. Esto es importante porque MiniMax-Music3 no es un modelo de conversión de texto a voz (TTS) con un locutor seleccionable. El resultado no se controla mediante un parámetro de voice; el género vocal, el timbre, el estilo interpretativo, las armonías y los efectos se describen directamente en la descripción.
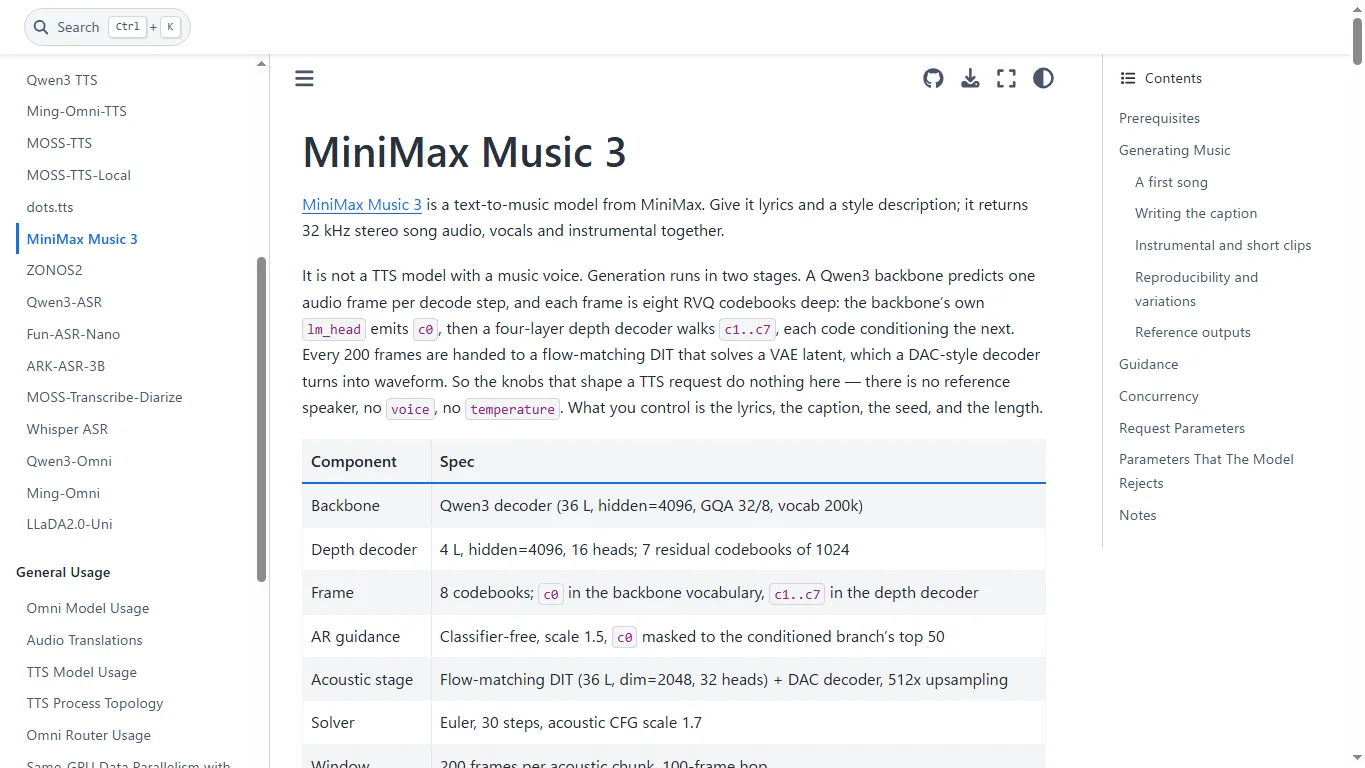
La compatibilidad con Diffusers también se documenta como una ruta ModularPipeline. En el momento de publicar la ficha del modelo, la instalación apunta al commit de una solicitud de extracción (PR) específica de Diffusers, por lo que conviene verificar si la compatibilidad total ya se ha integrado en la versión instalada antes de dar por sentado que basta con un comando estándar de pip.
Requisitos de VRAM y hardware
La ficha oficial del modelo ofrece una perspectiva de hardware sorprendentemente clara. La precisión completa cabe en menos de 24 GB de VRAM. Con la descarga automática a la CPU (offloading), la generación consume unos 22 GB. Mediante la transmisión por capas del modelo de lenguaje, el flujo de trabajo puede ejecutarse en tarjetas gráficas de 8 GB, aunque el proceso es más lento y debe considerarse una alternativa para equipos con recursos limitados más que un entorno de producción ideal.
| Configuración | Perspectiva práctica | Ideal para |
|---|---|---|
| GPU de 24 GB o más | La opción local más limpia; las tarjetas de la gama RTX 4090 son las más realistas para realizar pruebas | Usuarios de IA locales e investigadores |
| ~22 GB con descarga a CPU | Ahorra VRAM, pero puede reducir la velocidad | Usuarios con tarjetas ligeramente por debajo de los 24 GB |
| 8 GB con descarga por streaming | Es posible según la ficha del modelo, pero resulta mucho más lento | Pruebas breves y comprobaciones de viabilidad |
| Ruta de baja VRAM en ComfyUI | Los archivos de modelo INT8 y la decodificación por mosaicos facilitan la experimentación | Creadores que trabajan con nodos |
| GPU en la nube o API | Menos complicaciones de configuración y mayor facilidad para probar canciones largas | Equipos y evaluación de producción |
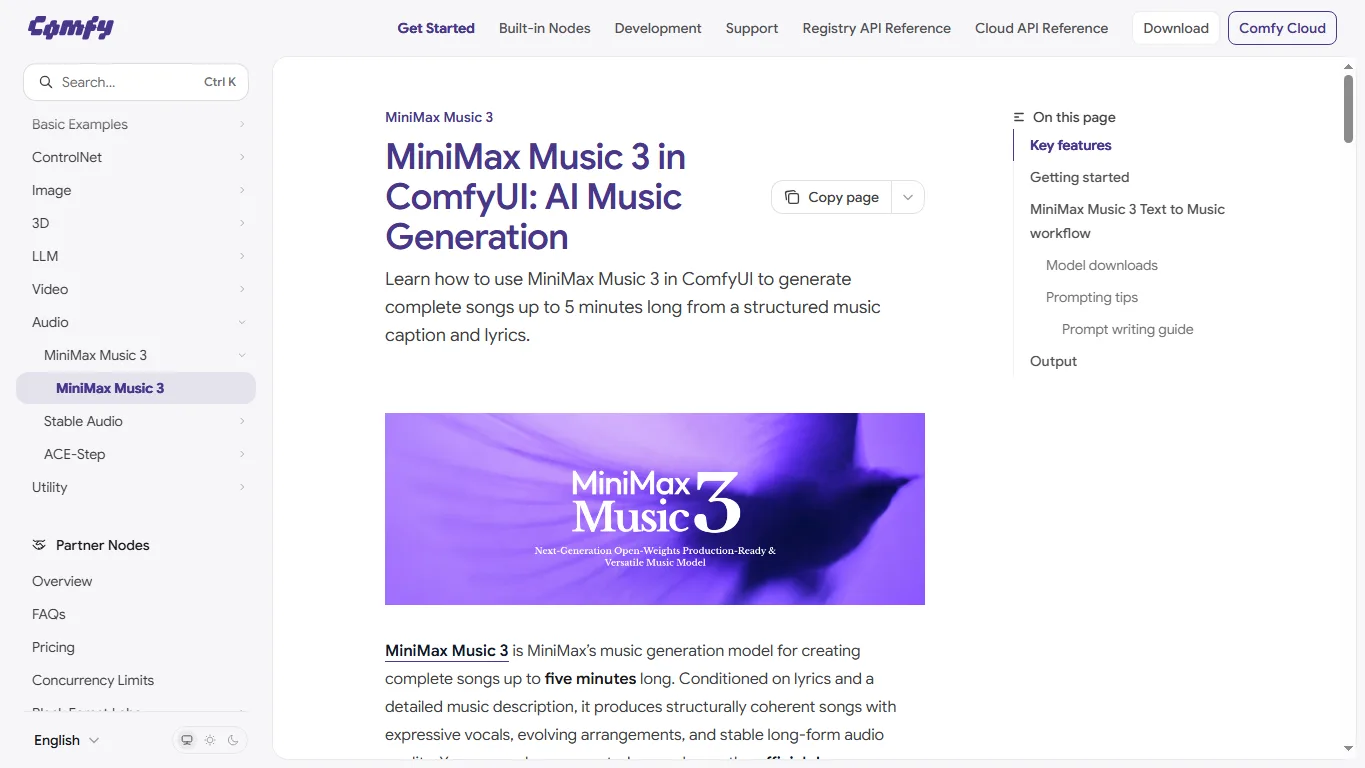
Para los usuarios de ComfyUI, el tutorial oficial de ComfyUI para MiniMax Music 3 constituye el punto de partida más práctico. En él se detallan los modelos de difusión en FP16 e INT8, un codificador de texto INT8, los archivos VAE, la ubicación de las carpetas, el flujo de trabajo de texto a música, consejos para redactar los prompts y la ruta de los archivos de salida.
Descargar el flujo de trabajo oficial para ComfyUI
Si deseas probar MiniMax-Music3 en ComfyUI, utiliza el archivo JSON del flujo de trabajo oficial de Comfy-Org: audio_minimax_music_3.json. Descarga el archivo, cárgalo en ComfyUI y podrás examinar directamente el flujo de trabajo de texto a música. Asegúrate de colocar los archivos de modelo necesarios en las carpetas correspondientes de ComfyUI antes de ejecutarlo.
El tutorial oficial de ComfyUI explica las descargas del modelo, los archivos INT8 para entornos con poca VRAM y los parámetros max_duration, seed y tiled_decode. Un enfoque práctico consiste en probar primero clips cortos, ajustar la descripción y la letra, y solo entonces renderizar una canción completa de entre tres y cinco minutos.
Comparativa con los principales modelos de música por IA
MiniMax-Music3 se sitúa en un punto intermedio entre los servicios comerciales de música por IA y los modelos de investigación locales. Las herramientas en línea como Suno, Udio y ElevenLabs Music son más fáciles de usar. Los modelos abiertos como Meta MusicGen, Stable Audio Open y YuE comparten una filosofía más cercana a la de MiniMax-Music3, aunque están orientados a diferentes necesidades de duración, control y flujos de trabajo.
| Modelo / Servicio | Tipo | Punto fuerte | Precaución |
|---|---|---|---|
| MiniMax-Music3 | Modelo de pesos abiertos | Hasta cinco minutos, letra y descripción detallada, compatibilidad con ComfyUI, SGLang y Diffusers | Requiere configuración, planificación de VRAM y revisión de licencias |
| Suno | Servicio en línea | Flujo de trabajo en el navegador muy sencillo y excelente experiencia de usuario | Sin control de modelos locales ni despliegue de pesos abiertos |
| Udio | Servicio en línea | Excelente para canciones vocales, edición y flujos de trabajo de ampliación | Los resultados y derechos de uso dependen de las condiciones del servicio |
| ElevenLabs Music | Servicio en línea / API | Muy adecuado para APIs de producción y flujos de trabajo de audio | No es un modelo local de pesos abiertos |
| Stable Audio Open | Modelo abierto | Útil para audio corto, efectos y elementos de fondo | Menos enfocado en canciones completas basadas en letras |
| Meta MusicGen | Modelo abierto | Base de investigación consolidada para la generación de música breve | Requiere un diseño de flujo de trabajo adicional para canciones vocales completas |
| YuE | Modelo abierto | Un punto de comparación relevante para la generación de canciones completas | La configuración y la calidad de salida dependen en gran medida del entorno y la versión |
Si el objetivo es publicar rápidamente una canción para redes sociales, Suno o Udio suelen ser opciones más sencillas. Si lo que buscas es poner a prueba estructuras de canciones largas, controlar las descripciones, gestionar las semillas (seeds), construir flujos de trabajo en ComfyUI o estudiar un modelo de música con pesos abiertos, MiniMax-Music3 resulta una alternativa mucho más interesante.
También vale la pena seguir de cerca la estrategia general de generación de MiniMax. El modelo de vídeo de la compañía se analiza en nuestro análisis de MiniMax H3, y las tendencias recientes en la generación de vídeo guardan relación con nuestro análisis de LTX-2.5. Music3 forma parte de esa misma evolución hacia una generación más prolongada, multimodal y compatible con flujos de trabajo avanzados.
Licencia, uso comercial y derechos de autor
MiniMax-Music3 utiliza la licencia comunitaria de MiniMax-Music3, y no una licencia permisiva simple de tipo MIT o Apache. Esta licencia incluye la atribución del producto comercial, un umbral de ingresos que puede requerir una autorización adicional, requisitos de seguridad para servicios alojados y una política de uso aceptable.
La generación de música también conlleva riesgos en materia de derechos de autor y gestión de derechos que van más allá de la licencia del modelo. La letra, la imitación de estilos de artistas, la similitud vocal, las normas de las plataformas de distribución y los requisitos de divulgación son aspectos fundamentales. Si tienes la intención de publicar o comercializar música generada por IA, guarda un registro de los prompts, la titularidad de las letras, la versión del modelo y cualquier edición realizada tras la generación.
Ejemplo de prompt
Un prompt práctico para MiniMax-Music3 separa la letra de la descripción musical. Para las canciones en inglés, redacta ambos apartados en ese idioma. En el caso de otros idiomas, puedes mantener la descripción musical en inglés si prefieres conseguir un control del estilo más estable.
[Verse] Morning light is breaking through the rain I keep walking past the places we became [Chorus] Hold on, we are brighter than the night Two hearts burning like a signal in the sky Music description: Emotional pop rock, 104 BPM, female lead vocal with airy harmonies, clean electric guitar in the verse, full drums and wide synth pads in the chorus, hopeful but nostalgic, radio-ready modern mix, gradual build to a final anthemic chorus.Para realizar iteraciones eficientes, es recomendable empezar con fragmentos de 30 a 60 segundos antes de renderizar la canción completa. Una vez que la voz, el tempo, la instrumentación y la energía del estribillo alcancen el resultado deseado, amplía la duración. Las generaciones largas consumen más tiempo y memoria, por lo que resulta esencial probar primero las descripciones.
Preguntas frecuentes
¿Es gratuito MiniMax-Music3?
Los pesos del modelo están disponibles en Hugging Face, pero el uso local conlleva costes de hardware, almacenamiento y tiempo de configuración. Si utilizas GPUs en la nube, inferencia alojada o una API, es posible que dichos servicios cuenten con sus propias tarifas.
¿Puede MiniMax-Music3 generar voces?
Sí. Está diseñado para generar voces y acompañamiento instrumental de forma simultánea. Las características de la voz se controlan mediante la descripción musical en lugar de un parámetro independiente de selección de locutor.
¿Puede ejecutarse en una GPU de 8 GB?
La ficha técnica oficial indica que puede caber en tarjetas gráficas de 8 GB mediante la descarga por streaming, aunque el proceso de generación será más lento. Para disfrutar de una experiencia local más fluida, resulta más realista emplear una GPU de la gama de 24 GB o un flujo de trabajo de baja VRAM en ComfyUI.
¿Es mejor que Suno o Udio?
No para todos los usuarios. Suno y Udio resultan más sencillos para la creación rápida en el navegador. MiniMax-Music3 resulta más atractivo si buscas acceso a los pesos abiertos, flujos de trabajo locales, integración con ComfyUI, reproducibilidad y un control más exhaustivo de las descripciones.
¿Se puede utilizar con fines comerciales?
Es posible, pero debes revisar detenidamente la licencia comunitaria. La atribución del producto, el volumen de ingresos, las medidas de seguridad y los derechos de terceros son aspectos clave. La distribución musical también añade consideraciones sobre derechos de autor y políticas de las plataformas.
¿Puede crear música instrumental?
Sí. Utiliza una descripción clara como «instrumental cinematic ambient, no vocals» (ambiente cinematográfico instrumental, sin voz) o «lofi background music, no vocal lead» (música de fondo lofi, sin voz principal) y prueba primero con duraciones más breves.
Referencias
- MiniMaxAI/MiniMax-Music3 – Hugging Face
- MiniMax-AI/MiniMax-Music3 – GitHub
- Demo de MiniMax Music 3
- MiniMax Music 3 en ComfyUI
- Guía de SGLang-Omni para MiniMax Music 3
- Licencia comunitaria de MiniMax-Music3
Resumen
MiniMax-Music3 representa uno de los lanzamientos de música por IA más relevantes porque se centra en canciones completas en lugar de limitarse a clips cortos. Su compatibilidad con letras, descripciones estructuradas, una duración de hasta cinco minutos, salida de audio estéreo en WAV y rutas para flujos de trabajo locales lo convierten en una herramienta especialmente valiosa para desarrolladores y creadores avanzados.
No obstante, no se trata de una aplicación de consumo inmediata. Los requisitos de hardware, los modos más lentos para baja VRAM, las licencias y la gestión de derechos de autor requieren atención. Para la mayoría de los lectores, el mejor enfoque consiste en escuchar la demo oficial, probar generaciones breves mediante ComfyUI o SGLang-Omni y, solo entonces, dar el salto a canciones más largas o flujos de trabajo comerciales.
Últimos Reseñas
Reseña de HiDream O1: IA de imagen, LoRA, uso local y política NSFW

5 mejores robots cortacésped en 2026

Los 5 mejores creadores de tarjetas de cumpleaños de 2026
YuE2-3B: música local con IA, Suno y ComfyUI
Los 5 mejores creadores de tarjetas de visita de 2026
Design.com vs. Canva: ¿qué creador de logotipos es mejor para desarrollar una marca completa?