Reseña de Nanosaur 2: qué puede hacer un modelo de ilustración de 670 M
Reseña práctica de Nanosaur 2: modelo de 670 M, instalación en ComfyUI, pruebas de velocidad, uso online, comparativas, evidencia NSFW, licencia y límites.

Actualizado el 12 de octubre de 2026
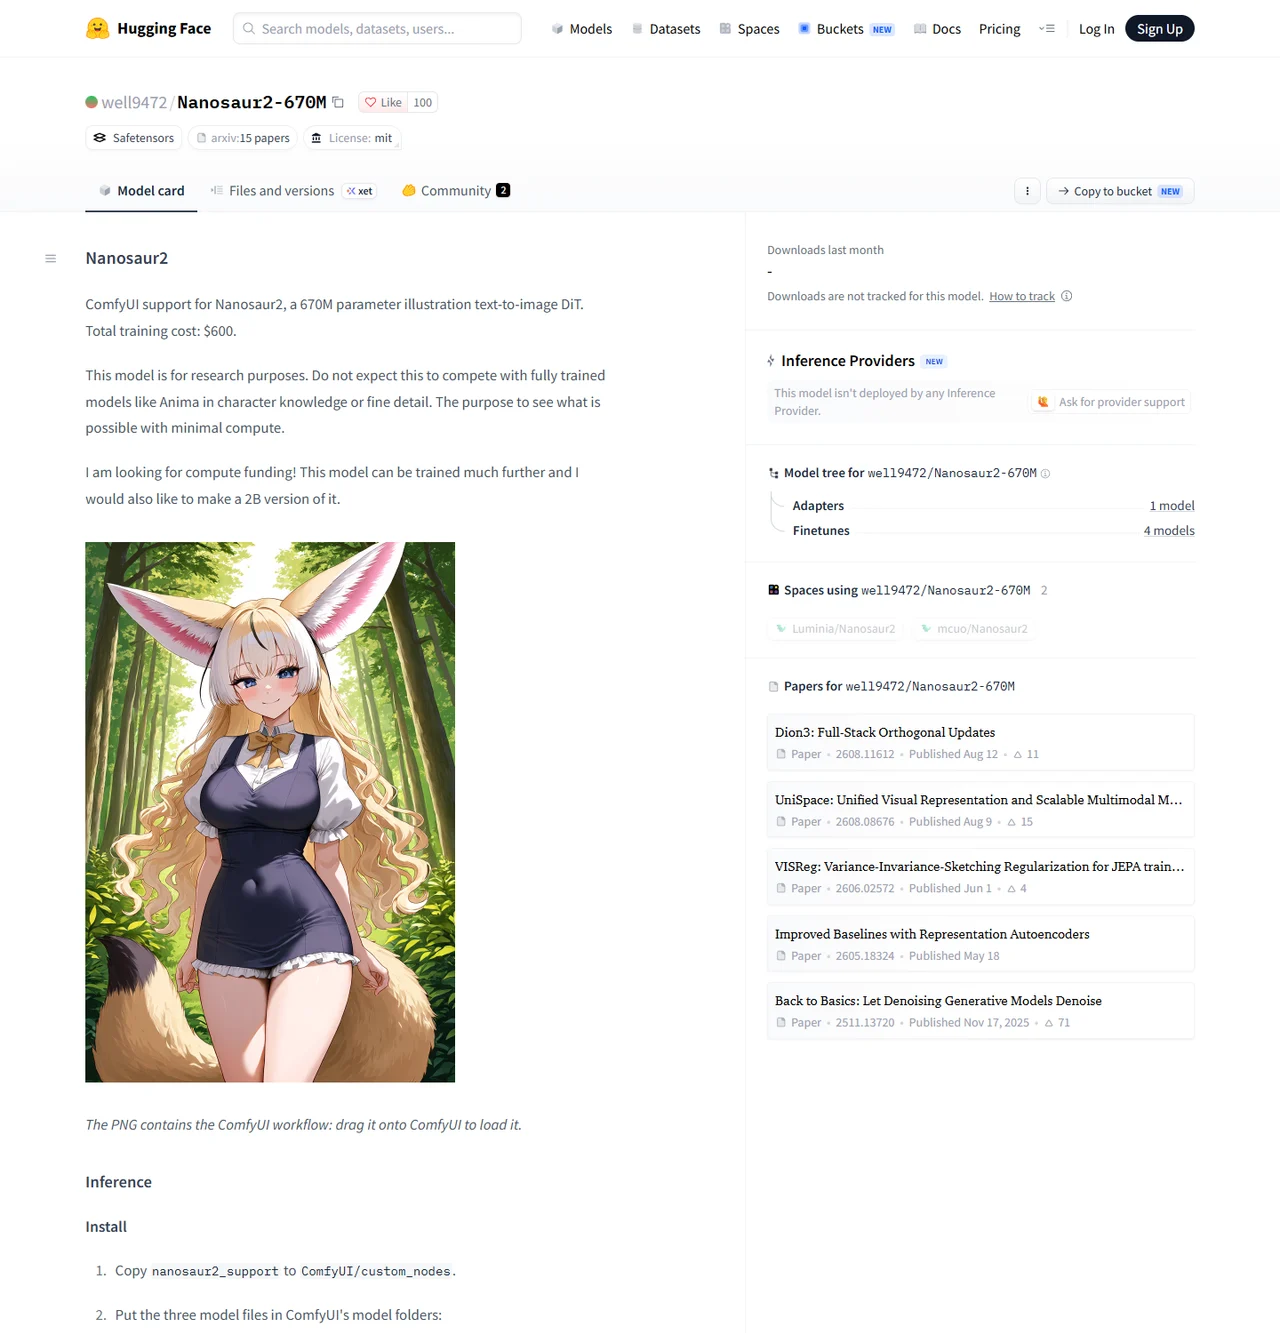
Nanosaur 2 es un modelo abierto de ilustración, inusualmente pequeño, creado para explorar cuánto puede lograr la generación de imágenes con pocos recursos. Su transformador de difusión tiene 670 M de parámetros y cuenta con un flujo de trabajo descargable para ComfyUI. Aun así, su responsable advierte que no debe esperarse el conocimiento de personajes ni el nivel de detalle de modelos maduros como Anima.
La pregunta útil no es si sustituye a un modelo grande, sino si su tamaño reducido, su flujo abierto y la posibilidad de entrenar LoRA lo convierten en un experimento local interesante. Las primeras pruebas de usuarios destacan los personajes y el bajo consumo, pero señalan fondos, anatomía y variedad entre semillas como puntos débiles.
Índice
- Veredicto rápido
- Qué es el modelo
- Instala primero el modelo base y después compara la versión de cuatro pasos
- Qué cuentan los primeros usuarios
- Comparación con otros modelos
- NSFW: disponibilidad, calidad y normas del servicio
- Descarga, acceso online y costes reales
- LoRA, inpainting y alternativas de VAE
- Para quién es
- Preguntas prácticas
- Conclusión
Veredicto rápido
| Dato | Información oficial |
|---|---|
| Modelo | DiT de ilustración de 670 M |
| Codificador de texto / VAE | Gemma 3 270M / VAE semántico DINOv2 (129M) |
| Base | Euler Simple, 50 pasos, CFG 4 |
| Coste de entrenamiento | Unos 600 US$, según el autor |
| Licencia / propósito | MIT; la ficha indica uso de investigación |
Merece la pena probarlo si buscas ejecutar, estudiar o ajustar localmente un modelo compacto de ilustración. La ficha oficial especifica un DiT de 670 M, un codificador Gemma 3 de 270 M, un VAE semántico de 129 M, cubos de aspecto de 1024 píxeles y una base Euler Simple de 50 pasos. El autor estima el coste de entrenamiento en unos 600 dólares.
Qué es el modelo
La ficha oficial de Hugging Face define Nanosaur2-670M como un DiT de texto a imagen para ilustración e investigación. Incluye un codificador Gemma 3 270M congelado y un VAE semántico basado en DINOv2. El responsable lo describe como un entrenamiento desde cero con bajo presupuesto y un conjunto de cuatro millones de ilustraciones.
Admite lenguaje natural y etiquetas. La receta recomendada es Euler Simple, 50 pasos, CFG 4 y cubos de aspecto de 1024 píxeles. La ficha sugiere etiquetas de calidad como “newest, masterpiece” y ponderar algunas etiquetas de artistas. Son puntos de partida, no una receta óptima para cualquier prompt.
Instala primero el modelo base y después compara la versión de cuatro pasos
Nanosaur 2 necesita su propio cargador, codificador de texto y VAE. No es un checkpoint de SDXL intercambiable. Guarda un flujo base limpio para distinguir un problema de instalación de una limitación del modelo.
- Descarga la carpeta completa nanosaur2_support y los tres componentes del repositorio del autor. Copia la carpeta en ComfyUI/custom_nodes, sin duplicarla dentro de otra del mismo nombre.
- Coloca cada archivo en el directorio de la tabla, reinicia ComfyUI e importa nanosaur2_workflow.json. El PNG original también puede contener el flujo; una copia recomprimida por una red social puede perderlo.
- Selecciona los archivos en Nanosaur2Loader y empieza con lote 1 y la resolución del ejemplo. Comprueba el flujo sin LoRAs ni ampliadores antes de añadir extensiones.
- Para acelerar, descarga el checkpoint DMAD separado y abre nanosaur2_dmad_4step_workflow.json. Reducir el modelo normal de 50 a 4 pasos no equivale a usar el modelo destilado.
| Archivo | Carpeta de ComfyUI |
|---|---|
| nanosaur2_diffusion_model.safetensors | models/diffusion_models |
| nanosaur2_text_encoder.safetensors | models/text_encoders |
| nanosaur2_vae.safetensors | models/vae |
| nanosaur2_support | custom_nodes |
nanosaur2_workflow.json · DMAD 4-step checkpoint · nanosaur2_dmad_4step_workflow.json
| Flujo | Muestreador / planificador | Pasos / CFG | Resolución inicial |
|---|---|---|---|
| Modelo base | Euler / simple | 50 / 4 | Formato de alrededor de 1024 píxeles |
| DMAD de cuatro pasos | LCM / simple | 4 / 1 | 832 × 1216 |
El JSON de cuatro pasos utiliza LCM / simple, 4 pasos, CFG 1, denoise 1 y 832 × 1216. El mismo condicionamiento positivo se conecta a las dos entradas del muestreador. Importa el gráfico completo: no copies el CFG 4 ni el esquema negativo del modelo base. La receta base es Euler / simple, 50 pasos y CFG 4; el desplazamiento 3 está integrado en la inferencia.
Una prueba de prompt fácil de repetir
Este es un ejemplo propuesto, no un resultado medido. Empieza con un sujeto, una acción y un fondo simple. El negativo corresponde al flujo base.
newest, masterpiece, an adult woman explorer in a blue jacket, standing beside a quiet forest lake, medium shot, soft morning light, simple background, illustrationoldest, low qualityCompara cuatro semillas fijas y revisa ojos, manos, ropa y bordes a tamaño real. Las etiquetas condensan atributos; el lenguaje natural explica mejor una acción. Si se ignora un prompt largo, elimina requisitos que compiten entre sí. La ponderación propia modifica el sesgo de atención cruzada, por lo que un peso de otro modelo puede comportarse de forma distinta.
Si el flujo no funciona
- No aparece Nanosaur2Loader: revisa los errores de inicio y la carpeta de nodos; reinicia.
- No aparece un archivo: verifica su nombre y directorio. No van los tres en checkpoints.
- Falta VRAM: empieza por lote 1 y menor resolución. El tamaño en disco no incluye todos los búferes de inferencia.
- Una extensión rompe el resultado: vuelve a los archivos y al gráfico base. Las versiones cuantizadas y de inpainting necesitan su integración específica.
Qué cuentan los primeros usuarios
En un hilo de septiembre de r/StableDiffusion, un usuario valoró los personajes para el tamaño del modelo, pero encontró fondos desordenados, composiciones repetidas y figuras secundarias poco logradas. Otro informó de unos 17 segundos por imagen a 50 pasos con una RTX 3070 de 8 GB. Es un resultado individual, no una prueba reproducible.
Pesos pequeños no garantizan funcionar con 2 GB
Los 670M solo cuentan el transformador de difusión. A dos bytes por parámetro, sus pesos serían aproximadamente 1,34 GB, sin el codificador de 270M, el VAE de 129M ni los búferes. Es una estimación de tamaño, no una medición de VRAM. La comunidad habla de tarjetas de 4–8 GB y de una RTX 3070 de 8 GB, pero no existe una tabla oficial de mínimos. En una GPU antigua también importan PyTorch y los tipos de datos compatibles.
La cifra de siete imágenes por segundo publicada el 5 de octubre corresponde a cuatro pasos en una RTX 5090. No determina el rendimiento de una GPU pequeña. El caudal continuo tampoco es el tiempo hasta la primera imagen, que puede incluir carga y compilación. Compara igual resolución, lote y estado de carga; menos pasos no garantizan idénticos detalles.
Reddit · 2026-09-26 · Reddit · 2026-10-05
Comparación con otros modelos
| Modelo | Uso recomendado | Qué respalda la evidencia |
|---|---|---|
| Nanosaur 2 (670M) | Experimentos locales y LoRA | DiT pequeño; el autor reconoce menos conocimiento y detalle que Anima |
| Anima 2.9B | Ilustración anime y personajes | Mayor; aquí no se probó cara a cara |
| SDXL | Generación general y amplio ecosistema | Ecosistema distinto; sin benchmark equivalente |
Anima-2.9B es una ampliación y ajuste de terceros sobre Anima de CircleStone Labs, con licencia no comercial propia. SDXL destaca como ecosistema de herramientas y LoRAs compatibles. Nanosaur tiene más sentido cuando pesan más el tamaño y la experimentación. Es una comparación por usos, no una clasificación medida.
NSFW: disponibilidad, calidad y normas del servicio
La presentación comunitaria lo llama uncensored, pero esa etiqueta no mide la calidad. La ficha del autor no incluye una prueba controlada de contenido adulto ni una especificación completa de moderación. Además, la cifra del conjunto de entrenamiento del anuncio no coincide con la ficha actual; para las especificaciones publicadas debe primar esta última.
En la práctica importan la fidelidad a una petición solo para adultos, la anatomía y la consistencia entre semillas. La evidencia no permite dar porcentajes fiables y las limitaciones habituales del modelo pueden mantenerse. Esta reseña no incluye una prueba NSFW controlada. Las reglas de una nube o galería siguen siendo independientes de la disponibilidad local.
Nanosaur2-670M · r/StableDiffusion
Descarga, acceso online y costes reales
Los pesos y flujos se descargan sin pagar por el modelo. No hay una tarifa oficial de suscripción o API. El coste local incluye hardware, electricidad y almacenamiento; una GPU alquilada añade descarga, tiempo inactivo y almacenamiento persistente. Los aproximadamente 600 USD de entrenamiento declarados por el autor no son un precio para el usuario.
El Space de terceros Luminia/Nanosaur2 estaba PAUSED el 12 de octubre de 2026. No es un servicio oficial permanente. Tampoco se verificó una API pública operada por el autor. La vía fiable es ComfyUI local o una máquina en la nube configurada por ti, sujeta a las normas del proveedor.
El repositorio base indica MIT y describe el proyecto como investigación. Respeta los avisos de licencia al redistribuir. La licencia no resuelve automáticamente derechos sobre imágenes de entrenamiento, personajes o resultados. Anima-2.9B tiene condiciones no comerciales distintas.
Nanosaur2-670M · Luminia/Nanosaur2 · INT8-ConvRot
LoRA, inpainting y alternativas de VAE
train_lora.py acepta una carpeta de imágenes con archivos .txt del mismo nombre y guarda el LoRA en models/loras. Se carga con LoraLoaderModelOnly. Entrenar requiere recursos distintos a generar: poder ejecutar inferencia no garantiza entrenar cómodamente.
Inpaint-ControlNet de levzalt es una extensión comunitaria para editar con máscara. Requiere sustituir todo nanosaur2_support por su versión, sin instalar copias duplicadas. Importa su flujo, añade imagen y máscara y utiliza dimensiones múltiplos de 16; el ejemplo usa 896 × 1152. No implica compatibilidad con cualquier ControlNet.
GAN-VAE es otra opción experimental. Su autor comunica mejoras modestas de reconstrucción en un conjunto pequeño utilizado también para seleccionar el checkpoint. No demuestra una mejora general. Compara los mismos latentes: cambiar el decodificador no corrige necesariamente un prompt mal interpretado o una anatomía incorrecta.
train_lora.py · Inpaint-ControlNet · GAN-VAE
uv run python custom_nodes/nanosaur2_support/train_lora.py /path/to/images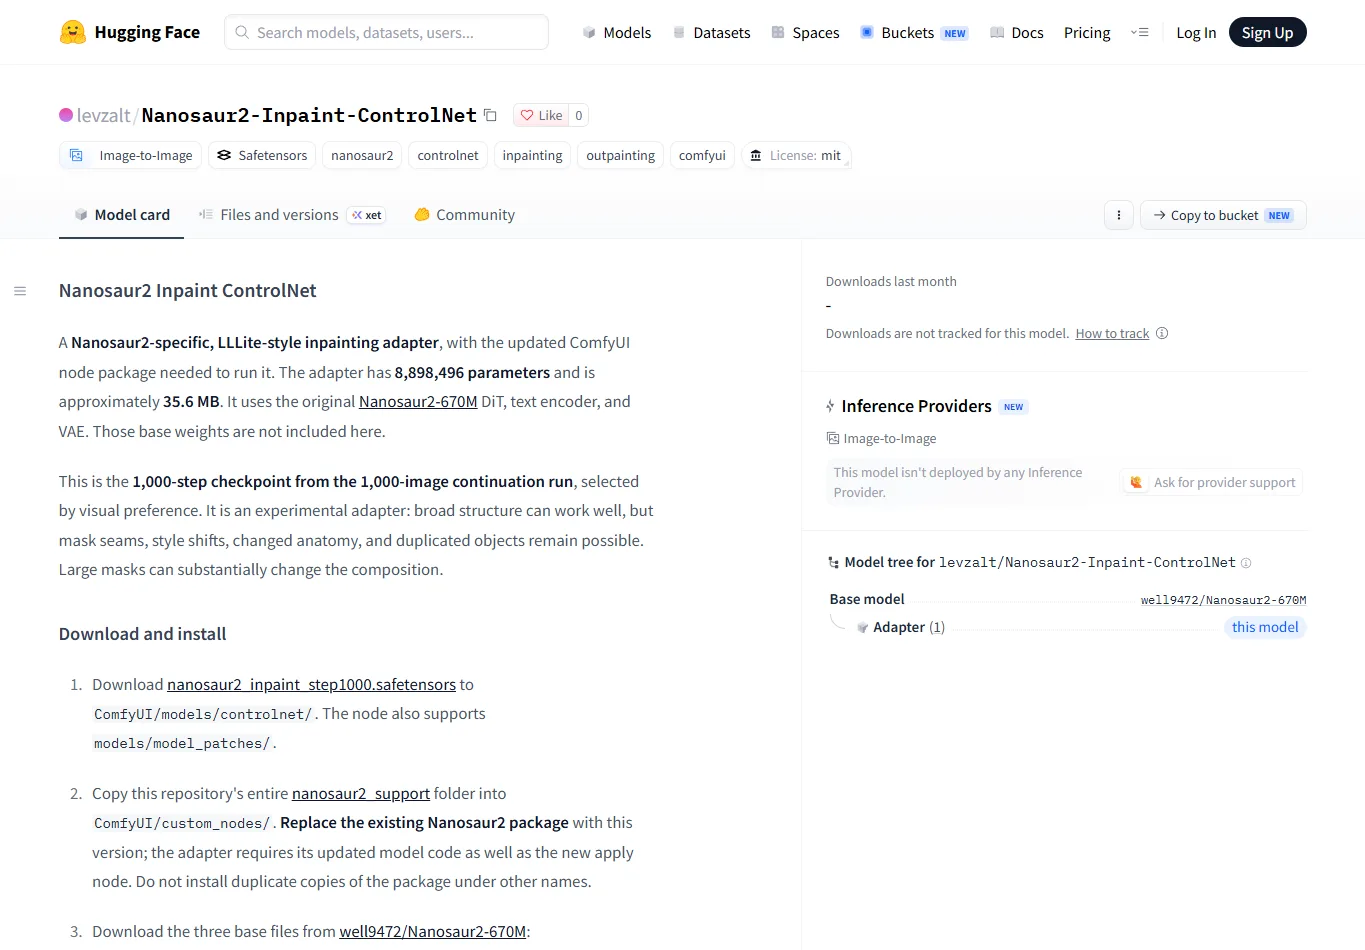
Para quién es
Pruébalo si tienes una GPU modesta, quieres aprender integración de modelos en ComfyUI, explorar arquitecturas pequeñas o entrenar una LoRA de estilo concreto. Los componentes y el flujo documentados permiten estudiar cómo funciona.
Para fondos detallados, varias personas coherentes, manos pulidas o seguimiento fiable de instrucciones complejas, elige un modelo de ilustración más maduro. Nanosaur 2 destaca como base experimental compacta y herramienta de bajo coste, no como sustituto listo para producción.
Preguntas prácticas
¿Es una versión de Nano Banana?
No. Nanosaur2-670M es un modelo independiente de ilustración. El nombre parecido no implica el mismo autor.
¿Qué versión instalo primero?
La base con su flujo original; después añade DMAD y su gráfico de cuatro pasos.
¿Sirven LoRAs de SDXL?
No se debe asumir compatibilidad. Utiliza pesos e integraciones específicos para Nanosaur.
¿Es bueno dibujando texto?
No es su especialidad y el anuncio comunitario lo reconoce. Añade los textos exactos posteriormente en un editor.
¿Hay una API online?
No se verificó una API oficial. El Space comunitario estaba pausado el 12 de octubre de 2026.
¿Obtendré siete imágenes por segundo?
No es una promesa para tu GPU. Mide resolución, lote y carga inicial comparables.
Conclusión
Ficha y descarga oficial en Hugging Face
Nanosaur 2 es un experimento de ilustración pequeño con un flujo real de ComfyUI, una configuración abierta y un coste de entrenamiento declarado muy bajo. Sus límites aparecen en la composición y el detalle, y faltan benchmarks independientes.
Si quieres aprender con un modelo reducido o probar una idea de LoRA, merece una ejecución local. Para imágenes pulidas y previsibles, recurre a un modelo maduro y deja Nanosaur 2 como proyecto de investigación.
Relacionados Reseñas
Análisis de Qwen Image Edit: Edición de texto, Inpainting, ComfyUI y política de NSFW

Análisis de FLUX 3: Image, Klein, edición, VRAM y licencia
Anima AI Model Review: Anime Image Model, LoRA, Licencia y Uso NSFW

Reseña de Z-Image: Turbo, Base, VRAM, LoRA y uso local sin censura (NSFW)
Análisis de MiniMax-Music3: modelo de IA musical de pesos abiertos para canciones de 5 minutos
Análisis de Seedream 5.0 Pro: modelo de imagen de inteligencia artificial, acceso por API y política sobre contenido NSFW