MiniMax M3.1 Flash: análisis de código, precios, pesos y límites
Analizamos MiniMax M3.1 Flash: MoE 428B/23B, programación y agentes, precios de API, razonamiento, GPU necesarias, licencia comercial y fiabilidad.

Actualizado el 23 de octubre de 2026
MiniMax M3.1 Flash merece una prueba si ejecutas muchas tareas de programación o agentes y necesitas controlar su coste. Combina una API barata, un contexto de un millón de tokens y pesos descargables. Sus límites más relevantes son el razonamiento siempre activo, las respuestas factuales demasiado confiadas y una infraestructura local considerable.
Nuestro criterio: candidato para desarrollo y automatización con revisión de resultados. Compáralo por trabajos correctos y aceptados, reintentos y coste total. Ni los 23B parámetros activos ni el enorme tráfico de Space Bunny demuestran que vaya a resolver mejor tu repositorio.
Qué ofrece realmente M3.1 Flash
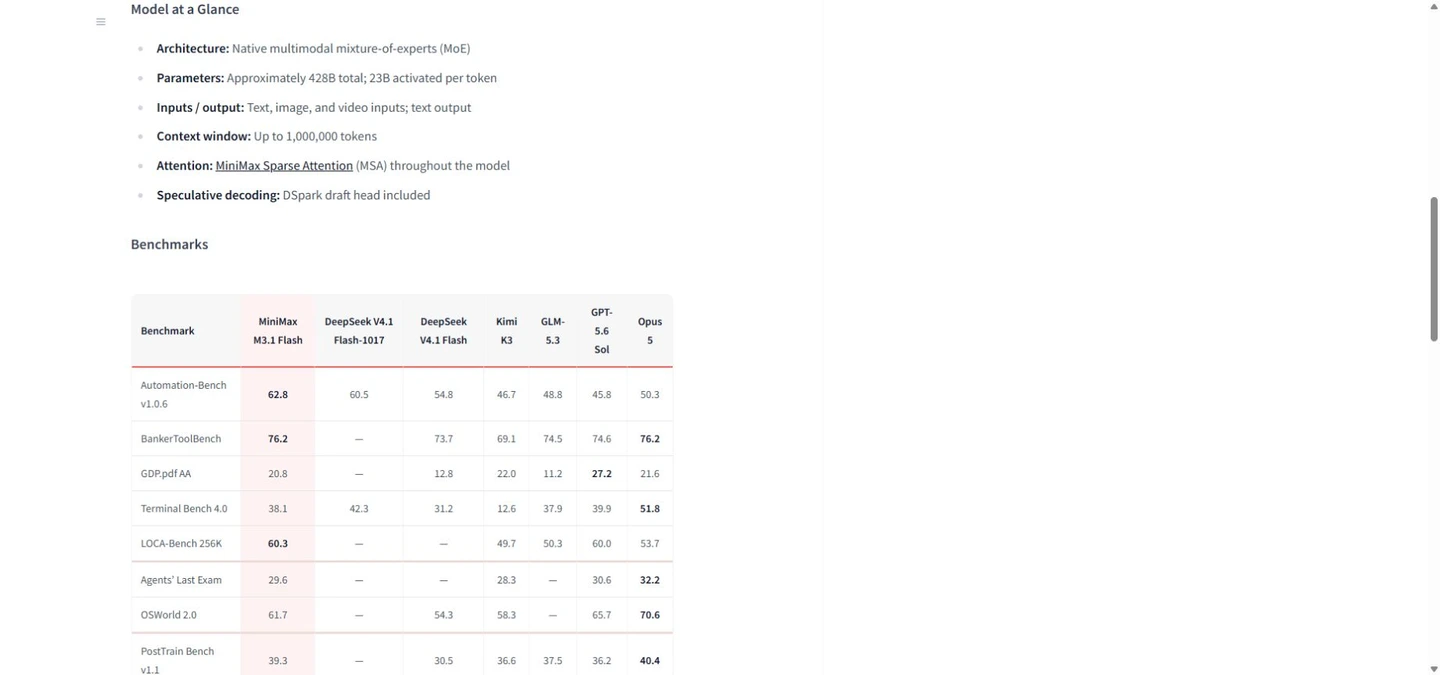
El servicio alojado llegó el 19 de octubre y los pesos el 23. La MiniMax M3.1 Flash — Hugging Face describe un MoE multimodal nativo con unos 428.000 millones de parámetros totales y 23.000 millones activados por token. Acepta texto, imágenes y vídeo; devuelve texto. No es MiniMax H3 ni un generador nativo de vídeo, imagen o voz.
Mantiene la familia M3, con atención dispersa en todas las capas, entrenamiento consciente de la cuantización y una cabeza de borrador DSpark para decodificación especulativa. Activar menos expertos reduce cálculo, pero no elimina los demás pesos. El número de parámetros activos no equivale a la memoria necesaria para guardar y servir el modelo.
| Especificación | Versión actual |
|---|---|
| Arquitectura | 428B totales / 23B activos por token; MoE |
| Contexto / salida máxima | Alojado: 1.000.000 / 524.288 tokens; sujeto a presupuesto |
| Entrada → salida | Texto, imágenes, vídeo → texto |
| Razonamiento | Siempre activo; low / medium / high / xhigh / max |
| Pesos / licencia | Descargables; MiniMax Community License |
Pesos abiertos y condiciones comerciales
Los archivos ya se pueden descargar. Su MiniMax Community License es MiniMax Community License, no MIT ni Apache. El uso comercial exige mostrar “Built with MiniMax M3.1-Flash”. Los productos o servicios que superen 20 millones de dólares estadounidenses de ingresos anuales necesitan autorización previa por escrito; por debajo del umbral se exige el aviso único indicado.
Existen usos prohibidos y condiciones también para uso no comercial. La definición comercial incluye API y modelos ajustados. Conviene describirlo como pesos abiertos con condiciones, sin prometer software abierto sin restricciones. Los términos del servicio alojado o de la suscripción son independientes de esta licencia de pesos.
Qué significan las cifras de 72 horas y 106 billones
El anuncio original de OpenCode separa 12 días consecutivos en primera posición y 106 billones de tokens —106 trillion en inglés— de una nueva promoción gratuita de tres días. OpenRouter comunica 56,7 billones y diez días en primera posición, seguidos de 72 horas gratis. Son plataformas y periodos distintos.
MiniMax — M3.1 Flash atribuye más de 200 billones de tokens al periodo anónimo de una versión temprana. Eso no demuestra que el modelo final procesara 100 billones en 72 horas. El uso agregado puede incluir entrada, salida, contexto repetido y muchos usuarios simultáneos: refleja adopción, no velocidad individual ni calidad independiente. Consulta el plazo y la cuota actuales del proveedor; la promoción no garantiza gratuidad permanente.
Resultados: automatización fuerte, liderazgo desigual en código
La ficha del 23 de octubre publica 62,8 en Automation-Bench v1.0.6, 73,7 en DeepSWE v1.1 y 38,1 en Terminal Bench 4.0. Algunas noticias iniciales citaban 62,2 en Automation-Bench. Usamos la ficha actual y marcamos estos resultados como pruebas del fabricante, no mediciones propias.
MiniMax supera a los modelos seleccionados en esa fila de automatización; DeepSeek V4.1 Flash-1017 lo supera en DeepSWE, Terminal Bench y NL2Repo, y Opus 5 mantiene una ventaja mayor en Terminal Bench. DeepSWE emplea mini-SWE-agent 2.4.5 con 512K de contexto; Terminal Bench usa Codex 0.149.1. Cambiar herramientas, versión del test o presupuesto puede alterar el resultado.
| Prueba (fabricante) | M3.1 Flash | DeepSeek V4.1 Flash-1017 | Opus 5 |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 | 50.3 |
| DeepSWE v1.1 | 73.7 | 77.0 | 74.0 |
| Terminal Bench 4.0 | 38.1 | 42.3 | 51.8 |
| NL2Repo-Bench | 61.2 | 68.2 | 75.3 |
| BankerToolBench | 76.2 | — | 76.2 |
| CyberGym | 82.2 | — | — |
| BabyVision (with tools) | 91.0 | 92.5 | 94.1 |
Comparación de la ficha oficial actual. Un guion significa que no se publica un resultado, no cero; BabyVision usa herramientas.
MiniMax anuncia más de 200 tokens/s de salida y una mediana superior a 170; la página de Artificial Analysis mostraba 92,5 al comprobarla. Son mediciones de servicio distintas, no una comparación controlada. El rendimiento de salida no incluye toda la espera por entrada, razonamiento, herramientas y reintentos. Mide el tiempo hasta un resultado útil con tu contexto y concurrencia.
Programación y agentes: tareas que sí conviene probar
Reproducir un fallo desde registros, implementar una función acotada, conciliar una hoja de cálculo con documentos y mantener datos coherentes entre herramientas son buenos puntos de partida. MiniMax Code — M3.1 Flash muestra, entre otros casos, el diagnóstico de una interfaz de soporte lenta. Es una demostración del proveedor, no una mejora garantizada para cualquier aplicación.
Entrega el repositorio, pasos de reproducción, pruebas que fallen y restricciones sobre datos e interfaces. Pide diagnóstico con evidencias, cambio mínimo y resultados reales de las pruebas. El modelo necesita un programa anfitrión que ejecute las herramientas; no obtiene por sí solo acceso al ordenador o a sistemas empresariales. Limita los permisos de escritura y revisa las acciones externas.
Imágenes, vídeo y contexto de un millón de tokens
Una captura permite describir un error visual y un vídeo puede mostrar una secuencia de interacciones. La salida sigue siendo texto. Los gráficos, presentaciones o escenas Three.js dependen de código y herramientas, no de generación nativa de medios. No se anuncia entrada o salida de audio para estos pesos.
El contexto alojado admite hasta 1.000.000 de tokens y la referencia de API permite un máximo de 524.288 tokens generados, sujeto a los presupuestos del contexto y la solicitud. No es una configuración recomendable para toda llamada. Archivos, imágenes, historial y razonamiento consumen recursos. Un contexto grande no asegura recordar cada detalle: empieza con archivos relevantes y exige ubicaciones de origen para las afirmaciones. No se especifica claramente una fecha de corte del conocimiento en los materiales revisados.
Razonamiento e integración de API
MiniMax API ofrece low, medium, high, xhigh y max; max es el valor predeterminado y no se puede desactivar el razonamiento. Anthropic compatible utiliza output_config.effort; OpenAI Chat Completions, reasoning_effort; Responses, reasoning.effort. Un cliente que elimine campos desconocidos puede cambiar el comportamiento esperado. none y disabled no son modos admitidos.
Conserva los mensajes completos del asistente y los identificadores de herramientas al continuar la conversación, tal como indica MiniMax Tool Use. Separa reasoning_content del texto final y contempla que algunas respuestas de herramientas no incluyan razonamiento. Valida el JSON y su esquema: admitir response_format no garantiza cumplimiento estricto. Prueba medium para trabajo habitual y compara high/max en los fallos difíciles, con límites de salida, turnos y reintentos.
Precio de API y coste por resultado aceptado
Las tarifas oficiales por millón de tokens son US$0,15 de entrada sin caché, US$0,60 de salida y US$0,015 de entrada en caché. Un millón de entrada y 100.000 de salida cuestan US$0,21; con toda la entrada elegible como acierto de caché, US$0,075. Son cálculos del modelo, sin herramientas, alojamiento, impuestos ni reintentos. La caché no está garantizada y los importes no son precios fijos en euros.
Incluye el razonamiento facturable y divide el gasto entre resultados aceptados. Diez llamadas baratas pueden costar más que una solución correcta al primer intento. El 70% de ahorro del proveedor se refiere a tareas bajo sus condiciones, no a todas las tarifas por token. M Plan, MiniMax Code y los endpoints gratuitos externos tienen sus propias cuotas, fechas y condiciones.
| Categoría de tokens | US$ por millón |
|---|---|
| Entrada sin caché | 0.15 |
| Salida | 0.60 |
| Entrada en caché | 0.015 |
Instalación local: requisitos reales
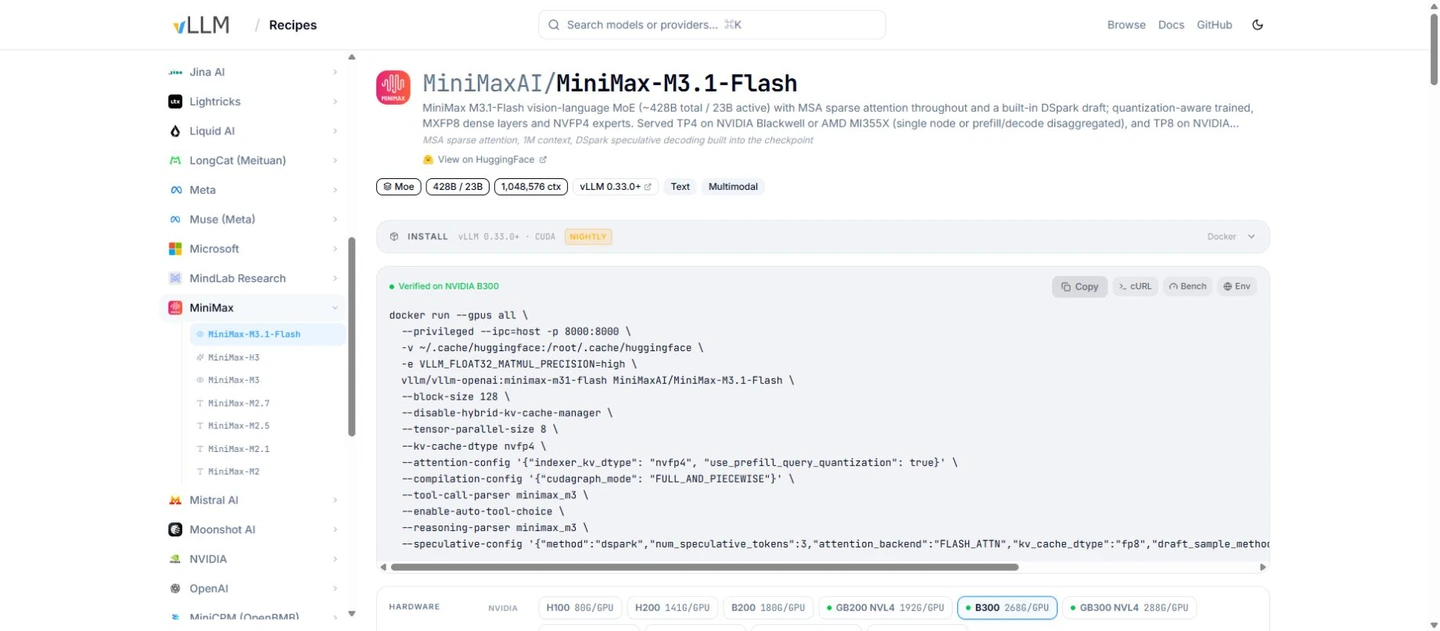
La distribución mezcla rutas MXFP8 y expertos MoE NVFP4; no es un archivo BF16 convencional. La suma de los 48 fragmentos principales safetensors del listado del 23 de octubre es de unos 250,1GB decimales, más unos 2,3GB de pesos DSpark y otros archivos. Es tamaño de descarga calculado, no consumo de VRAM medido. Los elementos U8 empaquetados tampoco equivalen al número lógico de parámetros.
vLLM documenta TP4 en sistemas Blackwell o AMD MI355X compatibles y TP8 en H100/H200. El ejemplo Hopper limita el contexto a 262.144, desactiva vídeo y no habilita DSpark. No todas las configuraciones locales heredan todas las funciones alojadas. Añade caché KV, visión, concurrencia y sobrecarga al presupuesto de memoria. No hay base para prometer el modelo completo en una sola GPU de 24/32GB. SGLang es otra ruta enlazada oficialmente; offload y cuantizaciones alternativas requieren pruebas propias.
Fiabilidad, español, NSFW y comentarios de usuarios
La página de Artificial Analysis mostraba 43 en Intelligence Index y unos US$0,22 por tarea de evaluación el 23 de octubre. Su evaluación de lanzamiento con esfuerzo max publicó 42, 56% de aciertos en AA-Omniscience y 93% de alucinaciones. Según AA-Omniscience, esa tasa divide las respuestas erróneas entre todas las no correctas, incluidas parciales y no intentadas. No significa que el 93% de todas las respuestas sean falsas; sí alerta de poca abstención cuando falta conocimiento.
Reddit — LocalLLaMA mezcla entusiasmo y dudas sobre tamaño y soporte de ejecución. Reddit — OpenCode recoge usuarios sorprendidos por el fin del acceso gratuito. Son experiencias aisladas. No hay resultados independientes equivalentes para los siete idiomas. En español, comprueba tratamiento formal, términos de España o Latinoamérica, nombres, fechas, decimales y comentarios de código con documentos reales. Idioma de respuesta no implica interfaz española, facturación local o acceso regional garantizado.
Los pesos abiertos no garantizan ausencia de filtros ni una capacidad NSFW fiable. Hay usos prohibidos y políticas separadas en los servicios alojados. Un endpoint en la nube tampoco procesa localmente: revisa retención, región y contrato antes de enviar repositorios confidenciales o datos de clientes.
Cómo compararlo antes de migrar
Prepara dos errores reales con pruebas fallidas, un diagnóstico visual, una conciliación de documentos y una pregunta sin respuesta en las fuentes aportadas. Mantén archivos, permisos, herramientas y tiempo iguales entre candidatos. Incluye una tarea en el español que usa tu equipo, no solo prompts traducidos de pruebas inglesas.
Prompt útil: “Reproduce el fallo y cita archivo y línea para cada diagnóstico. Aplica el cambio mínimo, ejecuta las pruebas pertinentes e informa de lo que siga fallando. Si falta un dato, indícalo en lugar de adivinar”. Registra entregables aceptados, reintentos, tokens de entrada/caché/razonamiento/salida y tiempo total. Es un protocolo propuesto, no una prueba ya ejecutada por AirMore.
Preguntas frecuentes
¿Es completamente de código abierto?
Los pesos son descargables, pero la Community License impone atribución comercial, aviso o autorización y restricciones de uso. Lee la licencia de esta versión; pesos abiertos con condiciones es una descripción más precisa.
¿Funciona en una GPU de 24GB?
El modelo oficial completo ocupa mucho más. Los 23B describen cálculo activo por token. Poder cargarlo con offload no demuestra velocidad útil, contexto largo o soporte multimodal completo.
¿Se puede quitar el razonamiento?
No. Reduce effort para intentar bajar latencia y tokens, usando el campo adecuado para el protocolo. none o disabled no son una modalidad sin razonamiento compatible.
¿Genera vídeos o voz?
Estos pesos reciben texto, imágenes y vídeo y devuelven texto. Las funciones multimedia de otros productos MiniMax o herramientas externas no son capacidades de salida nativas de este modelo.
¿La API es gratis para siempre?
Una promoción temporal no concede uso ilimitado permanente. Consulta el precio y la cuota vigentes; API de pago por uso, M Plan y pruebas de terceros son ofertas distintas.
¿Es mejor que DeepSeek o Claude?
Depende de la tarea. La tabla de MiniMax presenta ventajas en automatización y desventajas en varias pruebas de código. Compara entregables válidos con las mismas herramientas y reintentos.
Valoración y fuentes
M3.1 Flash tiene sentido como candidato económico para programación y agentes con contexto largo. Empieza con una prueba alojada, acotada y verificable; decide por exactitud, pruebas superadas y coste total. El alojamiento propio exige hardware, capacidad operativa y condiciones de licencia compatibles con el proyecto.
No cubre automáticamente las necesidades de un modelo pequeño de escritorio, generación multimedia nativa, esquemas estrictos o respuestas factuales sin verificación. Para creación visual, nuestra MiniMax H3 aborda otra categoría. Distinguir modelo y entorno de herramientas evita comprar o desplegar con expectativas equivocadas.
Fuentes comprobadas el 23 de octubre de 2026: MiniMax M3.1 Flash — Hugging Face, MiniMax Community License, MiniMax — M3.1 Flash, MiniMax API, MiniMax Tool Use, vLLM, SGLang, Artificial Analysis, Artificial Analysis — 2026-10-19, AA-Omniscience, OpenCode, OpenRouter y Reddit — LocalLLaMA. VentureBeat destaca la tensión entre costes y fiabilidad. Esta valoración se basa en documentación e información pública; no es una medición de GPU ni una competición de código ejecutada por AirMore.
Relacionados Reseñas
Gemini 4 Argon: análisis, precios, programación y límites NSFW

Reseña de GLM-5.3-Flash: Ox-Alpha, API, benchmarks y límites NSFW

Review de Ideogram 4.0: texto, ComfyUI, límites de censura y NSFW

Tsubaki.3: análisis, anime, manga, precios y NSFW (2026)
Review de Seedance 2.5: funciones, experiencia real y límites del modelo de vídeo IA
Los 10 mejores modelos de IA en 2026: ranking Arena, precios y usos