MiniMax-Music3 評測:支援 5 分鐘歌曲的開放權重 AI 音樂模型

MiniMax-Music3 是一款開放權重的 AI 音樂生成模型,可以透過歌詞和詳細的音樂描述,創作成品長度達約 5 分鐘的完整歌曲。它並非只聚焦於製作短暫的循環樂段或背景配樂,而是旨在呈現完整的歌曲架構:包含前奏、主歌、副歌、橋段、器樂間奏以及尾奏。
簡單來說:MiniMax-Music3 在免安裝、基於瀏覽器的休閒創作流暢度上,或許不及 Suno 或 Udio,但對於開發人員、ComfyUI 用戶、研究人員以及追求在地端工作流程的創作者來說,它吸引力十足。它最強大的地方在於長篇幅架構、歌詞結合提示詞的控制能力,以及針對 SGLang-Omni、Diffusers 和 ComfyUI 所提供的完整文件指引。
目錄
MiniMax-Music3 簡介
MiniMax-Music3 是由 MiniMax 推出的文字轉音樂模型。官方 Hugging Face 模型頁面將其描述為一款高效能的音樂生成模型,專為長達 5 分鐘的完整歌曲而設計,並以歌詞與詳細的音樂描述作為條件輸入。它能產出具備表現力的歌聲、不斷演進的編曲,以及 32 kHz、16 位元的立體聲 WAV 音訊。
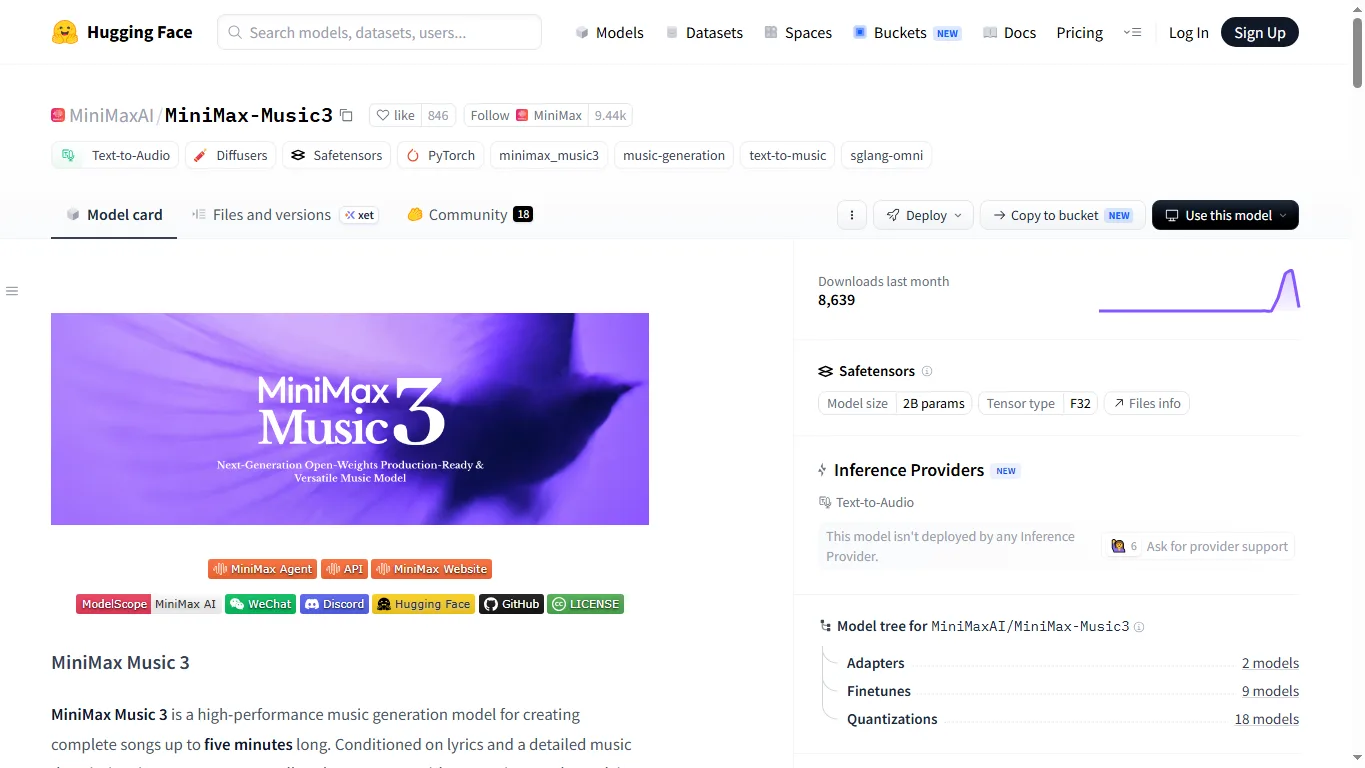
在架構上,該模型結合了用於長距離音樂架構的 8B Global LLM(全域大型語言模型),以及用於影格級(frame-level)聲學細節的 0.6B Local LLM(區域大型語言模型)。音訊合成則採用了 Flow Matching 與 Flow-VAE。這種拆分方式至關重要,因為生成一整首歌曲不只是產出悅耳的音訊影格而已;模型必須在長達數分鐘的時間內,維持主題、節奏、歌聲識別度以及編曲的推進感。
核心功能與規格
| 項目 | 詳細資訊 |
|---|---|
| 模型名稱 | MiniMax-Music3 / MiniMax Music 3 |
| 主要用途 | 基於歌詞的歌曲生成、人聲音樂、短版 BGM、器樂生成 |
| 輸入內容 | 歌詞加上音樂描述/結構化提示詞(Structured Caption) |
| 最大長度 | 最長約 5 分鐘 |
| 輸出格式 | 32 kHz、16 位元立體聲 WAV |
| 結構標籤 | [Intro]、[Verse]、[Pre-Chorus]、[Chorus]、[Bridge]、[Instrumental]、[Solo]、[Outro] |
| 執行路徑 | SGLang-Omni、Diffusers、ComfyUI |
| 模型託管 | Hugging Face 與 GitHub |
| 授權條款 | MiniMax-Music3 社群授權(Community License) |
這套工作流程環繞著兩種輸入方式。歌詞決定了要演唱的字句,而音樂描述則定義了曲風、次流派、BPM、調性、情感曲線、人聲風格、樂器配置、編曲以及製作質感。為了達到更精確的控制,模型卡片建議使用包含全域後設資料(Global Metadata)、人聲細節(Vocal Details)與編曲(Arrangement)的結構化提示詞(Structured Caption)。
這是它與較簡單的音樂生成器最實用的區別之一。陽春的提示詞可能只寫「節奏輕快的流行歌」。而更強效的提示詞則會寫:「舞曲流行,124 BPM,明亮的女聲,側鏈壓縮合成器貝斯,主歌帶有稀疏的撥弦聲,副歌搭配寬廣的鼓組與多層次合聲,具備乾淨、適合電台播放的混音品質」。MiniMax-Music3 提供了一個框架,讓你能明確寫出這些細節。
實際體驗與輸出品質
理解該模型最快的方式就是透過官方展示頁面。其中包含了橫跨流行、搖滾、R&B、嘻哈、舞曲流行、鄉村、靈魂樂、放克、藍調、巴薩諾瓦(Bossa Nova)和都會等曲風的範例。有幾個範例使用英文歌名,同時也有中文範例,這使得展示頁面在檢視其廣泛的音樂性與非英語處理能力時相當實用。
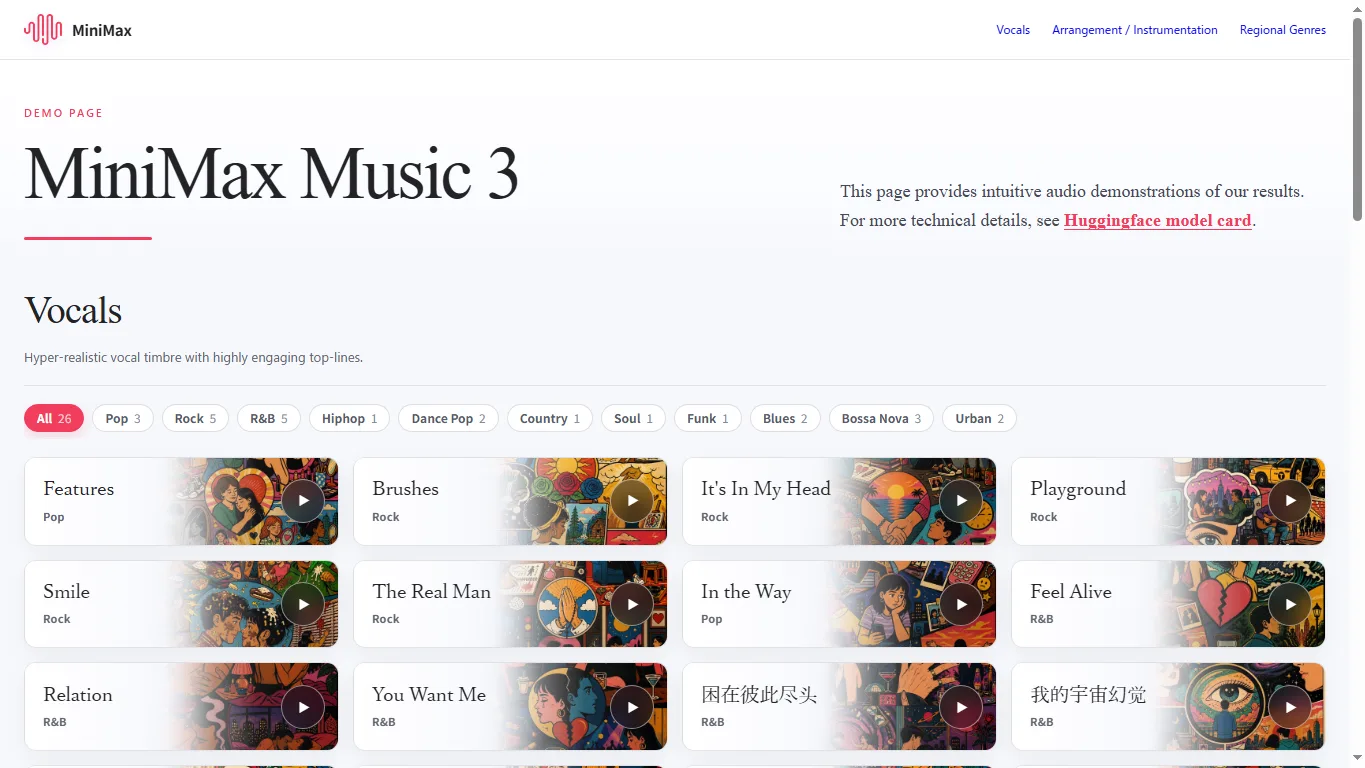
在聆聽生成的歌曲時,評判標準不應只看第一個主旋律(Hook)。請檢查主歌到副歌的轉場是否自然流暢、人聲音色是否保持一致、歌詞是否清晰易懂、編曲是否隨著時間推移而豐富,以及歌曲結尾是否自然。許多 AI 音樂系統都能做出令人驚豔的 20 秒片段;真正的挑戰在於維持整首歌曲的連貫性。
早期的社群回饋熱烈且務實。Hugging Face 上的討論包括對開放權重發布的讚賞、關於 ComfyUI 支援、低 VRAM 設定、授權以及生成速度的提問。這賦予了這次發布非常鮮明的特質:令人驚豔且充滿潛力,但它依然是一個需要使用者親自測試、調整並閱讀文件的模型,而非一鍵即可使用的消費級產品。
Download and Local Setup
官方模型可在 Hugging Face 上的 MiniMaxAI/MiniMax-Music3 取得,專案儲存庫則位於 GitHub 上的 MiniMax-AI/MiniMax-Music3。若是伺服器式的推論,模型卡片指向了 SGLang-Omni。最基本的服務啟動指令如下:
sgl-omni serve --model-path MiniMaxAI/MiniMax-Music3 --port 8000生成請求會使用共用的語音端點格式:歌詞放入 input 中,音樂提示詞則放入 instructions 中。這點相當重要,因為 MiniMax-Music3 並不是一個具備可選發音人(Speaker)的 TTS 模型。你無法透過 voice 參數來控制結果,而是要在提示詞中描述人聲性別、音色、演唱風格、合聲以及效果器。
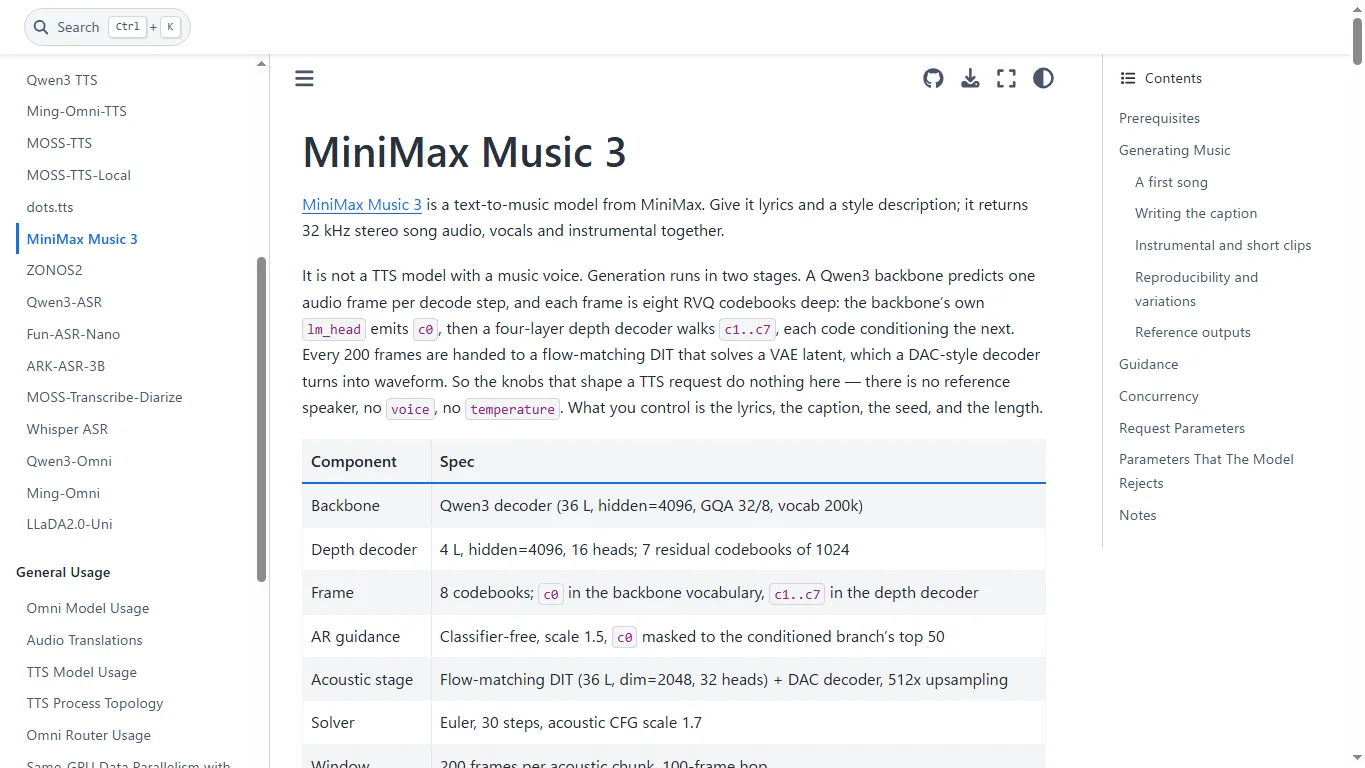
Diffusers 的支援也被記錄為 ModularPipeline 路徑。在撰寫模型卡片時,安裝步驟指向了一個特定的 Diffusers PR Commit,因此在假設透過標準 pip 安裝就足夠之前,請先確認完整的支援是否已合併至你安裝的 Diffusers 版本中。
VRAM 與硬體需求
官方模型卡片提供了相當清晰的硬體輪廓。完整精度(Full precision)可在 24GB 的 VRAM 以下運行。透過自動 CPU 卸載(CPU offloading),生成過程大約需要 22GB。透過針對語言模型的逐層串流卸載(layer-by-layer streaming offload),該管線可以在 8GB 的顯示卡上運行,但速度較慢,將其視為低 VRAM 的備用方案會比作為理想的生產環境設定更為合適。
| 設定 | 實務觀點 | 最適合對象 |
|---|---|---|
| 24GB+ GPU | 最乾淨的地端路徑;RTX 4090 等級的顯示卡在測試時更切合實際 | 地端 AI 用戶與研究人員 |
| 約 22GB 搭配 CPU 卸載 | 節省 VRAM,但可能會降低速度 | VRAM 略低於 24GB 的用戶 |
| 8GB 搭配串流卸載 | 根據模型卡片所述可行,但速度慢得多 | 短暫測試與可行性評估 |
| ComfyUI 低 VRAM 路徑 | INT8 模型檔案與分塊解碼(tiled decode)能讓實驗更輕鬆 | 基於節點(Node-based)的創作者 |
| 雲端 GPU 或 API | 減少設定上的痛苦,且更便於進行長歌曲測試 | 團隊與生產環境評估 |
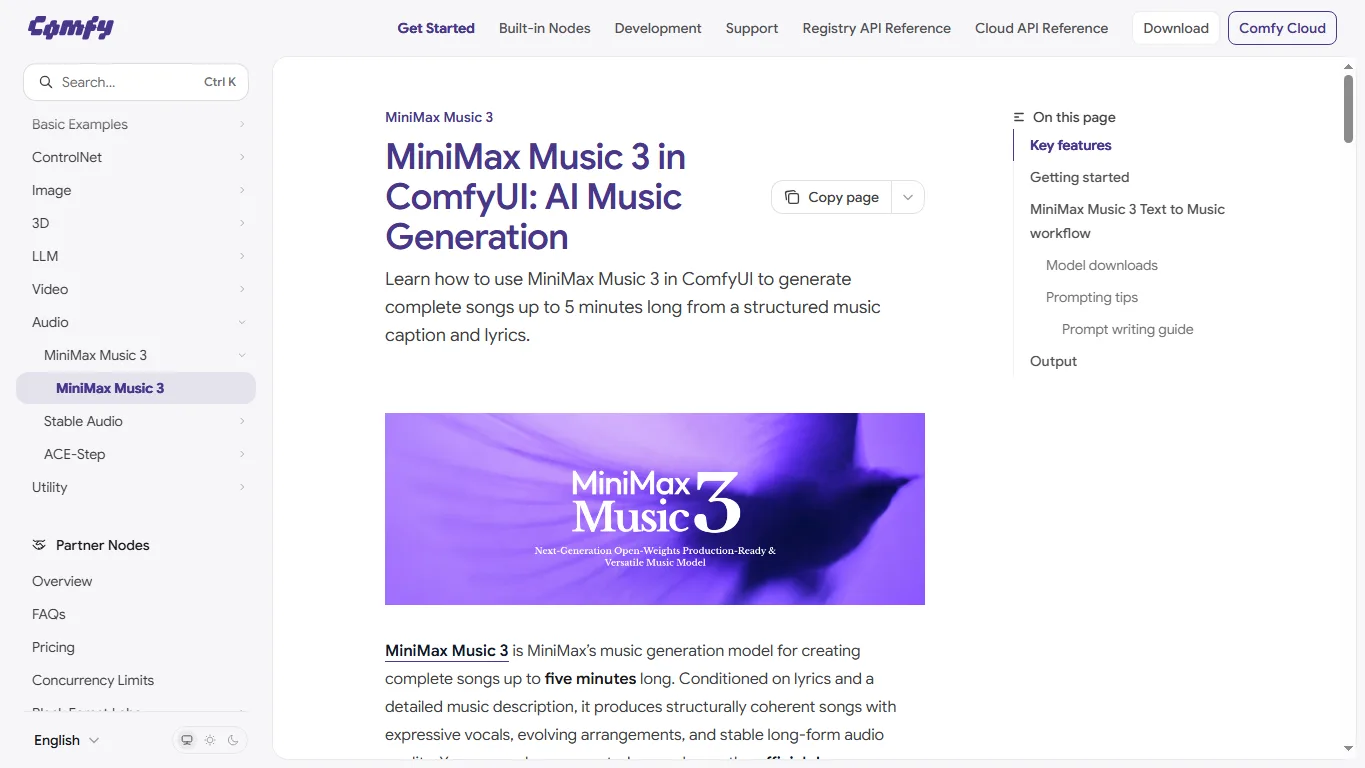
對於 ComfyUI 用戶來說,官方 ComfyUI MiniMax Music 3 教學 是最實用的起點。其中列出了 FP16 與 INT8 擴散模型、INT8 文字編碼器、VAE 檔案、資料夾放置位置、文字轉音樂工作流程、提示詞撰寫技巧以及輸出位置。
下載官方 ComfyUI 工作流程
如果你想在 ComfyUI 中測試 MiniMax-Music3,請使用官方的 Comfy-Org 工作流程 JSON:audio_minimax_music_3.json。下載該檔案並載入至 ComfyUI 中,即可直接檢視文字轉音樂(Text to Music)工作流程。在執行之前,請確保所需的模型檔案已放置在正確的 ComfyUI 資料夾中。
官方 ComfyUI 教學詳細說明了模型下載、低 VRAM INT8 檔案、max_duration(最大時長)、seed(種子碼)與 tiled_decode(分塊解碼)設定。一個務實的做法是先測試短片段,調整提示詞與歌詞後,再著手渲染完整的 3 到 5 分鐘歌曲。
主流 AI 音樂模型比較
MiniMax-Music3 介於消費級 AI 音樂服務與地端研究模型之間。像是 Suno、Udio 和 ElevenLabs Music 等線上工具使用起來更為簡單。而 Meta MusicGen、Stable Audio Open 和 YuE 等開源模型在精神上較接近 MiniMax-Music3,但它們各自鎖定了不同的時長、控制與工作流程需求。
| 模型/服務 | 類型 | 優勢 | 注意事項 |
|---|---|---|---|
| MiniMax-Music3 | 開放權重模型 | 最長 5 分鐘、歌詞 + 詳細提示詞、支援 ComfyUI/SGLang/Diffusers 路徑 | 需要自行設定、規劃 VRAM 以及審視授權 |
| Suno | 線上服務 | 極為簡單的瀏覽器工作流程與出色的消費體驗 | 無地端模型控制權或開放權重部署 |
| Udio | 線上服務 | 在人聲歌曲、編輯與延伸工作流程表現強勢 | 結果與使用權利取決於服務條款 |
| ElevenLabs Music | 線上/API 服務 | 非常適合用於生產環境 API 與音訊工作流程 | 並非地端開放權重模型 |
| Stable Audio Open | 開源模型 | 適用於短音訊、效果器與背景元素 | 較少專注於完整的歌詞歌曲 |
| Meta MusicGen | 開源模型 | 針對短音樂生成的成熟研究基準 | 若要製作完整人聲歌曲,需要額外的工作流程設計 |
| YuE | 開源模型 | 完整歌曲生成的相關比較對象 | 設定與輸出品質高度取決於執行環境與版本 |
如果你的目標是快速發布一首社群媒體歌曲,Suno 或 Udio 通常會更輕鬆。但如果你的目標是測試長篇幅歌曲架構、控制提示詞、管理種子碼、建立 ComfyUI 工作流程,或是研究開放權重的音樂模型,MiniMax-Music3 則是更有趣的選擇。
MiniMax 更廣泛的生成發展方向也值得關注。該公司的影片模型已在我們的 MiniMax H3 評測中介紹過,而近期影片生成的趨勢也與我們的 LTX-2.5 評測息息相關。Music3 感覺就像是朝著更長、多模態且對工作流程友善之生成發展趨勢的其中一部分。
授權、商業使用與版權
MiniMax-Music3 採用的是 MiniMax-Music3 社群授權(Community License),而非單純的 MIT 或 Apache 風格之寬鬆授權。該授權包含了商業產品署名要求、可能需要額外授權的營收門檻、託管服務的安全要求,以及可接受使用政策。
除了模型授權之外,音樂生成也伴隨著版權與權利管理的風險。歌詞、歌手風格模仿、人聲相似度、發行平台規則以及揭露要求等都相當重要。如果你計畫發布或販售生成的音樂,請妥善保留提示詞、歌詞所有權、模型版本以及生成後所進行任何編輯的紀錄。
提示詞範例
實用的 MiniMax-Music3 提示詞會將歌詞與音樂描述分開。對於英文歌曲,兩者皆以英文撰寫即可。若是其他語言,如果能讓風格控制更穩定,你依然可以將音樂描述保持為英文。
[Verse] Morning light is breaking through the rain I keep walking past the places we became [Chorus] Hold on, we are brighter than the night Two hearts burning like a signal in the sky Music description: Emotional pop rock, 104 BPM, female lead vocal with airy harmonies, clean electric guitar in the verse, full drums and wide synth pads in the chorus, hopeful but nostalgic, radio-ready modern mix, gradual build to a final anthemic chorus.為了進行有效率的迭代,建議在渲染完整歌曲前,先從 30 到 60 秒的片段開始測試。一旦人聲、速度、樂器配置與副歌能量都達到理想狀態,再拉長時長。長篇幅的生成在時間與記憶體上的成本較高,因此提示詞(Caption)的測試至關重要。
常見問題
MiniMax-Music3 是免費的嗎?
模型權重可在 Hugging Face 上取得,但地端使用仍需付出硬體、儲存空間與設定時間的成本。如果你使用雲端 GPU、託管推論或 API,這些服務可能會收取各自的費用。
MiniMax-Music3 可以生成人聲嗎?
可以。它旨在同時生成人聲與器樂伴奏。人聲的特色是透過音樂描述來控制,而不是透過獨立的發音人選擇參數。
它能在 8GB 的 GPU 上運行嗎?
官方模型卡片指出,透過串流卸載,它可以在 8GB 的顯示卡上運行,但生成速度會較慢。為了獲得更流暢的地端體驗,24GB 等級的 GPU 或 ComfyUI 低 VRAM 工作流程會更切合實際。
它比 Suno 或 Udio 更好嗎?
對每位用戶而言未必如此。Suno 和 Udio 在快速的瀏覽器創作上更為便利。如果你想要獲得開放權重存取、地端工作流程、ComfyUI 整合、可重現性以及更深度的提示詞控制,MiniMax-Music3 會更具吸引力。
我可以將其用於商業用途嗎?
有可能,但你必須仔細審視社群授權條款。產品署名、營收規模、安全防護以及第三方權利都是關鍵考量。音樂發行同時也伴隨著版權與平台政策的考量。
它能製作純音樂(Instrumental)嗎?
可以。請使用明確的提示詞,例如「instrumental cinematic ambient, no vocals」或「lofi background music, no vocal lead」,並優先測試較短的時長。
References
- MiniMaxAI/MiniMax-Music3 – Hugging Face
- MiniMax-AI/MiniMax-Music3 – GitHub
- MiniMax Music 3 Demo
- MiniMax Music 3 in ComfyUI
- SGLang-Omni MiniMax Music 3 cookbook
- MiniMax-Music3 Community License
Summary
MiniMax-Music3 是近年來相當重要的 AI 音樂發表之一,因為它的目標是完整的歌曲,而不僅僅是短片段。它對歌詞、結構化提示詞、5 分鐘時長、立體聲 WAV 輸出以及地端工作流程路徑的支援,使其對開發人員和進階創作者而言特別具有價值。
不過,它並非一款免安裝的消費級應用程式。硬體需求、較慢的低 VRAM 模式、授權以及版權管理等都需要特別留意。對多數讀者而言,最佳的路徑是先聆聽官方展示、透過 ComfyUI 或 SGLang-Omni 測試短片段生成,然後再投入長歌曲創作或商業工作流程。
相關 評測
Gemma 4 評測:本機部署、GPU 需求與 NSFW 政策

NovelAI V5 評測|NSFW 支援、提示詞、價格與使用限制
DeepSeek V4 評測:Flash、Pro、本機部署、Vision 與 NSFW 政策
Z-Image 評測|Turbo、Base、VRAM、LoRA 與本機使用重點
Grok 4.6 評測:xAI 推理模型、Agent、價格與 NSFW 政策

NoobAI XL 評測|導入、V-Pred、LoRA、NSFW、商用利用與 VRAM