Claude Fable 5.1/Mythos 5.1 評測【2026】:價格、API、NSFW 與 GPT/Gemini 比較
比較 Claude Fable 5.1 與 Mythos 5.1 的官方規格、Pro/Max 額度、API 價格、升級重點、媒體與用戶體驗、NSFW 政策,以及 GPT、Gemini 替代選擇。

當困難專案反覆修改的成本,高於模型本身的使用費時,Claude Fable 5.1 最值得考慮。 程式碼庫調查、大幅度改稿,以及多步驟文件工作,都比日常短問答更能發揮它的價值。Mythos 5.1 則是供通過審核的組織使用的專業選項,並非一般消費者能購買的 Fable 升級方案。
購買前要留意:Pro 的一般訂閱額度不包含 Fable 用量,Max 也不是無限使用。先選一個負擔得起的常用模型,再把難題交給 Fable,通常比追求 Mythos 使用資格更實際。
Fable 5.1 與 Mythos 5.1:你實際上買到什麼?
兩者於 2026 年 9 月 1 日發表,採用相同的底層模型,但有不同的安全措施。Fable 是廣泛提供的版本;Mythos 則允許經核准的組織,處理受到額外資安及生命科學限制影響的工作。官方發表。
本評測以 2026 年 9 月 11 日為基準,整合官方規格與註明來源的第三方體驗。編輯部並未進行自行控制條件的模型基準測試,也沒有取得 Mythos 權限來做直接比較。
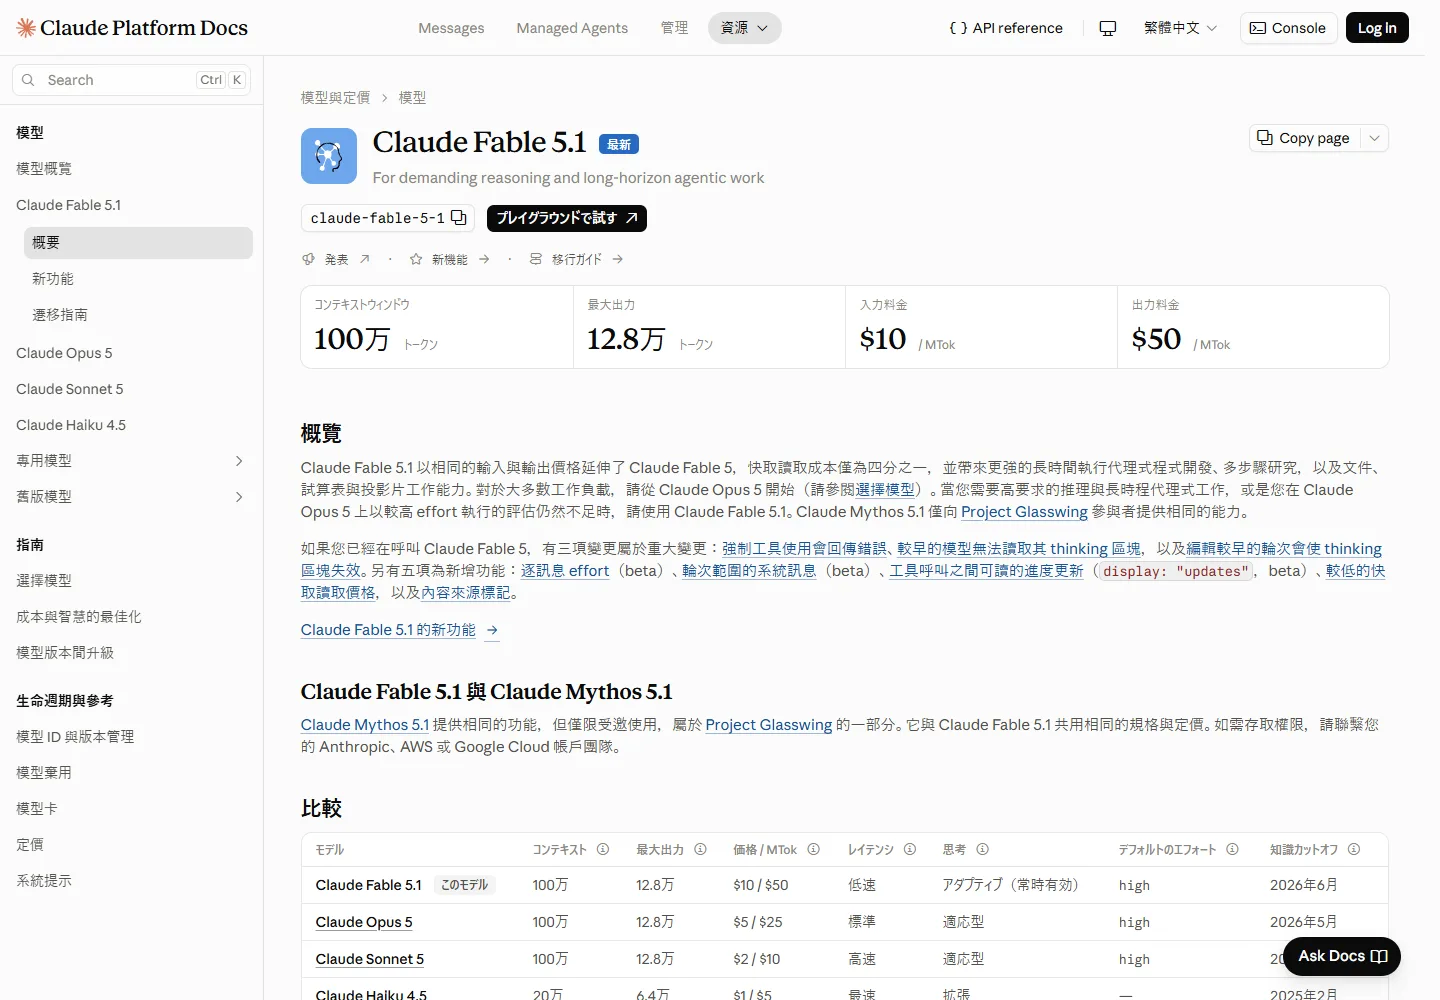
| 規格 | Claude Fable 5.1 |
|---|---|
| 官方 API 模型 ID | claude-fable-5-1 |
| API 上下文視窗 | 100 萬 tokens |
| API 最大輸出 | 128,000 tokens |
| 輸入與輸出 | 輸入文字及圖片;輸出文字 |
| 思考功能 | Adaptive thinking,持續啟用 |
| 可靠知識截止時間 | 2026 年 6 月 |
| 定位 | 高難度推理及長時間代理工作 |
上述是 API 規格,不代表每個 Claude 應用程式或訂閱都提供完整的 API 上下文容量。容量大也不等於完美記憶:研究結果仍須能追溯來源,程式修改仍須驗證。文字輸出可以包含用來製作圖表或文件的程式碼,但這不代表 Fable 是原生圖片生成模型。
官方線上使用入口與 API 提供網站
一般使用者可開啟 Claude,在欲使用的付費帳號中檢查模型選單與用量設定。官方 Claude Platform 提供 API 與測試介面。聊天訂閱與開發者 API 分開計費,購買其中一項不代表獲得另一項的使用點數。
| 使用管道 | 入口 | 需要確認的條件 |
|---|---|---|
| Claude 網頁/App | claude.ai | 付費方案、Fable 使用點數或符合資格的內含額度 |
| Anthropic API | Claude Platform | 模型 ID claude-fable-5-1、帳務及組織限制 |
| 雲端平台 | 官方平台連結 | Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry 的地區及合約條件 |
| 第三方統一 API | OpenRouter Fable 5.1 | ID anthropic/claude-fable-5.1、供應商、隱私及帳戶費用 |
| Mythos 5.1 | Anthropic 使用資格說明 | 須符合可信任存取計畫,沒有一般公開註冊的同等入口 |
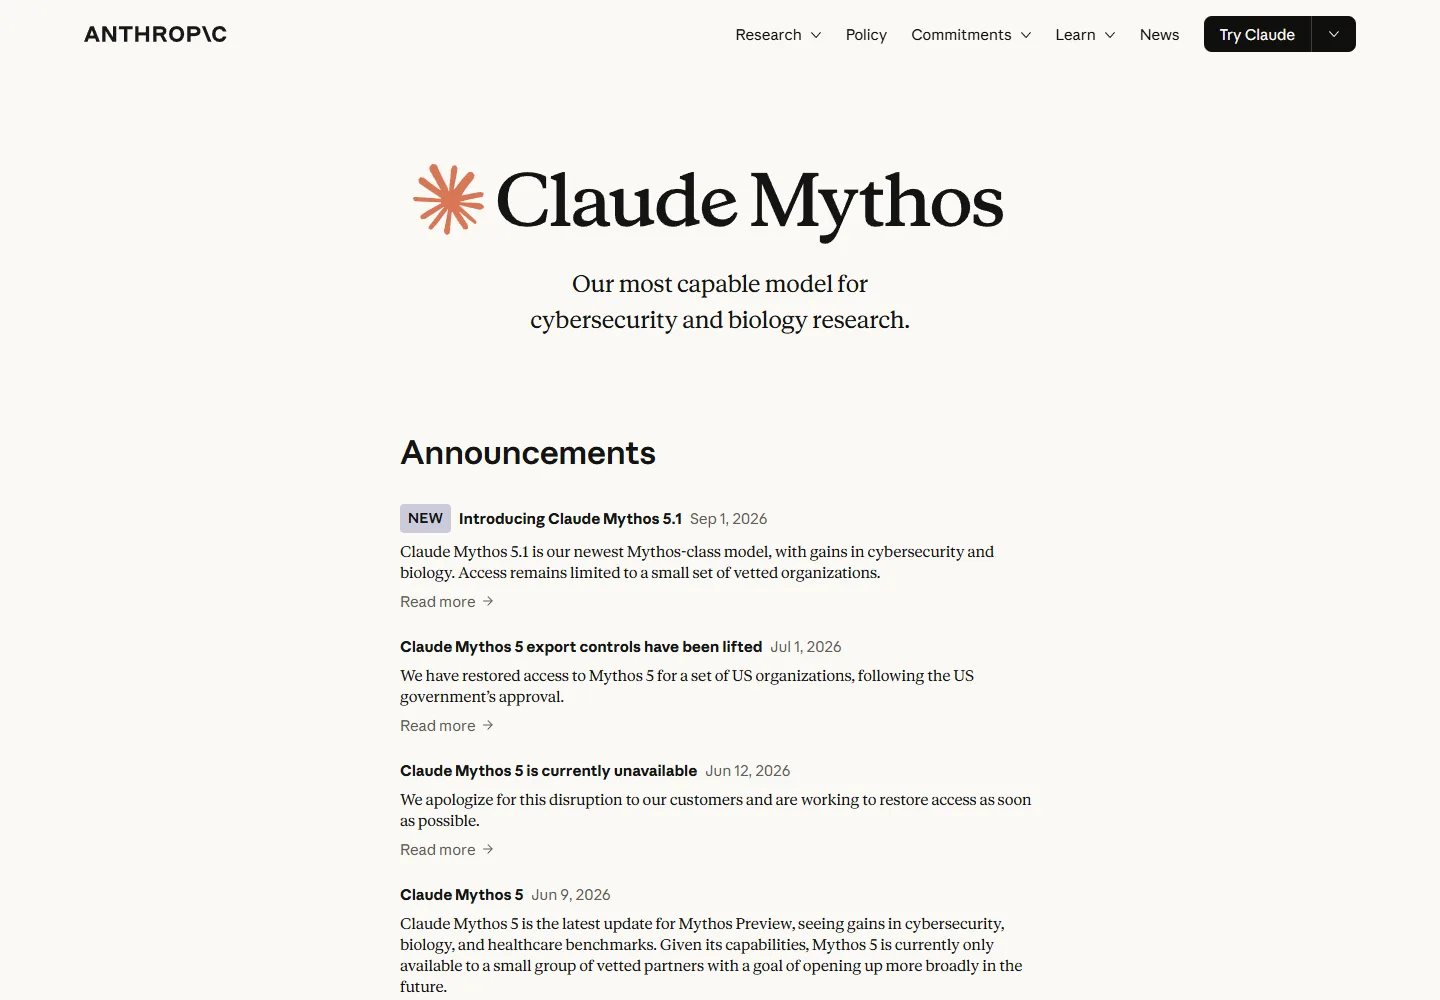
Mythos 官方頁面目前將對象限制為部分美國組織。生命科學方案是邀請制測試;透過 Cyber Verification Program 提供 Mythos 則列為近期規畫。能申請不代表已獲得權限。公布的起始 API 價格為每百萬 tokens 輸入 10 美元、輸出 50 美元,但價格公開不會取消資格限制。
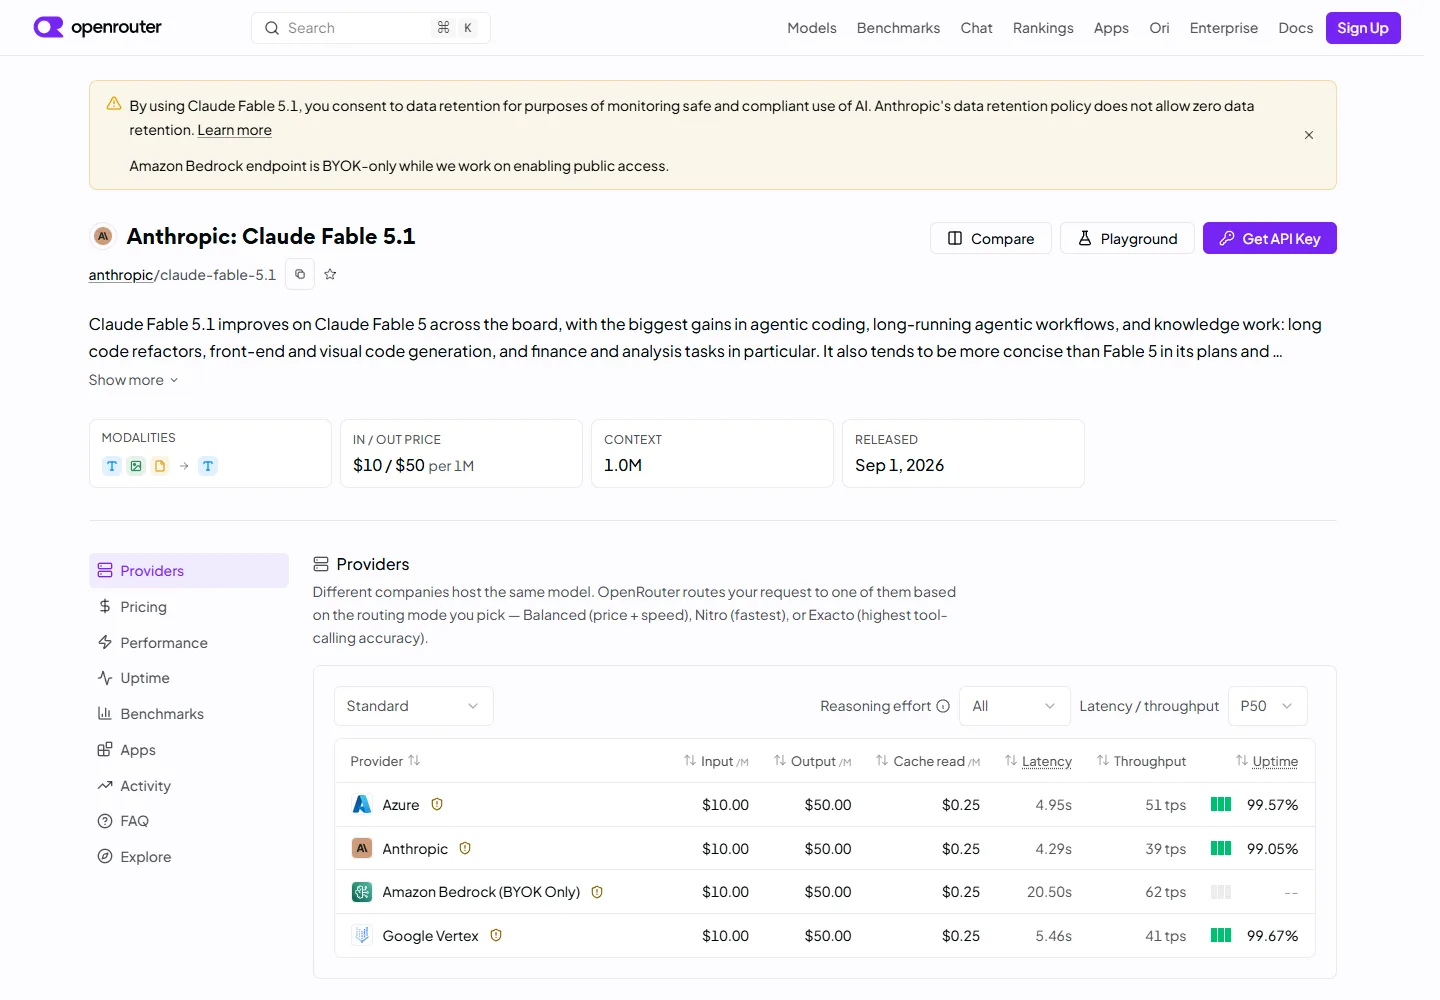
OpenRouter 是已確認提供 Fable 的第三方 API 服務,並非 Anthropic 自營網站。查閱時,其 Bedrock 端點標示為 BYOK,須使用者自備金鑰,頁面也列出資料保留條件。請確認實際供應商;與 Anthropic 直接簽訂的企業特殊條件,不會自動延伸到轉售端點。對於未經核實卻宣稱出售無限制 Mythos 的網站,不建議據此購買。
訂閱價格、API 費用與快取真正能省多少
官方公開美元價格為:Pro 月繳 20 美元或年繳 200 美元;Max 每月 100 美元起,適用稅金另計。官方方案價格。台灣用戶應以結帳頁面的實際幣別與新台幣請款金額為準;不能把匯率換算值視為台灣官方定價。
| 方案/使用類型 | Fable 5.1 如何計費 |
|---|---|
| Free | 不包含 |
| Pro/Team 標準席位 | 使用按量計費點數,不占一般訂閱額度 |
| Max/Team 進階席位 | 最多可將共享週間額度的 50% 用於 Fable;額外使用可能須購買點數 |
| Enterprise | 依席位制或按量計費合約而定,須確認工作區條件 |
| 開發者 API | 獨立的 token 計費 |
50% 不是額外增加的額度。其他模型也共用同一個週間額度池,而 Fable 消耗得更快。不能只用固定的「每月訊息數」估算,還要看工作難度、對話長度和代理活動。Fable 專用方案規則。
| 每百萬 tokens 的 API 費用 | Fable 5 | Fable 5.1/限定提供的 Mythos 5.1 |
|---|---|---|
| 未快取輸入 | 10 美元 | 10 美元 |
| 輸出 | 50 美元 | 50 美元 |
| 5 分鐘快取寫入 | 12.50 美元 | 12.50 美元 |
| 1 小時快取寫入 | 20 美元 | 20 美元 |
| 快取讀取 | 1 美元 | 0.25 美元 |
這是官方 API 價目表的標準美元費率。降幅是快取讀取便宜 75%,不是每次請求都便宜 75%。Anthropic 估計,一般按 token 計費的工作可省約 25%,大量代理工作最高約 45%;這是依工作型態而異的推估,並非訂閱折扣。Fable 價格說明。
例如一次請求含 10 萬個未快取輸入 tokens,以及 1 萬個計費輸出 tokens,模型 token 費用為 1.50 美元。如果同樣的輸入全部命中快取,讀取加輸出的費用為 0.525 美元,但不含先前的寫入及工具費。10 萬 tokens 的 5 分鐘快取寫入本身就要 1.25 美元。真正重複使用快取才有價值,一次性提示不會得到同樣好處。
更實際的比較單位是「一份可接受成果」的總支出,包括重試與審閱時間。便宜回答若需改三次,未必划算;昂貴模型若做了多餘工作,也可能更浪費。先設支出上限,用幾項具代表性的工作比較,再決定常用模型。
相較 Fable 5 的改良,以及移轉 API 的風險
主要升級結合了較強的持續作業能力、更便宜的上下文重用,以及更精準的安全措施。Anthropic 表示,與舊 Fable 5 防護相比,Claude Code 每個工作階段的資安安全介入平均減少約 60%,並允許發現原始碼中的弱點。這不表示開放無限制的攻擊程式開發。發表內容。
5.1 更新文件列出訊息層級的 effort、單一回合的系統指示、易讀的進度更新等測試功能,以及內容來源資訊。這些是整合功能;第三方聊天 App 是否能使用,取決於它的實作。
也有破壞相容性的變更:以 tool_choice 的「any」或指定「tool」強制選擇工具會回傳錯誤;舊模型不能讀取 5.1 的思考區塊,修改前段對話也可能讓保留的思考失效。升級時應閱讀移轉指南,重播真實的工具呼叫與模型切換流程。只改模型名稱不算完成驗證。
Mythos 5.1 延伸了上一版的專業研究能力,但使用資格仍是主要限制。對一般寫作、分析及應用開發來說,真正的選擇通常是從 Fable 5 升級,或從便宜模型改用 Fable,而非購買一般消費版的 Mythos。
官方基準:改善主要出現在哪裡?
下表節錄 Anthropic 發表時的評估,屬於廠商公布的資料,不是本站的測試成績。
| 評估項目 | Fable 5 | Fable 5.1 | Opus 5 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | 29.0% |
| Terminal-Bench 4.0 | 42.0% | 55.8% | 52.3% |
| AutomationBench | 17.1% | 31.4% | 26.9% |
| CursorBench 3.2.0 | 70.5% | 73.4% | 70.0% |
官方比較表及方法說明顯示,部分科學與商務工作差距較大,CursorBench 則較小。安全介入及備援模型也是評估條件的一部分。公布的 OSWorld 2.0 使用 2026 年 8 月版題目,若與舊版題目的成績混合排名,會造成誤導。基準注意事項。
實務上應先決定要減少哪種失敗。除錯看可重現的問題與通過測試的修正;報告看有來源支持的主張及漏掉的要求;代理工作則記錄需要人工介入的次數。單一智慧分數不能取代這些指標,也不能判定繁體中文寫作品質或創作風格的勝負。
編輯與用戶實際體驗了什麼?
書稿編輯: Tom’s Guide 編輯 Amanda Caswell 在 9 月 6 日的文章中,以自己的書稿測試。她認為模型提出了有用的結構建議,保留作者聲音,還發現她漏看的章節問題;但她並非接受每項修改。這支持把 Fable 當編輯助手試用,不能證明它在所有寫作上都更好。本人經驗。
理解程式碼庫: 9 月 1 日一名 r/claude 發文者表示,模型從約 40 個檔案追出計算流程,而不是只猜檔名。標題雖寫「用了一整天」,內文其實描述數小時。應把它當作可在自己專案重現的個案,而非受控比較。原始討論。
額度壓力: 另一則 r/ClaudeCode 討論中,有人肯定能力,也反映 Max 額度消耗很快;一人聲稱約 30 分鐘就用完 5 小時額度,其他人則建議降低 effort。這些人的工作條件不同,不是固定限額或可重現的速度測量。用量討論。
對熱烈評價的補充: Anthropic 自己的提示指南承認,開放式功能需求可能讓模型加入額外修改或過多測試。先限定交付物、完成條件,並要求把無關發現另列,就能提供更清楚的工作範圍。這項建議不需要依賴每則上市初期成功故事都成立。
公開體驗主要集中在 Fable,不能把它們改稱為親自使用 Mythos 的成果。目前這些資料也不足以建立具代表性的繁中用戶基準,或獨立的 Mythos 正面對照測試。
與 Opus 5、GPT-6 Astra、Gemini 3.8 Flash 比較
以下是不同預算下值得比較的選擇。價格為每百萬輸入/輸出 tokens 的標準 API 美元費率,不是聊天月費;上下文與工具限制亦屬 API 產品。
| 模型 | 輸入/輸出 | API 上下文 | 適合選擇的理由 |
|---|---|---|---|
| Fable 5.1 | 10/50 美元 | 100 萬 | 高難度推理、長時間工作,且修正成本高 |
| Mythos 5.1 | 10/50 美元起 | 100 萬 | 經核准的專業研究,使用受限 |
| Opus 5 | 5/25 美元 | 100 萬 | 較便宜的 Claude 比較基準 |
| GPT-6 Astra | 基本費率 10/50 美元 | 105 萬 | 在 OpenAI 工具生態完成複雜工作 |
| Gemini 3.8 Flash | 導入價 0.75/3.75 美元 | 約 100 萬 | 預算敏感及多模態輸入工作 |
來源:Claude 文件、Opus、Astra、Gemini,以及 Google 導入價格期限。這是購買比較,不代表各模型的推理品質相等。
Opus 5:先建立便宜的 Claude 基準
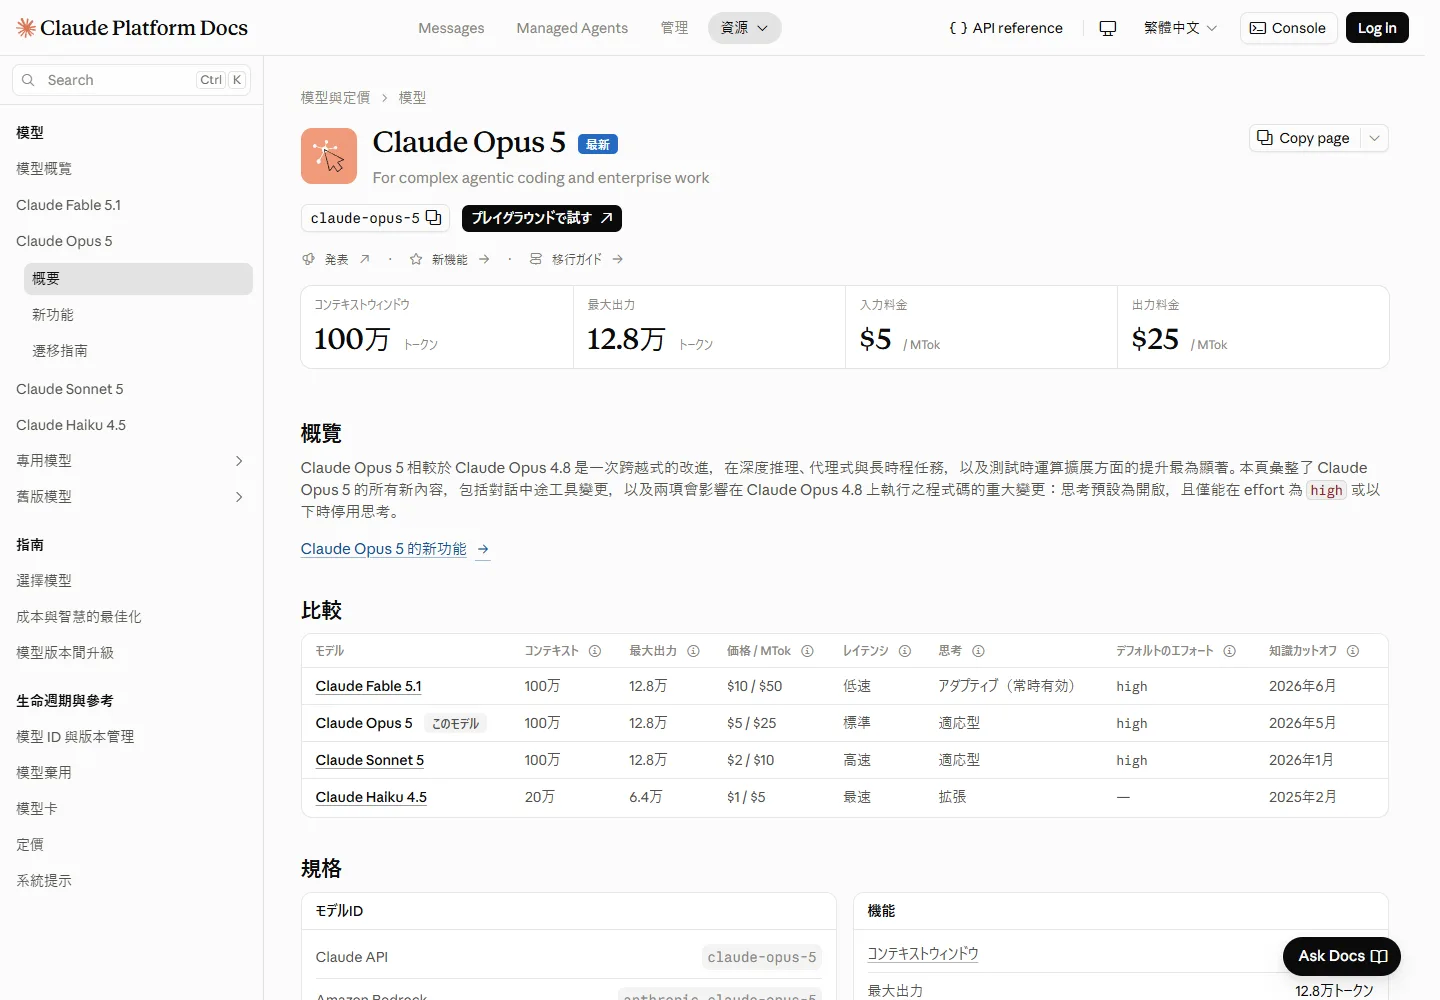
Opus 5 的基本輸入/輸出單價是 Fable 的一半,API 上下文公稱容量相同。Anthropic 的 Fable 概要也建議多數工作先從 Opus 開始。如果現有測試已過關,升級的價值就應表現在更少修正或更好的交付物。
將熟悉但有難度的工作交給兩者,在不知道模型名稱的情況下審閱。盡量統一指示與工具。如果只有一個階段需要 Fable,就只在該階段使用,不必整條流程都付高階單價。
GPT-6 Astra:比較完整工具流程
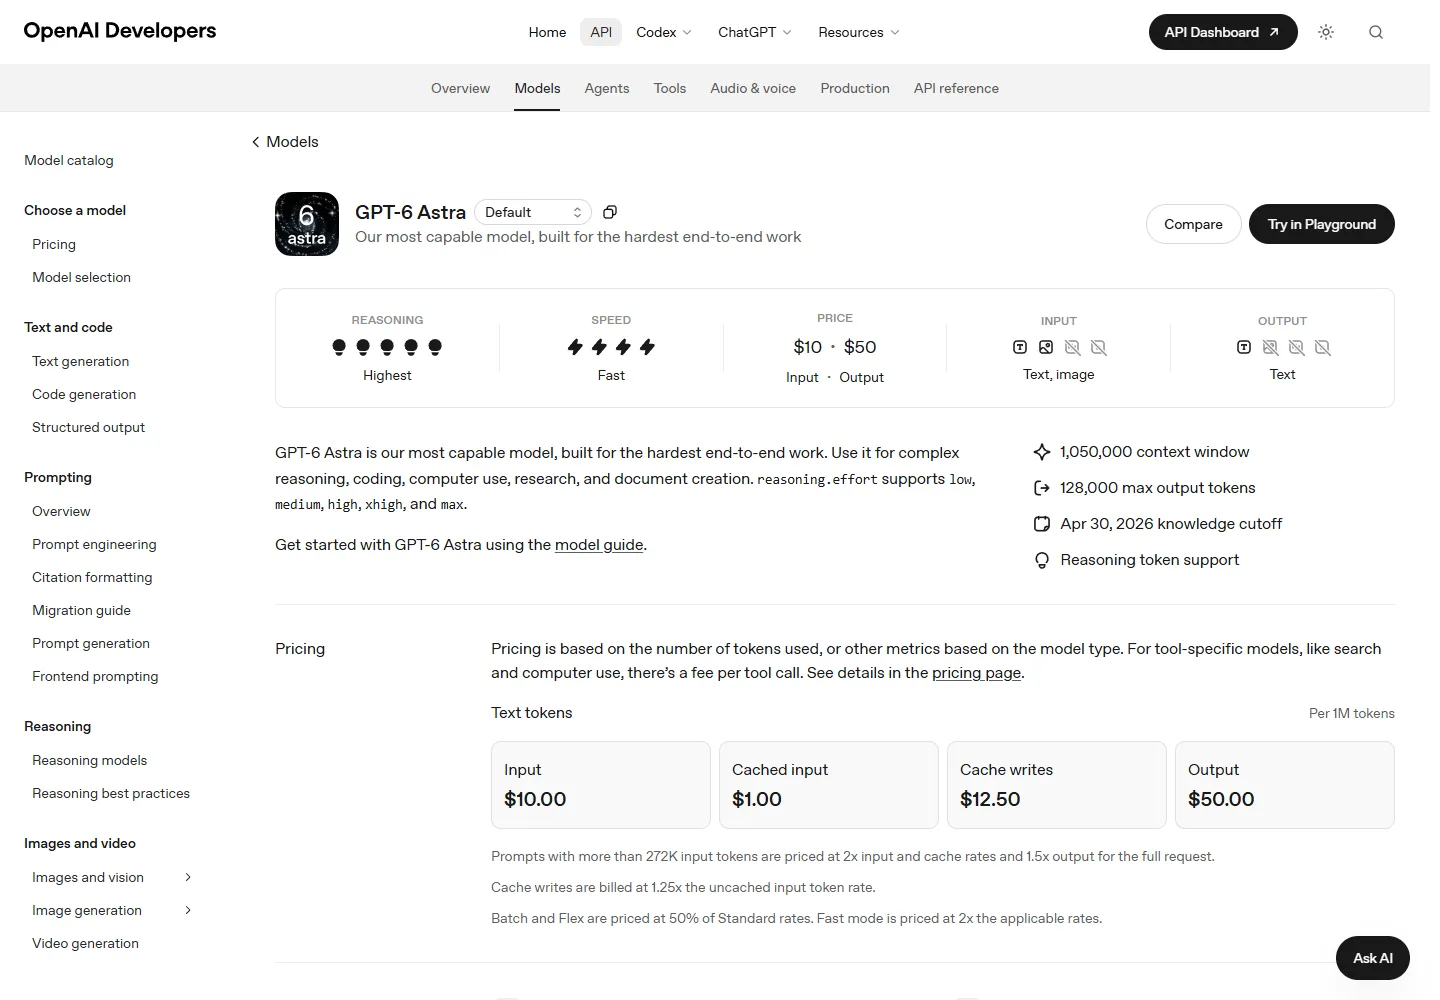
GPT-6 Astra面向推理、程式設計、電腦操作、研究與文件製作。基本 10/50 美元單價與 Fable 相同,但快取輸入為每百萬 tokens 1 美元。輸入超過 272,000 tokens 時,整個請求的輸入與快取費率變為 2 倍,輸出為 1.5 倍。長上下文比較必須帶入實際請求大小。
檔案存取、連接的工具、驗證與審閱方式,可能比小幅分數差距更重要。官方入口是 ChatGPT 與 API 平台;若為特定工作訂閱,先確認帳號的模型使用資格。
Gemini 3.8 Flash:低成本與影音輸入選擇
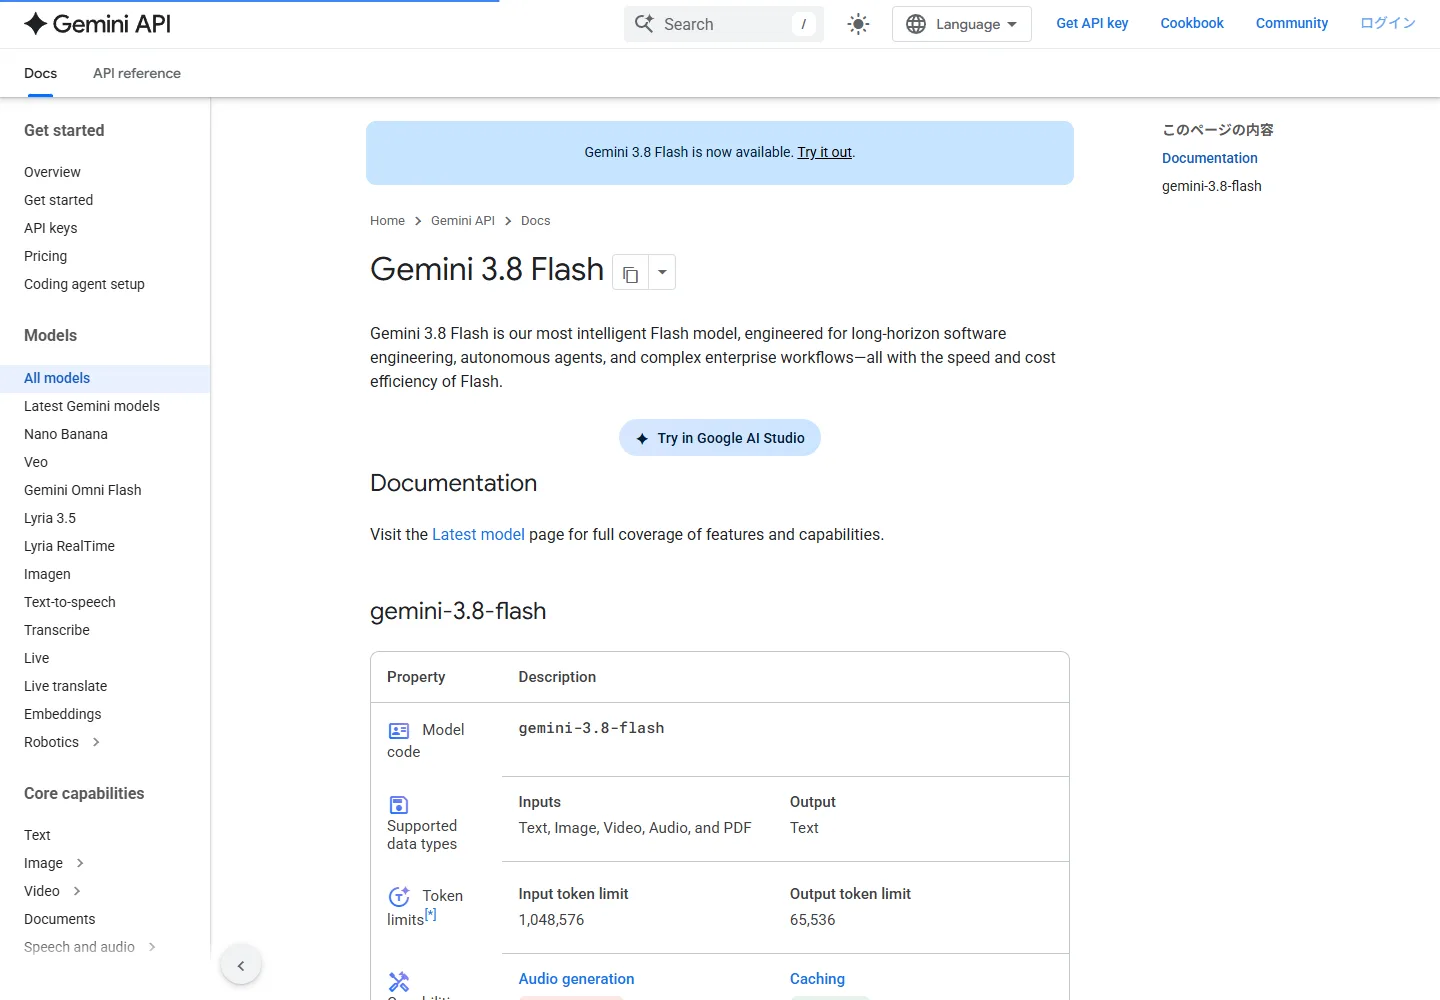
Gemini 3.8 Flash可輸入文字、圖片、影片、音訊與 PDF,並輸出文字。若資料包含影音,相較僅支援文字與圖片的模型,值得比較前處理的額外工作。可以從 Gemini 或 Google AI Studio 開始。
Google 的 0.75/3.75 美元導入價到 2026 年 12 月 31 日為止;公布的 2027 年 1 月 1 日起費率是 1.50/7.50 美元。持續營運的服務應把未來價格納入預算。單價低值得試,但仍須比較可接受成果及總 tokens,不能直接認定每項任務都更划算。官方發表與定價。
NSFW 支援:Mythos 不是無審查的成人模型
露骨性描寫、情色聊天或性癖內容,都不是 Fable 或 Mythos 官方支援的用途。 Anthropic 的使用政策禁止這些用途。Mythos 較寬鬆的安全措施針對獲准的資安與生命科學工作,不等於提供公開成人模式。
NSFW 也可能指不同種類的素材。非露骨的感情描寫、教育討論,以及較沉重的虛構題材,不能全部當成情色生成;是否適當取決於內容與情境。成熟題材小說的編輯工作,應在政策範圍內用實際任務測試,不要假設能討論某個主題,就能生成任何場景。
第三方包裝不代表 Anthropic 允許被禁止的內容;單張成功回應截圖,也不能證明穩定或正式的 NSFW 支援。如果核心需求是露骨成人生成,不應因為「隱藏的 Mythos 開關」這類承諾而選購。
推薦用途,以及實際可驗證的首次試用
程式維護: 提供失敗案例、程式碼背景及驗收條件,要求找出原因、做必要修改並展示驗證。評估修補結果,而不是解釋的自信程度。Claude Code 入門指南(英語)提供工具的開始使用方式。
長文編輯與翻譯審閱: 提供原稿、術語與讀者定位,先要優先排序的修正清單,再決定重寫。繁中應檢查台灣慣用語、角色稱謂、語氣及是否帶有翻譯腔。以人工認可的範例比較,因為上面的上市基準沒有測這些品質。
研究與商務文件: 要求主張對應來源的表格、未解問題,以及符合明確要求的交付物。試算表要有公式及數字核對;簡報除了文字事實,也要看匯出後的版面。
複雜代理工作: 設定預算、可用工具、完成條件及審閱節點。先使用能通過試驗的最低 effort,再對困難失敗提高設定。Anthropic 的成本與能力指南也建議以完成工作成本取代只看 token 單價。
可改用這個原創試用需求:「找出本月報告與原始 CSV 金額不一致的原因。交付修正的工作簿及簡短差異說明,保留現有工作表結構,展示合計如何核對。無關問題另外列出,在把檔案寄給任何人前停止。」這樣能定義可檢查的結果,而不是只獎勵看起來精彩的敘述。
常見問題
Fable 5.1 可以免費使用嗎?
Free 不包含它。付費也有條件:Pro 的 Fable 用量需要點數,符合資格的 Max/進階席位則使用有上限的週間額度。請看模型專用規則,不要只因為模型選單有顯示就認為免費。
Mythos 5.1 比 Fable 5.1 聰明嗎?
Anthropic 說明兩者採用同一底層模型。安全措施與權限可能改變受限任務的結果,但這不能證明一般程式設計或寫作需要追求另一個「更聰明」的 Mythos 訂閱。
升級後 API 會便宜 75% 嗎?
只有快取讀取由每百萬 tokens 1 美元降至 0.25 美元,基本輸入與輸出不變。估算時應計入命中比例、寫入、思考/輸出、重試及工具使用,才能判斷省多少。
100 萬上下文代表可以把任何檔案丟進 Claude 聊天嗎?
不是。這是模型 API 容量,消費者 App 有自己的上下文、上傳及方案限制。API 也有請求大小和支援的檔案處理條件,先用實際規模的文件測試,再決定流程。
Fable 5.1 最適合繁體中文寫作嗎?
值得用較長的編輯與文件工作比較,但沒有受控的繁中寫作成績能證明它第一。用同一篇文章、術語表與語氣要求,請熟悉台灣繁中的讀者評估忠實度與自然程度。
已有 Fable 5 API 整合,應該立刻切換嗎?
先測試。強制工具使用及保留思考的處理方式改變了。依移轉指南測試真實對話、模型切換與重試流程,比較品質和支出後再調整正式服務。
結論:為更少失敗付費,而非追求最高階名稱
Fable 5.1 值得放入困難程式與知識工作的候選名單,尤其適合同一大型上下文反覆重用,或較弱模型讓你花太多時間修正的工程。官方升級資料及初期寫作、程式體驗值得認真試用,但不足以給出無條件的「最佳模型」標籤。
從一項能判斷成果的工作開始,以真實預算與 Opus、Astra、Gemini 比較,只在改善確實成立的地方保留 Fable。Mythos 的對象是通過核准的專業組織;大多數人的關鍵問題仍是 Fable 額度、每份可接受成果的成本,以及與現有工具的搭配。
相關 評測
DeepSeek V4 評測:Flash、Pro、本機部署、Vision 與 NSFW 政策

2026 年 6 大最佳免費雲端硬碟服務
Seedance 2.5 評測:AI 影片生成模型的功能、使用體驗與限制

MiniMax-Music3 評測:支援 5 分鐘歌曲的開放權重 AI 音樂模型
2026 年 5 款最佳 AI 應用程式開發工具
Z-Image 評測|Turbo、Base、VRAM、LoRA 與本機使用重點