Test MiniMax-Music3 : Modèle de musique IA à poids ouverts pour des chansons de 5 minutes
MiniMax-Music3 est un modèle ouvert de génération musicale par IA capable de créer des chansons complètes d’environ cinq minutes à partir de paroles et d’une…

MiniMax-Music3 est un modèle ouvert de génération musicale par IA capable de créer des chansons complètes d’environ cinq minutes à partir de paroles et d’une description musicale détaillée. Plutôt que de se limiter à de courts boucles ou à des clips de fond, il vise une structure de chanson complète : introduction, couplet, refrain, pont, intermède instrumental et outro.
Le verdict est simple : MiniMax-Music3 offre une expérience moins immédiate que Suno ou Udio pour la création grand public sur navigateur, mais il s’avère bien plus intéressant pour les développeurs, les utilisateurs de ComfyUI, les chercheurs et les créateurs qui privilégient les flux de travail locaux. Ses points forts résident dans sa structure longue, son contrôle combinant paroles et descriptions, ainsi que ses parcours documentés pour SGLang-Omni, Diffusers et ComfyUI.
Sommaire
- Qu’est-ce que MiniMax-Music3 ?
- Caractéristiques principales et spécifications
- Expérience pratique et qualité des résultats
- Téléchargement et configuration locale
- VRAM et exigences matérielles
- Comparaison avec les principaux modèles de musique par IA
- Licence, utilisation commerciale et droits d’auteur
- Exemple de prompt
- FAQ
- Références
- Résumé
Qu’est-ce que MiniMax-Music3 ?
MiniMax-Music3 est un modèle texte-musique développé par MiniMax. La fiche officielle sur Hugging Face le décrit comme un modèle de génération musicale haute performance pour des chansons complètes allant jusqu’à cinq minutes, guidé par des paroles et une description musicale détaillée. Il produit des voix expressives, des arrangements évolutifs et un son stéréo WAV 32 kHz, 16 bits.
Sur le plan architectural, le modèle associe un LLM global de 8 milliards de paramètres (8B) pour la structure musicale à long terme et un LLM local de 0,6 milliard de paramètres (0,6B) pour les détails acoustiques image par image. La synthèse audio s’appuie sur le Flow Matching et le Flow-VAE. Cette distinction est cruciale, car générer une chanson entière ne se résume pas à produire de jolies trames audio : le modèle doit maintenir la thématique, le rythme, l’identité vocale et la progression des arrangements sur plusieurs minutes.
Caractéristiques principales et spécifications
| Élément | Détails |
|---|---|
| Nom du modèle | MiniMax-Music3 / MiniMax Music 3 |
| Utilisation principale | Génération de chansons basées sur des paroles, musique vocale, courte musique de fond, génération instrumentale |
| Entrées | Paroles et description musicale / légende structurée |
| Durée maximale | Jusqu’à environ cinq minutes |
| Format de sortie | Stéréo WAV 32 kHz, 16 bits |
| Balises de structure | [Intro], [Verse], [Pre-Chorus], [Chorus], [Bridge], [Instrumental], [Solo], [Outro] |
| Modes d’exécution | SGLang-Omni, Diffusers, ComfyUI |
| Hébergement du modèle | Hugging Face et GitHub |
| Licence | Licence communautaire MiniMax-Music3 |
Le flux de travail repose sur deux types d’entrées. Les paroles définissent le texte chanté, tandis que la description musicale précise le genre, le sous-genre, le tempo (BPM), la tonalité, la courbe émotionnelle, le style vocal, l’instrumentation, l’arrangement et le profil de production. Pour un contrôle plus précis, la fiche du modèle recommande l’utilisation d’une description structurée comprenant des métadonnées globales, des détails vocaux et des indications d’arrangement.
C’est là que réside la différence la plus utile par rapport aux générateurs de musique plus simples. Un prompt rudimentaire se contentera de « chanson pop entraînante ». Une description plus fouillée précisera « dance-pop, 124 BPM, voix féminine claire, basse synthétique en side-chain, couplet aux accords en pizzicato discrets, refrain avec batterie ample et harmonies superposées, mixage propre prêt pour la radio ». MiniMax-Music3 fournit un cadre permettant de formuler ce niveau de détail explicitement.
Expérience pratique et qualité des résultats
La page de démo officielle constitue le moyen le plus simple de comprendre le fonctionnement du modèle. Elle propose des exemples couvrant divers genres tels que la pop, le rock, le R&B, le hip-hop, la dance-pop, la country, la soul, le funk, le blues, la bossa nova et la musique urbaine. Plusieurs exemples utilisent des titres en anglais, mais on y trouve également des morceaux en chinois, ce qui permet d’évaluer à la fois la musicalité globale et la gestion des langues autres que l’anglais.
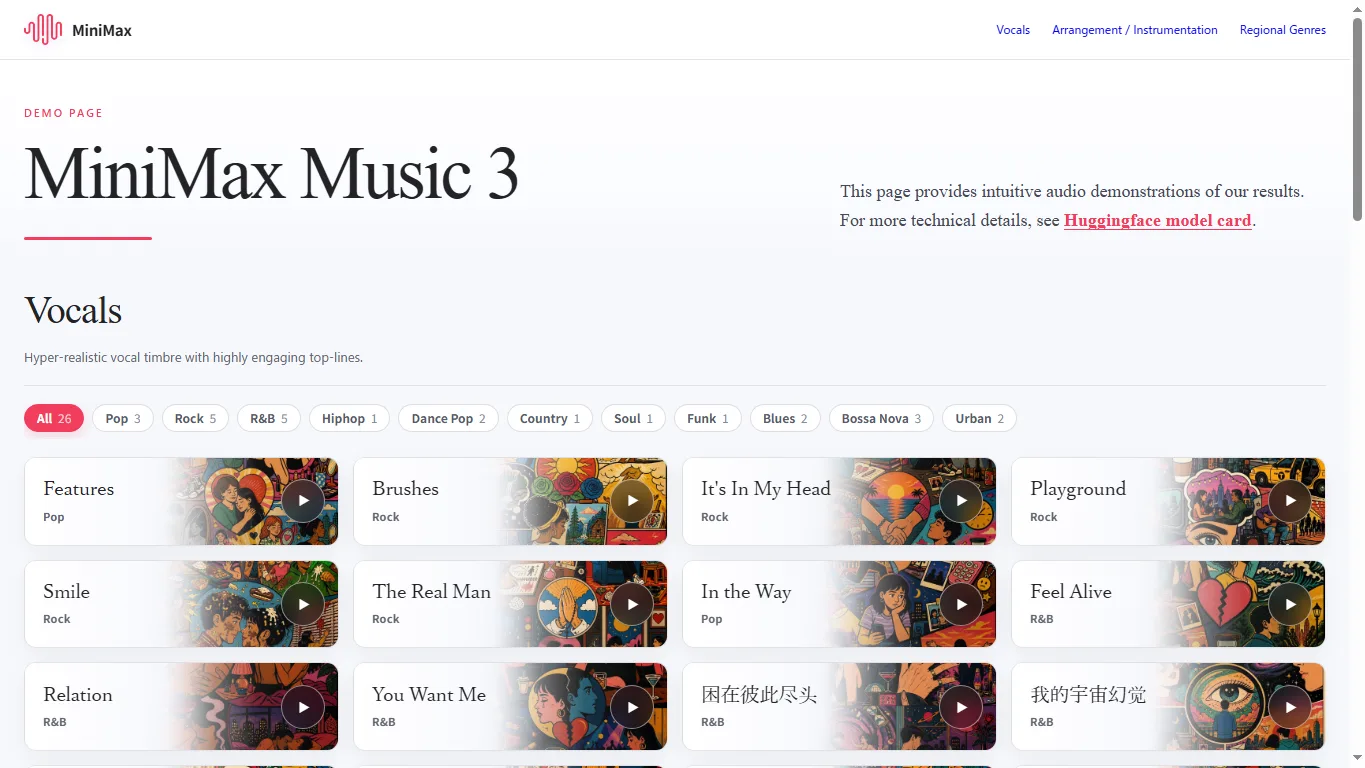
À l’écoute des chansons générées, il convient d’aller au-delà du premier accroche. Vérifiez si la transition entre le couplet et le refrain semble naturelle, si le timbre vocal reste constant, si les paroles sont intelligibles, si l’arrangement évolue au fil du temps et si le morceau se conclut de manière cohérente. De nombreux systèmes d’IA musicale savent produire un extrait impressionnant de 20 secondes, mais le véritable défi consiste à maintenir la cohérence d’un morceau complet.
Les premiers retours de la communauté se révèlent enthousiastes mais pragmatiques. Les discussions sur Hugging Face témoignent d’un réel engouement pour la publication de ce modèle ouvert, tout en abordant des aspects pratiques tels que la prise en charge de ComfyUI, les configurations à faible VRAM, la gestion des licences et la vitesse de génération. Cela confère à cette sortie un profil bien particulier : impressionnante et prometteuse, mais s’adressant avant tout aux utilisateurs prêts à tester, à affirmer leurs réglages et à lire la documentation, plutôt qu’à ceux qui recherchent un produit grand public en un clic.
Download et configuration locale
Le modèle officiel est disponible sur la page MiniMaxAI/MiniMax-Music3 sur Hugging Face, et le dépôt du projet se trouve sur MiniMax-AI/MiniMax-Music3 sur GitHub. Pour une inférence de type serveur, la fiche du modèle oriente vers SGLang-Omni. Une commande de service minimale ressemble à ceci :
sgl-omni serve --model-path MiniMaxAI/MiniMax-Music3 --port 8000Les requêtes de génération utilisent le format de point de terminaison vocal partagé : les paroles sont insérées dans input et la description musicale dans instructions. Ce point est important, car MiniMax-Music3 n’est pas un modèle de synthèse vocale (TTS) doté d’un locuteur sélectionnable. Le résultat ne se pilote pas via un paramètre voice, mais en décrivant le genre de la voix, son timbre, son style d’interprétation, ses harmonies et ses effets directement dans la description.
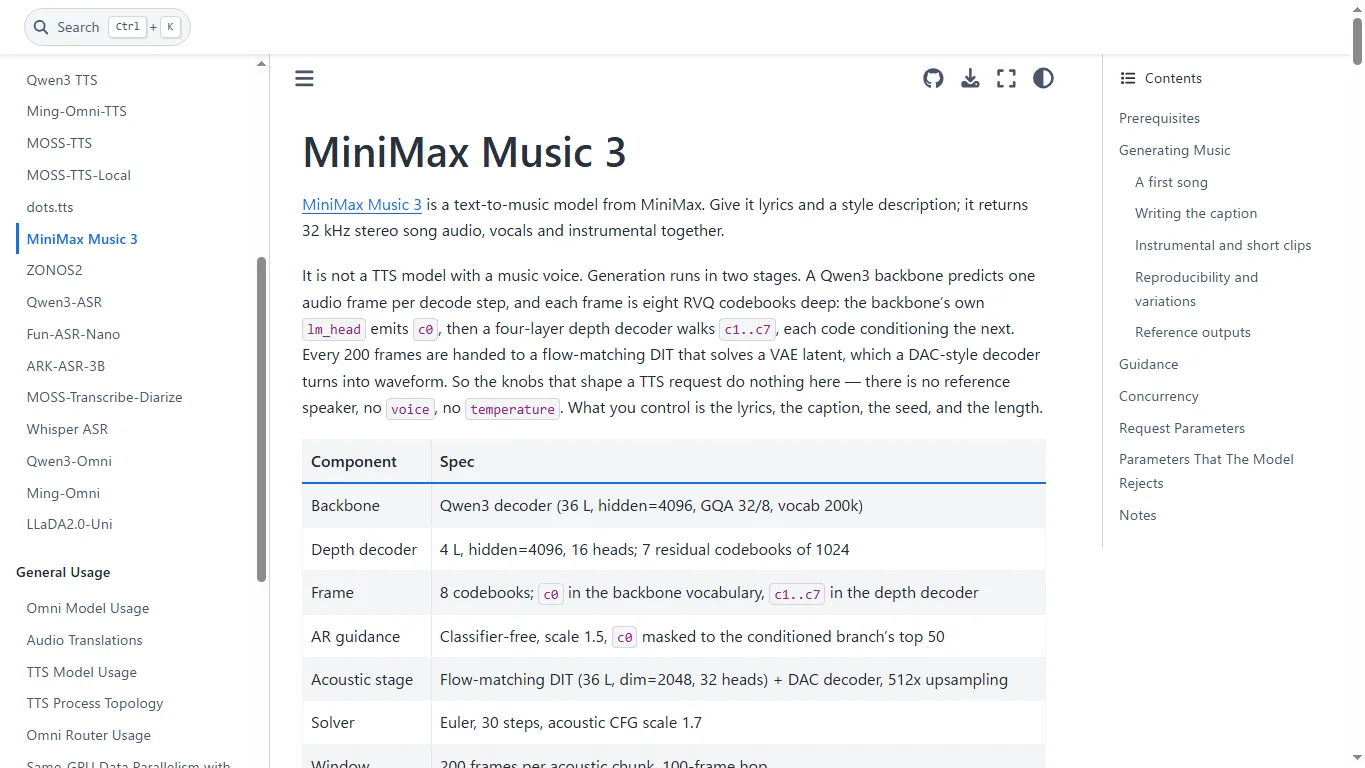
La prise en charge de Diffusers est également documentée via un parcours ModularPipeline. Au moment de la publication de la fiche du modèle, l’installation renvoie vers un commit spécifique d’une PR Diffusers. Il convient donc de vérifier si le support complet a bien été intégré à votre version installée de Diffusers avant de supposer qu’une simple installation standard via pip suffira.
VRAM et exigences matérielles
La fiche officielle du modèle offre un aperçu matériel étonnamment clair. En pleine précision, le modèle tient dans moins de 24 Go de VRAM. Avec le déchargement automatique sur le processeur (CPU offload), la génération requiert environ 22 Go. En recourant au déchargement en streaming couche par couche pour le modèle de langage, le pipeline peut s’exécuter sur des cartes graphiques de 8 Go, bien que cette méthode s’avère plus lente et doive plutôt être considérée comme une solution de secours pour les configurations limitées en VRAM que comme un environnement de production idéal.
| Configuration | Avis pratique | Idéal pour |
|---|---|---|
| GPU 24 Go et plus | La solution locale la plus propre ; les cartes de type RTX 4090 sont plus réalistes pour les tests | Utilisateurs d’IA locaux et chercheurs |
| ~22 Go avec déchargement CPU | Économise de la VRAM mais peut réduire la vitesse | Utilisateurs disposant d’un équipement légèrement inférieur à 24 Go |
| 8 Go avec déchargement en streaming | Faisable selon la fiche du modèle, mais nettement plus lent | Courts tests et vérification de faisabilité |
| Parcours ComfyUI à faible VRAM | Les fichiers de modèle INT8 et le décodage par tuiles facilitent les expérimentations | Créateurs travaillant par nœuds |
| GPU Cloud ou API | Moins de difficultés de configuration et tests de chansons longues facilités | Équipes et évaluation de production |
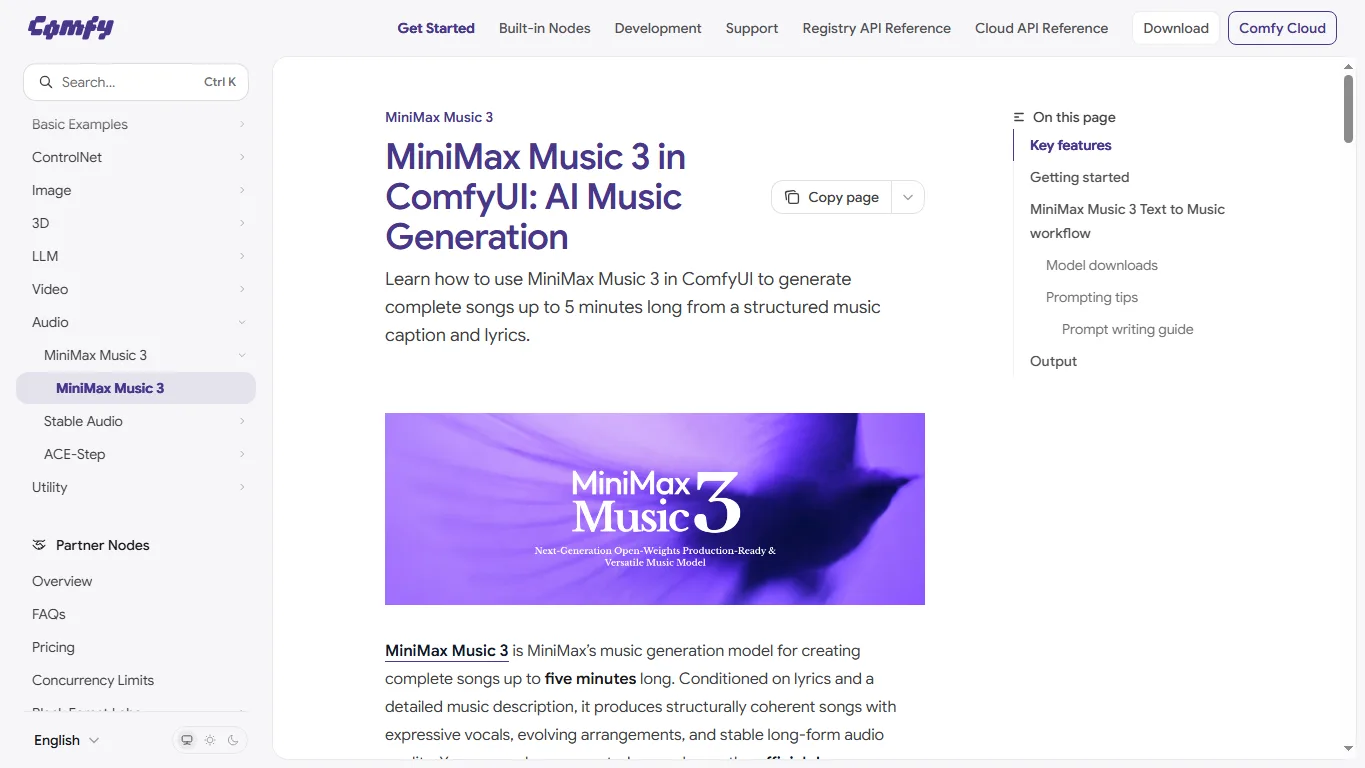
Pour les utilisateurs de ComfyUI, le tutoriel officiel ComfyUI pour MiniMax Music 3 constitue le point de départ le plus pragmatique. Il répertorie les modèles de diffusion FP16 et INT8, un encodeur de texte INT8, les fichiers VAE, l’emplacement des dossiers, le flux de travail de conversion texte-musique, des conseils pour la rédaction des prompts et l’emplacement des fichiers de sortie.
Télécharger le flux de travail ComfyUI officiel
Si vous souhaitez tester MiniMax-Music3 dans ComfyUI, utilisez le fichier JSON du flux de travail officiel de Comfy-Org : audio_minimax_music_3.json. Téléchargez le fichier, chargez-le dans ComfyUI et vous pourrez examiner directement le flux de travail de génération de musique à partir de texte. Assurez-vous que les fichiers de modèle requis sont placés dans les dossiers ComfyUI appropriés avant de lancer l’exécution.
Le tutoriel officiel ComfyUI détaille le téléchargement des modèles, les fichiers INT8 pour configurations à faible VRAM, ainsi que les paramètres max_duration, seed et tiled_decode. Une approche pragmatique consiste à tester d’abord de courts extraits, à ajuster la description et les paroles, et seulement ensuite de lancer le rendu d’une chanson complète de trois à cinq minutes.
Comparaison avec les principaux modèles de musique par IA
MiniMax-Music3 se positionne entre les services grand public de musique par IA et les modèles de recherche locaux. Les outils en ligne tels que Suno, Udio et ElevenLabs Music se révèlent plus faciles d’utilisation. Les modèles ouverts comme Meta MusicGen, Stable Audio Open et YuE partagent des affinités plus proches avec MiniMax-Music3, tout en répondant à des exigences différentes en matière de durée, de contrôle et de flux de travail.
| Modèle / Service | Type | Points forts | Points de vigilance |
|---|---|---|---|
| MiniMax-Music3 | Modèle ouvert (open-weight) | Jusqu’à cinq minutes, paroles + description détaillée, parcours ComfyUI/SGLang/Diffusers | Nécessite une configuration, une planification de la VRAM et l’examen de la licence |
| Suno | Service en ligne | Flux de travail sur navigateur très simple et excellente expérience grand public | Pas de contrôle local du modèle ni de déploiement de poids ouverts |
| Udio | Service en ligne | Performant pour les morceaux chantés, l’édition et les flux de travail d’extension | Les résultats et les droits d’utilisation dépendent des conditions du service |
| ElevenLabs Music | Service en ligne / API | Bien adapté aux API de production et aux flux de travail audio | Il ne s’agit pas d’un modèle ouvert local |
| Stable Audio Open | Modèle ouvert | Utile pour les courts extraits audio, les effets et les éléments de fond | Moins axé sur les chansons complètes basées sur des paroles |
| Meta MusicGen | Modèle ouvert | Référence de recherche établie pour la génération de musique courte | Nécessite la conception d’un flux de travail supplémentaire pour les chansons vocales complètes |
| YuE | Modèle ouvert | Un point de comparaison pertinent pour la génération de chansons complètes | La configuration et la qualité des résultats dépendent fortement de l’environnement et de la version |
Si votre objectif est de publier rapidement une chanson pour les réseaux sociaux, Suno ou Udio s’avéreront généralement plus simples. En revanche, si vous cherchez à tester la structure de chansons longues, à contrôler les descriptions, à gérer les graines (seeds), à concevoir des flux de travail ComfyUI ou à étudier un modèle musical ouvert, MiniMax-Music3 représente l’option la plus stimulante.
La direction prise par MiniMax en matière de génération multimédia mérite également d’être suivie. Le modèle vidéo de l’entreprise est abordé dans notre test de MiniMax H3, et les tendances récentes de la génération vidéo font également l’objet de notre test de LTX-2.5. Music3 s’inscrit dans cette même dynamique en faveur d’une génération plus longue, multimodale et adaptée aux flux de travail.
Licence, utilisation commerciale et droits d’auteur
MiniMax-Music3 utilise la licence communautaire MiniMax-Music3, et non une simple licence permissive de type MIT ou Apache. Cette licence inclut des exigences d’attribution pour les produits commerciaux, un seuil de revenus pouvant nécessiter une autorisation supplémentaire, des règles de sécurité pour les services hébergés ainsi qu’une politique d’utilisation acceptable.
La génération musicale comporte également des risques liés aux droits d’auteur et à la gestion des droits qui vont au-delà de la licence du modèle. Les paroles, l’imitation du style d’artistes, la similarité vocale, les règles des plateformes de distribution et les obligations de divulgation sont autant d’éléments à prendre en compte. Si vous prévoyez de publier ou de commercialiser de la musique générée, conservez une trace des prompts, de la paternité des paroles, de la version du modèle ainsi que de toute modification apportée après la génération.
Exemple de prompt
Un prompt pratique pour MiniMax-Music3 sépare les paroles de la description musicale. Pour les chansons en anglais, rédigez les deux parties en anglais. Pour les autres langues, vous pouvez conserver la description musicale en anglais si cela vous garantit un contrôle du style plus stable.
[Verse] Morning light is breaking through the rain I keep walking past the places we became [Chorus] Hold on, we are brighter than the night Two hearts burning like a signal in the sky Music description: Emotional pop rock, 104 BPM, female lead vocal with airy harmonies, clean electric guitar in the verse, full drums and wide synth pads in the chorus, hopeful but nostalgic, radio-ready modern mix, gradual build to a final anthemic chorus.Pour des itérations efficaces, commencez par générer des segments de 30 à 60 secondes avant de lancer le rendu d’une chanson entière. Une fois que la voix, le tempo, l’instrumentation et l’énergie du refrain vous conviennent, augmentez la durée. Les générations longues étant plus exigeantes en termes de temps et de mémoire, le peaufinage de la description s’avère primordial.
FAQ
MiniMax-Music3 est-il gratuit ?
Les poids du modèle sont disponibles sur Hugging Face, mais son utilisation locale implique des coûts en matière de matériel, de stockage et de temps de configuration. Si vous utilisez des GPU dans le cloud, une inférence hébergée ou une API, ces services peuvent appliquer leur propre tarification.
MiniMax-Music3 peut-il générer des voix ?
Oui. Il est conçu pour générer simultanément des voix et un accompagnement instrumental. Le profil vocal se pilote par le biais de la description musicale et non via un paramètre de sélection du locuteur distinct.
Peut-il s’exécuter sur un GPU de 8 Go ?
La fiche officielle du modèle indique qu’il peut tenir sur des cartes graphiques de 8 Go grâce au déchargement en streaming, mais il faut s’attendre à une génération plus lente. Pour une expérience locale plus fluide, un GPU de classe 24 Go ou un flux de travail ComfyUI à faible VRAM se révèle plus réaliste.
Est-il supérieur à Suno ou Udio ?
Pas pour tous les utilisateurs. Suno and Udio s’avèrent plus simples pour une création rapide sur navigateur. MiniMax-Music3 se montre plus attrayant si vous recherchez un accès aux poids ouverts, des flux de travail locaux, une intégration à ComfyUI, de la reproductibilité et un contrôle plus approfondi des descriptions.
Puis-je l’utiliser à des fins commerciales ?
C’est envisageable, mais vous devez examiner attentivement la licence communautaire. L’attribution du produit, l’échelle des revenus, les garanties de sécurité et les droits des tiers sont des aspects essentiels. La distribution musicale entraîne également des considérations relatives aux droits d’auteur et aux politiques des plateformes.
Peut-il créer de la musique instrumentale ?
Oui. Utilisez une description claire telle que « instrumental cinematic ambient, no vocals » ou « lofi background music, no vocal lead », et testez d’abord des durées plus courtes.
Références
- MiniMaxAI/MiniMax-Music3 – Hugging Face
- MiniMax-AI/MiniMax-Music3 – GitHub
- Démo de MiniMax Music 3
- MiniMax Music 3 dans ComfyUI
- Guide SGLang-Omni pour MiniMax Music 3
- Licence communautaire MiniMax-Music3
Résumé
MiniMax-Music3 s’impose comme l’une des sorties majeures dans le domaine de la musique par IA, car il se focalise sur des chansons complètes plutôt que sur de simples extraits. Sa prise en charge des paroles, des descriptions structurées, d’une durée de cinq minutes, de la sortie stéréo WAV et des parcours de flux de travail locaux en fait un outil particulièrement précieux pour les développeurs et les créateurs exigeants.
Il ne s’agit toutefois pas d’une application grand public sans friction. Les exigences matérielles, la lenteur des modes à faible VRAM, la gestion des licences et celle des droits d’auteur requièrent toute votre attention. Pour la plupart des lecteurs, la meilleure approche consiste à écouter la démo officielle, à tester de courtes générations via ComfyUI ou SGLang-Omni, et seulement ensuite de s’engager dans la création de chansons plus longues ou dans des flux de travail commerciaux.
Derniers Évaluations
Meilleures lunettes connectées en 2026 : 6 modèles pour l’IA, l’AR et le sport

Créer une station IA avec un GPU cloud : images, vidéo, LLM et limites NSFW (2026)

Manus 2.0 : avis sur Studio, les tarifs, l’API et les nouveautés
Avis Meta Muse 2026 : agent IA, tarifs et Muse Spark
Où sont stockés les téléchargements Spotify ? Peut-on les exporter en MP3 ?
MiniMax H3 Image Studio : avis, images ComfyUI et références pour la vidéo