
¿IA de imágenes local u online? Qué elegir en 2026
Empieza online si generas imágenes de vez en cuando, trabajas desde un portátil o móvil, o necesitas editar mediante conversación. La opción local cobra sentido si ya tienes una GPU adecuada y reutilizas los mismos modelos, LoRA y flujos de trabajo. Comprar una GPU cara solo para ahorrarte una suscripción de 20–30 dólares suele tardar años en amortizarse.
«Local» indica dónde se ejecuta el modelo. No implica automáticamente mejor calidad, peor comprensión de instrucciones, derechos de contenido ilimitados ni coste cero. Un mismo modelo descargable puede funcionar en tu PC y mediante una API de pago alojada por un proveedor. Los pesos, la precisión, los ajustes y la moderación importan más que la ubicación por sí sola.
| Factor | Inferencia local | Generación online |
|---|---|---|
| Inversión inicial | GPU o equipo existente adecuado; almacenamiento y tiempo de configuración | Normalmente sin comprar GPU; pruebas gratuitas, suscripciones o créditos API |
| Calidad de imagen | Depende del modelo, el flujo y la memoria disponible | Acceso a modelos alojados y cerrados; el proveedor determina el procesamiento |
| Texto e instrucciones | Los modelos modernos comprenden lenguaje natural; algunos antiguos o especializados prefieren etiquetas | El chat facilita las revisiones; hay que comprobar las letras generadas |
| NSFW | Depende del modelo, la licencia y la aplicación; no existe un permiso universal | Según el servicio: algunos solo admiten SFW; otros tienen mayor capacidad para contenido sensible |
| Velocidad y límites | Hardware, resolución y tamaño del lote; sin cuota del proveedor en inferencia totalmente local | Colas, plan, créditos, límites de solicitudes y modo de calidad |
| Anime / realismo | Modelos especializados y LoRA compatibles permiten más control | Los servicios de anime y los modelos generales tienen fortalezas diferentes |
| Mantenimiento / privacidad | Gestionas dependencias, archivos y copias; un flujo offline puede mantener los datos en el equipo | Poca configuración; el tratamiento de datos y la visibilidad dependen del servicio |
Esta guía de compra se basa en fuentes revisadas el 8 de septiembre de 2026; no es una prueba controlada de todos los modelos. Identificamos las cifras de velocidad del fabricante y explicamos las hipótesis de los cálculos. Salvo indicación contraria, todos los precios están en dólares estadounidenses, no en euros ni en una moneda local.
Un flujo práctico: primero generar, después terminar
1. Elige el entorno de inferencia. ComfyUI es una interfaz de flujos de trabajo y un motor de inferencia de código abierto, no un modelo de imágenes. Permite combinar generación, edición y otros procesos. Un flujo instalado localmente puede incluir nodos de API remotas de pago: revísalos antes de asumir que las imágenes permanecen en tu ordenador.
2. Termina solo la imagen seleccionada. Si el resultado es correcto pero demasiado pequeño, Ampliador de imágenes con IA de AirMore es una herramienta opcional de navegador que aumenta sus dimensiones en píxeles. Amplía imágenes, pero no sustituye a un generador. Tampoco corrige de forma fiable las faltas de ortografía ni garantiza la exactitud de los detalles reconstruidos. Para archivos sensibles o confidenciales, utiliza un proceso de acabado acorde con tus requisitos de datos.
Separar generación y acabado evita gastar créditos de alta resolución en decenas de conceptos antes de elegir una composición. Revisa primero el borrador pequeño y dedica después tiempo y cómputo a la imagen final.
Comparativa de precios: ¿GPU, suscripción o API?
Para generar en local, presupuesta el sistema completo: memoria gráfica, RAM, SSD, fuente de alimentación compatible y refrigeración. Los modelos pueden ocupar mucho almacenamiento. Como punto de partida orientativo, 16 GB de VRAM y 32 GB de RAM dan más flexibilidad que una GPU básica con poca memoria, pero no garantizan que quepan todos los flujos grandes. Los modelos pesados pueden necesitar más memoria o una descarga a CPU más lenta.
| GPU de ejemplo | Memoria gráfica | Precio inicial de lanzamiento en EE. UU. | Cómo interpretarlo |
|---|---|---|---|
| RTX 5060 Ti | 16 GB | 429 USD | Referencia de capacidad, sin promesa de velocidad de gama alta |
| RTX 5070 Ti | 16 GB | 749 USD | Más cómputo no aumenta el límite de memoria |
| RTX 5090 | 32 GB | 1.999 USD | Mayor margen, con costes de compra y del sistema mucho más altos |
Son precios de lanzamiento de NVIDIA para la familia 5060 y la serie 50, no presupuestos actuales de compra. Un reciente informe de precios minoristas de Tom’s Hardware en EE. UU. situaba la 5060 Ti de 16 GB en unos 761 USD y la 5090 más barata en al menos 5.000 USD. Disponibilidad, país, impuestos y diseño de la tarjeta pueden cambiar la decisión. Pide un precio local antes de calcular la amortización.
| Opción online | Precio mensual / API | Qué compras realmente |
|---|---|---|
| ChatGPT Plus | 20 USD/mes | Acceso a ChatGPT con límites de imágenes; la API se factura aparte |
| Midjourney | Basic 10 USD; Standard 30 USD; Pro 60 USD; Mega 120 USD | Las horas de GPU Fast dependen del nivel; Standard y superiores incluyen imágenes en Relax |
| NovelAI | Tablet 10 USD; Scroll 15 USD; Opus 25 USD | Anlas y ventajas del plan; las generaciones gratuitas de V5 Opus tienen un cupo que se repone |
| API FLUX.2 klein 4B | Desde 0,014 USD por imagen de 1 MP | Pago por imagen; las salidas mayores y las ediciones pueden incrementar el coste |
| API GPT Image 2 | Por millón de tokens de imagen: 8 USD de entrada / 30 USD de salida; texto de entrada: 5 USD por millón | Tarifa estándar por tokens; calidad, tamaño e imágenes de entrada influyen en el total |
Fuentes: ChatGPT Plus, planes de Midjourney, suscripciones de NovelAI, precios de BFL y precios de la API de OpenAI. Las tarifas de entrada en caché y procesamiento por lotes son distintas. No confundas facturación mensual y anual; pueden añadirse impuestos. Una suscripción web no incluye automáticamente crédito API.
Ejemplo de amortización: supongamos 800 USD en hardware adicional, la cancelación de un plan de imágenes de 30 USD/mes y gastos locales recurrentes de 5 USD/mes. El plazo sería 800 ÷ (30 − 5) = 32 meses. Un PC completo de 1.500 USD tardaría 60 meses con las mismas hipótesis. Si mantienes la suscripción, ese ahorro no existe. El cálculo excluye reventa, reparaciones y tiempo de configuración.
La electricidad se puede medir: un consumo supuesto de todo el PC de 0,35 kW × 30 horas × 0,20 USD/kWh = 2,10 USD. Sustituye los valores por tus mediciones y tarifa; no es una medición real del consumo de una GPU. El tiempo de trabajo suele costar más: resolver un fallo del flujo puede superar el ahorro obtenido en muchas imágenes.
Para uso ocasional, pagar por consumo puede salir más barato que una suscripción o hardware nuevo. Para producción intensiva con una GPU que ya tienes, la inferencia local resulta más atractiva. Compara el coste por imagen aceptada: un intento hipotético de 0,03 USD cuesta 0,12 USD por imagen útil si solo aceptas el 25 %, antes del retoque.
Potencia de los modelos locales: elige según la tarea
FLUX.2 [klein] 4B es un candidato compacto para generación y edición local. Sus pesos 4B usan Apache 2.0; los 9B tienen otra licencia, no comercial salvo autorización independiente. No presupongas que todas las descargas FLUX comparten condiciones comerciales. Guía oficial de uso local y licencias.
BFL indica unos 8,4 GB y 1,2 segundos para la inferencia del 4B destilado en una RTX 5090, mientras que su guía del flujo completo menciona unos 13 GB. Son ámbitos de memoria distintos; no garantizan una buena experiencia con una tarjeta de 8 GB. Reserva margen para codificadores, decodificación y entradas de edición. Tampoco traslades los tiempos de la 5090 a una 5060 Ti. Tabla de rendimiento del fabricante; guía del flujo de trabajo.
Qwen-Image-2512 es un modelo descargable de unos 20.000 millones de parámetros que merece probarse en temas realistas y composiciones con texto. Su ficha oficial destaca mejoras de realismo y letras, con cobertura de inglés y chino. Es un modelo grande: cuantización y descarga a CPU pueden ayudar a ejecutarlo, pero modificar velocidad y resultados. Usamos esta versión descargable concreta como referencia, sin afirmar que sea el producto más reciente de toda la familia Qwen. Ficha oficial y licencia Apache 2.0.
Z-Image-Turbo es una opción destilada de 6.000 millones de parámetros orientada a la eficiencia. El desarrollador comunica 8 evaluaciones de función, fotorrealismo, texto en inglés y chino, y compatibilidad con dispositivos de consumo de 16 GB. La latencia anunciada inferior a un segundo corresponde a una H800 empresarial, no a una GPU doméstica habitual. Ficha oficial del modelo.
Para anime, un modelo especializado o un LoRA compatible puede importar más que el modelo general más grande. Un LoRA es una adaptación pequeña vinculada a una familia de modelos, no un complemento de estilo universal. Empieza con un ejemplo funcional de la versión base exacta. Nuestra guía de descarga de modelos y LoRA, en inglés, explica cómo evaluar fuentes y compatibilidad.
Modelos online: edición, estética y especialización en anime
Acceso web oficial: ChatGPT · Midjourney · NovelAI.
ChatGPT Images 2.0 / GPT Image 2 es la opción conversacional de esta comparativa. Puedes describir una escena y pedir cambios concretos utilizando la imagen anterior como contexto. Es un punto de partida accesible para conceptos de marketing y composiciones cuyo encargo evoluciona durante la conversación. La documentación del modelo API es independiente de la del producto ChatGPT. Anuncio oficial de Images 2.0; documentación de la API GPT Image 2.
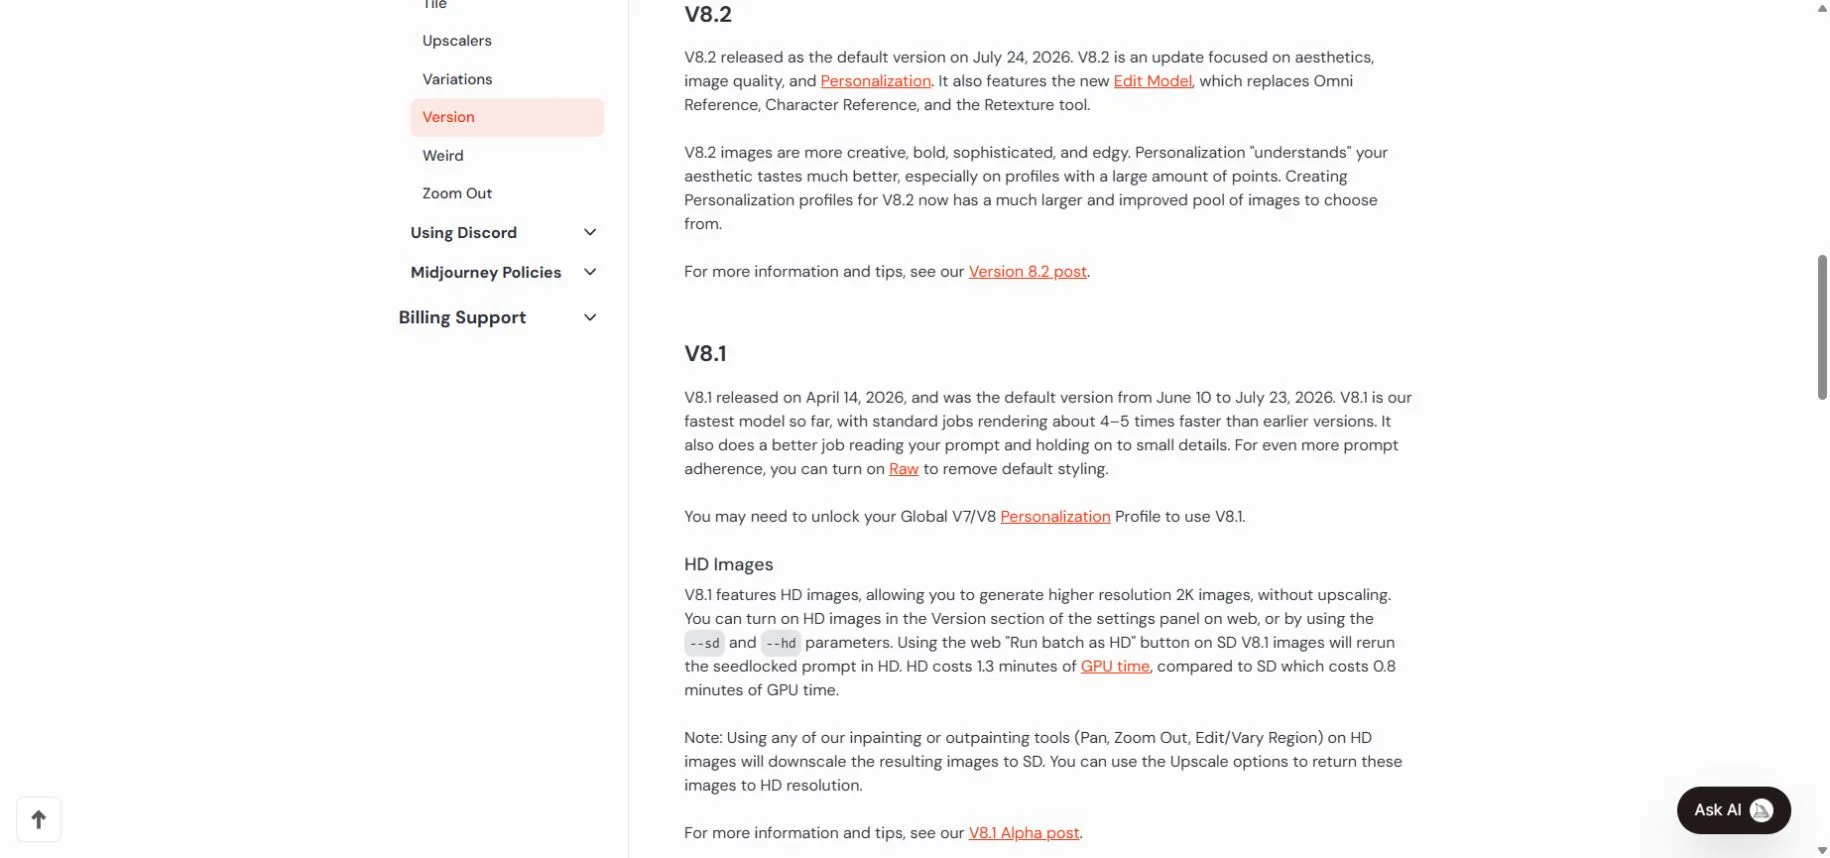
Midjourney V8.2 pasó a ser la versión predeterminada el 24 de julio de 2026, según su documentación. Destaca la estética y personalización, con un nuevo Edit Model. Para anime, el servicio ofrece Niji 7. Es una opción cuando el reto principal es definir la dirección visual; eso no demuestra superioridad con etiquetas exactas de productos o instrucciones complejas. Versiones actuales y diferencias entre modelos.
NovelAI Diffusion V5 combina generación de anime con instrucciones en lenguaje natural, soporte de japonés, controles para varios personajes y letras mejoradas. Full tiene una cobertura de entrenamiento más amplia; Curated busca reducir resultados sensibles no deseados. Sus funciones resultan especialmente pertinentes para escenas de personajes y cómics. Información oficial del modelo V5.
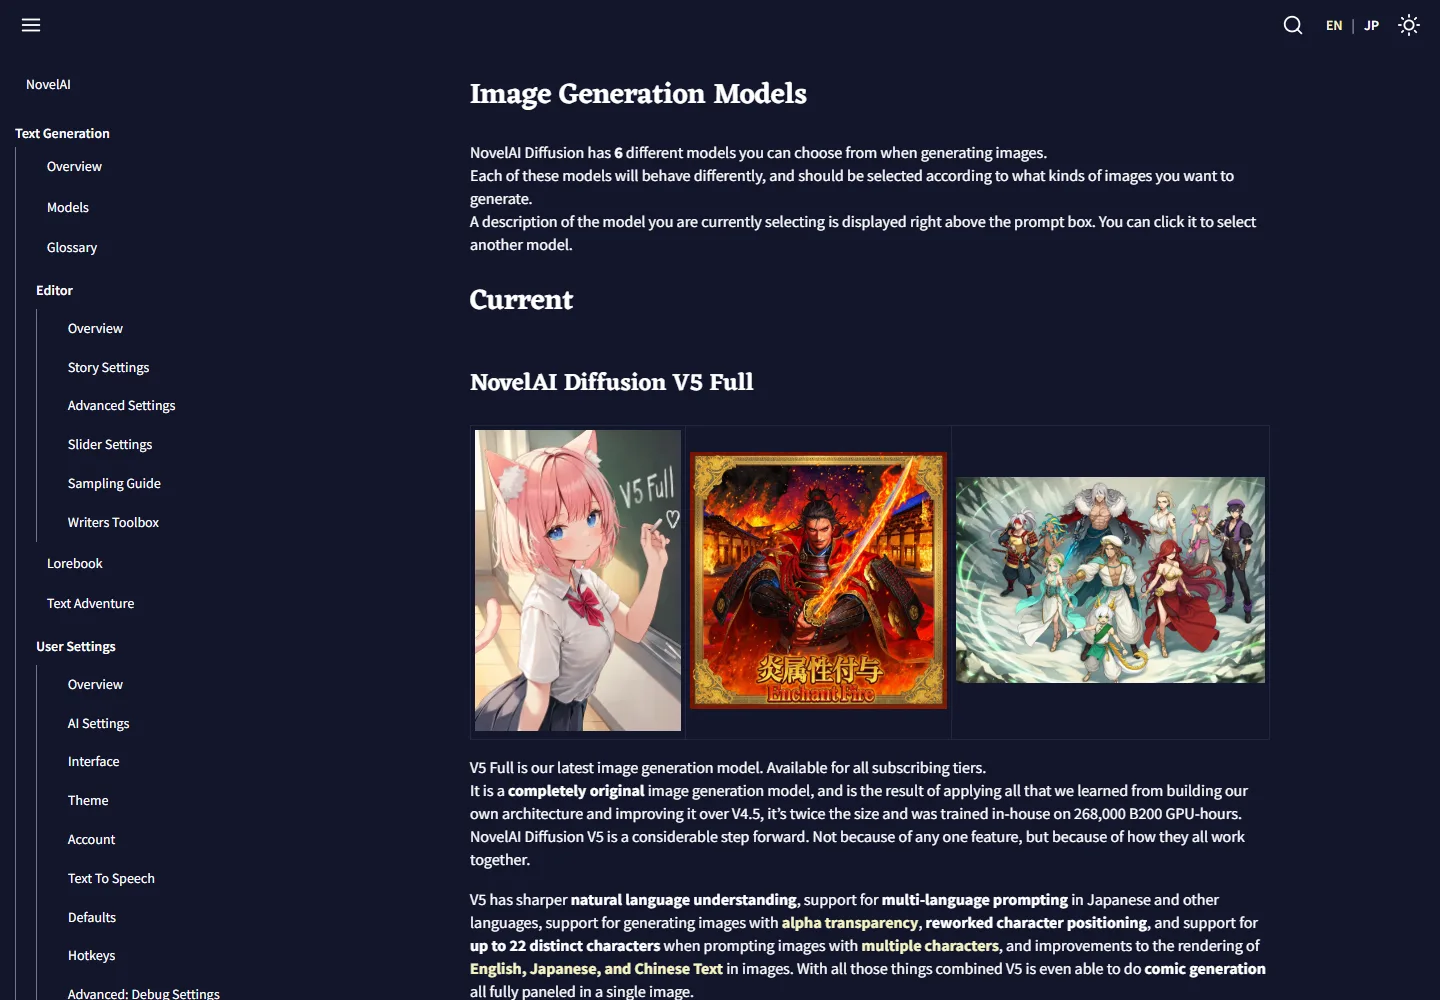
Son formas distintas de trabajar, no una clasificación universal. Prioriza edición conversacional para encargos cambiantes, un sistema de estilos para explorar dirección artística y controles explícitos de personajes para escenas recurrentes. Prueba tus casos difíciles antes de pagar un año.
Dibujar texto y comprender instrucciones son capacidades diferentes
Comprender instrucciones significa asignar correctamente objetos, colores, posiciones y acciones. Renderizar texto es dibujar con precisión los caracteres pedidos dentro de la imagen. Un modelo puede producir un cartel precioso con el título mal escrito, o escribirlo bien y equivocarse sobre quién sostiene el producto.
| Prueba | Qué pedir | Qué comprobar |
|---|---|---|
| Relaciones | Taza roja a la izquierda de un libro azul; planta verde detrás de ambos | Cantidad de objetos, izquierda/derecha y asociación de colores |
| Texto exacto | Título breve entre comillas y un precio separado | Letras omitidas, números alterados, palabras adicionales y alineación |
| Tipografía multilingüe | Frase en español con tildes, ñ y signos ¿¡; como prueba japonesa, kanji, kana y cifras | Acentos, puntuación y espaciado; en japonés, kana pequeños y marcas de vocal larga |
| Edición | Cambiar solo el fondo, conservando el envase y la etiqueta | Si se redibujaron detalles que debían permanecer iguales |
Empieza con una instrucción sencilla: «Crea un cartel cuadrado para una cafetería ficticia. Coloca una taza azul a la izquierda y el título “Mezcla de la mañana” arriba. Deja despejado el tercio inferior». Después corrige una cosa cada vez. Suele ser más fácil detectar errores así que con un párrafo de adjetivos de estilo contradictorios.
Los modelos locales modernos también aceptan prosa. Un modelo de anime entrenado con etiquetas puede responder mejor a las etiquetas y ponderaciones documentadas; un servicio conversacional interpreta la intención mediante diálogo. La dificultad depende del modelo y sus controles, no simplemente de ejecutarlo localmente. No copies una receta antigua de instrucciones negativas en cada modelo nuevo.
Para trabajos en español, prueba expresamente tildes, ñ y signos de apertura: un ejemplo en inglés no basta. Lo mismo ocurre con entregables japoneses frente a demostraciones en inglés o chino. Haz una prueba del idioma y revisa al tamaño final. Para precios, textos legales, datos de contacto y párrafos densos, genera la ilustración y añade texto editable en una herramienta de diseño; las correcciones posteriores serán más baratas.
Velocidad y cuotas: compara imágenes terminadas por hora
Cuenta desde que envías la solicitud hasta que obtienes un archivo aceptable. Incluye carga del modelo, transferencia, colas, vistas previas, reintentos, ampliación y reparación manual. Una inferencia de un segundo anunciada por el fabricante es solo parte del proceso.
| Entorno | Límite relevante | Consecuencia práctica |
|---|---|---|
| Totalmente local | VRAM, cómputo, temperatura y almacenamiento | Sin cuota del servicio, pero un lote grande puede agotar la memoria; descargar a CPU puede ralentizarlo |
| ChatGPT | Límites del plan y complejidad de la solicitud | Las generaciones complejas pueden tardar minutos; no asumas una cuota diaria fija para todas las cuentas |
| Midjourney | Horas GPU Fast frente a colas Relax | Basic: 3,3 horas Fast; Standard: 15; Pro: 30; Mega: 60. Relax en Standard y superiores cambia espera por volumen |
| NovelAI V5 Opus | Cupo gratuito que se repone más Anlas | Las generaciones gratuitas elegibles tienen límite; al agotarlo, utiliza Anlas o espera |
| API alojada | Límites de solicitudes, créditos y concurrencia | Automatizar es cómodo, pero cada lote necesita presupuesto y gestión de reintentos |
Fuentes: ayuda de imágenes de ChatGPT, tabla de planes de Midjourney y FAQ de límites de NovelAI Opus. NovelAI indica que el cupo V5 se repone continuamente y tarda alrededor de una semana en recuperarse del todo desde cero. Los modelos anteriores elegibles conservan reglas diferentes de generación ilimitada. No describas V5 simplemente como «ilimitado».
Para una prueba justa, usa los mismos diez encargos con dimensiones comparables. Anota intentos, imágenes aceptadas, tiempo y gasto total. Separa los resultados con el modelo local ya cargado en memoria de los arranques en frío. Esta prueba sencilla aporta más que comparar vídeos de velocidad sin condiciones comunes en redes sociales.
Anime, personas realistas y coherencia de personajes
Anime y manga: prueba NovelAI o Niji de Midjourney si quieres empezar con un servicio alojado; investiga modelos de anime y LoRA compatibles si necesitas controlar un estilo repetible en local. Evalúa por separado composición de viñetas, manos, número de personajes y coherencia entre páginas, además del atractivo de un retrato.
Personas y productos fotorrealistas: compara los modelos generales citados en piel, tejidos, reflejos, geometría y fidelidad a referencias. Un rostro convincente no garantiza logotipos, tamaños de envases o posturas de manos correctos. Las afirmaciones de realismo de Qwen y Z-Image justifican probarlos, pero no demuestran de forma independiente que superen a todos los competidores online.
Personajes recurrentes: elige un flujo compatible con las referencias o adaptaciones que necesitas. Guarda versión del modelo, instrucciones, semilla cuando exista y ajustes de edición. Una semilla no garantiza la misma persona si cambias de modelo o procesamiento. En producción, mide el esfuerzo de mantener un personaje en diez escenas, no solo un resultado afortunado.
NSFW: controlar el equipo no equivale a tener permiso ilimitado
NSFW puede abarcar desnudo artístico, material sexual explícito o violencia gráfica: son categorías de política diferentes. La tabla resume capacidades generales y restricciones documentadas. No realizamos pruebas de generación explícita ni de evasión de filtros.
| Opción | Situación NSFW | Límite importante |
|---|---|---|
| Modelos locales descargables | Varía según pesos, entrenamiento y aplicación | Eliminar el servicio alojado no elimina las condiciones del modelo ni hace legal cualquier resultado |
| ChatGPT Images / GPT Image 2 | Restringido; no es un servicio adulto sin censura | Los filtros se aplican a instrucciones e imágenes; hay restricciones específicas para deepfakes sexuales |
| Midjourney / Niji | Solo SFW | Prohíbe contenido adulto y gore, también en servidores privados y modo Stealth |
| NovelAI V5 | Full y Curated difieren en capacidad de contenido sensible | Curated busca evitar imágenes sensibles no deseadas; no supone permiso general para cualquier uso adulto |
| Modelos abiertos alojados | Se aplican las reglas del proveedor | Una API puede imponer límites distintos a los de una instalación local |
Fuentes: informe de seguridad de OpenAI Images 2.0, normas de Midjourney, diferencias entre modelos de NovelAI, condiciones de NovelAI y política de BFL. La documentación de NovelAI citada no establece una lista universal de contenido permitido para cualquier situación explícita; la etiqueta «Full» no es esa garantía.
Antes de suscribirte para proyectos adultos, distingue capacidad técnica de permiso contractual. Utiliza únicamente material adulto legal y consentido; evita contenido sexual con menores o representaciones íntimas no consentidas. Ejecutar el modelo localmente no justifica ninguno de esos usos. Almacenamiento privado y permiso para generar una categoría también son cuestiones distintas.
Privacidad, licencias y decisión de compra
Un flujo totalmente local puede mantener las imágenes originales en el ordenador una vez instalados los componentes. Comprueba nodos remotos y extensiones antes de llamarlo offline. Los servicios online varían: las creaciones de Midjourney son públicas por defecto y Stealth solo está en Pro y Mega. Los controles de datos de ChatGPT para consumidores son otra configuración; pagar no convierte el espacio en offline o confidencial automáticamente.
Para trabajo comercial, revisa la licencia exacta del modelo y las adaptaciones, el plan y los derechos de las referencias. Pesos descargables no significa uso comercial sin restricciones. La licencia del proveedor tampoco garantiza que todos los logotipos o parecidos generados estén autorizados.
- Uso ocasional sin GPU adecuada: empieza con una prueba o un mes online. Es difícil justificar hardware solo con el ahorro de suscripción.
- GPU existente y lotes repetibles: prueba un modelo local y un flujo estable. Mide resultados aceptados y mantenimiento antes de ampliar.
- Carteles en español o japonés y encargos cambiantes: prioriza pruebas lingüísticas, edición selectiva y tipografía final editable.
- Producción de anime: compara controles de personajes, recursos de estilo compatibles y límites reales de V5 y del plan.
- Tareas mixtas: deja en local los trabajos rutinarios ya validados y utiliza un modelo alojado donde su edición o calidad ahorren tiempo suficiente.
Un flujo híbrido suele tener sentido, pero mantener ambos implica un coste adicional de servicio. Encontrarás otras opciones iniciales en nuestra guía de generadores de imágenes con IA.
Preguntas frecuentes
¿Generar imágenes con IA local es gratis?
El software y algunos pesos pueden descargarse gratis. Hardware, electricidad, almacenamiento, mantenimiento y tiempo siguen costando. Tener ya un ordenador adecuado facilita justificar la opción local.
¿Bastan 8 GB de VRAM?
Para ciertos flujos pequeños o cuantizados, sí. No es un objetivo fiable para todos los modelos. Comprueba el proceso completo, dimensiones y entradas de edición; la memoria del modelo aislado excluye otros componentes.
¿Más VRAM mejora la calidad?
Permite alojar modelos o flujos mayores y reducir la descarga a CPU. No mejora automáticamente el mismo modelo con ajustes idénticos. Velocidad de cómputo y capacidad de memoria resuelven problemas distintos.
¿La IA online puede generar imágenes NSFW?
No hay una respuesta única. Midjourney solo admite SFW, OpenAI aplica restricciones de seguridad y otros servicios distinguen variantes y normas de contenido sensible. Verifica el modelo actual y la política del proveedor.
¿Qué opción dibuja mejor texto en español o japonés?
Elige según pruebas con el modelo y tu texto exacto, no según local u online. Revisa tildes, ñ, puntuación, cifras y, en japonés, kana. Mantén editable el texto final importante en vez de depender totalmente de las letras generadas.
¿Debería comprar una GPU para sustituir mi suscripción?
Solo después de probar el flujo local y calcular el ahorro de las suscripciones que realmente cancelarás. Incluye presupuesto real de hardware, gastos recurrentes y proporción de imágenes útiles. Un precio elevado puede alargar la amortización más allá del ciclo razonable de renovación.
Nuestra conclusión
La generación online es la primera compra más sencilla para la mayoría sin hardware adecuado. La local resulta convincente cuando ya tienes GPU, necesitas control repetible y puedes mantener el flujo. Ninguna ubicación garantiza el mejor anime, rostros realistas o letras exactas.
Elige el modelo para la tarea, verifica sus límites NSFW y comerciales, y compara coste y tiempo por imagen realmente utilizable. En 2026, esas diferencias prácticas importan más que «lo local es gratis» o «la nube siempre es mejor».
Relacionados
Best AEO Tools for AI Search Visibility

YouTube Script Template: Copy-and-Use Structures for Better Videos
AI Email Subject Line Generator: Best Tools to Write Better Email Hooks
AI Cover Letter Generator: Best Tools to Write Better Job Applications Faster

Mejores herramientas para comprimir y unir PDF: reducir tamaño y combinar archivos
5 mejores traductores de novelas con IA en 2026 y webs gratuitas