GPU Unlock: análisis de la aceleración IA, compatibilidad y riesgos
Analizamos gpu-unlock, KohakUnlock y las variantes Ada: GPU RTX compatibles, tiempos en ComfyUI, límites en LLM, energía y riesgos del firmware.

GPU Unlock puede acelerar ciertas tareas de IA local en una GeForce existente. Su mejor escenario es una tarjeta compatible que dedique gran parte del trabajo al cálculo de coma flotante en Tensor Cores. No aumenta la VRAM, no duplica todos los modelos y no ofrece una actualización compatible para la RTX 5090.
La evidencia merece atención si tienes un equipo Linux secundario con una RTX 30 y sabes recuperar el arranque. El balance es menos atractivo en una estación de producción, con flujos INT8 o si buscas un instalador universal para Windows. La decisión consiste en elegir una implementación adecuada y comprobar qué parte de tu trabajo realmente mejora.
Contenido
Qué modifica GPU Unlock
El objetivo es una ruta de Tensor Cores que multiplica valores de baja precisión y acumula en FP32. FP16 con acumulación FP16, el cálculo FP32 convencional en CUDA y las operaciones enteras son rutas diferentes. El documento técnico Ada de NVIDIA ya distingue sus tasas; una cifra genérica de «AI TOPS» no sirve como referencia intercambiable.
Las implementaciones ejecutan firmware con privilegios antes de que el controlador NVIDIA tome la GPU, modifican selectores de velocidad y entregan el dispositivo al controlador original. Describirlo como un simple ajuste del controlador oculta el mecanismo de firmware y arranque. Los métodos revisados no requieren flashear VBIOS ni aumentar voltaje, pero conservan riesgos de ejecución privilegiada.
Los desarrolladores lo atribuyen a segmentación comercial. Lo medible es la tasa de instrucciones concretas; no demuestra que todo trabajo de consumo estuviera reducido a la mitad ni que NVIDIA apruebe la modificación. Tampoco se ha establecido una mejora verificada de FPS en juegos con estas pruebas.
Documento técnico de arquitectura Ada de NVIDIA
Alcance: análisis documental comprobado el 29 de octubre de 2026, con documentación de proyectos, mediciones publicadas por propietarios y prensa. AirMore no ejecutó el desbloqueo, pruebas CUDA ni ensayos de resistencia. Recalculamos tiempos publicados; las capturas muestran documentación, no resultados propios. Se utilizó IA para investigación, redacción y localización. La portada es una ilustración editorial.
Cuatro proyectos con funciones distintas
gpu-unlock — Zagitta
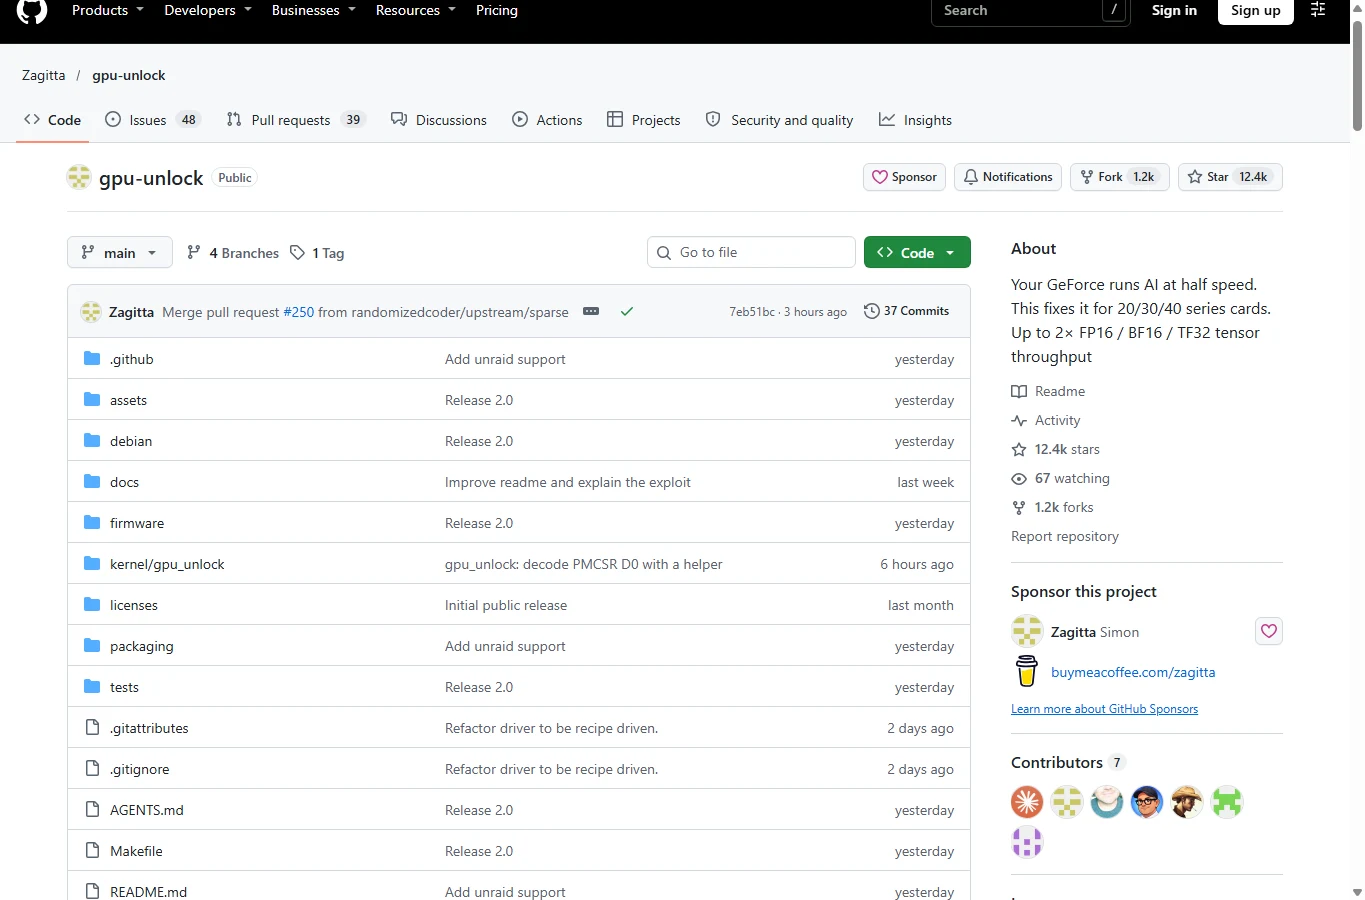
El proyecto original para Linux es el punto de partida más directo para investigar Ampere. El README consultado se identifica como v2.0.0 e incluye paquetes e integración con initramfs. Ahora enumera Turing y Ada como experimentales, además de RTX 30. La etiqueta stable del mantenedor no certifica cada placa de forma independiente.
Debe ejecutarse antes de que NVIDIA se vincule a la tarjeta. Cargar el módulo manualmente después no desbloquea un dispositivo ya controlado. Importan las cabeceras del kernel, el orden de arranque, la identidad PCI exacta y una entrada normal de recuperación. El módulo es código gratuito GPL-2.0-only; el firmware NVIDIA mantiene condiciones separadas.
El autor indica expresamente que no tiene una web, moneda o instalador universal afiliados. Los resultados de búsqueda con el mismo nombre no son necesariamente distribución oficial. Comprueba autor y revisión: disponer de paquetes no elimina el mantenimiento del arranque ni las comprobaciones tras actualizar el sistema.
gpu-unlock-ada — JustAResearcher
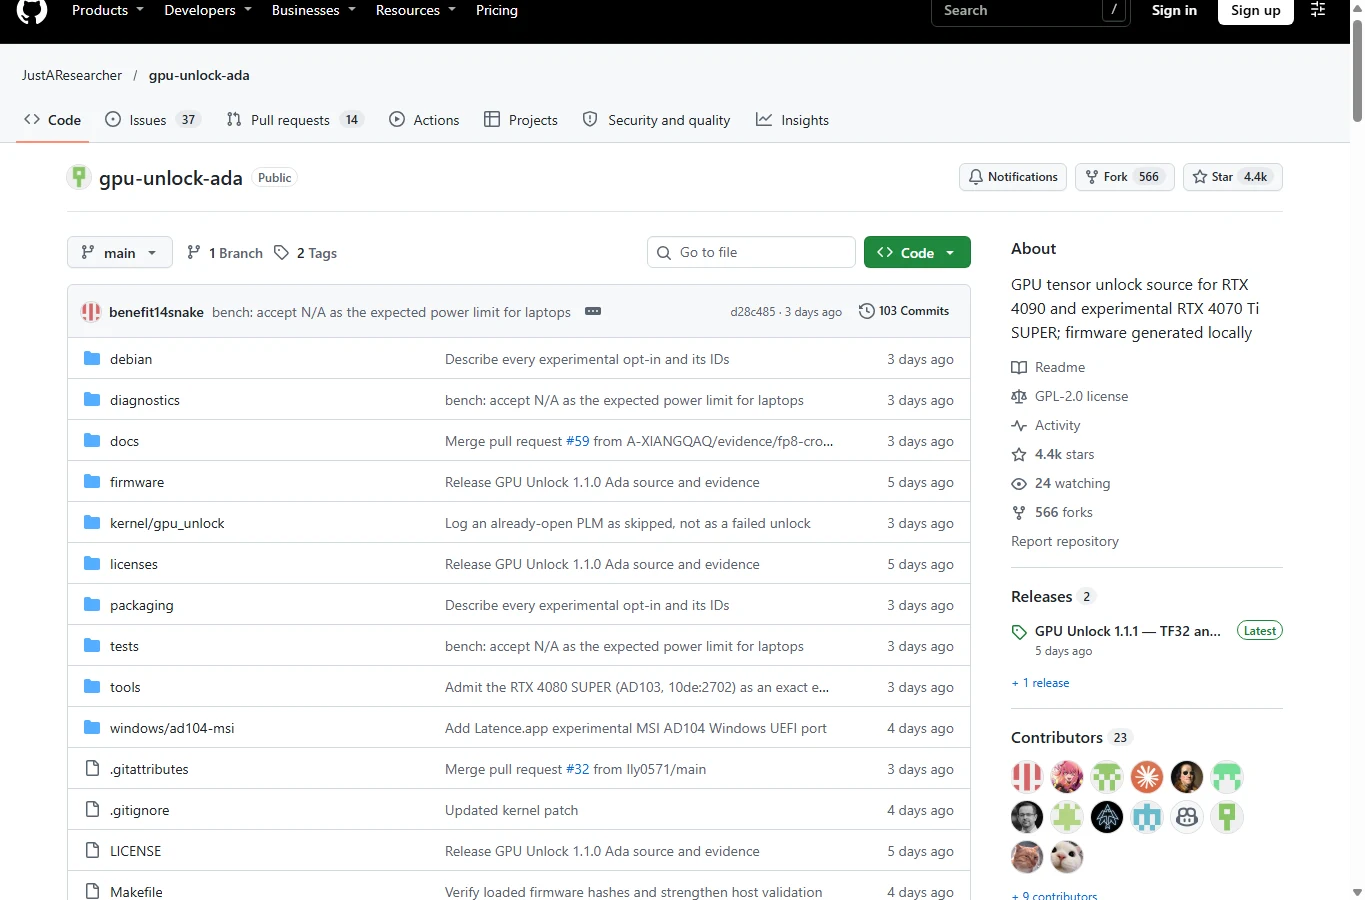
gpu-unlock-ada — JustAResearcher
Esta bifurcación Linux integra firmware y cargas para Ada. El README v1.1.1 conserva evidencia detallada de RTX 4090, incluida una comparación de otro propietario con la misma GPU, binarios, controlador y límite de 450 W. También hay registros experimentales de RTX 4070 Ti SUPER, sin validar toda la familia RTX 40.
Su ventaja es separar tasa de instrucciones, GEMM de cuBLAS y comprobaciones numéricas. La muestra de hardware y las pruebas prolongadas siguen siendo limitadas. Un puerto Windows de referencia para una MSI RTX 4070 Ti concreta no significa compatibilidad general con Windows ni admisión de esa tarjeta en Linux.
FP8 exige matices: las instrucciones FP8 con acumulación FP32 pueden mejorar en Ada, mientras que un GEMM FP8 emparejado apenas cambió. Ni todos los modelos de 8 bits mejoran ni FP8 es siempre ajeno al desbloqueo. Hay que identificar kernel, acumulador y cuello de botella.
KohakUnlock — KohakuBlueleaf
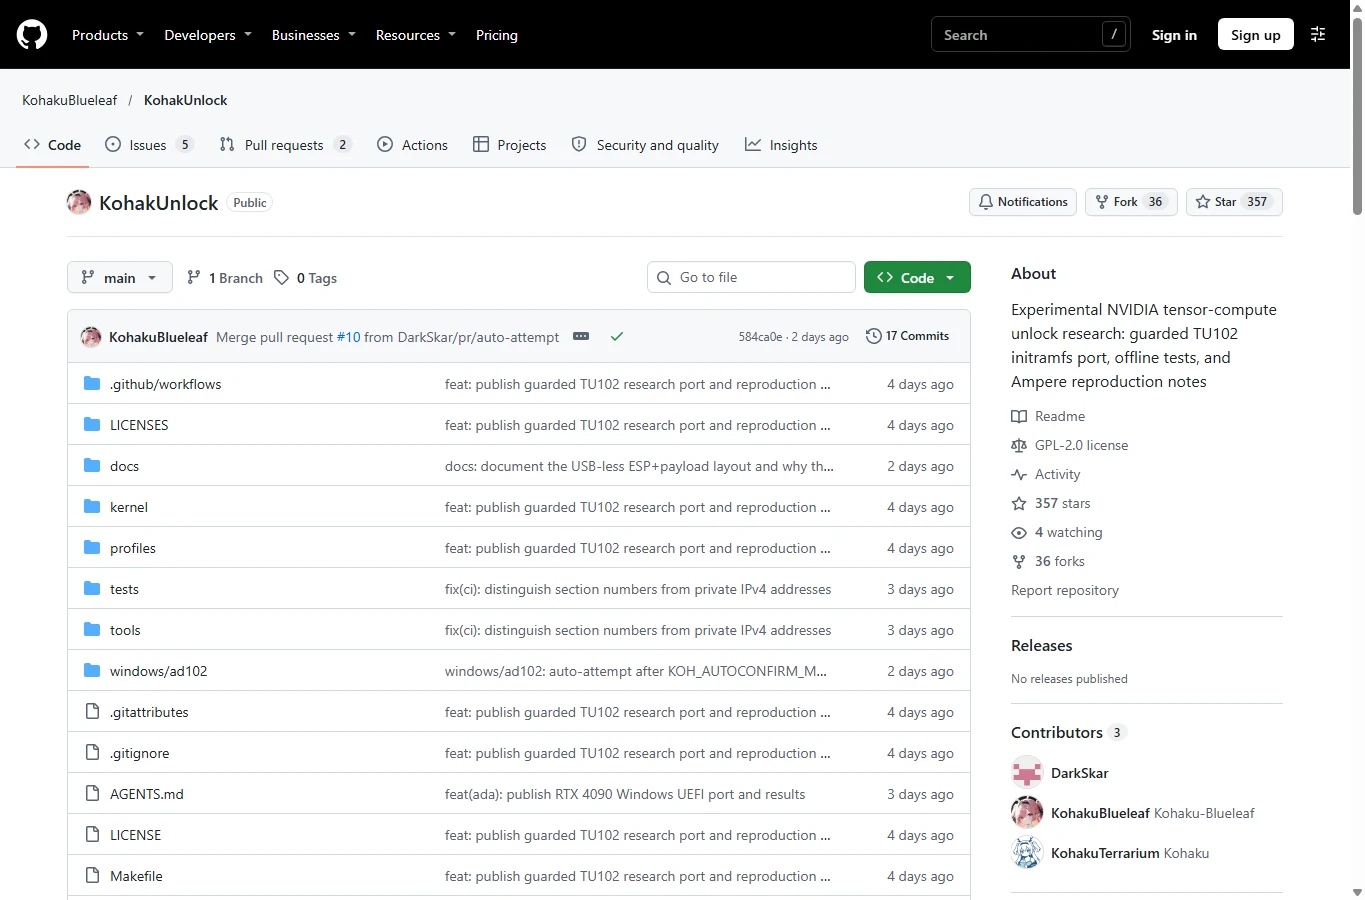
Es un proyecto de investigación centrado en código fuente, no un desbloqueador universal. Documenta RTX 2080 Ti con memoria modificada físicamente en Linux, una ruta Windows/UEFI para RTX 4090 y despliegues RTX 3090 con el código original de Zagitta. Los 22 o 48 GB de ciertas publicaciones proceden de modificaciones físicas, no de esta utilidad.
El ejecutor Linux público desactiva por defecto la operación en hardware y aplica comprobaciones estrictas de identidad y firmware. La ruta Windows utiliza una transacción EFI preparada localmente antes del controlador original. La prueba física exitosa con EFI firmado mantuvo Secure Boot desactivado: admitir firmas en el código no verifica el arranque seguro activado.
La documentación reconoce límites importantes: el barrido de matrices de la 2080 Ti comparó dos tarjetas ya modificadas y la referencia recuperada de la 3090 tenía otro límite de potencia. El empaquetado público tampoco es idéntico a los binarios históricos probados. Es una referencia para desarrolladores con recuperación disponible, no una mejora sencilla para el PC diario.
AD103_win_unlocker — TOTORONG
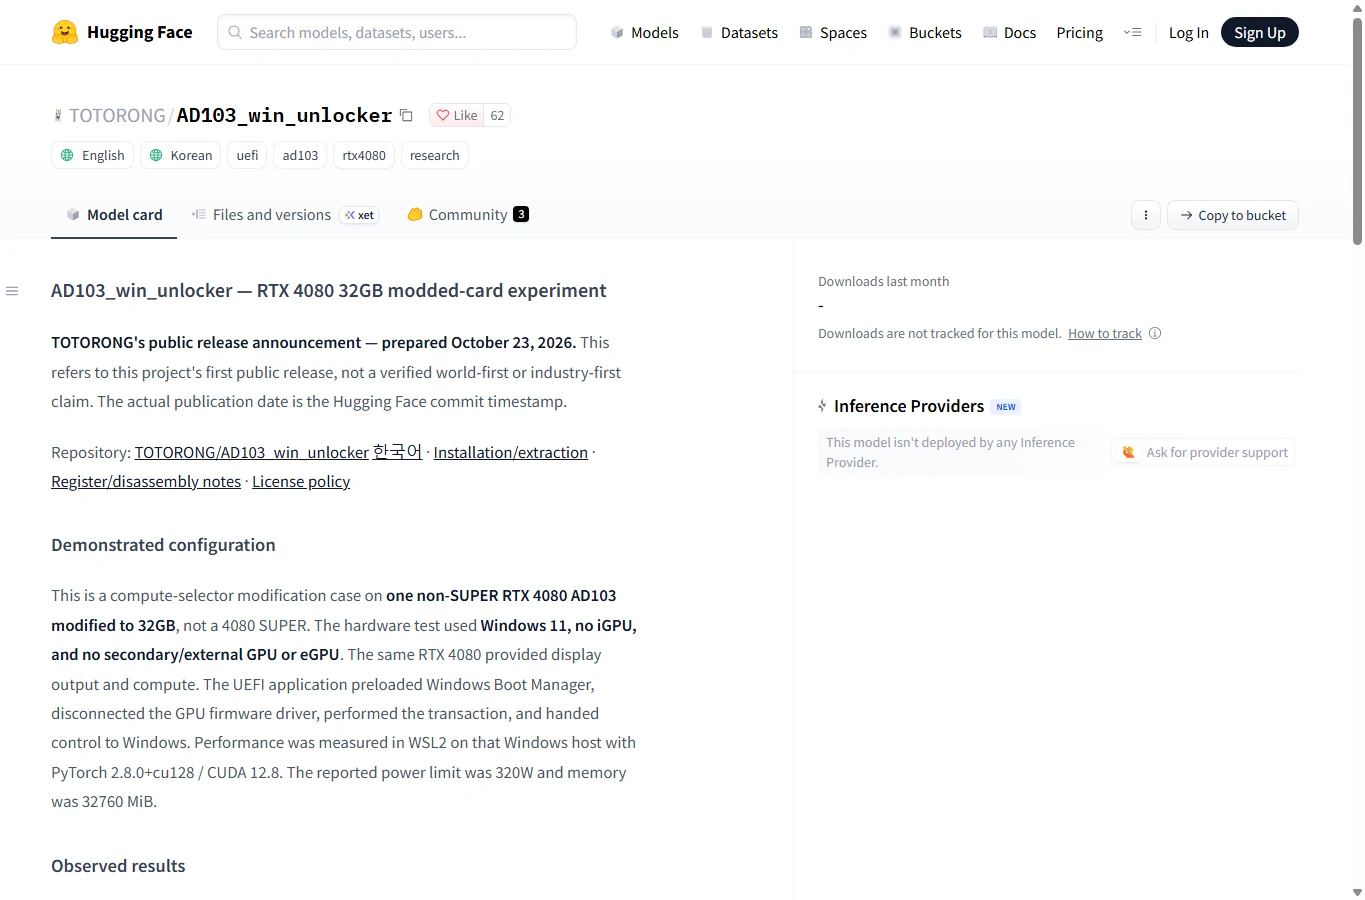
Esta publicación en Hugging Face es investigación Windows/UEFI para Ada, no un modelo generativo ni un servicio GPU. Se demostró con una RTX 4080 no SUPER modificada físicamente a 32 GB, Windows 11 y mediciones WSL2/PyTorch, con límite declarado de 320 W. Es una pieza importante del origen del trabajo Ada.
El EFI distribuido está vinculado a identidad de dispositivo, subsistema y hash de ROM; otra «RTX 4080» puede ser rechazada. Los resultados GEMM dependen del tamaño de matriz y no se afirma acelerar LLM completos, DLSS o trazado de rayos. Cambiar identificadores o hashes no valida un puerto. Conviene como referencia específica, no como descarga genérica para Windows.
Tarjetas RTX y sistemas compatibles
| Generación | Evidencia útil | Límite |
|---|---|---|
| RTX 30 / Ampere | Informes de 3090, 3090 Ti y 3060; mayor base del proyecto original | Confirmar placa, PCI ID, kernel, controlador y revisión; validación desigual por modelo |
| RTX 40 / Ada | Comparación RTX 4090 y puertos experimentales de placas concretas | Separar Linux de Windows/UEFI; una placa no valida toda la serie |
| RTX 20 / Turing | Mediciones 2080 Ti FP16→FP32 | No añade BF16/TF32 nativos; tarjetas modificadas no garantizan las originales |
| RTX 50 / Blackwell | No compatible con el enfoque revisado | Sin desbloqueo 5090 verificado; una dificultad no equivale a una versión disponible |
El README del 29 de octubre amplía la lista respecto a las noticias del 24–26 de octubre. Son instantáneas distintas, no garantías contradictorias. En portátiles, apagar la GPU dedicada puede borrar el estado volátil: gestión energética y suspensión requieren verificación específica.
El idioma no cambia la compatibilidad del hardware. Son repositorios técnicos, principalmente en inglés; TOTORONG también ofrece material coreano. Una explicación en español no amplía las placas admitidas ni convierte el procedimiento en un servicio localizado.
Qué demuestran las pruebas de cálculo
La comparación RTX 4090 del repositorio Ada mantuvo Linux 7.2.11-arch1-1, NVIDIA 615.78.08 y 450 W. FP16/FP32 pasó de 160,4 a 320,4 TFLOPS y BF16/FP32 de 159,7 a 320,2. Sin embargo, las medianas GEMM FP16 solo mejoraron un 12–34%; BF16 ganó aproximadamente 16–20% en dos tamaños y prácticamente nada en 4096³. Es una pareja de mediciones de un propietario, no aplicaciones al doble de velocidad.
El informe #150 de Zagitta describe una RTX 3060 de 12 GB a 170 W, Ubuntu 26.04.1, NVIDIA open 595.99.02 y PyTorch 2.14.1+cu130. Su GEMM 8192³ mejoró aproximadamente 78% en FP16, 81% en BF16 y 76% en TF32. Verifica viabilidad en esa configuración, no un aumento equivalente en generación de imágenes para todas las 3060.
KohakUnlock midió 59,9→111,0 TFLOPS en instrucciones FP16→FP32 sobre la misma 2080 Ti, con controles FP16→FP16 e INT8 casi planos. Las mejores medianas del barrido, 57,71 frente a 88,24 TFLOPS, pertenecen a dos tarjetas modificadas y tamaños óptimos distintos. No son un A/B controlado de la misma tarjeta con un 53% de mejora.
Tom’s Hardware y Notebookcheck informaron de los proyectos y sus límites. Remiten principalmente a pruebas de desarrolladores y propietarios; sus noticias no son dos reproducciones adicionales de laboratorio independiente.
Tom’s Hardware · Notebookcheck
ComfyUI, LLM y entrenamiento en la práctica
La prueba ComfyUI de u/under-_-null utilizó una EVGA FTW3 RTX 3090 Ti, Ubuntu, NVIDIA 615.71.09, ComfyUI 0.42.1, frecuencias originales y techo de 450 W. Para cada configuración de imagen hubo tres calentamientos excluidos y 15 imágenes por estado, lote 1, mismos prompts, semillas y archivos. Las medianas cubren la solicitud completa salvo la carga inicial del modelo.
Prueba ComfyUI del propietario y condiciones
| Flujo | Original → desbloqueado | Más rendimiento | Menos tiempo |
|---|---|---|---|
| MOSS-Image SFT BF16 | 71,98 s → 45,40 s | +58,5% | 36,9% |
| MOSS-Image SFT INT8 | 27,31 s → 27,23 s | +0,3% | 0,3% |
| Qwen-Image 2.1 Turbo BF16 | 8,51 s → 5,41 s | +57,3% | 36,4% |
| Qwen-Image 2.1 Turbo INT8 | 3,92 s → 3,75 s | +4,5% | 4,3% |
| Z-Image Turbo BF16 | 6,79 s → 4,35 s | +56,1% | 35,9% |
| Krea 2 Turbo BF16 | 15,65 s → 10,70 s | +46,3% | 31,6% |
MOSS usó 1024×1024 y 50 pasos; Qwen, Z-Image y Krea Turbo, 1024×1024 y 8 pasos. Recalculamos rendimiento como tiempo original ÷ tiempo desbloqueado − 1, y ahorro como 1 − tiempo desbloqueado ÷ original. Las pequeñas diferencias con el autor son redondeos. Un 59% más de rendimiento equivale aproximadamente a un 37% menos de espera, no a un 59%.
El propietario indicó píxeles RGB decodificados idénticos en 150 parejas de imágenes. Es evidencia para esos flujos, no una garantía numérica universal. Su checkpoint FLUX FP8 calculaba realmente en BF16. Un flujo INT8 también puede conservar etapas flotantes; hace falta perfilarlo antes de atribuir ganancias pequeñas o grandes a una ruta concreta.
En LLM conviene separar prefill y decode. Otro informe comunitario con límites fijos observó alrededor de 15% más de prefill en una 3060 y decode prácticamente igual. Kernels enteros, ancho de banda, descarga a CPU y PCIe pueden dominar. El entrenamiento BF16 o LoRA podría beneficiarse, pero un gráfico de matrices no demuestra menor tiempo total ni convergencia sin cambios.
Ejemplo calculado, no medido: si el cálculo elegible ocupa el 40% del tiempo y duplica su velocidad, el trabajo completo acelera 1 ÷ (0,60 + 0,40/2) = 1,25×; ahorra 20% de tiempo. Así pueden coexistir instrucciones al doble y mejoras modestas de aplicación.
Informe comunitario de prefill y decode
Potencia, temperatura y energía por tarea
Terminar antes puede reducir energía por imagen aunque suba la potencia instantánea. Vatios, julios por tarea y temperatura describen cosas distintas. Los datos no establecen que desbloquear siempre reduzca el consumo instantáneo.
En MOSS BF16, el propietario de la 3090 Ti registró una media de núcleo de 77,9°C original y 78,7°C desbloqueada. Otros flujos bajaron, pero no controló temperatura inicial ni ambiente y faltan VRAM junction y hotspot. No demuestra funcionamiento más frío ni seguridad a largo plazo.
Mantén el mismo límite de potencia en el A/B. Reducirlo puede ser un experimento de eficiencia separado y limitar la ganancia; cambiarlo entre estados confunde causas. Mide trabajos completos, resultados, energía y temperatura antes de perseguir TFLOPS aumentando voltaje o potencia.
Instalación, recuperación y mantenimiento
No flashear VBIOS no garantiza recuperación. KohakUnlock enumera bloqueos de GPU/host, fallos de arranque, corrupción de datos y daños posibles. Un reinicio en caliente puede no limpiar todo el estado; una instalación persistente puede volver a aplicar el desbloqueo al arrancar.
Antes de experimentar, identifica placa y revisión exactas, guarda copias y claves de recuperación del cifrado, conserva el arranque normal y prepara consola local/BMC y control completo de alimentación. No desactives Secure Boot o IOMMU sin evaluar sus implicaciones ni elimines controles para forzar una GPU ya tomada por el controlador. Si falla antes de la red, SSH no está disponible.
La aceptación requiere tres niveles: arranque y entrega al controlador original; comprobaciones numéricas reproducibles sin errores Xid; y el benchmark de tu aplicación con condiciones iguales. Ninguno certifica resistencia. Repite tras cambios de kernel/controlador y suspensión. Respeta licencias de firmware y elimina identificadores privados de los registros compartidos.
Los proyectos fuente revisados no cobran suscripción. El coste es configuración, recuperación, mantenimiento y posibles interrupciones. Son componentes locales privilegiados: ejecutar binarios desconocidos concede mucho más acceso que abrir un archivo de modelo.
Para quién tiene sentido
Tiene sentido evaluarlo con una RTX 30 secundaria compatible o un perfil Ada/Turing documentado, experiencia técnica, trabajo BF16/FP16 y un plan de recuperación. Compara además con el flujo cuantizado más rápido cuya calidad aceptes, no solo con una precisión más lenta.
Mantén la configuración original en una estación crítica, una 5090 no compatible, un portátil sin perfil validado o tareas dominadas por memoria e INT8. El valor está en aprovechar rutas Tensor Core existentes. Decide por el tiempo verificable que ahorras frente a la complejidad de arranque y la estabilidad a largo plazo aún incierta.
Relacionados Reseñas
GPT-Image-2.5: análisis 2026 de Flare, Sunburst, precios y NSFW

Análisis de Krea 3: edición, Ultra, costes reales y uso local
Nucleus Image: análisis de Sparse MoE, uso local y límites NSFW
Los 6 mejores escaladores de imágenes con IA de 2026
Reseña de ERNIE-Image: IA de imagen open source, LoRA, uso local y NSFW
Los 8 mejores software de base de conocimientos en 2026
