
KI-Bilder lokal oder online: Was lohnt sich 2026?
Starten Sie online, wenn Sie nur gelegentlich Bilder erstellen, mit Laptop oder Smartphone arbeiten oder per Gespräch nachbearbeiten möchten. Lokal lohnt sich ein Einstieg besonders mit bereits vorhandener, geeigneter GPU und wiederkehrenden Modellen, LoRAs und Abläufen. Eine teure Grafikkarte nur für die Ersparnis eines monatlichen Abos zu kaufen, amortisiert sich oft erst nach Jahren.
„Lokal“ beschreibt den Ausführungsort des Modells. Daraus folgen weder automatisch bessere Qualität noch schlechteres Promptverständnis, unbegrenzte Inhaltsrechte oder Kostenfreiheit. Dasselbe herunterladbare Modell kann auf Ihrem PC und über eine kostenpflichtige, gehostete API laufen. Gewichte, Rechengenauigkeit, Einstellungen und Moderation sind wichtiger als der Ort allein.
| Kriterium | Lokale Inferenz | Online-Bilderzeugung |
|---|---|---|
| Anschaffung | GPU oder geeigneter vorhandener Rechner; Speicherplatz und Einrichtung | Meist kein GPU-Kauf; kostenlose Tests, Abos oder API-Guthaben |
| Bildqualität | Abhängig von Modellgewichten, Ablauf und verfügbarem Speicher | Zugriff auf gehostete und geschlossene Modelle; Anbieter legt Verarbeitung fest |
| Text und Prompts | Moderne Modelle verstehen natürliche Sprache; ältere oder spezialisierte Modelle bevorzugen teilweise Tags | Dialog erleichtert Änderungen; erzeugte Schrift muss weiterhin geprüft werden |
| NSFW | Modell-, lizenz- und anwendungsabhängig; keine allgemeine Erlaubnis | Je nach Dienst: teils ausschließlich SFW, teils breitere Fähigkeiten für sensible Inhalte |
| Tempo und Grenzen | Hardware, Auflösung und Stapelgröße; bei vollständig lokaler Inferenz kein Anbieterkontingent | Warteschlangen, Tarif, Guthaben, Anfragelimits und Qualitätsmodus |
| Anime / Realismus | Spezialisierte Modelle und passende LoRAs erlauben gezielte Steuerung | Anime-Dienste und allgemeine Modelle haben unterschiedliche Stärken |
| Wartung / Datenschutz | Sie verwalten Abhängigkeiten, Dateien und Backups; offline können Eingaben lokal bleiben | Wenig Einrichtung; Datenverarbeitung und Sichtbarkeit hängen vom Dienst ab |
Diese Kaufberatung basiert auf Quellen, geprüft am 8. September 2026, und ist kein kontrollierter Vergleichstest sämtlicher Modelle. Herstellerangaben zur Geschwindigkeit sind entsprechend gekennzeichnet; Rechenbeispiele nennen ihre Annahmen. Hardware wird mit deutschen Händlerpreisen in Euro verglichen. Bei Abos nennen wir den Kaufkanal; zu veröffentlichten Dollarpreisen stehen datierte, unverbindliche Euro-Umrechnungen.
Ein praktischer Ablauf: erst erzeugen, dann fertigstellen
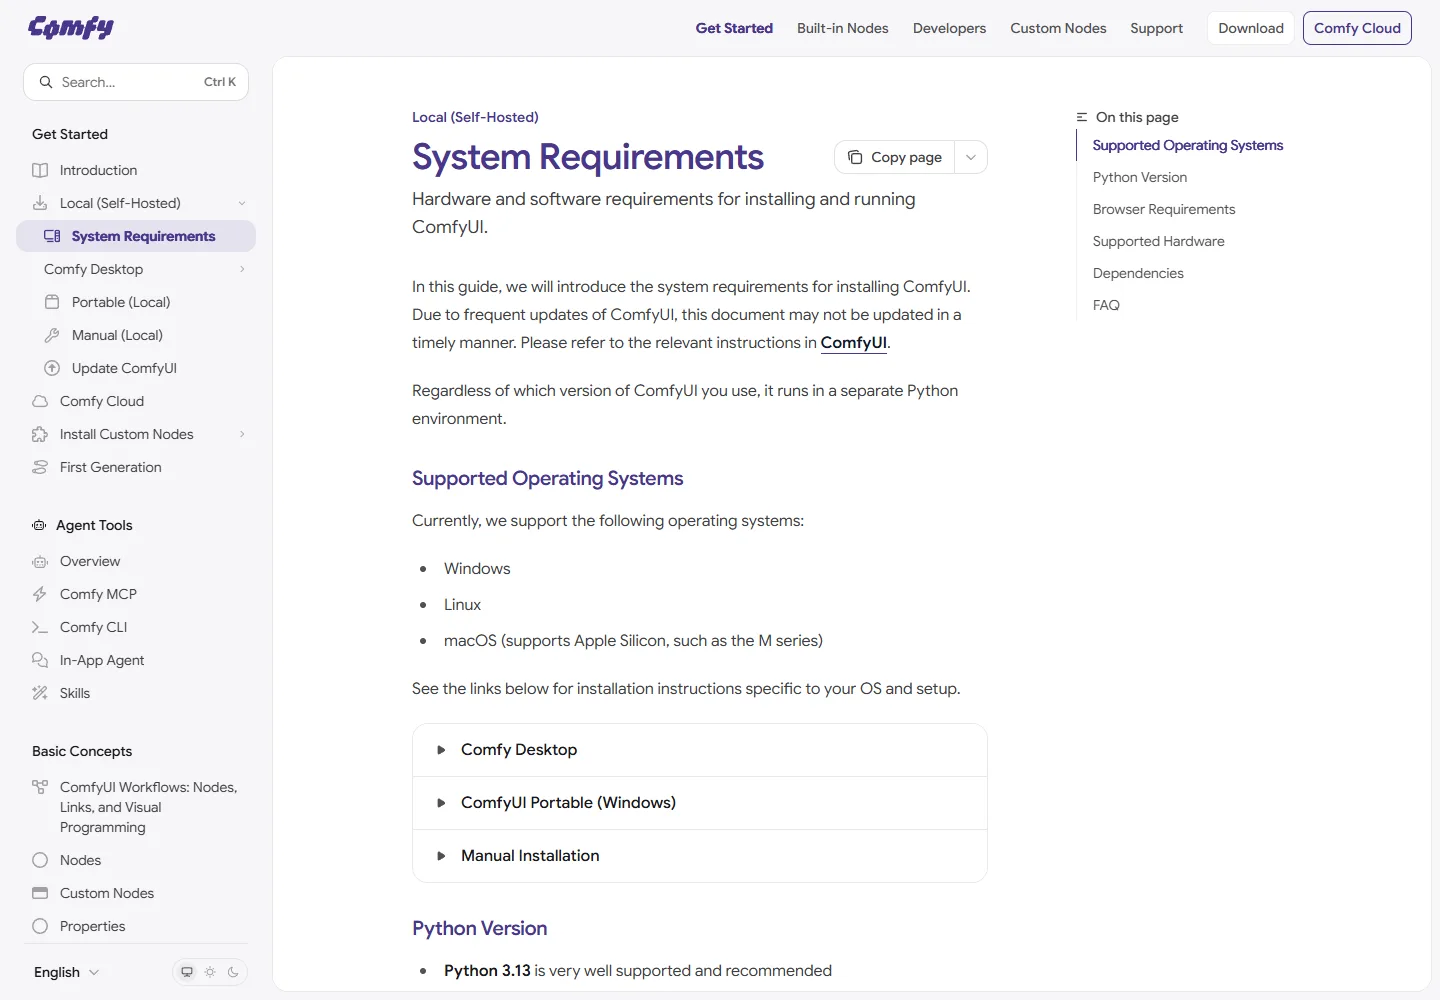
1. Inferenzumgebung wählen. ComfyUI ist eine quelloffene Oberfläche für Arbeitsabläufe samt Inferenz-Engine, kein Bildmodell. Es kann Generierung, Bearbeitung und weitere Schritte verbinden. Auch eine lokale Installation kann kostenpflichtige Remote-API-Knoten enthalten. Prüfen Sie diese, bevor Sie davon ausgehen, dass Bilder auf Ihrem Rechner bleiben.
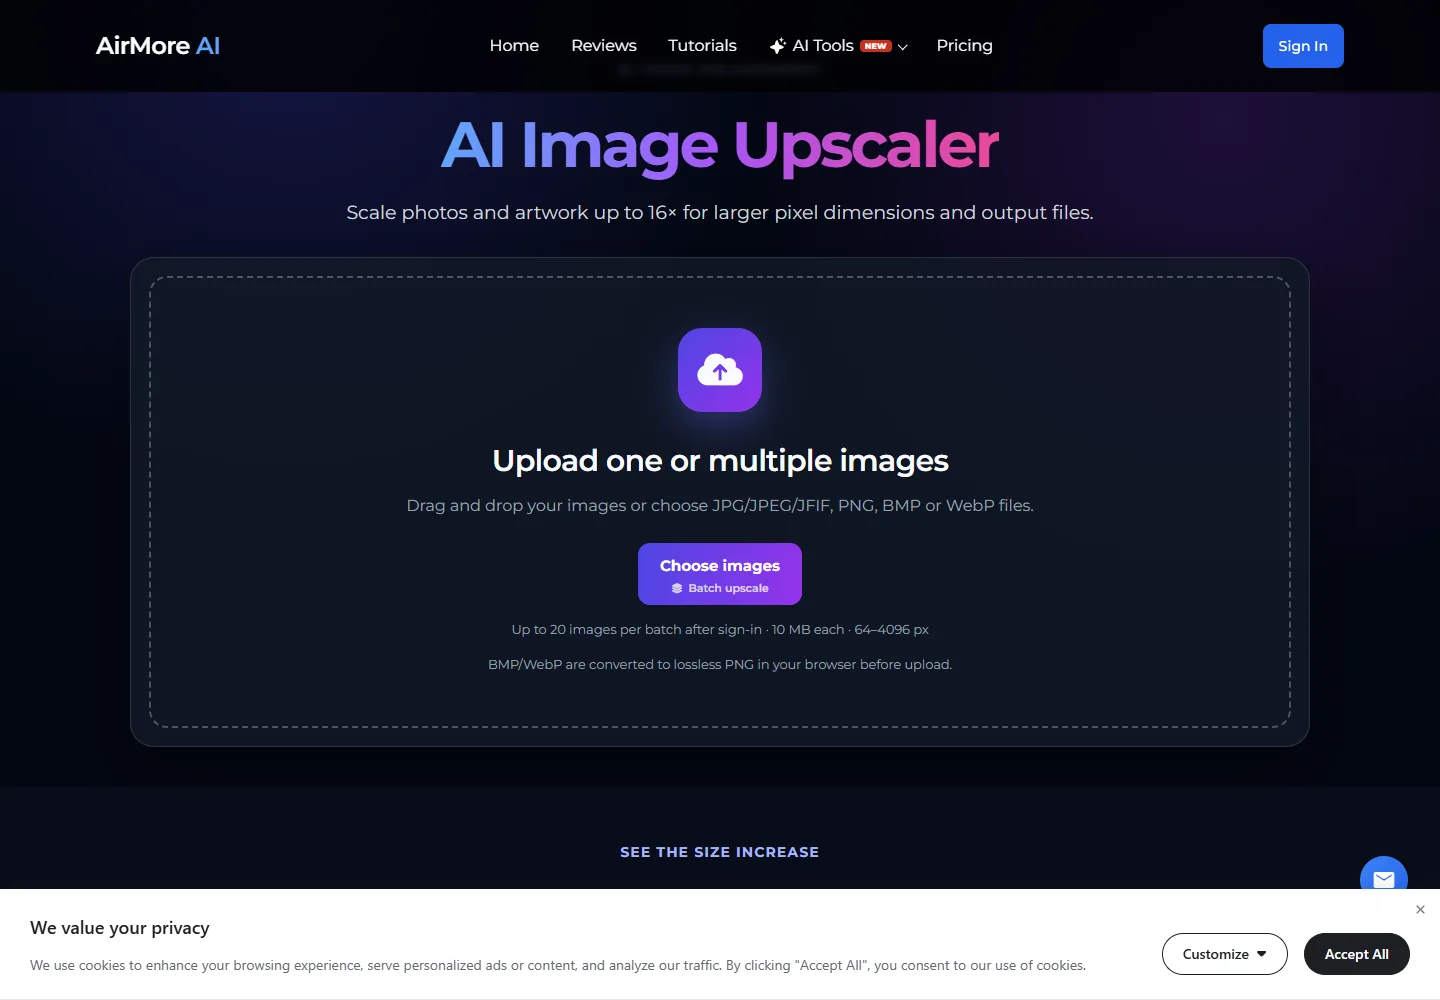
2. Nur das ausgewählte Bild fertigstellen. Ist das Ergebnis richtig, aber zu klein, kann der AirMore KI-Bild-Upscaler im Browser seine Pixelabmessungen erhöhen. Das Werkzeug vergrößert Bilder, ersetzt jedoch keinen Generator. Es korrigiert Schreibfehler nicht zuverlässig und garantiert keine sachlich korrekten rekonstruierten Details. Für sensible oder vertrauliche Dateien sollte die Nachbearbeitung Ihren Datenanforderungen entsprechen.
Getrennte Generierung und Nachbearbeitung verhindern, dass hochauflösende Guthaben schon für Dutzende Entwürfe verbraucht werden, bevor die Komposition feststeht. Prüfen Sie zunächst den kleinen Entwurf und investieren Sie danach Zeit und Rechenleistung in die gewählte Fassung.
Preisvergleich: GPU kaufen, Abo buchen oder API nutzen?
Kalkulieren Sie lokal das gesamte System: Grafikspeicher, Arbeitsspeicher, SSD-Platz, passendes Netzteil und Kühlung. Modelldateien können viel Speicherplatz belegen. Als unverbindlicher Ausgangspunkt bieten 16 GB VRAM und 32 GB RAM mehr Spielraum als eine kleine Einsteiger-GPU. Sie garantieren aber nicht, dass jeder große Ablauf passt. Umfangreiche Modelle benötigen eventuell mehr Speicher oder langsameres Auslagern auf die CPU.
| In Deutschland angebotenes Modell | Grafikspeicher | Euro-Preis bei ALTERNATE | Steuern / Versand |
|---|---|---|---|
| ASUS RTX 5060 Ti DUAL OC 16GB | 16 GB | 722,00 € | inkl. MwSt.; Standardversand kostenlos |
| ZOTAC RTX 5070 Ti SOLID OC SFF | 16 GB | 1.179,00 € | inkl. MwSt.; Versand ab 7,99 € |
| MSI RTX 5090 32G VENTUS 3X OC | 32 GB | 5.731,00 € | inkl. MwSt.; Versand ab 7,99 € |
Preisabruf am 8. September 2026 für die genannten Ausführungen bei ALTERNATE. Das sind weder Marktbestpreise noch NVIDIAs Einführungspreise. Verfügbarkeit und Gesamtbetrag vor der Bestellung prüfen. Gleiche 16 GB bedeuten nicht gleiche Geschwindigkeit; 32 GB bieten mehr Platz für große Abläufe, erfordern aber gegebenenfalls zusätzliche Ausgaben für Netzteil und Kühlung.
| Online-Option | Preis und Euro-Orientierung | Was enthalten ist |
|---|---|---|
| ChatGPT Plus | 22,99 € (Preisbeispiel im deutschen App Store) | ChatGPT-Zugang mit Bildlimits; API-Nutzung wird separat berechnet |
| Midjourney | Monatliche Zahlung: Basic 10 USD (ca. 8,60 €); Standard 30 USD (ca. 25,81 €); Pro 60 USD (ca. 51,63 €); Mega 120 USD (ca. 103,25 €) | Fast-GPU-Zeit je nach Tarif; ab Standard auch Relax-Bilderzeugung |
| NovelAI | Monatliche Zahlung: Tablet 10 USD (ca. 8,60 €); Scroll 15 USD (ca. 12,91 €); Opus 25 USD (ca. 21,51 €) | Anlas und Tarifvorteile; kostenlose V5-Opus-Generierungen haben ein nachfüllendes Kontingent |
| FLUX.2 klein 4B API | Ab 0,014 USD je Bild mit 1 MP (ca. 0,012 €) | Abrechnung je Bild; größere Ausgaben und Bearbeitungen können mehr kosten |
| GPT Image 2 API | Je Million Bildtokens: Eingabe 8 USD (ca. 6,88 €), Ausgabe 30 USD (ca. 25,81 €); Texteingabe 5 USD je Million (ca. 4,30 €) | Standardpreise je Token; Qualität, Größe und Eingabebilder beeinflussen den Gesamtpreis |
Der ChatGPT-Plus-Betrag ist ein Preisbeispiel für iOS; den Abrechnungszeitraum bitte im Kaufdialog prüfen. Der Webpreis kann abweichen. Laut OpenAIs Abrechnungsinformationen ist EUR für Web-Abos verfügbar; App-Abos werden über die Stores abgerechnet, API-Guthaben wird in USD gekauft.
Quellen: ChatGPT Plus, Midjourney-Tarife, NovelAI-Abos, BFL-Preise und OpenAI-API-Preise. Cache-Eingaben und Stapelverarbeitung haben andere Tarife. Monatliche und jährliche Abrechnung sind nicht gleichzusetzen; Steuern können hinzukommen. Ein Web-Abo enthält nicht automatisch API-Guthaben.
Unverbindliche Umrechnung: Referenzkurse der Banque de France vom 7. September 2026: 1 EUR = 1,1622 USD, also 1 USD ≈ 0,860437 EUR, gerundet. Die Euro-Beträge für Midjourney, NovelAI und APIs sind keine festen deutschen Verkaufspreise. Eventuelle Steuern und Kartenwechselgebühren sind nicht enthalten. Laut Midjourneys Steuerhinweisen können beim Bezahlen abhängig von der Rechnungsadresse Steuern hinzukommen.
Amortisationsrechnung mit angenommenen Beträgen: 800 € zusätzliche Hardware, ein gekündigtes Abo für 30 €/Monat und 5 €/Monat laufende lokale Kosten ergeben 800 ÷ (30 − 5) = 32 Monate. Ein angenommener Komplett-PC für 1.500 € benötigt 60 Monate. Das ist ein eigenständiges Rechenbeispiel, kein Angebot für die genannten Karten oder einen bestimmten Tarif. Bleibt das Abo bestehen, entfällt die Ersparnis. Wiederverkauf, Reparaturen und Einrichtungszeit sind nicht eingerechnet.
Stromkosten als Rechenbeispiel: angenommene 0,35 kW für den gesamten PC × 30 Stunden × hypothetische 0,25 €/kWh = 2,625 €, gerundet 2,63 €. Dies ist weder ein gemessener GPU-Verbrauch noch ein allgemeiner deutscher Stromtarif. Setzen Sie Ihren Vertragspreis und eigene Messungen ein. Auch Einrichtung und Fehlerbehebung kosten Zeit.
Bei gelegentlicher Nutzung kann nutzungsabhängige Abrechnung günstiger sein als ein Abo oder neue Hardware. Mit vorhandener GPU und großen Mengen wird lokale Inferenz attraktiver. Vergleichen Sie Kosten pro akzeptiertem Bild: Ein hypothetischer Versuch für 0,03 € kostet bei 25 % brauchbaren Ergebnissen 0,12 € je verwendbarem Bild, noch ohne Retusche.
Lokale Modellleistung: nach Aufgabe statt Parameterzahl wählen
FLUX.2 [klein] 4B ist ein kompakter Kandidat für lokale Generierung und Bearbeitung. Die 4B-Gewichte stehen unter Apache 2.0; die 9B-Gewichte haben eine andere, ohne gesonderte Lizenz nicht kommerzielle Lizenz. Nicht alle FLUX-Downloads haben dieselben kommerziellen Bedingungen. Offizieller Leitfaden zu lokaler Nutzung und Lizenzen.
BFL nennt etwa 8,4 GB und 1,2 Sekunden für destillierte 4B-Inferenz auf einer RTX 5090; der umfassendere Ablaufleitfaden spricht von etwa 13 GB. Das betrifft unterschiedliche Speicherumfänge und garantiert keine passende Nutzung auf einer 8-GB-Karte. Planen Sie Platz für Encoder, Decodierung und Bearbeitungseingaben ein. Die 5090-Zeit lässt sich nicht auf eine 5060 Ti übertragen. Leistungstabelle des Herstellers; Hinweise zum Ablauf.
Qwen-Image-2512 ist ein herunterladbares Modell mit rund 20 Milliarden Parametern, das für realistische Motive und textreiche Bildlayouts einen Test wert ist. Die offizielle Modellkarte betont verbesserten Realismus sowie englische und chinesische Schrift. Das Modell ist groß: Quantisierung und CPU-Auslagerung können Speicherprobleme lösen, aber Tempo und Ergebnisse verändern. Diese konkrete Download-Version dient hier als Vergleichspunkt; sie wird nicht als neuestes Produkt der gesamten Qwen-Familie bezeichnet. Offizielle Modellkarte und Apache-2.0-Lizenz.
Z-Image-Turbo ist ein auf Effizienz ausgelegtes destilliertes Modell mit 6 Milliarden Parametern. Der Entwickler nennt 8 Funktionsauswertungen, fotorealistische Ausgabe, englische und chinesische Schrift sowie Eignung für Consumer-Geräte mit 16 GB. Die beworbene Latenz unter einer Sekunde wurde auf einer H800 für Unternehmen erzielt, nicht auf einer üblichen Heim-GPU. Offizielle Modellkarte.
Für Anime können ein passendes spezialisiertes Modell oder LoRA wichtiger sein als das größte allgemeine Modell. Ein LoRA ist eine kleine Anpassung für eine bestimmte Modellfamilie, kein universelles Stil-Plug-in. Beginnen Sie mit einem funktionierenden Beispiel für die genaue Basisversion. Unser englischer Download-Leitfaden für Modelle und LoRAs erläutert Quellenprüfung und Kompatibilität.
Online-Modelle: Bearbeitung, Ästhetik und Anime-Spezialisierung
Offizielle Webzugänge: ChatGPT · Midjourney · NovelAI.
ChatGPT Images 2.0 / GPT Image 2 ist die dialogorientierte Option dieses Vergleichs. Sie beschreiben eine Szene und verlangen anschließend gezielte Änderungen mit dem vorherigen Bild als Kontext. Das erleichtert Marketingentwürfe und Layouts, deren Anforderungen sich im Gespräch verändern. Das API-Modell wird getrennt vom ChatGPT-Produkt dokumentiert. Offizielle Ankündigung zu Images 2.0; API-Dokumentation zu GPT Image 2.
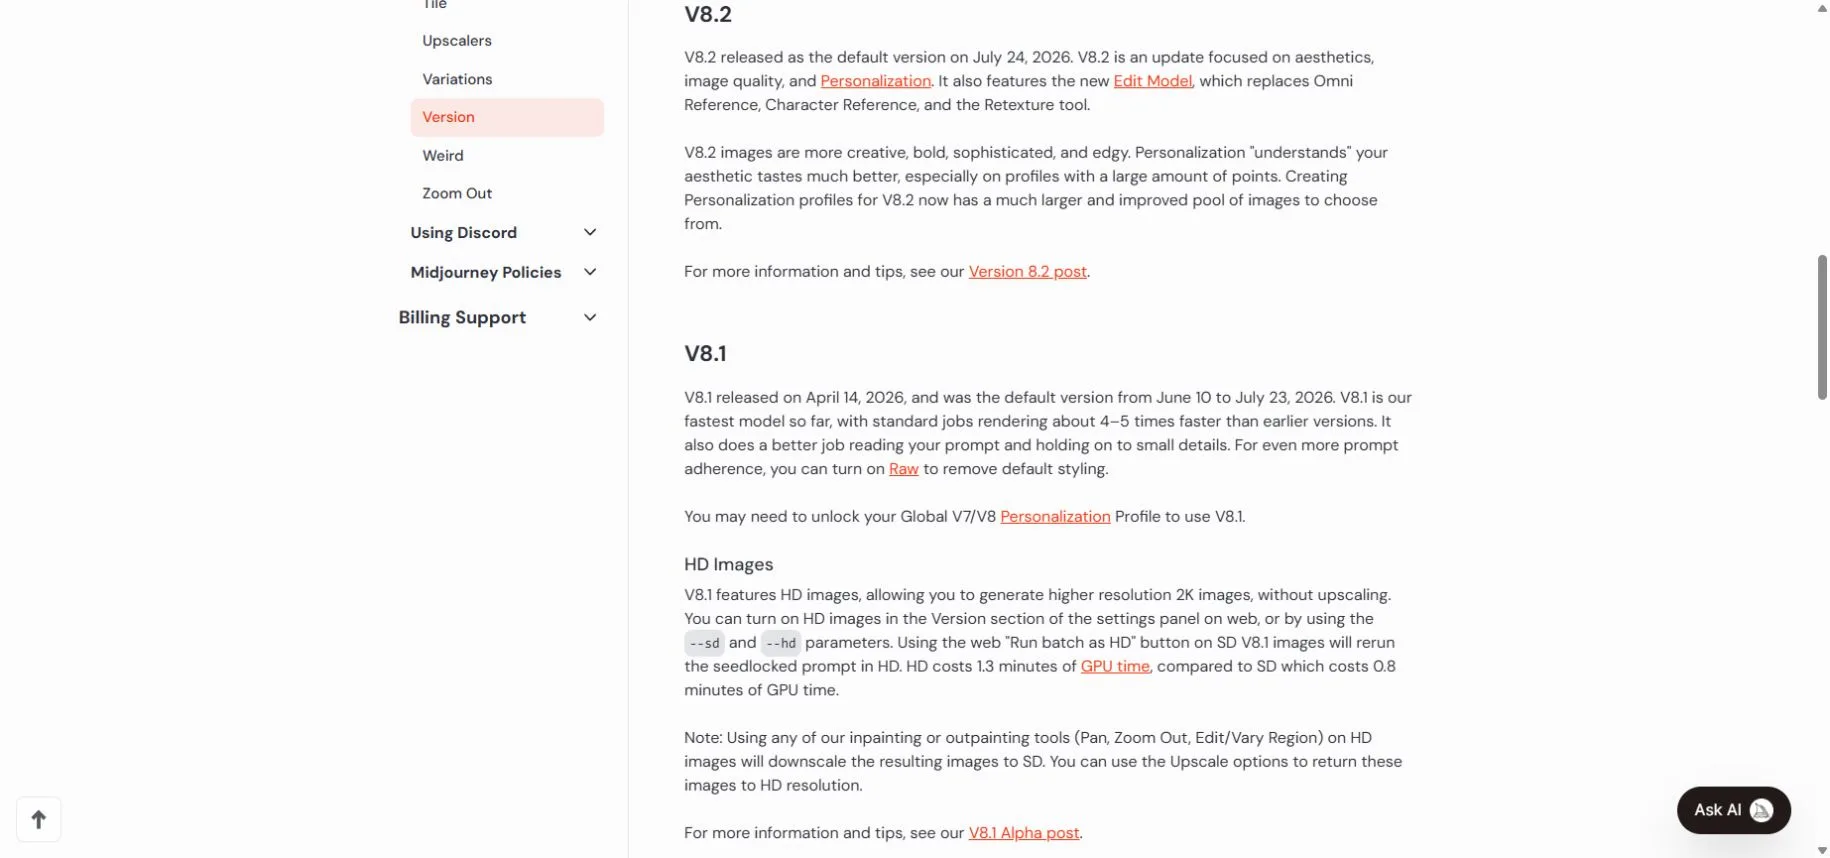
Midjourney V8.2 wurde laut Versionsdokumentation am 24. Juli 2026 zum Standard. Im Mittelpunkt stehen Ästhetik und Personalisierung sowie ein neues Edit Model. Für Anime bietet derselbe Dienst Niji 7. Midjourney kommt infrage, wenn die visuelle Richtung die Hauptaufgabe ist; das belegt keine Überlegenheit bei exakten Produktetiketten oder komplexen Anweisungen. Aktuelle Versionen und Modellunterschiede.
NovelAI Diffusion V5 verbindet Anime-Generierung mit natürlichsprachlichen Prompts, Japanisch-Unterstützung, Steuerung mehrerer Figuren und verbesserter Schrift. Full hat eine breitere Trainingsabdeckung; Curated soll unerwünschte sensible Ergebnisse reduzieren. Diese Funktionen sind insbesondere für Figurenszenen und Comics relevant. Offizielle V5-Modellinformationen.
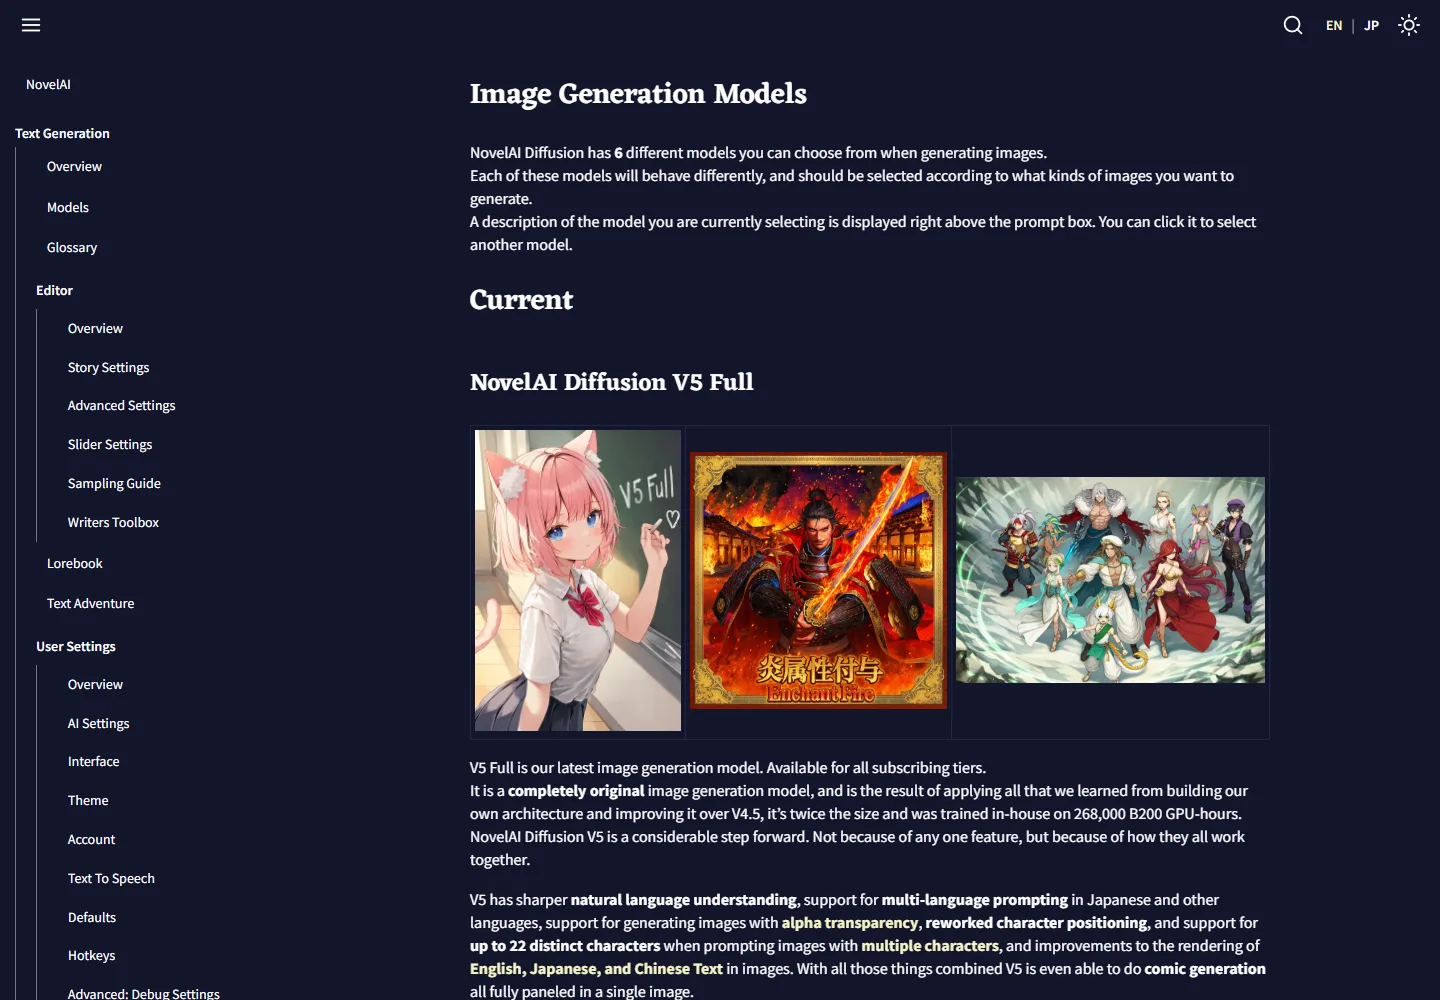
Das sind unterschiedliche Arbeitsweisen, keine allgemeingültige Rangliste. Bei wechselnden Anforderungen ist dialogbasierte Bearbeitung interessant, bei der Suche nach einer Bildsprache ein Stilsystem und bei wiederkehrenden Illustrationen eine explizite Figurensteuerung. Testen Sie schwierige eigene Beispiele vor einem Jahresabo.
Bildschrift und Promptverständnis sind zwei Fähigkeiten
Promptverständnis bedeutet, Objekte, Farben, Positionen und Handlungen richtig zuzuordnen. Textdarstellung bedeutet, die gewünschten Zeichen korrekt ins Bild zu zeichnen. Ein Modell kann ein schönes Plakat mit falsch geschriebenem Titel erzeugen oder richtig schreiben, aber die falsche Person das Produkt halten lassen.
| Test | Anforderung | Prüfpunkte |
|---|---|---|
| Beziehungen | Rote Tasse links neben blauem Buch; grüne Pflanze hinter beiden | Objektanzahl, Links-rechts-Position und Farbzuordnung |
| Exakter Text | Kurze Überschrift in Anführungszeichen und separater Preis | Fehlende Buchstaben, veränderte Ziffern, zusätzliche Wörter und Ausrichtung |
| Mehrsprachige Typografie | Deutscher Satz mit ä, ö, ü und ß; japanischer Test mit Kanji, Kana und Ziffern | Umlaute, Sonderzeichen, Satzzeichen und Abstände; japanisch auch kleine Kana und Langvokalzeichen |
| Bearbeitung | Nur Hintergrund ändern, Verpackung und Etikett beibehalten | Ob angeblich unveränderte Details neu gezeichnet wurden |
Beginnen Sie mit klarer Alltagssprache: „Erstelle ein quadratisches Plakat für ein erfundenes Café. Setze eine blaue Tasse links und die Überschrift ‚Morgenmischung‘ nach oben. Lass das untere Drittel frei.“ Ändern Sie anschließend jeweils einen Punkt. So sind Fehler meist leichter zu finden als in einem Absatz widersprüchlicher Stiladjektive.
Moderne lokale Modelle können ebenfalls Fließtext verstehen. Ein mit Tags trainiertes Anime-Modell reagiert eventuell besser auf dokumentierte Tags und Gewichtungen; ein Gesprächsdienst erschließt Absichten im Dialog. Die Schwierigkeit hängt von Modell und Steuerung ab, nicht allein von lokaler Ausführung. Übertragen Sie alte Negativ-Prompt-Rezepte nicht ungeprüft auf jedes neue Modell.
Für deutsche Ergebnisse sollten Sie Umlaute, ß und lange Wörter gezielt prüfen; englische Beispiele reichen nicht. Auch japanische Ergebnisse lassen sich nicht durch englische oder chinesische Schriftdemos belegen. Testen Sie die Zielsprache und lesen Sie in endgültiger Größe Korrektur. Bei Preisen, Rechtstexten, Kontaktdaten und dichten Absätzen erzeugen Sie besser erst die Illustration und ergänzen editierbaren Text im Designprogramm. Das erleichtert spätere Korrekturen.
Tempo und Kontingente: fertige Bilder pro Stunde vergleichen
Messen Sie vom Absenden der Anfrage bis zur akzeptablen Datei. Dazu gehören Modellladen, Übertragung, Warteschlange, Vorschauen, Wiederholungen, Vergrößerung und manuelle Korrektur. Eine vom Hersteller genannte Sekunde Inferenz ist nur ein Teil davon.
| Umgebung | Relevante Grenze | Praktische Folge |
|---|---|---|
| Vollständig lokal | Grafikspeicher, Rechenleistung, Temperatur und Speicherplatz | Kein Dienstkontingent, aber große Stapel können den Speicher überfüllen; Auslagerung kann bremsen |
| ChatGPT | Tarifabhängige Bildlimits und Anfragekomplexität | Komplexe Bilder können Minuten benötigen; kein einheitliches festes Tageslimit für alle Konten annehmen |
| Midjourney | Fast-GPU-Stunden gegenüber Relax-Warteschlangen | Basic: 3,3 Fast-Stunden; Standard: 15; Pro: 30; Mega: 60. Relax ab Standard tauscht Wartezeit gegen Menge |
| NovelAI V5 Opus | Nachfüllendes Gratiskontingent plus Anlas | Berechtigte kostenlose Generierungen sind begrenzt; danach Anlas nutzen oder warten |
| Gehostete API | Anfragelimits, Guthaben und Parallelität | Automatisierung ist bequem, erfordert aber Budget und Behandlung von Wiederholungsversuchen |
Quellen: ChatGPT-Bildhilfe, Midjourney-Tariftabelle und FAQ zu NovelAI-Opus-Limits. Laut NovelAI füllt sich das V5-Kontingent fortlaufend auf und braucht nach vollständigem Verbrauch etwa eine Woche bis zum Maximum. Für ältere berechtigte Modelle gelten andere Regeln zur unbegrenzten Generierung. V5 sollte nicht pauschal als „unbegrenzt“ beschrieben werden.
Für einen fairen Versuch lassen Sie dieselben zehn Aufgaben in vergleichbaren Abmessungen bearbeiten. Erfassen Sie Versuche, akzeptierte Bilder, Zeit und Gesamtkosten. Trennen Sie Ergebnisse mit bereits geladenem lokalem Modell von einem Kaltstart. Dieser kleine Test hilft mehr als Geschwindigkeitsclips aus sozialen Medien ohne vergleichbare Bedingungen.
Anime, realistische Menschen und konsistente Figuren
Anime und Manga: Für einen gehosteten Einstieg bieten sich NovelAI oder Midjourneys Niji zum Testen an. Für lokal wiederholbare Stilkontrolle prüfen Sie passende Anime-Modelle und LoRAs. Panelaufbau, Hände, Figurenanzahl und Konsistenz zwischen Seiten sollten getrennt von der Schönheit eines einzelnen Porträts bewertet werden.
Fotorealistische Menschen und Produkte: Vergleichen Sie die genannten allgemeinen Modelle bei Haut, Stoff, Spiegelungen, Geometrie und Referenztreue. Ein glaubwürdiges Gesicht beweist nicht, dass Logo, Verpackungsgröße oder Handhaltung stimmen. Die Realismusversprechen von Qwen und Z-Image sind ein Anlass zum Testen, kein unabhängiger Beweis für Überlegenheit gegenüber allen Online-Konkurrenten.
Wiederkehrende Figuren: Wählen Sie einen Ablauf mit den benötigten Referenzen oder Anpassungen. Speichern Sie Modellversion, Prompt, verfügbaren Seed und Bearbeitungsparameter. Ein Seed allein garantiert nach einem Modell- oder Ablaufwechsel nicht dieselbe Person. Messen Sie für die Produktion den Aufwand für eine konsistente Figur in zehn Szenen statt nur einen Glückstreffer zu beurteilen.
NSFW: lokale Kontrolle bedeutet keine uneingeschränkte Erlaubnis
NSFW kann künstlerische Nacktheit, explizite sexuelle Inhalte oder drastische Gewalt meinen. Die Richtlinien behandeln diese Kategorien unterschiedlich. Die Tabelle beschreibt allgemeine Fähigkeiten und dokumentierte Einschränkungen; dieser Leitfaden enthält keine Tests expliziter Generierung oder Filterumgehung.
| Option | NSFW-Einordnung | Wichtige Grenze |
|---|---|---|
| Herunterladbare lokale Modelle | Abhängig von Gewichten, Training und installierter Anwendung | Ohne Hostingdienst entfallen weder Modellbedingungen noch rechtliche Grenzen für Ausgaben |
| ChatGPT Images / GPT Image 2 | Eingeschränkt; kein ungefilterter Erwachsenendienst | Sicherheitsfilter gelten für Prompts und Bilder; sexuelle Deepfakes sind ausdrücklich eingeschränkt |
| Midjourney / Niji | Nur SFW | Erwachsenen- und Gore-Inhalte sind auch auf privaten Servern und im Stealth-Modus verboten |
| NovelAI V5 | Full und Curated unterscheiden sich bei sensiblen Inhalten | Curated soll unerwünschte sensible Bilder reduzieren; daraus folgt keine allgemeine Freigabe jeder Erwachsenennutzung |
| Gehostete offene Modelle | Eigene Regeln des Hosts | Eine API kann andere Einschränkungen als eine lokale Installation vorgeben |
Quellen: OpenAI-Sicherheitsbericht zu Images 2.0, Midjourney-Communityrichtlinien, NovelAI-Modellunterschiede, NovelAI-Bedingungen und BFL-Nutzungsrichtlinie. Die hier zitierte NovelAI-Dokumentation enthält keine universelle Freigabeliste für jedes explizite Szenario. Die Bezeichnung „Full“ ist keine solche Garantie.
Unterscheiden Sie vor einem Abo für Erwachsenenprojekte technische Möglichkeiten und vertragliche Erlaubnis. Verwenden Sie nur rechtmäßige, einvernehmliche Themen mit Erwachsenen; vermeiden Sie sexuelle Inhalte mit Minderjährigen und nicht einvernehmliche intime Darstellungen. Lokaler Betrieb rechtfertigt diese Nutzungen ebenfalls nicht. Private Speicherung und Erlaubnis einer Inhaltskategorie sind zwei getrennte Fragen.
Datenschutz, Lizenzen und Kaufentscheidung
Ein vollständig lokaler Ablauf kann nach Installation der Komponenten Quellbilder auf Ihrem Rechner halten. Prüfen Sie entfernte Knoten und Erweiterungen, bevor Sie ihn offline nennen. Online-Dienste unterscheiden sich: Midjourney-Werke sind standardmäßig öffentlich, Stealth gibt es nur mit Pro und Mega. ChatGPTs Datenkontrollen für Verbraucher sind eine separate Einstellung; ein bezahlter Tarif ist nicht automatisch offline oder vertraulich.
Bei kommerziellen Arbeiten prüfen Sie die genauen Lizenzen des Modells und seiner Anpassungen, den Tarif sowie die Rechte an Referenzen. Herunterladbare Gewichte bedeuten keine uneingeschränkte kommerzielle Nutzung. Die Anbieterlizenz garantiert auch nicht, dass jedes generierte Logo oder Abbild rechtlich freigegeben ist.
- Gelegentliche Bilder ohne geeignete GPU: Mit Testzugang oder einem Online-Monat beginnen. Reine Aboersparnisse rechtfertigen Hardware selten.
- Vorhandene GPU, wiederkehrende Stapel: Ein lokales Modell und einen stabilen Ablauf testen. Akzeptierte Ergebnisse und Wartungszeit vor dem Ausbau messen.
- Deutsche oder japanische Plakate und wechselnde Kundenwünsche: Sprachtests, gezielte Bearbeitung und editierbare Endtypografie priorisieren.
- Anime-Produktion: Figurensteuerung, kompatible Stilressourcen und tatsächliche V5- und Tariflimits vergleichen.
- Gemischte Aufgaben: Bewährte Routine lokal erledigen und gehostete Modelle dort einsetzen, wo Bearbeitung oder Ergebnis genügend Zeit sparen.
Ein hybrider Ablauf ist oft sinnvoll, verursacht beim Weiterbezahlen beider Seiten aber zusätzliche Dienstkosten. Weitere Einstiegsoptionen finden Sie in unserem Leitfaden zu KI-Bildgeneratoren.
Häufige Fragen
Ist lokale KI-Bilderzeugung kostenlos?
Software und manche Gewichte sind kostenlos herunterladbar. Hardware, Strom, Speicherplatz, Wartung und Zeit kosten weiterhin. Ein bereits vorhandener geeigneter Rechner macht lokale Nutzung deutlich leichter begründbar.
Reichen 8 GB VRAM?
Für manche kleinen oder quantisierten Abläufe ja. Als Ziel für alle Modelle ist das nicht zuverlässig. Prüfen Sie die gesamte Verarbeitung, Bildabmessungen und Bearbeitungseingaben; reine Modellangaben lassen andere Komponenten aus.
Verbessert mehr VRAM die Bildqualität?
Mehr Speicher ermöglicht größere Modelle oder Abläufe und kann Auslagerung reduzieren. Er verbessert nicht automatisch dasselbe Modell bei gleichen Einstellungen. Rechentempo und Speicherkapazität lösen unterschiedliche Probleme.
Kann Online-KI NSFW-Bilder erzeugen?
Es gibt keine allgemeine Antwort. Midjourney erlaubt nur SFW, OpenAI nutzt Sicherheitsbeschränkungen, andere Dienste unterscheiden Modellvarianten und Regeln für sensible Inhalte. Prüfen Sie das aktuelle Modell und die Richtlinie des Hosts.
Was eignet sich besser für deutschen oder japanischen Text?
Entscheidend sind Tests mit dem Modell und Ihrem genauen Text, nicht nur lokal oder online. Prüfen Sie Umlaute, ß, Satzzeichen, Ziffern und japanische Kana. Wichtiger endgültiger Text sollte editierbar bleiben, statt vollständig auf generierte Schrift zu vertrauen.
Sollte ich eine GPU als Aboersatz kaufen?
Erst nach einem Test des lokalen Ablaufs und einer Rechnung mit den Abos, die Sie tatsächlich kündigen. Berücksichtigen Sie ein reales Hardwareangebot, laufende Kosten und den Anteil brauchbarer Bilder. Ein hoher Kaufpreis kann die Amortisation über einen sinnvollen Austauschzyklus hinaus verschieben.
Unser Fazit
Für die meisten Menschen ohne geeignete Hardware ist Online-Generierung der einfachere erste Kauf. Lokal wird überzeugend, wenn die GPU vorhanden ist, wiederholbare Kontrolle nötig ist und Sie den Ablauf pflegen können. Kein Ausführungsort garantiert das beste Anime, realistische Gesichter oder fehlerfreie Schrift.
Wählen Sie das Modell nach Aufgabe, prüfen Sie NSFW- und kommerzielle Grenzen und vergleichen Sie Kosten und Zeit je tatsächlich brauchbarem Bild. 2026 zählen diese praktischen Unterschiede mehr als „lokal ist kostenlos“ oder „Cloud ist immer besser“.
Verwandte
AI YouTube Title Generator: Best Tools for Better Video Titles

Deepseek vs ChatGPT: Der umfassende LLM-Vergleich (2025)
15 Best Free Ebook Sites to Download and Read Books Legally in 2026
Sticker in Sekunden entfernen – So macht AirMore AI Ihre Fotos wieder sauber
Die besten KI-Ausmalbild-Generatoren zum Erstellen von druckbaren Malvorlagen
Die 10 besten KI-Notiz-Apps und Meeting-Protokollanten für 2025
