
動漫 LoRA 可以從實際生圖使用的 SDXL 底模開始,Anima 則走專用訓練流程。真人相片模型要選對 Z-Image、Qwen、FLUX 或 Krea 2 的版本;影片則從 Wan、官方 LTX Trainer 或 H3 專用工具的小規模短片試跑開始。LoRA 是附加在相容底模上的權重,並不是所有模型通用的角色檔。
最浪費時間的問題往往出在開跑之前:拿推理用量化檔直接訓練、混用模型世代、所有圖片寫同一句標註,或期待靜態圖片學會連續動作。先用小資料集驗證快取、訓練、存檔和載入,再擴大規模,比直接複製大型預設跑整晚更實際。
2026 年 10 月 13 日更新
先選底模,再選訓練工具
動漫/相片是常見用途分類,不是能力限制。FLUX、Krea 也能畫插畫,SDXL 衍生模型也有寫實路線。本文將 WanX 視為 Wan 系列,具體參數分開說明 Wan 2.1/2.2;FLUX 和 LTX 也要先決定世代。
Pony V6 XL 屬於 SDXL,但 Pony V7 不適用這套 SDXL 配方。Illustrious、NoobAI 衍生版本的標籤與預測目標可能不同。Anima、Z-Image、Qwen、Krea 2 各有專用模組;成功載入檔案不等於輸出品質與角色一致性已獲保證。
推薦的 LoRA 訓練工具
kohya_ss+sd-scripts
想用 GUI 訓練 SDXL,可從 kohya_ss 開始。進入 LoRA/SDXL 流程,指定底模、圖文資料夾和輸出位置,先儲存設定再執行。底層參數以 sd-scripts 為準;GUI 若綁定較舊版本,不一定包含最新模型支援。
Anima 專用 sd-scripts
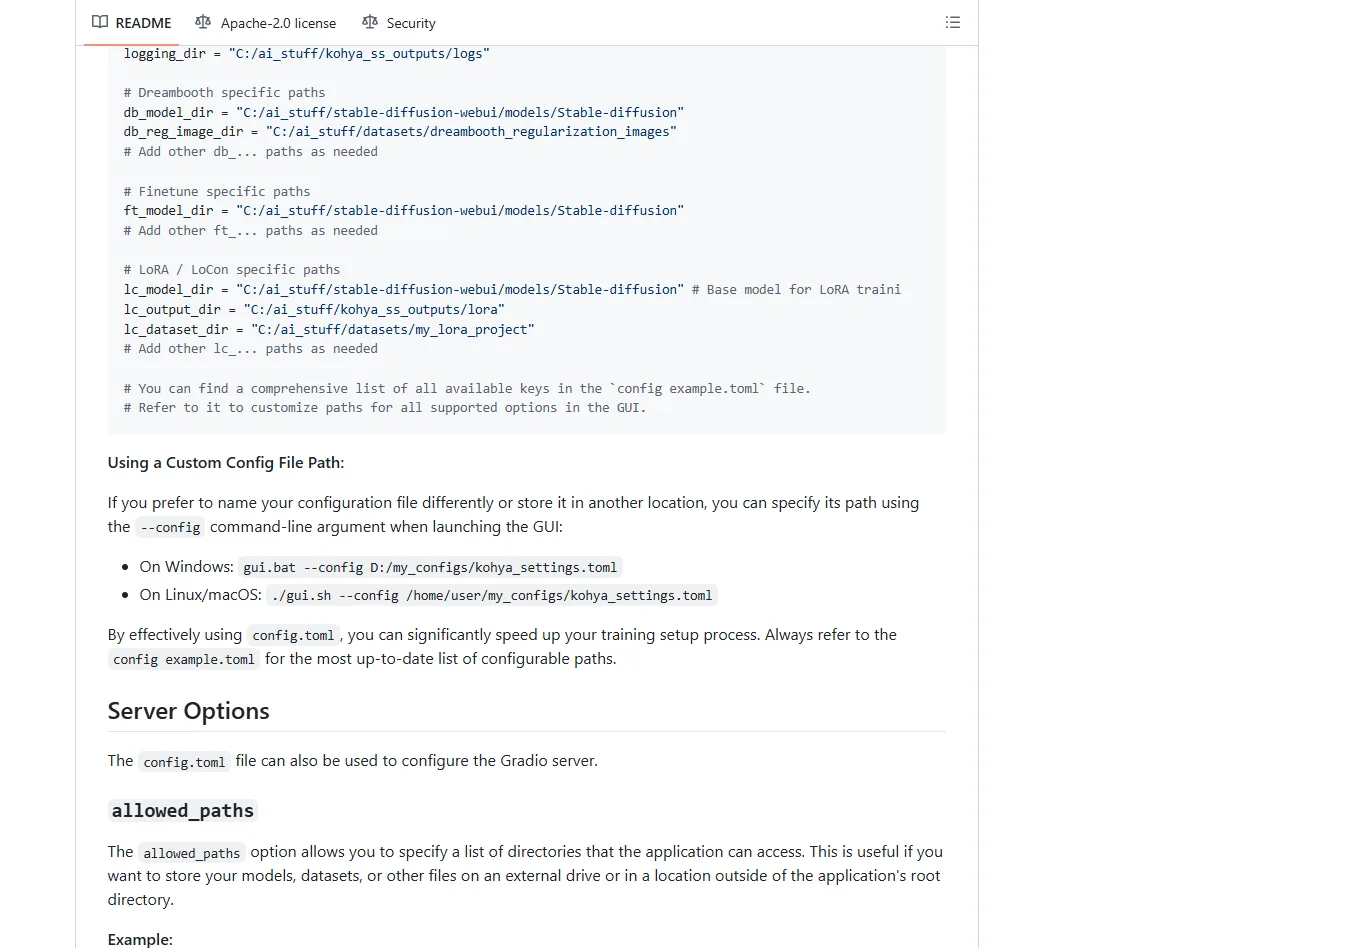
Anima 使用 anima_train_network.py,不是 SDXL 入口。DiT、Qwen3 編碼器、VAE 都需正確指定,適合願意編輯 TOML 與終端指令的使用者。不要因為都是動漫模型,就將 SDXL 設定整份套用。
Ostris AI Toolkit
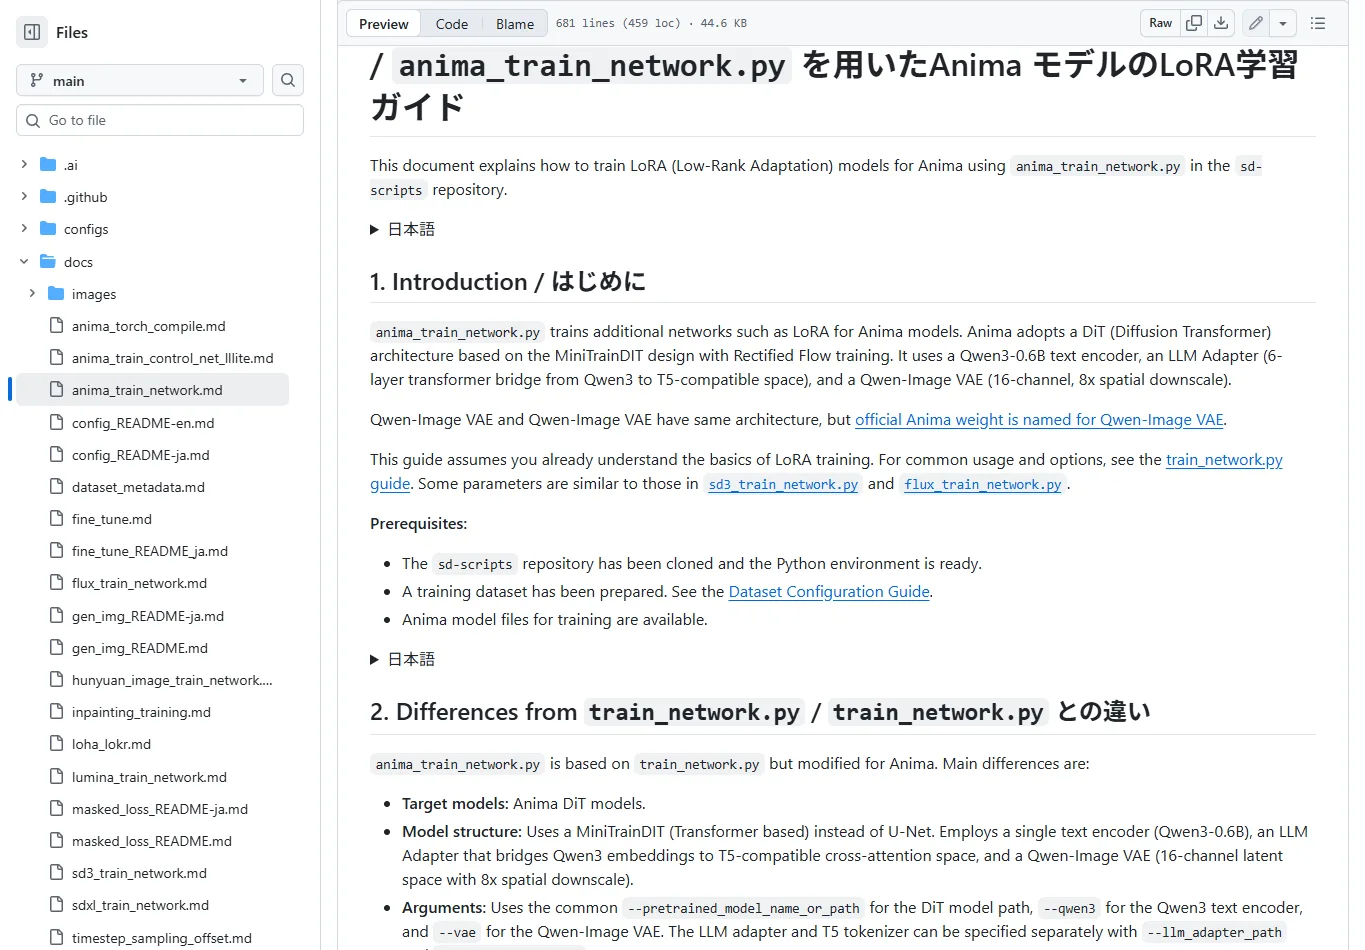
AI Toolkit 提供 GUI 和 YAML 工作,支援多種圖片架構。建立工作後選正確模型,加入圖片/標註資料夾、觸發詞、固定驗證提示詞及存檔間隔。應複製對應範例,而非把 FLUX 工作改名為 Qwen。雲端 UI 請設定驗證並限制公開存取。
Musubi Tuner
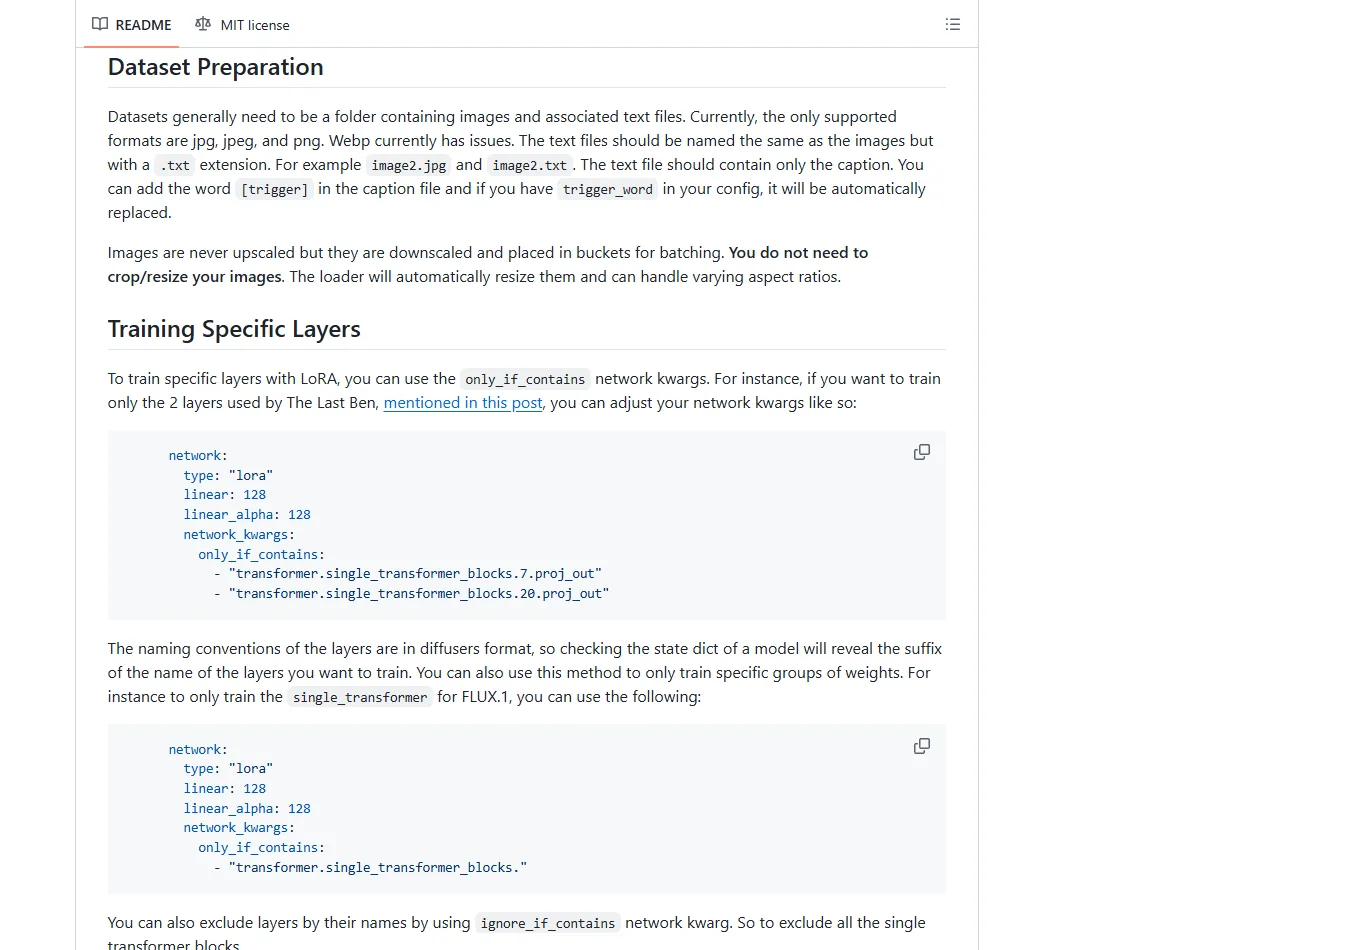
適合需要分開快取、訓練,並控制模型特有參數與區塊卸載的使用者。使用獨立環境,依序建立資料集 TOML、潛在快取、文字快取,再執行模型專用訓練腳本。快取和噪聲排程不可跨架構照搬。
Lightricks LTX Trainer
LTX 優先使用官方訓練套件,前處理、訓練與驗證設定都在同一專案。從一般或低顯存 T2V LoRA 設定開始,不要誤選全量微調。模型與文字編碼器都必須是版本相容的本機檔案。
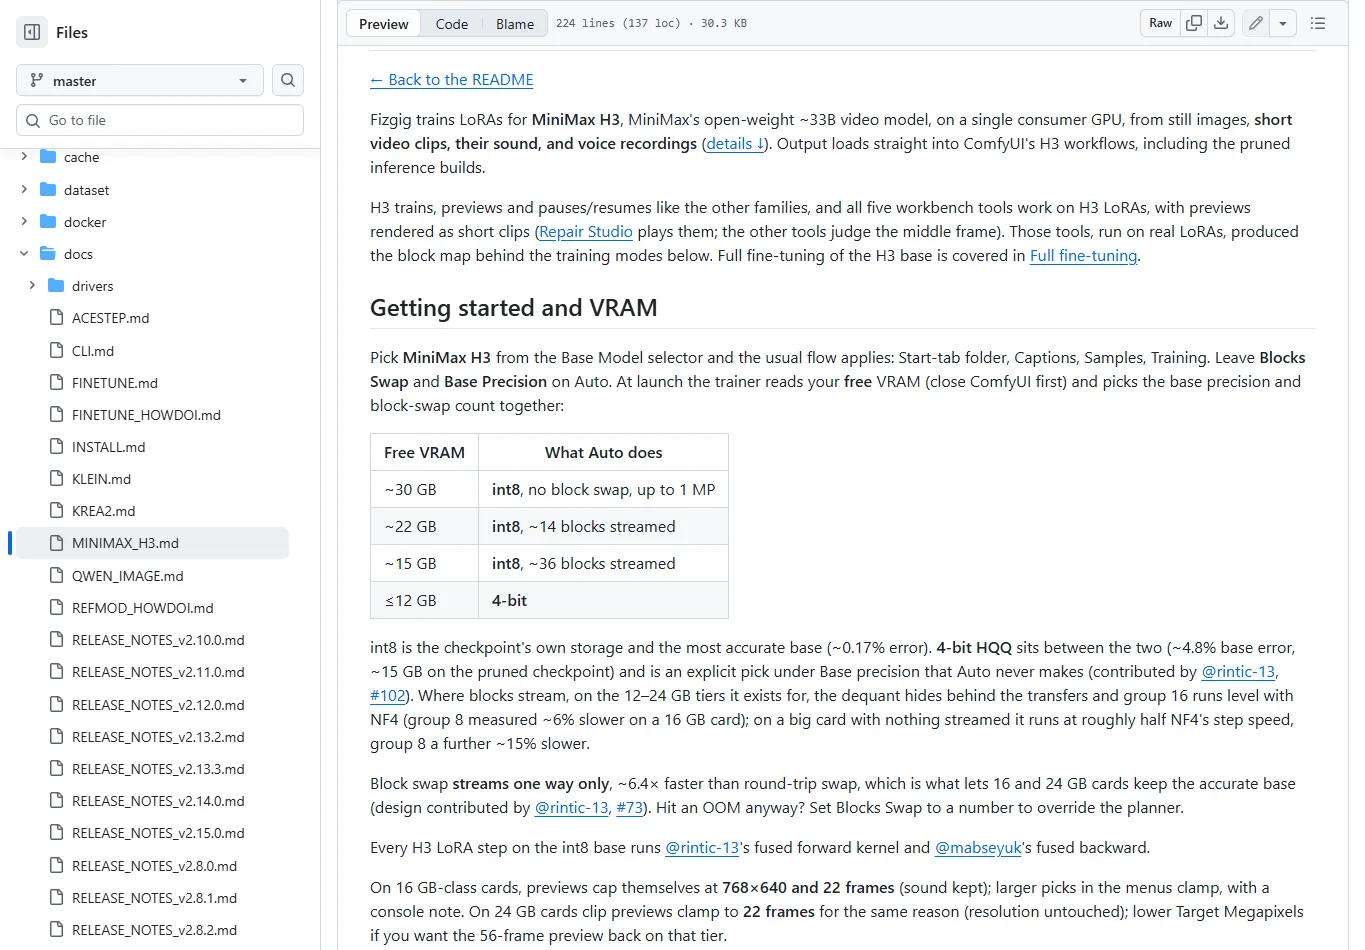
MiniMax H3 的 Fizgig 圖形化流程
Fizgig 將資料準備與 H3 預設整合在一起。選擇 MiniMax H3、加入並標註靜態圖片或短片,再用 Fast 預設試跑。確認存檔結果後才拉長影片。這是社群實作,其自動學習率不能與 Musubi 固定學習率範例混搭。
資料集準備:讓模型學到正確特徵
- 先決定學習角色、人物、畫風、商品還是動作。圖片初次試驗可用約 20~50 張不重複素材作為容易管理的起點,但不是最低門檻或成功保證。畫風通常需要更多不同題材。
- 移除重複、破圖、浮水印、嚴重壓縮與身分矛盾的圖片。讓角度、姿勢、光線、背景多樣化;不希望固定的衣服或背景,要在標註裡說明,避免黏在觸發詞上。
- 圖片與文字同名,例如 subject_001.png 與 subject_001.txt。動漫底模常適合標籤,新型 Transformer 常適合自然句子。自動標註要人工檢查左右、人數、動作與人物名稱。
- 另外保留未參與訓練的評估素材。同一支影片相鄰畫格分到訓練與測試集,會把記憶誤認為泛化能力。
- 影片依鏡頭切換分段,保留連續動作,記錄 FPS 和長度。抽成一堆靜態圖片可以教外觀,但無法取代動作的時間順序。
- 解析度與畫格數依各工具允許的 bucket 設定。影音模型需要同步、有用的聲音,或明確支援的純影片模式;隨便補無聲音軌不是通用解法。
- 素材須有權利或取得訓練授權;可辨識人物與聲音另須適當同意。底模授權、素材權利、輸出 LoRA 的發布條件要分開確認。
- 將底模版本、訓練器 commit、標註規則與設定一起保存。不要在執行中途升級環境;修改標註、元件或前處理後重建對應快取。
以下是建議的標註範例,不代表實測生成結果。
Anime: a1explorer, adult woman, blue jacket, standing, forest, daylight
Photo: A photo of a1subject wearing a blue jacket beside a window in soft daylight.
Video: a1subject walks from left to right, turns toward the camera, and stops. The camera remains fixed.
起始參數:文件範例與試跑建議
下列「範例」來自特定訓練工具文件,不是所有資料集實測最佳值。SDXL 範圍和試跑預算屬建議起點。rank、alpha、學習率與 optimizer 必須成組考慮,alpha=1 和 alpha=rank 並不相同。第一次先用 batch 1 確認記憶體。
| 模型/分支 | 文件範例或試跑起點 |
|---|---|
| SDXL / Pony / Illustrious / NoobAI | SDXL:建議起點 rank 16~32、alpha=rank、U-Net LR 1e-4、凍結文字編碼器。能容納時使用 1024 bucket,有限的冒煙測試可考慮 768。 文件 |
| Anima | Anima:sd-scripts 範例 rank 8、預設 alpha 1、LR 1e-4、AdamW8bit、bf16。提高 alpha 時也應重新考慮學習率。 文件 |
| Z-Image | Z-Image Base:Musubi 範例 rank 32、LR 1e-4、AdamW8bit、shift 2.0。Turbo 需使用專用去蒸餾/訓練轉接器流程。 文件 |
| Qwen-Image | 初代 Qwen-Image:Musubi 範例 rank 16、LR 5e-5、shift 2.2,不是 Qwen-Image-2.1/Edit 的通用預設。 文件 |
| FLUX | FLUX.1-dev:AI Toolkit 範例 rank/alpha 16/16、LR 1e-4、batch 1、2,000 steps、512/768/1024 buckets。FLUX.2、Klein 另選架構。 文件 |
| Krea 2 | Krea 2 RAW:Musubi 範例 32/32、LR 1e-4、bf16、AdamW8bit;1024 固定 shift 2.5,另有隨解析度調整的 krea2_shift。 文件 |
| Wan | Wan 2.1:Musubi 範例 rank 32、LR 2e-4、AdamW8bit、shift 3.0。Wan 2.2 需另處理不同專家的時間範圍。 文件 |
| LTX | LTX 低顯存:16/16、LR 1e-4、batch 1、2,000 steps、INT8 與 checkpointing。文件內 576×576×49 是驗證設定,不表示所有訓練影片都必須相同。 文件 |
| MiniMax H3 | MiniMax H3:Musubi 範例 16/16、LR 1e-4,還要搭配一種完整 H3 損失配方。Fizgig Fast 則是 8/8、50 epochs、0.25 MP,以及從 1e-6 開始的自動排程。 文件 |
圖片 LoRA:動漫模型訓練
優先使用與最終生成目標相同或接近的底模。SDXL 衍生模型間即使載入成功,角色相似度、顏色與適用強度仍可能變化,需要實際驗證。
Pony V6 XL:底模與標籤規則要一致
使用 kohya_ss/sd-scripts 的 SDXL LoRA 路線。把角色或畫風的觸發詞,與衣服、場景等可變內容分開標註。驗證時遵守該 Pony 模型卡的品質標籤,不要把整套規則直接套到 Illustrious 或 NoobAI。
在 GUI 填入底模、資料夾、caption 副檔名、bucket、rank/alpha 與 U-Net 學習率,先凍結文字編碼器。每次存檔用相同提示詞驗證,若只會同一背景或姿勢就比較早期版本。Pony V7 需要另一條架構路線。
Illustrious XL:避免把背景一起記死
訓練工具屬 SDXL 生態,但版本與衍生模型仍重要。選擇真正會拿來生圖的底模,依其文件決定標籤或自然語言描述;後期版本未必沿用早期的標籤偏好。
先做單一角色或畫風,rank 16~32、凍結編碼器並定期驗證。角色總是帶著同一背景時,先修改標註與素材多樣性,不要直接加 rank。用未看過的服裝與構圖測試泛化。
NoobAI XL:先分清 eps 與 v-prediction
NoobAI 存在不同預測版本。V-Pred 模型卡指定 v-prediction 與 zero-terminal-SNR 推理設定;訓練端也要匹配預測目標與噪聲設定,不能照搬普通 epsilon SDXL 配方。也不能看到 Noob 名稱就一律啟用 v-pred。
選對分支後進行小型 SDXL 試跑。色彩或對比崩壞時,先查預測方式與推理 scheduler,而不是立即責怪資料集。模型卡連結了專用 v-pred LoRA 教程,相關設定應與 LoRA 一起保留。
文件 — NoobAI XL:先分清 eps 與 v-prediction
Anima:獨立的 DiT 訓練架構
Anima 並非 SDXL 微調版。準備 DiT、Qwen3-0.6B、匹配的 Qwen-Image VAE,以及版本需要的 tokenizer/adapter,使用 anima_train_network.py 與 networks.lora_anima。重新命名 Pony LoRA 不會變成 Anima LoRA。
初次可只訓練 DiT,並快取文字編碼輸出。rank 8/alpha 1 範例要整組看待。若之後要訓練文字編碼器,需停用文字輸出快取,另設較低學習率。Anima 特有的 dropout/cache 支援不能假設 SDXL 也相同。
使用步驟
- 建立 dataset TOML,在 Anima 範例裡填入正確元件路徑。
- 使用硬體支援的 bf16、gradient checkpointing 與文件快取設定,明確選擇只訓練 DiT。
- 每 epoch 存檔,在同版本底模與保留提示詞上比較,再決定是否增加 rank 或訓練模組。
圖片 LoRA:真人與相片風格模型
Z-Image:優先從 Base 開始
目前 Musubi 文件推薦已發布的 Base 進行訓練,「只有 Turbo」是舊資訊。Turbo 是蒸餾模型,需要工具支援的 De-Turbo 或訓練轉接器,推理時也要依對應流程處理。
準備 DiT、VAE、文字編碼器,以 Z-Image 腳本快取後,執行 zimage_train_network.py 和 networks.lora_zimage。可先試 rank 32/LR 1e-4 範例,若推理端需要不同權重鍵名格式,再按文件轉換。
使用步驟
- 明確選擇 Base、De-Turbo 或 Turbo+adapter,寫入工作名稱。
- 用匹配元件建立圖片與文字快取,訓練並保存數個檢查點。
- 在匹配的 Z-Image 流程測試;只有文件要求時才做 LoRA 格式轉換。
Qwen-Image:生圖和修圖用不同資料
初代生圖模型有 Musubi 的 rank 16/LR 5e-5 範例。修圖 LoRA 則需要輸入/control 圖、目標圖與修改指令;只有人像加 caption,不能完整教會編輯動作。不同版本的 control 編碼也有差異。
AI Toolkit 已列出 Qwen-Image-2.1 的生成與編輯支援,control 圖會啟用編輯。不要把舊版 model_version original 當成 2.1 通用設定。修圖先用少量成對素材,確認新輸入的指定部分改變、其他部分仍保持。
使用步驟
- 選生成或編輯,再選正確 Qwen 版本。
- 修圖素材要配對,指令描述改變,先檢查幾筆實際載入內容。
- 小規模訓練後用未知圖片,同時比較修改效果與主體保持。
文件 — Qwen-Image:生圖和修圖用不同資料 · AI Toolkit: Qwen-Image-2.1
FLUX:區別 1、2 與 Klein
AI Toolkit 的 FLUX.1-dev YAML 提供 rank、驗證文、存檔間隔與 steps。複製為新工作,修改資料/輸出路徑和觸發詞,再以 python run.py 執行。需要的模型授權和存取 token 請先設定,token 不公開。
FLUX.2-dev 與 Klein 要選各自架構與元件,不能只因都叫 FLUX 就套用 1-dev 配方。自然語言 caption 描述看得到的場景,身分/風格觸發詞維持一致,刪除自動描述幻想出來的內容。
使用步驟
- 從正確範例或 GUI 模型預設建立工作。
- 固定驗證提示詞,包含新場景及不帶觸發詞的對照。
- FLUX.1-dev 以文件 2,000 steps 為比較基準,若變得僵硬就選較早檢查點。
Krea 2:RAW 訓練、Turbo 驗證
Musubi 推薦以 RAW 訓練,再搭配 Turbo 推理。準備 raw.safetensors、Qwen-Image VAE、單一檔案 Qwen3-VL-4B,依序用 krea2_cache_latents.py、krea2_cache_text_encoder_outputs.py 與 krea2_train_network.py。
先把 32/32、LR 1e-4 當成完整範例。1024 固定 shift 2.5 與解析度感知 krea2_shift 是不同選項。RAW 驗證要 CFG,Turbo 範例為低 steps/關閉 CFG;RAW 在 CFG 關閉時模糊,不代表 LoRA 必然失敗。
使用步驟
- 以 RAW 元件建立快取,Turbo 權重另外保存。
- 在 RAW 上訓練;記憶體模式相容時使用文件的 Turbo sampling 選項。
- 以 Turbo 的 8 steps/CFG 1 範例開始,除了臉部,也看姿勢彈性與背景。
影片 LoRA:Wan、LTX 與 MiniMax H3
Wan 2.1/2.2:外觀和動作要分開規劃
Musubi 支援 Wan 2.1/2.2;先選 T2V 或 I2V,再快取。單畫格適合外觀,真正的動作需要連續片段。使用 wan_cache_latents.py、wan_cache_text_encoder_outputs.py,再執行 wan_train_network.py。
Wan 2.2 A14B 分高/低噪聲專家。文件 I2V 範圍為 0~900/900~1000,T2V 為 0~875/875~1000;單專家訓練另保留分布形狀。兩個專家一起訓練的記憶體壓力更高。
使用步驟
- 選正確 task、權重與短 frame bucket,確認解碼出的樣本影片正常。
- 用匹配 VAE、T5 與任務元件快取,再採用 Wan 範例。
- 2.2 明確選擇專家與範圍,記錄推理端哪條分支載入哪個 LoRA。
- 評估整段運動與身分漂移,不只看漂亮的第一格。
LTX:官方工具也需要對齊世代
官方 Trainer 覆蓋 LTX-2、2.3、2.5,但元件不同。2/2.3 使用 Gemma 3;2.5 要 LTX 特別微調的 Gemma 4,不能隨便替換成原版。換模型後也不能沿用舊文字嵌入。
32GB 低顯存範例採 16/16、LR 1e-4、batch 1、2,000 steps,加上 INT8 和 checkpointing;標準配置推薦 80GB。這不是任何 32GB 卡都能跑任意長度解析度的保證。
使用步驟
- 安裝 LTX 環境,準備匹配的本機模型與編碼器。
- 分段、檢查 caption,依合法解析度與畫格 bucket 執行 process_dataset.py。
- 複製低顯存或一般 YAML,修改模型與前處理資料路徑,再執行 scripts/train.py。
- I2V、音訊與參考條件需選對應 strategy 和 target modules。
文件 — LTX:官方工具也需要對齊世代 · LTX: low-VRAM YAML
MiniMax H3:不要拆散專用配方
H3 是大型影音模型,不適合直接套通用影片 LoRA 預設。GUI 路線可選 Fizgig Fast:rank/alpha 8/8、50 epochs、0.25 MP 與專用自動排程。其 16GB 範例限定 0.25 MP、最長 56 格的短片,並非 H3 通用最低顯存。
Musubi 範例使用 16/16、LR 1e-4,但必須另選完整的 training adapter、guidance loss 或 teacher matching 其中一條。base time 為 uniform/none/shift 1.0,影音 shift 在內部處理;複製 Wan 的 shift 會改錯機制。
使用步驟
- 先選 Fizgig 或 Musubi,別混用學習率排程。
- 外觀由靜態圖開始;動作從工具允許的最短影片開始。
- Musubi 選定 task 和 loss 路線,一致地快取影片、聲音與文字。
- 先做存檔重載測試,再於最終 base 評估;不要只憑 training adapter 下的取樣判斷成敗。
文件 — MiniMax H3:不要拆散專用配方 · Fizgig: MiniMax H3
從資料集到第一個可用 LoRA
以下是 epsilon-prediction SDXL 的起始範本。先依 sd-scripts 文件安裝,並替換所有路徑。此例凍結文字編碼器以使用快取;NoobAI V-Pred 或其他架構必須改用匹配的預測/模型設定,不能照貼。
設定範例 — dataset.toml
[general]
caption_extension = ".txt"
shuffle_caption = false

[[datasets]]
resolution = 1024
batch_size = 1
enable_bucket = true

[[datasets.subsets]]
image_dir = "/path/to/images"
num_repeats = 5
SDXL / Epsilon
accelerate launch sdxl_train_network.py --pretrained_model_name_or_path="/path/to/sdxl-epsilon.safetensors" --dataset_config="dataset.toml" --output_dir="output" --output_name="subject_lora" --network_module=networks.lora --network_dim=16 --network_alpha=16 --network_train_unet_only --learning_rate=1e-4 --optimizer_type=AdamW8bit --lr_scheduler=constant --max_train_steps=1000 --save_every_n_steps=250 --mixed_precision=bf16 --save_model_as=safetensors --gradient_checkpointing --cache_latents --cache_text_encoder_outputs先跑約 100~200 optimizer steps,驗證快取、反向傳播、存檔與推理載入都正常。確定輸出的 LoRA 有作用,再拉長訓練,並比較中途保存版本,不要自動認定最後一個最好。
Musubi 的順序是資料 TOML→潛在快取→文字快取→架構專用訓練→匹配推理。模型檔、目標模組、timestep sampling、loss recipe 都重要,應使用該模型文件的完整指令。
如何挑選檢查點與排除失敗
完全沒有變化
先查是否載入、觸發詞、底模與推理強度,閱讀 missing key 警告後才考慮加 steps。
總是生成同一張圖
試早期檢查點、降低推理強度並改善資料多樣性。增加 rank 之前先減少 repeats 或總 steps。
loss 下降但圖越來越差
以固定 seed 和保留提示詞驗證。訓練損失不等於構圖、動態或身分泛化品質。
顯存不足
分清快取、訓練或驗證階段,減 batch、解析度、片長並使用支援的量化、checkpointing 或卸載。梯度累積不能讓單筆過大樣本變小。
影片閃爍或不動
檢查素材連續性、FPS、時間任務與影音目標層。靜態外觀成功不代表動作訓練完成。
新 caption 沒有效果
改標註、觸發詞或編碼器後重建對應快取,別沿用另一底模的 latent。
顯存、時間與實際訓練成本
不要用推理顯存數字選訓練硬體。訓練還要活化值、梯度與 optimizer state,驗證峰值甚至可能更高。SDXL 通常是較輕的起點;新型圖片 DiT 常受益於 16~24GB 以上與支援的卸載,但這只是規劃級距,不是最低規格保證。
Musubi 一般建議圖片 12GB、影片 24GB 以上,系統 RAM 64GB;個別模型可能更高。Krea 文件的 1024/batch 1 比較中,3090 無法容納 bf16,但有量化路線。LTX 的 32GB/80GB 與 Fizgig 有條件的 H3 範例,不能合併成「影片 16GB 就夠」。
雲端費用以下載快取+steps×實測每步秒數+驗證存檔時間估算,再乘供應商當下時薪,加儲存與傳輸。台灣用戶也應核對請款幣別、稅金及換匯費用。免費程式不等於免費 GPU;本機還有硬體和電費。
有效 batch=單 GPU batch×梯度累積×GPU 數。40 張、repeats 5、有效 batch 2、10 epochs,簡化估計約 1,000 optimizer steps;bucket 和餘數處理會影響結果,以工具顯示總數為準。
常見問題
一個 LoRA 能套所有模型嗎?
不行,權重形狀與目標層受架構限制。SDXL 衍生間也要分清可載入與效果穩定,公開時註明訓練底模及驗證底模。
要一起訓練文字編碼器嗎?
先凍結建立基準。快取文字輸出時無法同時更新編碼器;工具支援時才另做低學習率、無衝突快取設定的實驗。
20 張圖夠嗎?
可能足以做單一角色試驗,但不是保證。畫風要題材多樣性,動作要連續片段,先補素材覆蓋而非狂加 repeats。
rank 統一 32 可以嗎?
不建議。rank 影響容量與記憶體,alpha 影響縮放。Anima alpha 1 和 Krea alpha=rank 不是一樣,請以完整配方起跑、一次改一項。
靜態圖能教新動作嗎?
能幫助外觀,但沒有時間順序。新動作需要支援的影片訓練與整段驗證。
Turbo 或量化權重能直接訓練嗎?
只有工具明確支援該格式與流程才行。有些量化凍結底模,有些先合併訓練 adapter;支援 GGUF 推理不代表支援 GGUF 訓練。
訓練完如何使用?
放到推理工具的 LoRA 資料夾,選匹配底模與 loader,加上觸發詞。先比較強度 0、0.5、1 及多個 seed,必要時依文件轉換權重格式。
第一次訓練該選哪條路?
先固定一個底模、一個目標和一組驗證提示詞。第一次動漫角色可走 kohya_ss 的 SDXL;確定要用 Anima 生圖,就從 Anima 訓練。相片路線 AI Toolkit 較方便,想細調模型參數可選 Musubi。
影片先決定外觀、動作、編輯還是聲音。從短片、完整專用配方和可重載的第一個檢查點開始,再逐步擴大。保留彈性的小 LoRA,通常比記死資料集的長時間訓練更實用。

