Nanosaur 2 評測:670M 小型插畫模型的實力與限制
完整評測 Nanosaur 2:670M 模型、ComfyUI 安裝、速度說法、線上使用、模型比較、NSFW 證據、授權與限制。

2026 年 10 月 12 日更新
Nanosaur 2 是一款小型、開源的插畫模型,目標是探索低算力的文字生圖系統能做到什麼程度。它的擴散 Transformer 為 670M 參數,並提供可下載的 ComfyUI 工作流程;但開發者也明確表示,角色知識和細節表現不應期待能追上 Anima 這類成熟模型。
評估它不該只看能否取代大型模型。它的價值在於本機執行、研究結構,以及測試 LoRA。早期使用心得肯定它的角色表現與小體積,同時也提到背景、手眼一致性與不同種子之間的變化仍有不足。
目錄
快速結論:適合研究與本機實驗
| 項目 | 官方資訊 |
|---|---|
| 模型 | 670M 參數插畫 DiT |
| 文字編碼器 / VAE | Gemma 3 270M / DINOv2 語意 VAE(129M) |
| 基準設定 | Euler Simple、50 步、CFG 4 |
| 訓練成本 | 開發者表示約 600 美元 |
| 授權 / 用途 | 標示 MIT;模型卡說明研究用途 |
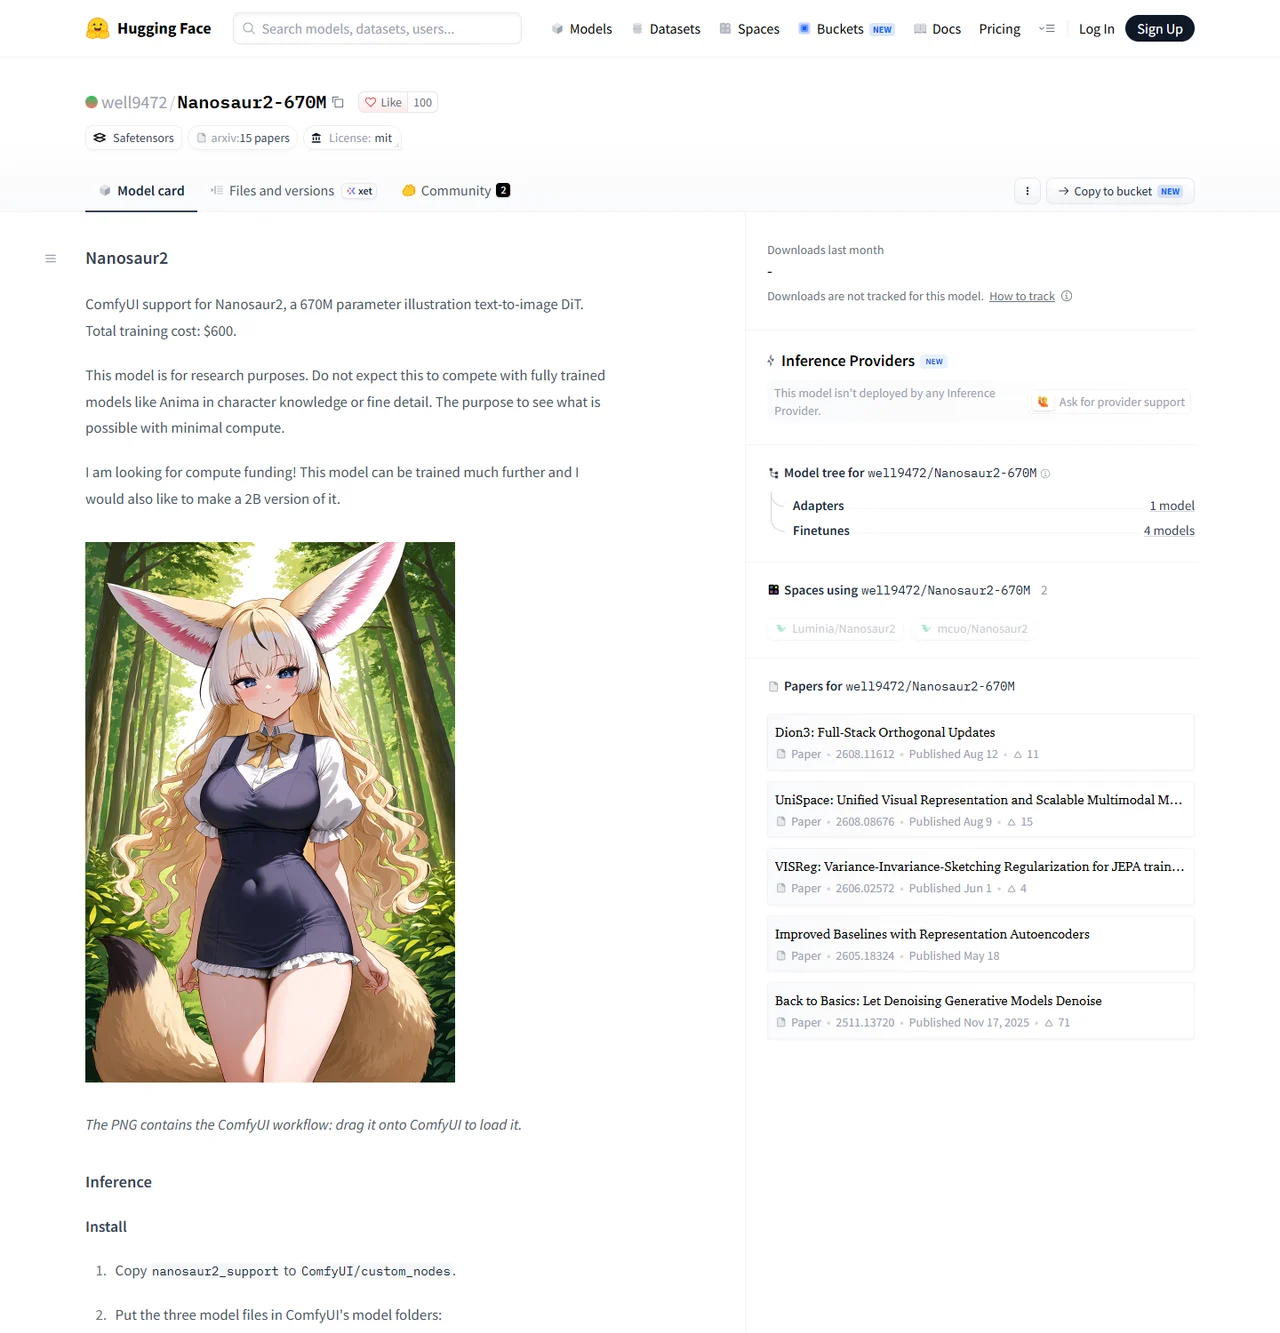
如果你想在本機執行精簡插畫模型、研究架構或訓練 LoRA,Nanosaur 2 值得一試。官方模型卡列出 670M DiT、Gemma 3 270M 文字編碼器、129M 語意 VAE、1024 像素比例桶,以及 50 步 Euler Simple 基準設定。開發者表示訓練算力成本約 600 美元。
模型是什麼?
官方 Hugging Face 模型卡將 Nanosaur2-670M 定義為插畫向文字生圖 DiT,包含凍結的 Gemma 3 270M 文字編碼器,以及 DINOv2 語意 VAE。開發者說明這是以低算力從頭訓練的研究專案,使用 400 萬張插畫資料。
提示詞可用自然語言或標籤。建議起始設定是 Euler Simple、50 步、CFG 4 與 1024 像素比例桶。模型卡建議正向提示詞加入 “newest, masterpiece” 等品質標籤,部分畫師標籤可能需要加權。這些是起點,不是適用所有提示詞的固定最佳值。
先跑通基礎版,再比較四步版
Nanosaur 2 不是一個 SDXL checkpoint 就能啟動的模型,必須搭配專用載入器、文字編碼器與 VAE。先保留乾淨的基準工作流,才能分辨問題來自擴充套件還是模型本身。
- 從作者倉庫下載 nanosaur2_support 完整資料夾和三個模型檔,放入 ComfyUI/custom_nodes,避免同名資料夾重複巢狀放置。
- 依下表存放各元件,重新啟動 ComfyUI,再把 nanosaur2_workflow.json 拖進畫布。官方範例 PNG 也可能包含工作流,但社群平台重新壓縮後可能遺失中繼資料。
- 在 Nanosaur2Loader 選擇正確檔名,以 batch 1 和範例解析度執行。先不要加入 LoRA、放大器或其他外掛。
- 高速版需下載獨立擴散權重和 nanosaur2_dmad_4step_workflow.json,並依圖設定編碼器與 VAE。把普通版從 50 步改成 4 步,不等於使用蒸餾版。
| 下載檔案 | ComfyUI 目錄 |
|---|---|
| nanosaur2_diffusion_model.safetensors | models/diffusion_models |
| nanosaur2_text_encoder.safetensors | models/text_encoders |
| nanosaur2_vae.safetensors | models/vae |
| nanosaur2_support | custom_nodes |
nanosaur2_workflow.json · DMAD 4-step checkpoint · nanosaur2_dmad_4step_workflow.json
| 工作流 | 取樣器/排程器 | 步數/CFG | 初次解析度 |
|---|---|---|---|
| 基礎版 | Euler / simple | 50 / 4 | 1024 級別的長寬比桶 |
| DMAD 四步版 | LCM / simple | 4 / 1 | 832 × 1216 |
目前四步 JSON 使用 LCM/simple、4 步、CFG 1、denoise 1 和 832 × 1216。同一份正向 conditioning 接到取樣器的兩個條件輸入。請載入完整圖,不要套用基礎版的 CFG 4 和負向提示設定。基礎版建議 Euler/simple、50 步、CFG 4,shift 3 已內建於推論。
可重複比較的起始提示詞
以下是建議的試用提示,不是聲稱已生成驗證的結果。先限定一位主角、一個動作和簡單背景。負向範例供基礎工作流使用。
newest, masterpiece, an adult woman explorer in a blue jacket, standing beside a quiet forest lake, medium shot, soft morning light, simple background, illustrationoldest, low quality固定四個 seed,比較眼睛、手部、衣服邊緣與主體背景交界。標籤適合指定屬性,自然語言適合解釋動作。長提示失效時,先減少互相競爭的條件,不要一味堆品質標籤。其權重機制影響 cross-attention bias,不能假定其他模型的相同權重值也有一樣效果。
工作流出錯時怎麼排查
- 找不到 Nanosaur2Loader:檢查啟動紀錄與 custom_nodes 目錄後重啟。
- 選單沒有模型:核對檔名和元件目錄,不要全部放到 checkpoints。
- 顯存不足:先用 batch 1 並降低解析度。檔案大小不等於尖峰顯存,還有編碼、注意力與解碼緩衝區。
- 裝外掛後出圖異常:先回到原始支援套件。量化版與局部重繪版各有載入器要求。
早期使用者怎麼說
9 月 r/StableDiffusion 討論串中,有使用者認為角色表現以模型規模而言不錯,但背景較亂、構圖容易重複、背景人物效果不理想。另一位使用者回報在 8GB RTX 3070 上以 50 步生成約 17 秒。這是個人環境與參數,並非可重現的基準測試。
權重小,不代表 2 GB 顯存一定能跑
670M 只計算擴散 Transformer。以每參數兩位元組估算,這部分約 1.34 GB,尚未包含 270M 編碼器、129M VAE 和執行緩衝區;這不是實測顯存要求。社群談到 4–8 GB 顯卡與 8 GB RTX 3070,但沒有作者驗證的最低規格表。舊顯卡還要確認 PyTorch 核心及資料型別相容性。
10 月 5 日每秒七張的說法來自 RTX 5090 四步配置,不能推算成低顯存卡的速度。連續吞吐量也不同於含模型載入的首張延遲。請固定解析度、batch 和冷/熱啟動條件;步數變少可以加快試稿,但不保證細節和構圖完全相同。
Reddit · 2026-09-26 · Reddit · 2026-10-05
和其他生圖模型比較
| 模型 | 適合用途 | 目前證據 |
|---|---|---|
| Nanosaur 2 (670M) | 小型本機實驗、LoRA 研究 | 小型 DiT;開發者表示角色知識與細節不如 Anima |
| Anima 2.9B | 動漫插畫與角色知識 | 模型較大;本文沒有直接對照測試 |
| SDXL | 通用生圖與多樣工具 | 生態系不同;沒有同條件比較 |
Anima-2.9B 是第三方擴充及微調 CircleStone Labs Anima 的模型,不等於原始 Anima,且有非商用條款。SDXL 的價值是較廣的 LoRA 與編輯生態。Nanosaur 適合將體積、實驗與透明工作流列為優先者;這是用途比較,不是實測排行榜。
NSFW:可生成、品質和平台規則是三回事
社群發布文將它稱為 uncensored,成人插畫因此成為關注點之一。但這不是官方品質評分;模型卡沒有提供受控成人內容測試或完整審核規格。發布文的資料量說法也與現行模型卡不同,訓練規格應以作者卡片為準。
實際應看成人限定需求的遵循、解剖結構和不同 seed 的穩定性。目前證據不足以量化成功率,普通插畫中的小模型限制仍可能出現。本篇沒有執行受控 NSFW 生成測試。本機權重可用,也不代表雲端主機或發表平台允許所有內容。
Nanosaur2-670M · r/StableDiffusion
下載、線上狀態與真正成本
權重與工作流可免費下載,沒有官方訂閱或逐張 API 定價。本機仍有儲存、電費與硬體成本;租 GPU 還要計入下載、閒置及持久儲存。作者約 600 美元的訓練花費不是用戶價格,也不保證你重新訓練有相同成本。
第三方 Luminia/Nanosaur2 Space 在 2026 年 10 月 12 日確認時是 PAUSED。它不是常駐的官方服務,也沒有確認到作者營運的公開 API。穩定使用以本機 ComfyUI 或自行配置雲端環境為主,內容政策另依主機商規則。
基礎倉庫標示 MIT 並定位研究專案。再散布時要保留需要的授權聲明;模型授權不會自動解決原始圖像、角色與生成物的所有權利。Anima-2.9B 採用不同的非商用條款。
Nanosaur2-670M · Luminia/Nanosaur2 · INT8-ConvRot
LoRA、局部重繪與 VAE 擴充
基礎倉庫的 train_lora.py 接受圖片及同名 .txt 描述,輸出到 models/loras,使用 LoraLoaderModelOnly。訓練的顯存和時間成本不同於推論,能生成不代表能順暢訓練。
levzalt 的 Inpaint-ControlNet 是社群遮罩編輯擴充,需用其完整 nanosaur2_support 取代原套件,不要重複安裝。載入專用圖、原圖與遮罩,尺寸使用 16 的倍數;範例預設 896 × 1152。這不代表所有 ControlNet 都能直接套用。
GAN-VAE 是另一項社群實驗。作者僅在也用於選模的小型保留集上回報較小的重建誤差改善,不能當成廣泛畫質提升的證明。應以相同 latent 比較,VAE 不能保證修正錯誤解讀的提示或人體結構。
train_lora.py · Inpaint-ControlNet · GAN-VAE
uv run python custom_nodes/nanosaur2_support/train_lora.py /path/to/images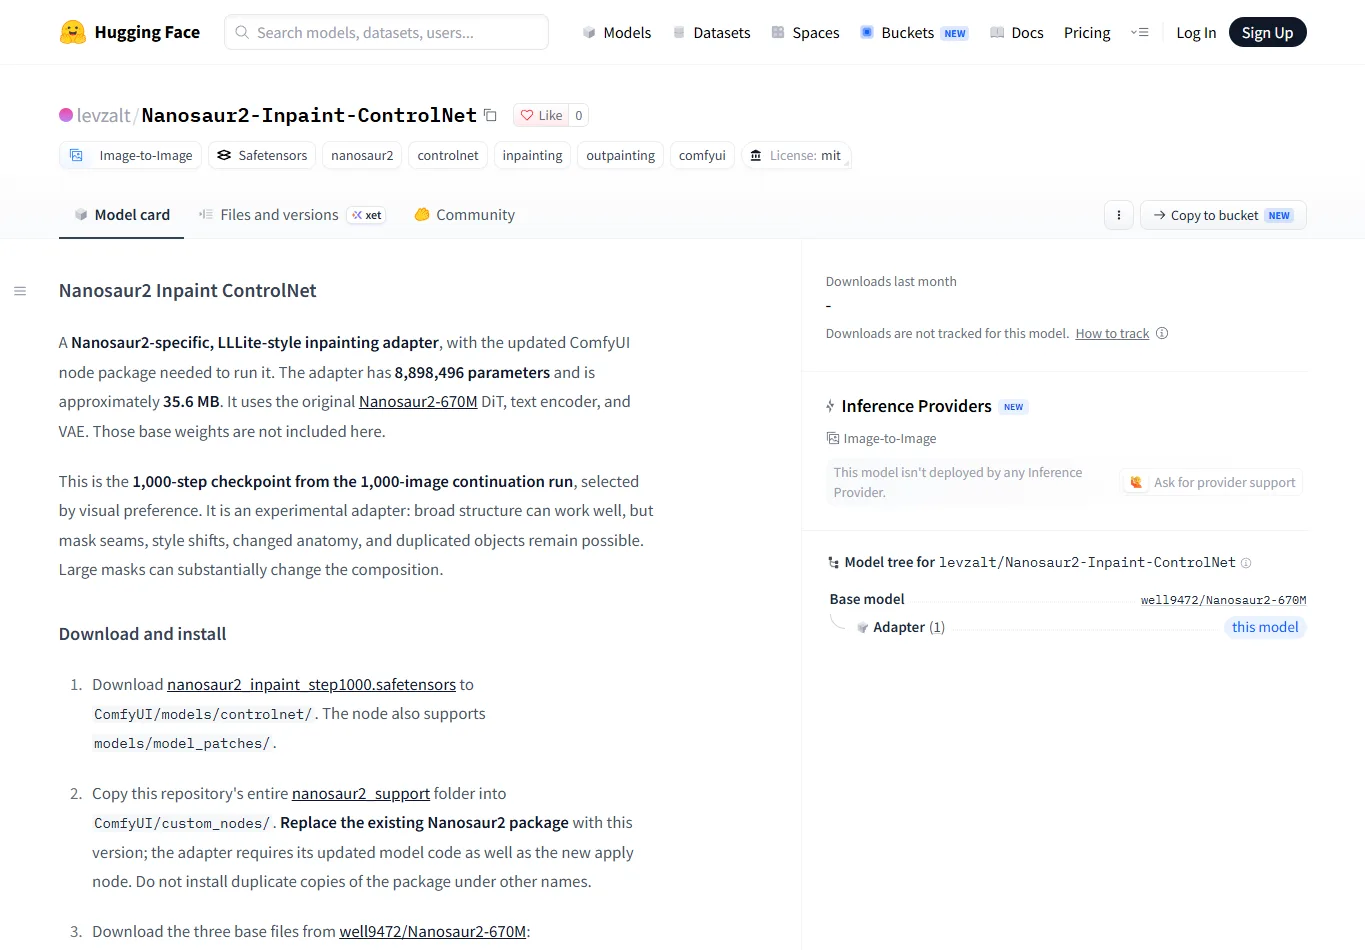
適合哪些人?
適合顯卡資源有限、想學 ComfyUI 模型整合、研究小型擴散架構,或想訓練特定風格 LoRA 的使用者。模型元件與工作流程公開,方便實際追蹤。
如果需要細緻背景、多人物穩定構圖、精準手部或可靠遵循複雜提示詞,建議選成熟的插畫模型。Nanosaur 2 更適合作為精簡研究底模和低成本實驗工具,而不是直接取代正式製作用模型。
常見實用問題
它是 Nano Banana 新版嗎?
不是。Nanosaur2-670M 是獨立的小型插畫模型,名稱相似不代表同一家開發者。
先下載哪個版本?
先用基礎版與標準工作流確認安裝成功,再比較 DMAD 專用權重和四步圖。
SDXL LoRA 或 ControlNet 能通用嗎?
不能假定相容。使用 Nanosaur 專用 LoRA 或有明確安裝文件的社群套件。
適合生成字體和 Logo 嗎?
文字不是強項,發布討論也指出這點。先生成插畫,再以編輯軟體加入正確文字。
有線上 API 嗎?
未確認官方付費 API;所找到的社群 Space 在 2026 年 10 月 12 日暫停中。
我的 GPU 也能每秒七張嗎?
不能據此保證。那是 5090 配置,必須依相同解析度、batch 與載入狀態測量自己的環境。
總結
Nanosaur 2 是一個有完整 ComfyUI 流程的小型插畫研究模型,低訓練成本與公開架構是亮點;構圖細節和獨立基準仍不足。
如果你想學小模型或測試 LoRA,值得在本機試跑。若需要穩定、精緻的成品,應優先使用成熟模型,再把 Nanosaur 2 當作研究和比較對象。
相關 評測
2026 年 5 款最佳桌布製作工具

Gemini 4 Argon 評測:程式能力、價格、長文本與 NSFW 限制
2026 年 5 款最佳圖片轉 3D 工具|AI 3D 模型生成器比較
NovelAI Diffusion 4.5 評測|免費 30 張、圖生圖、局部重繪與擴圖功能解析
Grok 4.6 評測:xAI 推理模型、Agent、價格與 NSFW 政策

Gemma 4 評測:本機部署、GPU 需求與 NSFW 政策