GPU Unlock 評測:RTX AI 加速、支援顯卡與實際風險
比較 gpu-unlock、KohakUnlock 與 Ada 版本:支援 RTX、ComfyUI 時間、LLM 限制、耗電與開機韌體風險,區分峰值與實際效益。

GPU Unlock 可以讓部分既有 GeForce 顯卡更快執行本機 AI,而不必先買新硬體。最有機會受益的是相容顯卡上、浮點 Tensor Core 運算佔比高的工作。它不會增加顯存,也不代表所有模型都快一倍,更不是已支援 RTX 5090 的升級方案。
對有備用 RTX 30 系 Linux 主機、能自行復原環境的使用者,公開證據值得研究;對工作主機、INT8 為主的流程,或想找通用 Windows 安裝器的人,代價就高得多。評測重點是各個實作能做什麼、適合誰,以及能省下多少完整工作的時間。
目錄
GPU Unlock 改變的是哪條運算路徑
目標是低精度乘法、以 FP32 累加的 Tensor Core 路徑。即使輸入同為 FP16,FP16 累加仍是另一種情況;一般 FP32 CUDA 與整數運算也不同。NVIDIA Ada 白皮書早已分列這些模式的速率,不能拿一個「AI TOPS」數字當成通用比較基準。
主要工具會在正常 NVIDIA 驅動程式接管前執行具特權的韌體,修改運算速度選擇暫存器,再交回原廠驅動。只說「驅動設定解鎖」會省略重要的開機與韌體機制。查核的方式不需要刷寫 VBIOS 或提高電壓,但特權執行仍有風險。
開發者將限制解釋為產品市場區隔。可觀察到的是特定指令速率改變,並不能據此認定所有消費級工作原本都被砍半,或 NVIDIA 認可這些修改。以下資料也沒有建立遊戲 FPS 提升的證據。
評測範圍:截至 2026 年 10 月 29 日,分析官方專案文件、擁有者公開測量與媒體報導。AirMore 未執行顯卡解鎖、CUDA 跑分或耐久測試。表格重算公開時間;專案截圖是文件畫面,並非本站跑分。AI 協助研究、撰寫及本地化,封面為編輯示意圖。
四個專案的定位與使用差異
gpu-unlock — Zagitta
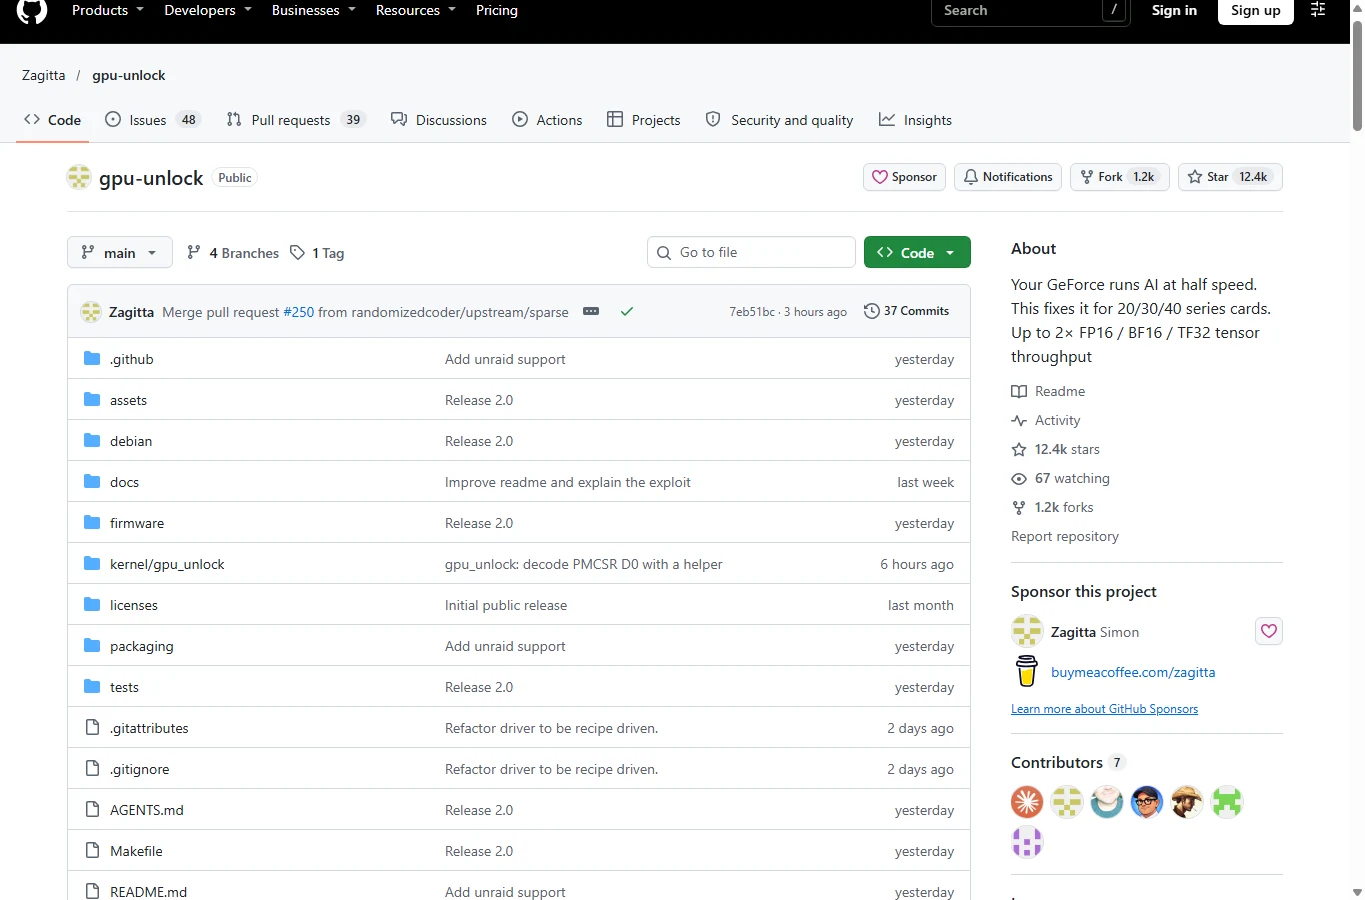
這是研究 Ampere 時的主要 Linux 上游專案。查核的 README 標示 v2.0.0,包含發行版套件與 initramfs 整合,除了 RTX 30 系,也列出實驗性的 Turing、Ada 支援。型號被列入或標為 stable,屬於維護者分類,不等於每一張板卡都取得獨立驗證。
它必須在 NVIDIA 綁定顯卡之前執行;正常驅動接管後才手動載入模組,不會解鎖該卡。核心標頭、開機載入順序、精確 PCI 身分和可用的原始開機項目,比顯卡商品名稱更重要。模組是免費的 GPL-2.0-only 原始碼,NVIDIA 韌體仍受個別條款約束。
維護者明確表示沒有關聯的官方網站、加密貨幣或通用安裝器。同名搜尋結果不能當成官方下載。應核對作者與指定修訂版;有套件不代表免除核心、開機整合,以及系統更新後的回歸檢查。
gpu-unlock-ada — JustAResearcher
gpu-unlock-ada — JustAResearcher
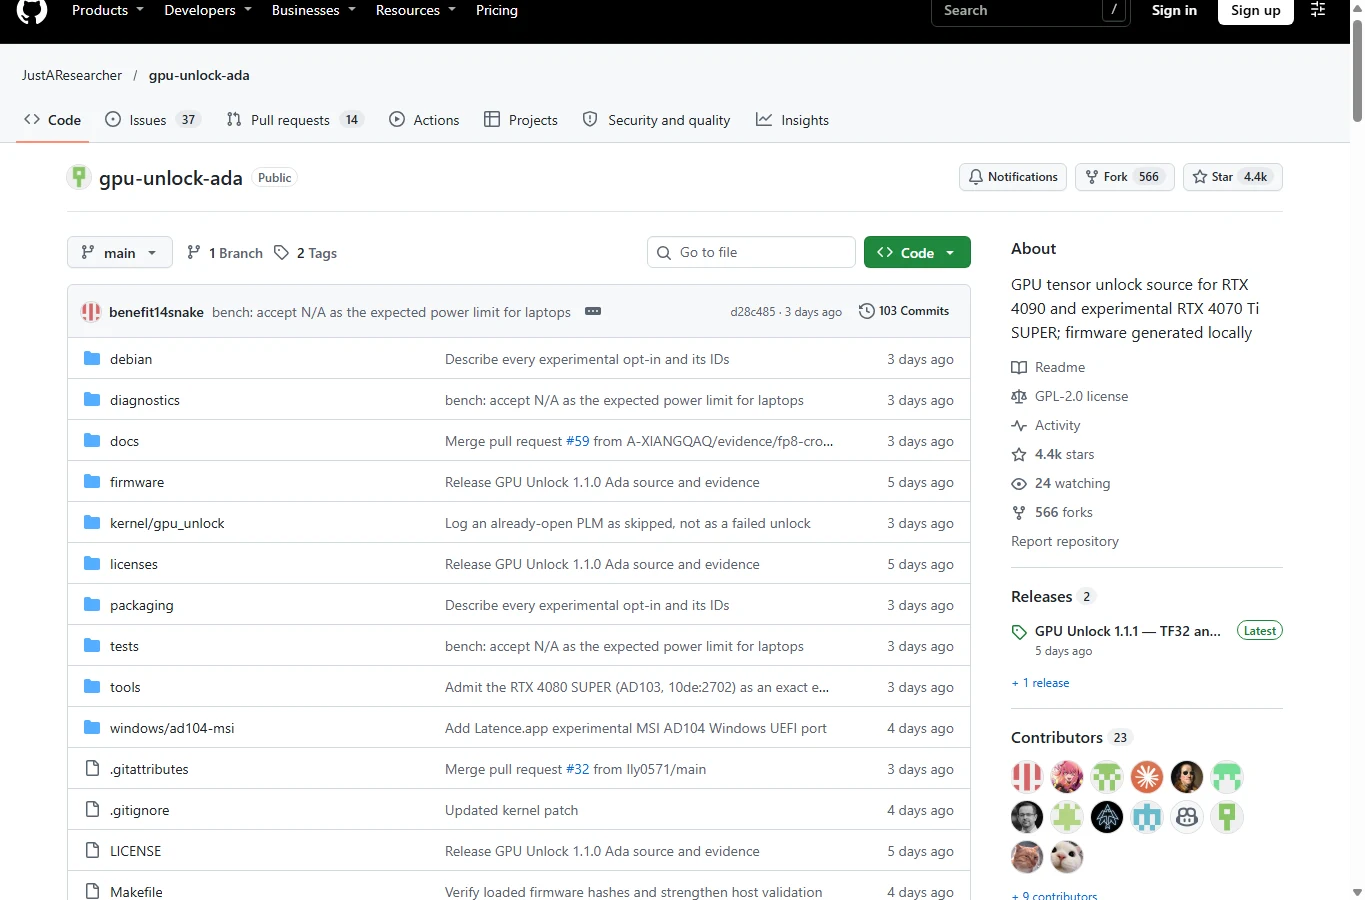
這個 Linux 分支聚焦 Ada 韌體與有效負載整合,查核的 README 為 v1.1.1,並保存詳細 RTX 4090 證據。獨立擁有者的配對測量保持相同顯卡、程式、驅動及 450 W 上限,比不同條件的峰值截圖更有參考價值。RTX 4070 Ti SUPER 也有實驗紀錄,但不代表整個 40 系都已驗證。
優點是將指令吞吐、cuBLAS GEMM 與數值檢查分開;限制是硬體樣本少,沒有長期應用及耐久驗證。另附的 MSI RTX 4070 Ti Windows 參考移植只對應特定設定,不代表通用 Windows 支援,也不會自動增加該卡的 Linux 支援。
FP8 不能一概而論。Ada 證據顯示 FP32 累加的 FP8 指令可能加速,但一組配對 FP8 GEMM 幾乎不變。「所有 8bit 模型都加速」與「FP8 完全無效」都過度簡化,實際核心、累加格式與瓶頸才是關鍵。
KohakUnlock — KohakuBlueleaf
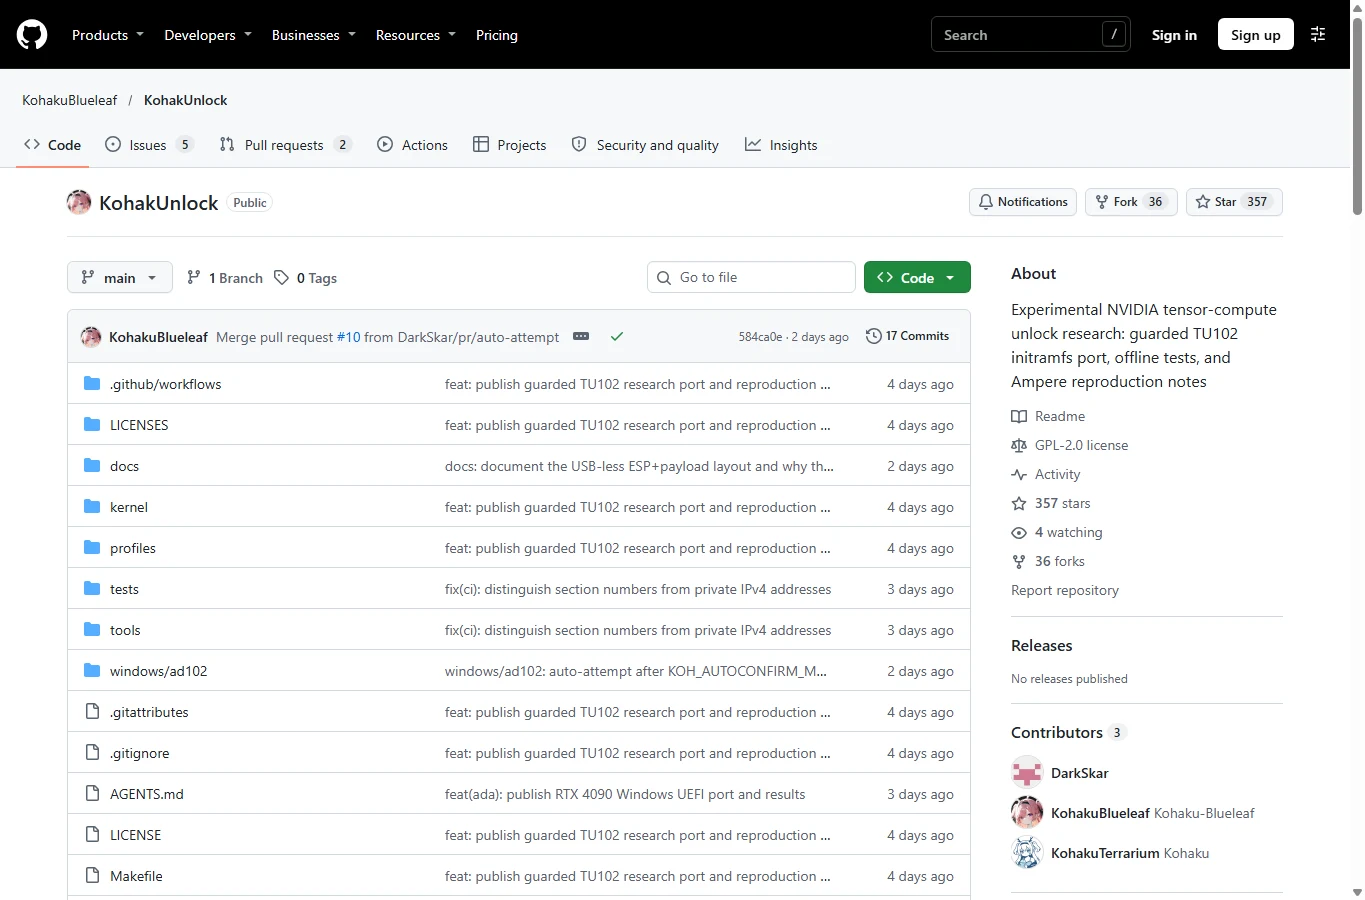
KohakUnlock 是重視原始碼與驗證紀錄的研究專案,不是通用一鍵解鎖器。內容涵蓋實體改裝顯存 RTX 2080 Ti 的 Linux 實驗、RTX 4090 Windows/UEFI 路徑,以及使用 Zagitta 上游部署 RTX 3090 的經驗。報告中的 22 GB、48 GB 顯存來自硬體改裝,不是軟體增加的容量。
公開 Linux 執行器預設關閉硬體操作,並有嚴格的裝置與韌體檢查。Windows 路徑以本機準備的 EFI 交易交接原廠驅動。成功的已簽章 EFI 實機測試仍關閉 Secure Boot,因此程式具備簽章機制,不代表已驗證 Secure Boot 開啟下可用。
它對限制的記載相當具體:2080 Ti 行列尺寸搜尋比較的是兩張已改裝顯卡,3090 復原的原始基準也使用不同功率上限;公開封裝與歷史測試執行檔並非完全相同。適合作為有復原能力的開發者參考,不能當成日常電腦的低門檻加速建議。
AD103_win_unlocker — TOTORONG
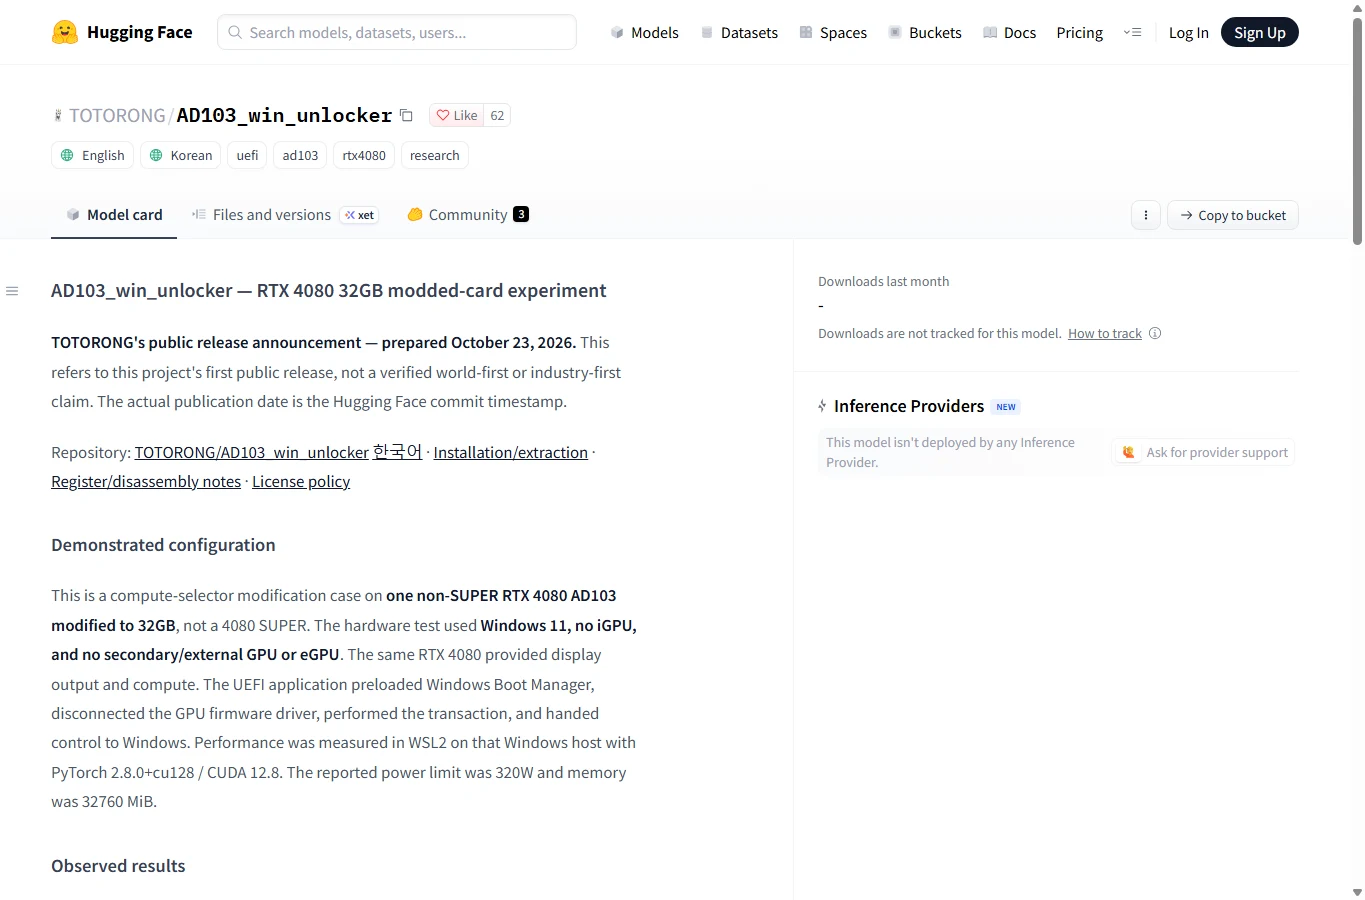
這是發表在 Hugging Face 的 Ada Windows/UEFI 研究成果,不是圖片模型或雲端 GPU 服務。示範設定是一張實體改裝成 32 GB 的非 SUPER RTX 4080、Windows 11,以 WSL2/PyTorch 測量,報告功率上限 320 W。它是理解 Ada 移植來源的重要資料。
發行 EFI 綁定裝置、子系統身分及 ROM 雜湊,另一張同名 RTX 4080 也可能被拒絕。GEMM 增益隨矩陣尺寸不同,作者未主張 LLM 整體、DLSS 或光線追蹤加速。雖提供原始碼和擷取工具,修改 ID 或雜湊不等於完成有效移植。應將它視為精確研究參考,而非一般 Windows 下載工具。
支援哪些 RTX 與作業系統
| 世代 | 可參考證據 | 適用邊界 |
|---|---|---|
| RTX 30 / Ampere | 3090、3090 Ti、3060 等報告;上游部署較多 | 核對板卡、PCI ID、核心、驅動與修訂版;各型號驗證程度不同 |
| RTX 40 / Ada | 4090 配對測量與其他特定板卡實驗 | Linux 與 Windows/UEFI 路徑不同;單卡成功不能推廣至整個系列 |
| RTX 20 / Turing | 2080 Ti FP16→FP32 測量 | 不新增原生 BF16、TF32;改裝顯存樣本不等於原裝卡保證 |
| RTX 50 / Blackwell | 查核方式不支援 | 未確認有可用的 5090 解鎖;困難不等於已發行 |
10 月 29 日上游 README 的涵蓋範圍已比 10 月 24–26 日報導更廣,應視為不同時間點資訊,而非相互保證。筆電還有獨立 GPU 斷電後暫存狀態清除的問題,執行期電源管理與睡眠喚醒都需要逐機驗證。
使用語言不是硬體相容條件:這些是技術儲存庫與開機工具,不是多語生成服務。官方文件以英文為主,TOTORONG 另有韓文內容。中文說明不能擴大支援範圍,也不會降低開機操作本身的複雜度。
公開計算測試能證明什麼
Ada 儲存庫的 RTX 4090 配對紀錄採 Linux 7.2.11-arch1-1、NVIDIA 615.78.08 與相同 450 W 上限。FP16/FP32 指令由 160.4 增至 320.4 TFLOPS,BF16/FP32 由 159.7 增至 320.2;但 cuBLAS GEMM 的 FP16 中位數只增加 12–34%,BF16 兩種尺寸約增加 16–20%,4096³ 幾乎不變。這是一位擁有者的測量,不是應用整體快一倍。
Zagitta Issue #150 記載 12 GB RTX 3060、170 W、Ubuntu 26.04.1、NVIDIA open 595.99.02、PyTorch 2.14.1+cu130;8192³ GEMM 報告 FP16 約增加 78%、BF16 81%、TF32 76%。它支持該設定的 3060 可行性,不能改寫成每張 3060 圖片生成都增加這些幅度。
KohakUnlock 的同卡 2080 Ti 指令測量,FP16→FP32 由 59.9 增至 111.0 TFLOPS,FP16→FP16 與 INT8 對照大致不變。矩陣尺寸搜尋最高中位數 57.71 對 88.24 TFLOPS 則來自不同改裝卡與不同最佳尺寸,不能宣稱同一張卡的受控測試快了 53%。
Tom’s Hardware 與 Notebookcheck 均報導了專案與工作負載差異,但主要追溯開發者和擁有者測量,不能視為額外兩次獨立實驗室複測。
Tom’s Hardware · Notebookcheck
ComfyUI、LLM 與訓練的實際效益
較貼近創作者工作的 ComfyUI 測試來自 u/under-_-null:同一張 EVGA FTW3 RTX 3090 Ti,Ubuntu、NVIDIA 615.71.09、ComfyUI 0.42.1、原廠時脈、450 W 上限。每種靜態圖片設定在兩個狀態各測 15 張,排除前三次暖機,batch 1,固定提示詞、種子和模型。中位數涵蓋完整請求,排除初次載入模型。
| 工作流程 | 原始 → 解鎖後 | 吞吐增加 | 耗時減少 |
|---|---|---|---|
| MOSS-Image SFT BF16 | 71.98 s → 45.40 s | +58.5% | 36.9% |
| MOSS-Image SFT INT8 | 27.31 s → 27.23 s | +0.3% | 0.3% |
| Qwen-Image 2.1 Turbo BF16 | 8.51 s → 5.41 s | +57.3% | 36.4% |
| Qwen-Image 2.1 Turbo INT8 | 3.92 s → 3.75 s | +4.5% | 4.3% |
| Z-Image Turbo BF16 | 6.79 s → 4.35 s | +56.1% | 35.9% |
| Krea 2 Turbo BF16 | 15.65 s → 10.70 s | +46.3% | 31.6% |
MOSS 使用 1024×1024、50 步;Qwen、Z-Image、Krea Turbo 使用 1024×1024、8 步。表格以「原始時間÷解鎖時間−1」重算吞吐,以「1−解鎖時間÷原始時間」計算省時;與原文些微差異來自四捨五入。吞吐增加約 59%,是等待減少約 37%,不是耗時減少 59%。
作者報告 150 組配對靜態圖片的解碼 RGB 像素一致;這只支持測過的流程,不能保證所有數值完全相同。他使用的 FLUX FP8 檢查點實際仍以 BF16 運算,顯示檔案精度標籤不足以判斷效益。INT8 流程也可能含浮點階段,應以分析資料確認,而非宣稱完全沒有或固定幅度的效益。
LLM 應分開看 prefill 提示處理和 decode 逐字生成。另一組固定功率社群測試報告 3060 prefill 約增加 15%,decode 幾乎不變。整數核心、記憶體頻寬、CPU 卸載及 PCIe 傳輸可能才是瓶頸。BF16 訓練或 LoRA 可能受益,但行列乘法圖表不足以證明完整訓練縮時或收斂不變。
一個示範計算:若適用運算佔總時間 40%,該部分恰好加速兩倍,整體只有 1÷(0.60+0.40/2)=1.25 倍、耗時減少 20%。這不是實機測量,而是解釋指令翻倍與應用小幅提升為何可以同時成立。
功率、溫度與每次任務的耗電
任務提早完成,即使瞬間功率增加,每張圖的電力量仍可能下降。W、每次任務的 J 與溫度是不同指標,公開樣本無法支持「解鎖必然降低功率」的通則。
3090 Ti 擁有者測得 MOSS BF16 平均核心溫度由 77.9°C 變成 78.7°C;其他流程有下降,但起始溫度及室溫未控制,也未記錄顯存接面或熱點溫度。這不證明解鎖更涼,也不是長期安全認證。
前後比較應保持相同功率上限;降低上限可以另做效率實驗,但也可能壓低增益。在同一組對照中改上限會混淆原因。比起為了 TFLOPS 提高電壓或功率,更有用的是記錄完整工作、輸出檢查、電力量與溫度。
安裝、復原及維護成本
不刷 VBIOS 並不等於保證復原。KohakUnlock 明列 GPU 或主機掛起、無法開機、資料損壞與硬體受損風險。暖重啟不一定清除所有狀態;若開機設定持續啟用,重新啟動還會再執行解鎖。
評估前應核對精確板卡與修訂版,保存備份、磁碟加密復原金鑰、不變更的正常開機項目,並具備本機或 BMC 主控台及完整斷電能力。不應隨意關閉 Secure Boot、IOMMU、繞過型號檢查,或對已被驅動接管的 GPU 強制操作。停在網路啟動前,SSH 也救不了。
驗收要分三關:正常開機與原廠驅動交接、可重現數值檢查且無 Xid 錯誤、相同條件下的完整應用測量。任一單項都不是耐久保證。核心或驅動更新、睡眠喚醒後需再確認;韌體應遵守授權,分享紀錄前應移除主機識別資料。
查核的原始碼專案沒有訂閱費,真正成本是設定、復原能力、維護與停機。它們是具特權的本機元件,不是雲端隱私功能;執行不可信任的二進位檔,授予的存取權比開啟模型檔案高得多。
哪些人值得考慮
值得評估的對象是有相容備用 RTX 30 卡,或完全符合已記載 Ada/Turing 設定、以 BF16/FP16 為主且懂得復原的進階使用者。應同時比較畫質可接受的最快量化流程,不要只拿較慢的精度設定作為對手。
關鍵工作站、不支援的 5090、型號不明的筆電,或主要受頻寬與 INT8 限制的工作,保留原始環境通常更合理。它的價值在於利用現有 Tensor Core 的特定路徑;是否值得採用,要看可驗證的省時能否抵銷開機複雜度與長期穩定性的不確定性。
相關 評測
2026 年 5 款最佳 AI 影片配音工具

2026 年 5 款最佳桌布製作工具
2025 年十大語音轉文字工具推薦(免費與付費精選)

Spotify 下載後存在哪裡?能匯出 MP3 嗎?
MiniMax H3 評測:具備原生音訊的開放權重 AI 影片模型
2026 年 5 款最佳 AI 海報製作工具推薦