Melhores LLMs de Código Aberto Locais em 2026: Desempenho, NSFW e Hardware Comparados
O melhor LLM local já não é o modelo com a maior contagem de parâmetros. Em 2026, a questão prática é mais específica: qual é…
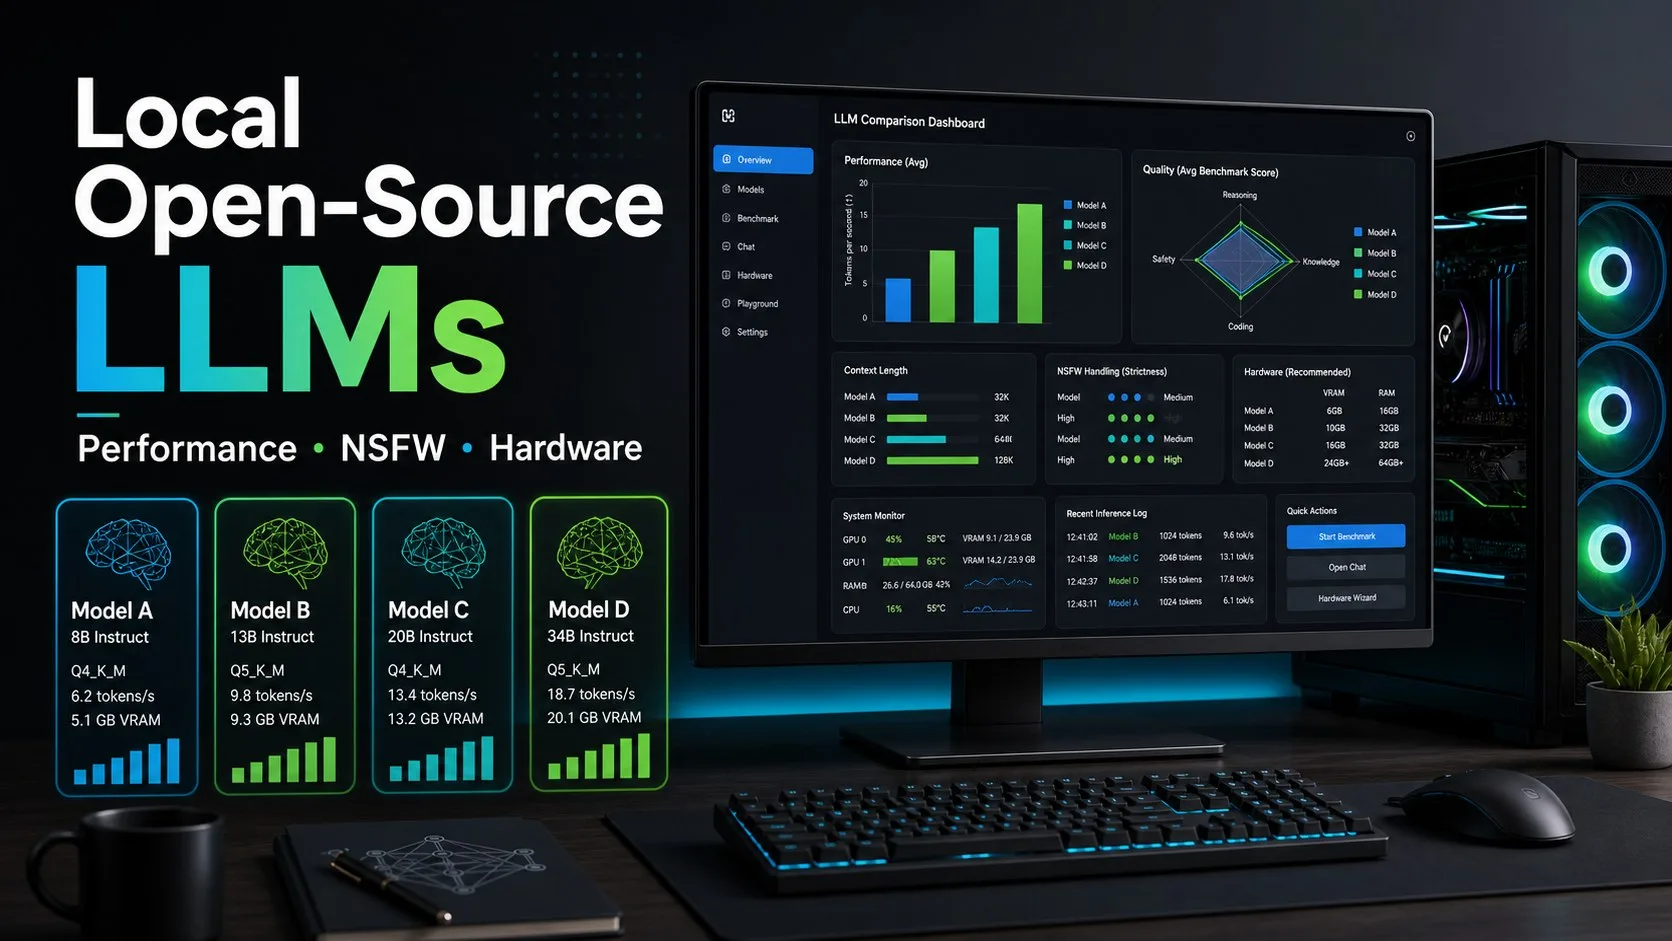

O melhor LLM local já não é o modelo com a maior contagem de parâmetros. Em 2026, a questão prática é mais específica: qual é o modelo de código aberto ou pesos abertos que oferece o equilíbrio certo entre qualidade, flexibilidade NSFW, custos de hardware, licenciamento e controlo local?
Para a maioria dos leitores, a lista restrita é simples. Escolha o Qwen 3.8 para tarefas multilingues, programação e RAG; o Gemma 4 quando procura um modelo de pesos abertos da Google com documentação sólida; o Dolphin 3.0 quando a flexibilidade em termos de NSFW/roleplay com poucas recusas é importante; e o DeepSeek V4 se estiver a avaliar cargas de trabalho de contexto longo, agentes ou de escala empresarial, em vez de um modelo de chat normal para computador.
Índice
Recomendação Rápida
| Necessidade | Melhor Escolha | Motivo |
|---|---|---|
| Melhor LLM local polivalente para multilingue/programação | Qwen 3.8 27B | Forte comportamento multilingue, programação, utilização de ferramentas e uma opção prática de 27B para utilizadores locais avançados. |
| Ecossistema da Google e documentação de segurança mais clara | Gemma 4 | Bom cartão de modelo, documentação oficial, vários tamanhos e alinhamento oficial mais seguro. |
| NSFW, roleplay e escrita com poucas recusas | Dolphin 3.0 | Uma linha clássica de aperfeiçoamento (fine-tune) sem censura, criada para controlo de prompts do sistema e menos recusas. |
| Avaliação de contexto longo / escala empresarial | DeepSeek V4 | Pesos abertos, direção de contexto de um milhão de tokens e opções Pro/Flash, mas exige hardware potente. |
| Maior ecossistema de aperfeiçoamentos | Llama 4 / Família Llama | Comunidade enorme, variantes GGUF e derivados de roleplay/sem censura. |
| MoE de pesos abertos para servidores exigentes | Mistral Large 3 | Forte opção europeia de pesos abertos, mas muito além do hardware de um computador doméstico comum. |
| Modelo focado em agentes e utilização de ferramentas | Kimi K2 / Kimi K2 Thinking | Interessante para agentes de programação e fluxos de trabalho com ferramentas, não focado principalmente em NSFW. |
| Programação com contexto longo e trabalho de agentes | GLM-4.6 | Boa alternativa quando um contexto de 200K e programação orientada a agentes são mais importantes do que o comportamento sem censura. |
Desempenho
Os benchmarks são úteis, mas a escolha de um LLM local deve começar pela sua carga de trabalho. Programação, escrita em japonês/chinês/inglês, RAG de contexto longo, roleplay e fluxos de trabalho com agentes muitas vezes classificam o mesmo modelo de forma diferente. Um modelo pequeno com boa quantização pode superar um modelo maior se couber na sua GPU e responder mais depressa.
As tabelas classificativas públicas, como a Artificial Analysis e a LMArena, são úteis para uma visão geral, mas não substituem os testes práticos locais. Por exemplo, um modelo com boa pontuação em chat geral pode continuar a ser fraco com os seus documentos privados, chamadas de ferramentas, controlo de tom em japonês ou escrita criativa NSFW.
| Modelo | Caraterísticas de Desempenho | Principal Compromisso |
|---|---|---|
| Qwen 3.8 | A melhor escolha equilibrada para multilingue, programação e trabalho local prático. | Os modelos oficiais não foram criados como modelos NSFW sem censura. |
| Gemma 4 | Linha de pesos abertos bem documentada com opções de 12B/26B/31B. | Pode parecer mais alinhado com a segurança e menos flexível do que os ajustes sem censura. |
| Dolphin 3.0 | Forte obediência a prompts do sistema, escrita e roleplay. | Menos focado em benchmarks; requer disciplina de segurança por parte do utilizador. |
| DeepSeek V4 | Interessante para contexto longo, agentes e serviços em grande escala. | Não é um modelo confortável para desktop com uma única GPU. |
| Llama 4 / Família Llama | O maior ecossistema da comunidade para ajustes, versões GGUF e experimentação local. | Os lançamentos oficiais não são focados em NSFW; a qualidade depende muito do ajuste escolhido. |
| Mistral Large 3 | Modelo MoE de pesos abertos com um teto muito elevado para implementações em servidor. | Os modelos da classe 675B não são viáveis para computadores domésticos. |
| Kimi K2 Thinking | Ideal para agentes de programação, chamadas de ferramentas e tarefas longas em várias etapas. | Mais orientado para agentes do que para roleplay/NSFW. |
| GLM-4.6 | Contexto longo e melhorias na programação/agentes, com distribuição acessível de modelos abertos. | Menos conhecido globalmente do que Llama ou Qwen, mas vale a pena testar para fluxos de programação. |
Comportamento NSFW e Sem Censura
O NSFW é a área em que os LLM locais mais diferem dos assistentes na nuvem. Os modelos alojados normalmente adicionam moderação por parte da plataforma, enquanto os modelos locais de pesos abertos permitem que o proprietário escolha o motor, o prompt do sistema e filtros adicionais. Isto não significa que todos os modelos locais sejam igualmente livres de restrições.
Dolphin 3.0 é claramente a escolha mais compatível com NSFW neste grupo. Pertence à tradição clássica de ajustes sem censura e é popular para roleplay privado, ficção, escrita para adultos e experiências de controlo de prompts. É poderoso porque transfere maior responsabilidade para o utilizador.
O Qwen 3.8 e o Gemma 4 têm lançamentos oficiais alinhados com a segurança, mas a comunidade também cria derivados abliterados ou sem censura. Estes podem reduzir as recusas, mas não são versões oficiais e devem ser tratados como modelos separados, com verificações de confiança e licenças próprias. O DeepSeek V4 deve ser encarado mais como um modelo de contexto longo/agentes do que como um modelo focado em NSFW.
Requisitos de Hardware e VRAM
O maior erro com LLMs locais é descarregar o modelo que parece melhor no papel e, a seguir, descobrir que este se arrasta na sua máquina. A VRAM, a quantização, o comprimento do contexto e a cache KV importam tanto quanto o tamanho do modelo.
| Hardware | Modelos Realistas | Notas |
|---|---|---|
| 8GB-12GB VRAM | GGUF 7B/8B, Dolphin 3.0 8B, pequenas variantes Llama/Mistral | Bom para chat e testes de escrita, fraco para RAG intenso ou agentes longos. |
| 16GB VRAM | Modelos da classe 12B, Q4/Q5 20B-27B com limitações | Um patamar prático para entusiastas, se aceitar um contexto mais curto. |
| 24GB VRAM | Qwen 27B quantizado, Gemma 31B/26B quantizado, Dolphin 24B GGUF | O ponto ideal para utilizadores domésticos exigentes. |
| 48GB-80GB VRAM | Modelos BF16 maiores, contexto longo, melhor débito | Melhor para serviços, RAG e trabalho com múltiplos utilizadores. |
| Multi-GPU / servidor | DeepSeek V4 Pro/Flash, modelos MoE muito grandes | Território empresarial ou de investigação, não para chat local casual. |
Análise Modelo a Modelo
Qwen 3.8: A Melhor Escolha Local Equilibrada
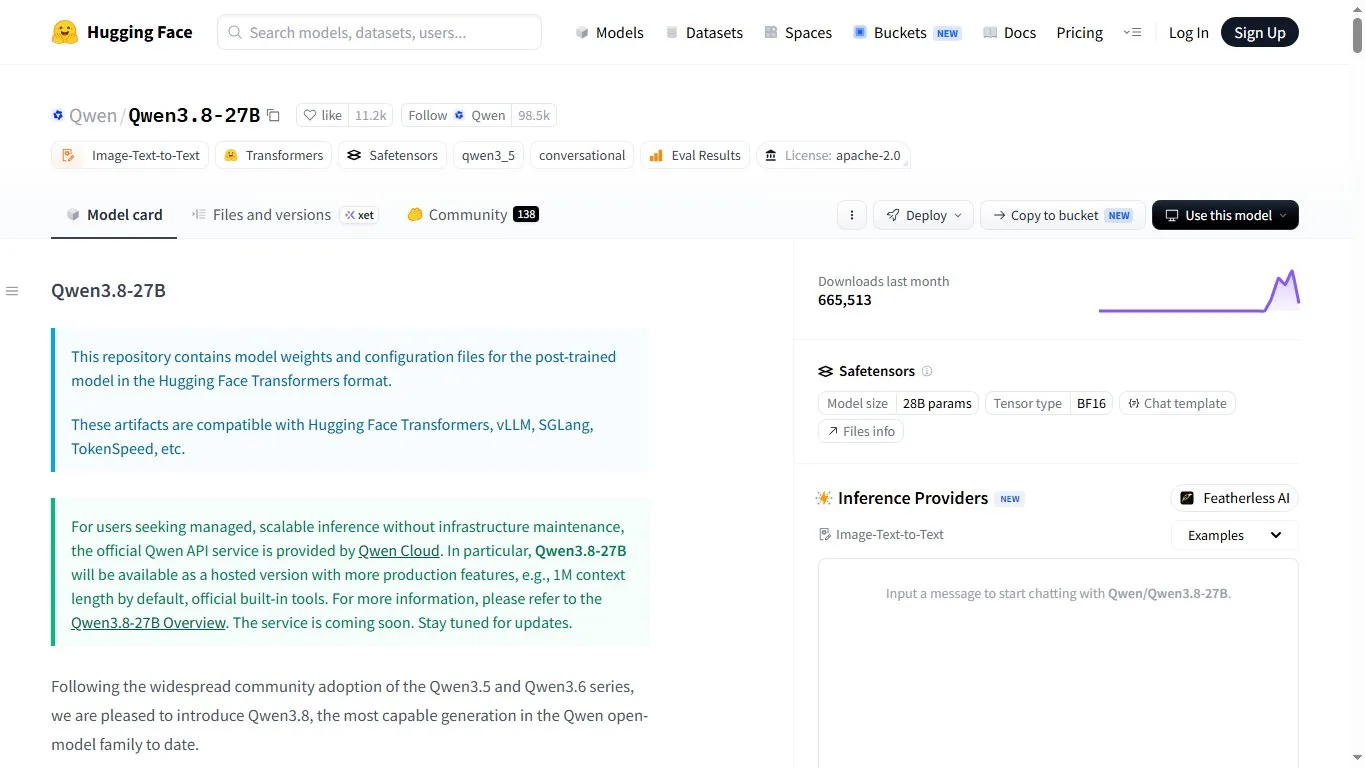
O Qwen 3.8 é a família de modelos com a qual começaria para trabalho multilingue, programação, RAG e tarefas diárias de assistente local. A ramificação de 27B é muito mais realista do que a enorme ramificação da classe Max, mantendo-se substancialmente mais capaz do que os modelos pequenos de 7B/8B.
O seu ponto fraco não é a qualidade, mas sim o propósito. Os modelos oficiais do Qwen não foram concebidos como modelos NSFW sem censura. Se o seu principal objetivo são menos recusas para roleplay adulto, o Qwen não é a primeira escolha, a menos que escolha e teste deliberadamente uma versão abliterada pela comunidade.
Gemma 4: Melhor Documentação e Ecossistema Google
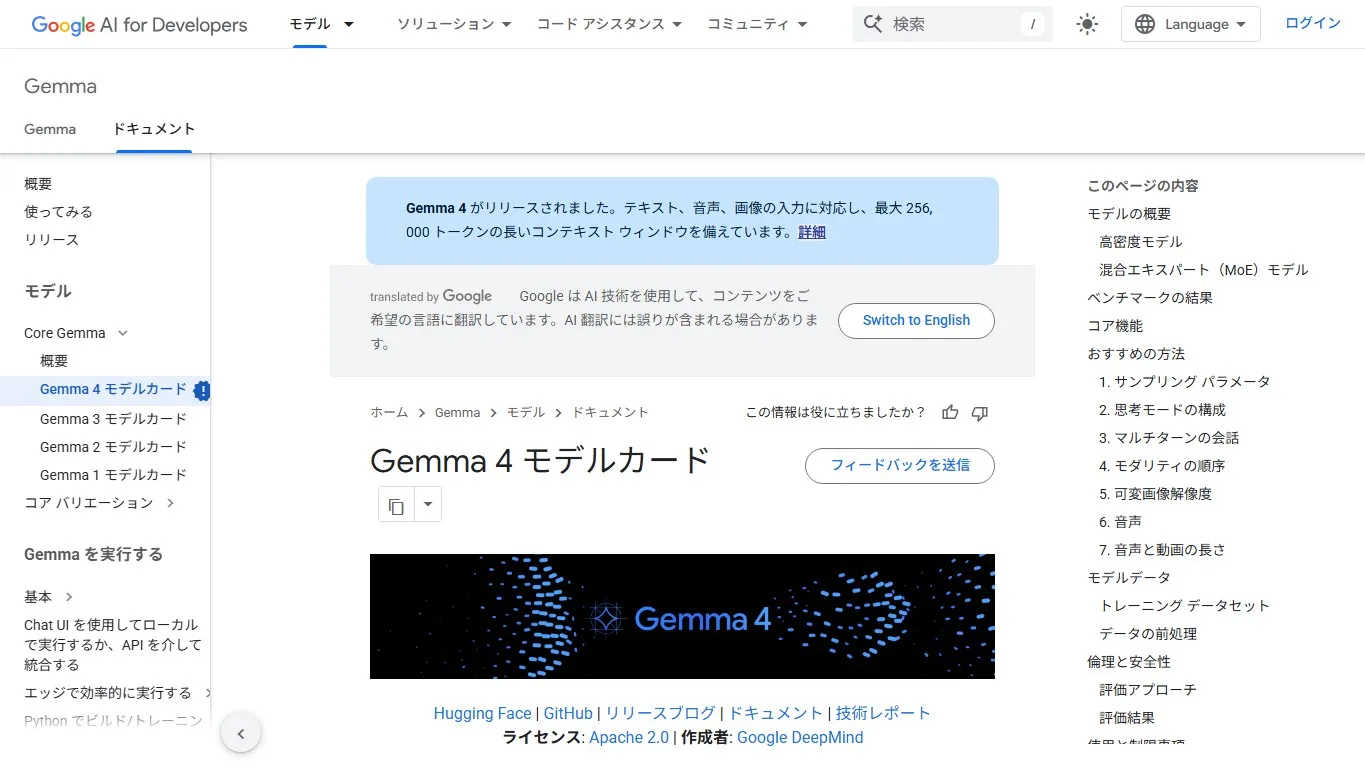
O Gemma 4 é atraente quando procura pesos abertos, documentação oficial e uma família de modelos limpa. A versão de 12B é o ponto de partida mais fácil, enquanto as versões 26B-A4B e 31B são alvos de qualidade mais sérios para hardware mais potente.
Em relação ao NSFW, o Gemma 4 é mais conservador na sua forma oficial. A existência de modelos da comunidade sem censura/heréticos e abliterados torna o ecossistema interessante, mas estes não devem ser confundidos com o alinhamento oficial ou a postura de segurança da Google.
Dolphin 3.0: O Melhor para NSFW Sem Censura e Roleplay
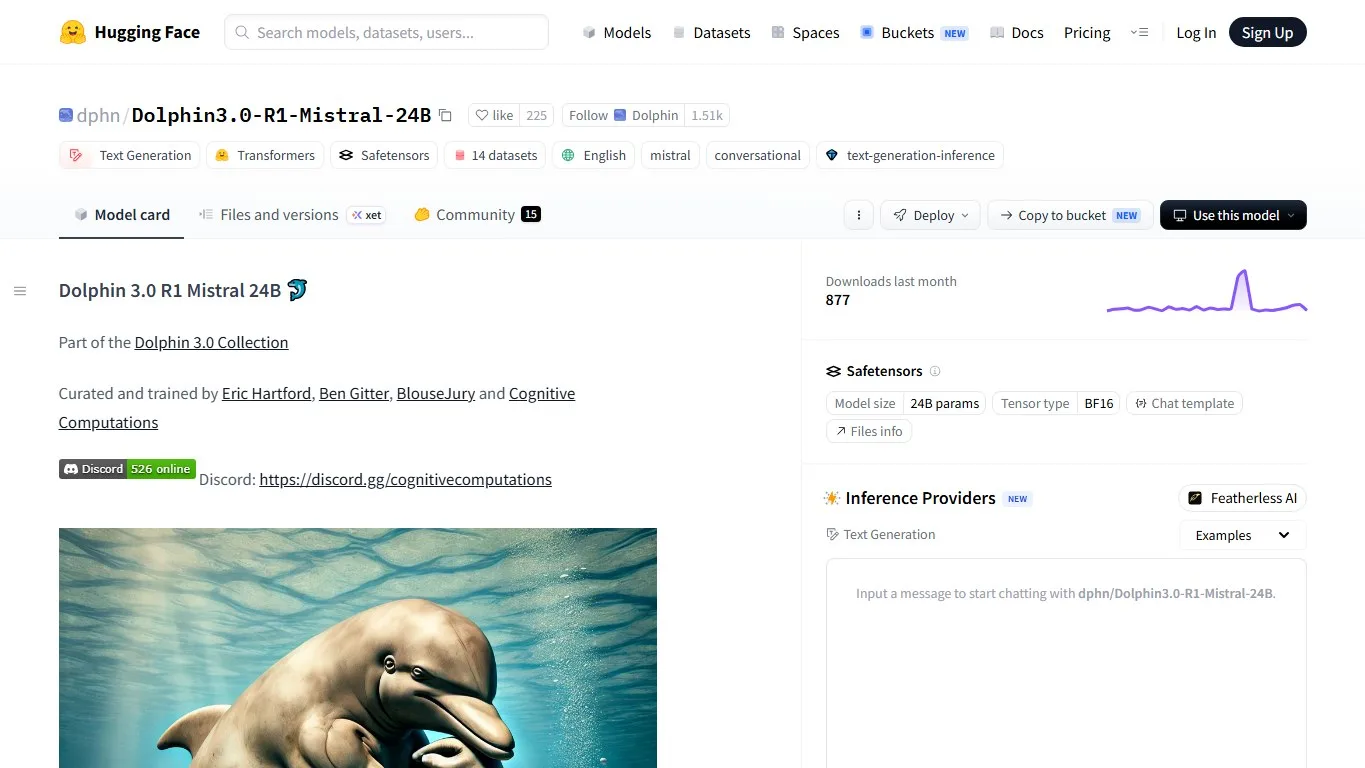
O Dolphin 3.0 continua a ser a recomendação mais evidente quando a intenção de pesquisa inclui conteúdos sem censura, NSFW, roleplay ou escrita com poucas recusas. Não tenta ser o assistente geral mais alinhado com a segurança; o seu objetivo é ser um modelo local controlável onde o proprietário do sistema decide o comportamento.
Comece com a rota 8B ou GGUF se tiver um computador normal. Mude para o Mistral 24B se quiser melhor escrita e raciocínio e puder arcar com os custos de hardware. Para uma implementação pública, adicione as suas próprias regras de moderação e utilização.
DeepSeek V4: Potente, mas Exigente
O DeepSeek V4 é tecnicamente impressionante e merece ser acompanhado, especialmente para tarefas de contexto longo, agentes e tarefas do lado do servidor. A divisão Pro e Flash é útil porque permite às equipas decidir entre um resultado mais forte e um débito mais económico.
Para o utilizador local comum, o problema é o hardware. O DeepSeek V4 não é a recomendação confortável para uma única GPU. É mais adequado para equipas que conseguem executar serviços ao estilo de vLLM/SGLang, gerir custos e avaliá-lo com base numa carga de trabalho real.
Llama 4 e Ajustes Llama: O Melhor Ecossistema
A família Llama continua a ser impossível de ignorar. O Llama 4 Scout e o Maverick levaram a linha de modelos abertos da Meta ainda mais para o território multimodal e MoE, enquanto o ecossistema mais amplo do Llama continua a ser o sítio mais fácil para encontrar compilações GGUF, ajustes de roleplay, variantes de programação e guias de implementação.
O aspeto negativo é que o Llama não é apenas um modelo. Um lançamento oficial básico, um ajuste de programação, um ajuste de roleplay e um derivado sem censura podem comportar-se de formas completamente diferentes. Para os leitores que pretendem a máxima escolha, o Llama é excelente. Para os leitores que pretendem uma recomendação clara, o Qwen ou o Gemma podem gerar menos confusão.
Mistral Large 3: Pesos Abertos para Infraestruturas Exigentes
O Mistral Large 3 merece destaque porque representa um tipo diferente de ambição local/de pesos abertos. É um grande modelo MoE direcionado para implementação aberta de nível de vanguarda, com expectativas de infraestrutura muito superiores às de um modelo de desktop de 12B ou 27B.
Para um utilizador individual, o Mistral Large 3 raramente é a primeira descarga local. Para uma equipa com GPUs de servidor, integra a lista restrita juntamente com o DeepSeek V4 e outros modelos MoE de grande escala. O seu comportamento NSFW deve ser avaliado a partir do ponto de verificação de instruções exato, da camada do fornecedor e da política de implementação, e não apenas pelo nome do modelo.
Kimi K2: Especialista em Agentes e Utilização de Ferramentas
O Kimi K2 Thinking é interessante para utilizadores que valorizam a utilização de ferramentas, agentes de programação e fluxos de trabalho longos em várias etapas. Não é a escolha óbvia para um chat simples em desktop, mas pode ser atraente quando está a criar sistemas de agentes ou a avaliar a execução de tarefas complexas.
Em comparação com o Dolphin, o Kimi não é essencialmente um modelo de roleplay sem censura. Em comparação com o Qwen, assemelha-se mais a um concorrente especializado em agentes/programação. Se estiver a programar agentes, agentes de browser ou a automatizar fluxos de trabalho, merece um teste dedicado em vez de ficar relegado para segundo plano pelas pontuações de chat geral.
GLM-4.6: Alternativa para Contexto Longo e Programação
O GLM-4.6 é outra linha de modelos que deve constar numa comparação real em 2026. Pode não ser tão familiar para muitos leitores ocidentais como o Llama ou o Mistral, mas é relevante para cargas de trabalho de contexto longo, programação e agentes, especialmente para utilizadores que já comparam ecossistemas de modelos abertos chineses.
O seu papel prático é semelhante ao do Kimi e do Qwen num aspeto: teste-o nas suas próprias tarefas de programação, multilingues e de documentos. Não o escolha apenas porque um benchmark parece bom; escolha-o se lidar melhor com o seu comprimento de contexto real, chamadas de ferramentas e pilha de servidores locais do que as alternativas.
Como Escolher
- Comece pela sua tarefa real: programação, escrita, RAG, roleplay, documentos longos ou agentes.
- Escolha o modelo maior que funcione com velocidade suficiente no seu hardware, e não o maior modelo que consiga carregar tecnicamente.
- Utilize GGUF ou quantização de 4-bit para testes em desktop, mudando para BF16 ou serviços em servidor apenas quando necessário.
- Para NSFW ou trabalho criativo com poucas recusas, teste os modelos ao estilo Dolphin e Llama-fine-tune separadamente dos modelos oficiais alinhados com a segurança.
- Para uso empresarial, verifique a licença exata, os termos do modelo base e se os ajustes da comunidade são aceitáveis.
FAQ
Qual é o melhor LLM de código aberto local em geral?
Para a maioria dos utilizadores locais avançados, o Qwen 3.8 27B é o melhor ponto de partida equilibrado. Apresenta uma forte capacidade multilingue, desempenho de programação e opções práticas de implementação local. Se a sua prioridade for o roleplay NSFW, o Dolphin 3.0 adapta-se melhor.
Que modelo devo executar numa RTX 4090 de 24GB?
Utilize o Qwen 27B, o Gemma 31B/26B, o Dolphin 24B ou modelos semelhantes em formato quantizado. Se quiser uma velocidade mais fluida e um contexto mais longo, reduza para 12B ou 8B. Um modelo que funcione confortavelmente é habitualmente mais útil do que um que quase não cabe.
Os LLMs de código aberto são seguros para uso empresarial?
Podem sê-lo, mas apenas após verificações de licença, design de privacidade, decisões de registo (logging) e revisão de resultados. Os pesos abertos não resolvem automaticamente a conformidade. Para documentos confidenciais, a implementação local pode melhorar a privacidade, mas a equipa continua a precisar de governação.
Qual é o melhor LLM local para NSFW?
O Dolphin 3.0 é a escolha mais evidente entre os modelos analisados aqui. O Qwen e o Gemma têm variantes sem censura criadas pela comunidade, mas os seus lançamentos oficiais não são modelos focados em NSFW.
Devo utilizar o Ollama, LM Studio, vLLM ou SGLang?
O Ollama e o LM Studio são os mais fáceis para testes em desktop. Os serviços ao estilo vLLM e SGLang são melhores para servidores de API, processamento em lote, experiências de contexto longo e utilização em equipa.
Veredito
Não existe um único melhor LLM de código aberto local para todos. O Qwen 3.8 é o melhor polivalente prático, o Gemma 4 é a linha de pesos abertos mais limpa apoiada pela Google, o Dolphin 3.0 é a opção mais forte para NSFW sem censura e roleplay, o DeepSeek V4 e o Mistral Large 3 são escolhas sérias para o lado do servidor, enquanto o Llama, o Kimi e o GLM adicionam profundidade em termos de ecossistema, agentes e contexto longo.
O caminho mais inteligente é enfadonho mas fiável: comece com um modelo quantizado que caiba na sua GPU, teste-o com os seus prompts reais, compare o comportamento de recusa, a estabilidade do contexto e a latência, e só depois mude para cima quando o modelo mais pequeno falhar claramente. A IA local torna-se interessante quando é suficientemente rápida para ser utilizada todos os dias.
Referências
Relacionados Avaliações
Seedream 5.0 Pro: Análise ao Modelo de IA de Imagem, Acesso à API e Política de Conteúdos Sensíveis (NSFW)

Análise do FLUX 3: Vídeo, Imagem, Open Weights e Política de NSFW

NoobAI XL Review: VRAM, LoRA, V-Pred, Prompts e Utilização Local NSFW
Análise do Qwen Image Edit: Edição de Texto, Inpainting, ComfyUI e Política de NSFW
Review do Grok 4.6: raciocínio, agentes, preço e política NSFW
Review do Mistral AI: modelos locais, Large 3, Small 4 e política NSFW