RustingStrataレビュー|速度・RAM・導入手順とNSFW対応
RustingStrataの対応GGUF、速度とメモリの検証範囲、Windows・Linuxへの導入、ローカルAPI、NSFWの制約を具体的に解説します。

RustingStrataは、ローカルチャット、モデルのダウンロード、APIサーバーを備えたRust製の推論エンジンです。対応するQwenのGGUFをCPUとGPUで分担して動かし、VRAMに収まらないMoEモデルも扱える点が魅力です。ただし、省メモリという評判だけで、RAMやSSDの負担まで小さいとは判断できません。普段の作業と併用できるかは、モデルとキャッシュの設定次第です。
RustingStrataの機能と対応モデル
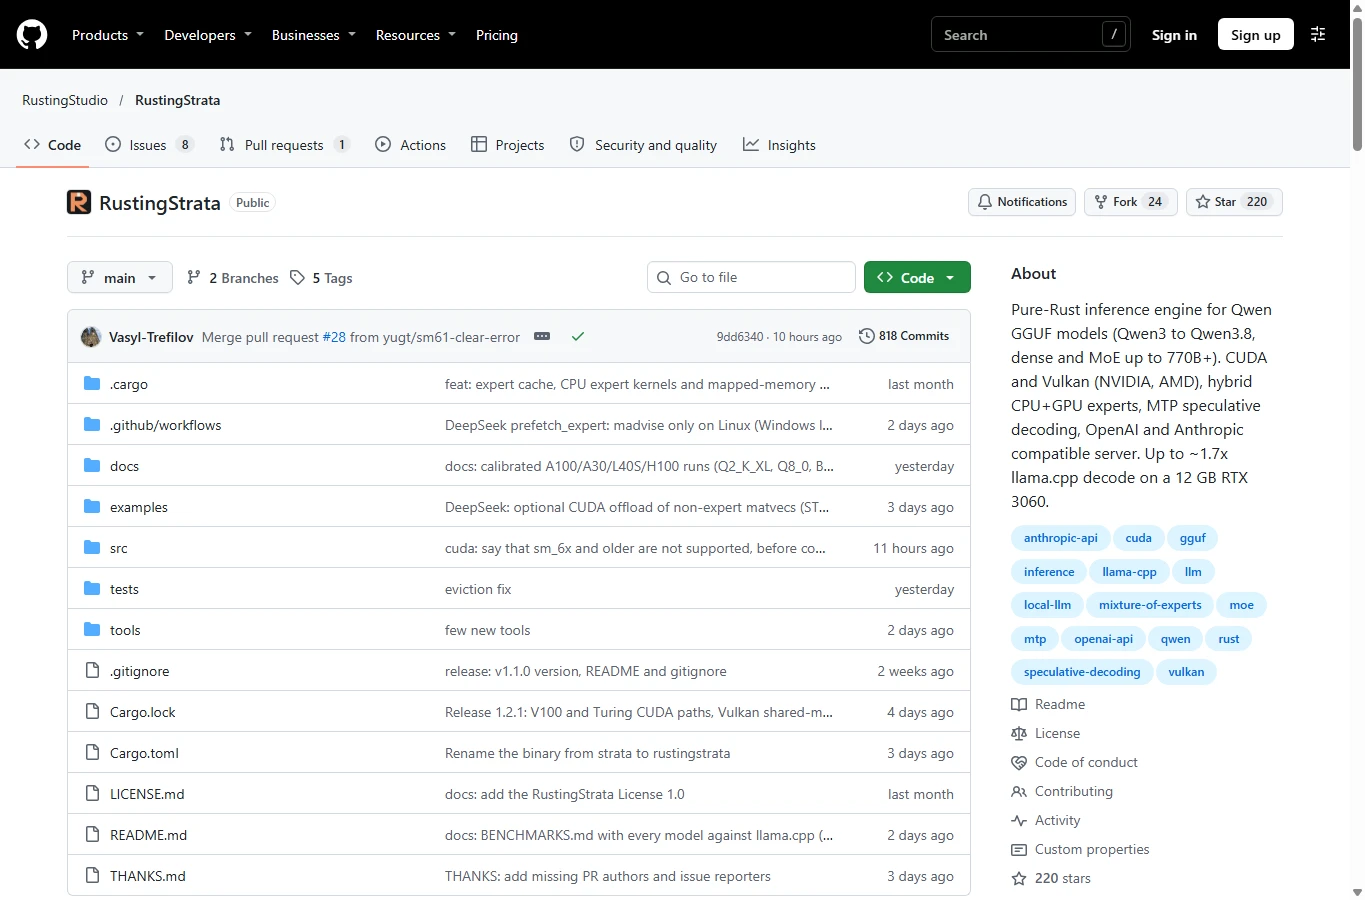
開発元はRustingStudio、作者はVasyl Trefilov氏です。RustingStrata自体に会話の知識や人格が入っているわけではなく、読み込むGGUFモデルが回答の内容、日本語の自然さ、得意分野を決めます。VRAMに置けないエキスパートはCPUで処理し、よく使うものをGPUへ移す仕組みです。CUDAはNVRTCで実行時にカーネルをコンパイルし、Vulkanも選べます。
2026年11月8日公開のv1.2.1では、Qwen3、Qwen3-Next、Qwen3.5/3.6系、Qwen3.8-Flash-Nextが対象です。拡張子がGGUFなら何でも使える、という意味ではありません。調査時点のmainブランチにはDeepSeek-V4.1-FlashとGLM-5.3-Flashも記載されていますが、後から追加された機能をv1.2.1の配布ファイルで使えるとは限りません。
ブラウザー画面ではモデルの取得・切り替え、会話、コンテキストや速度・リソースの確認ができます。OpenAI互換Chat CompletionsとAnthropic互換Messagesにも対応します。ただし、クラウドAPIの全機能を再現するものではなく、画像・動画生成モデルに変わるわけでもありません。
速度・RAM・ユーザー評価をどう読むか
速度の主な根拠は開発者測定です。RTX 3060 12GB、Ryzen 5 7600X、RAM 32GBで、11.7GiBのQwen3.6-35B-A3B UD-Q2_K_XLを使った場合、4K入力後の生成は113.4 tokens/s、比較用に調整したllama.cpp build 11876は66.5 tokens/sでした。一方、4K入力処理は2,216対約2,236 tokens/sでほぼ同等です。約1.7倍という数字は、この条件の生成部分に限って読む必要があります。
MTPでは簡単な短い入力で最大160 tokens/sとされていますが、文章によって効果が変わります。20入力×32トークンで98~99%のgreedy出力一致という結果も、推論・コーディング能力全般の品質保証ではありません。量子化による品質差とも分けて考えてください。
コミュニティでは、RAMを多く積んだ別構成のユーザーが元のStrataでも良好な結果を示し、開発者も自分の比較環境ではディスクからモデルを読み出していた点を認めています。独立した幅広い省RAM・同時作業テストは確認できませんでした。メモリマップされた重みはOSのページキャッシュも使うため、プロセスの表示値だけでなく、システム全体、スワップ、初回と再実行の待ち時間を見てください。
必要なPC環境とモデル選び
最初は巨大なFlash-Nextではなく、小型の対応Qwenで動作確認するのが現実的です。後述するQwen3-4B-Instruct-2507 Q4_K_Mはファイルが約2.5GBです。これは必要メモリの合計ではなく、コンテキスト、作業領域、OS、他のアプリの余裕が別に必要です。12GB GPUは開発者の測定構成であり、全モデル共通の最低条件ではありません。
配布バイナリはx86-64-v3/AVX2向けで、Linux版はglibc 2.35以降が必要です。CUDAには対応するNVIDIAドライバーとNVRTCライブラリが必要です。ドライバーだけでNVRTCがそろわない場合は、対応するCUDA Toolkitまたはランタイムを導入します。V100はCUDA 13でVolta対応が外れたため12.xが必要です。Vulkanは1.3に加えshaderFloat64や整数・サブグループ機能の条件があります。Intel Arcは公式記載の経路に必要なshaderFloat64を満たしません。
SSDにはモデル本体、取得途中のファイル、キャッシュの空きを確保します。分割GGUFは全ファイルを同じ場所に置き、最初の分割ファイルを指定します。大容量MoEは12GB VRAMで起動できても、RAM不足でストレージ待ちになります。ローカルなので従量API料金は避けられますが、電気代と保存容量、調整の時間はかかります。
Windows・Linuxへの導入:まず配布版から
現在の簡単な方法はv1.2.1の配布版です。上の公式リンクからReleases → v1.2.1 → Assetsへ進み、Windowsはstrata-windows-x86_64.exe、Linuxはstrata-linux-x86_64を取得します。配布元を確認し、必要ならSHA-256をGitHubのasset digestと照合してください。以下では名前をrustingstrataに変更して扱いますが、機能は変わりません。
WindowsではC:\AI\RustingStrataなど専用フォルダーに保存し、その場所でPowerShellを開いて下のコマンドを実行します。Linuxは同じく取得先で名前変更と実行権限の付与を行います。http://127.0.0.1:8080が開かなければブラウザーに手入力します。使用中はターミナルを閉じず、終了はCtrl+Cです。配布版を使うだけならRustやVisual Studio Build Toolsは不要です。
Windows:配布ファイルから起動
Rename-Item .\strata-windows-x86_64.exe rustingstrata.exe
.\rustingstrata.exe
Linux:配布ファイルから起動
mv strata-linux-x86_64 rustingstrata
chmod +x rustingstrata
./rustingstrata
ソースから作る場合はGit、MSVC版の安定版Rust、Visual Studio Build Toolsの「C++によるデスクトップ開発」、MSVC、Windows SDKを入れ、新しくDeveloper PowerShellを開きます。下の手順はv1.2.1に固定しているため、生成物はtarget\release\strata.exeです。新しいmainでは実行ファイル名がrustingstrataになります。LinuxではCコンパイラーとリンカーなどの開発環境が必要です。ビルドが完了してもGPU用ランタイムは別途必要です。
任意:Windowsでv1.2.1をビルド
git clone --branch v1.2.1 --depth 1 https://github.com/RustingStudio/RustingStrata.git
cd RustingStrata
cargo build --release
Copy-Item .\target\release\strata.exe .\rustingstrata.exe
.\rustingstrata.exe
小型モデルを入れて最初のチャットを動かす
「Models and settings」でHugging Faceのunsloth/Qwen3-4B-Instruct-2507-GGUFを指定し、Qwen3-4B-Instruct-2507-Q4_K_M.ggufを選んで取得、読み込みます。標準保存先はWindowsが%LOCALAPPDATA%\rusting_strata\models、Linuxが~/.local/share/rusting_strata/modelsです。この公開モデルにHF_TOKENは通常不要ですが、制限付きリポジトリでは必要なことがあります。
画面から取得できない場合は、下のPowerShell例で同じファイルをローカルのmodelsフォルダーへ保存できます。この保存先は画面の標準フォルダーとは別です。先に引数なしで起動したサーバーをCtrl+Cで止め、実行ファイルのある場所からcalibrateとchatを実行してください。Linuxは.\rustingstrata.exeを./rustingstrataに置き換え、モデルの実際のパスを指定します。
最初は短い普通の質問で確認します。文章が返れば読み込みの確認になりますが、最大速度の再現を意味しません。初回CUDA起動時には約15秒のカーネル作成が入り、次回以降はキャッシュが使われます。ログでバックエンドも確認してください。Qwenでは–gpuを付け、外すと遅いCPU参照実装になります。小型で動いてからMoEへ進み、モデルやPCを変えたら再調整します。
Windows:モデル取得・調整・チャット
New-Item -ItemType Directory -Force .\models | Out-Null
curl.exe -L --fail "https://huggingface.co/unsloth/Qwen3-4B-Instruct-2507-GGUF/resolve/main/Qwen3-4B-Instruct-2507-Q4_K_M.gguf" -o .\models\Qwen3-4B-Instruct-2507-Q4_K_M.gguf
$model = (Resolve-Path .\models\Qwen3-4B-Instruct-2507-Q4_K_M.gguf).Path
.\rustingstrata.exe calibrate --model $model
.\rustingstrata.exe chat --model $model --gpu --ctx 4096
Linux / Bash
mkdir -p models
curl -L --fail "https://huggingface.co/unsloth/Qwen3-4B-Instruct-2507-GGUF/resolve/main/Qwen3-4B-Instruct-2507-Q4_K_M.gguf" -o models/Qwen3-4B-Instruct-2507-Q4_K_M.gguf
MODEL="$PWD/models/Qwen3-4B-Instruct-2507-Q4_K_M.gguf"
./rustingstrata calibrate --model "$MODEL"
./rustingstrata chat --model "$MODEL" --gpu --ctx 4096
外部アプリ接続・メモリ調整・速度測定
別のチャット画面やコーディングツールにつなぐ場合は、下のserveを実行し、接続先をhttp://127.0.0.1:8080/v1、APIキーを同じ秘密値にします。GET /v1/modelsで実際のモデルIDを取り、続くPowerShell例で応答を確認できます。choices[0].message.contentに文章が返れば接続確認完了です。Anthropic形式は/v1/messagesとx-api-keyを使いますが、Claudeのモデルを取得する機能ではありません。
複数アプリを開くことと同時生成は別です。標準では1件ずつ処理し、–parallel NでGPU同時処理を有効にします。計算資源を分けるので、1人当たりが同じ速度になる保証はありません。会話の共通部分を再利用し、別の履歴の状態をRAMへ退避する仕組みもあり、–cache-ramの標準値は4096MBです。軽量という印象でも、会話キャッシュはRAMを使います。
最初は–ctx 4096にし、画像生成などと併用するなら–vram-margin 1024または2048を出発点にします。単位はMBであり、ピーク時まで確実に予約する保証ではありません。必要ならコンテキストを減らすか–kv q8を検討します。MTPには対応するdraft headが必要です。複数GPUへの分割も、1件の処理が単純に2倍速になる仕組みではありません。
比較時はGGUF、量子化、入力、生成長、コンテキストをそろえます。下のbenchを初回とキャッシュ後で分けて測り、普段の長文やコードでも確認してください。入力処理と生成速度を別々に記録し、RAM・VRAMと他アプリの稼働状況も残すと判断しやすくなります。
Windows:APIキー付きローカルサーバー
$model = (Resolve-Path .\models\Qwen3-4B-Instruct-2507-Q4_K_M.gguf).Path
$env:STRATA_API_KEY = "replace-with-your-own-local-secret"
.\rustingstrata.exe serve --model $model --gpu --ctx 4096 --addr 127.0.0.1:8080
別のPowerShellでAPI接続を確認
$headers = @{ Authorization = "Bearer replace-with-your-own-local-secret" }
$models = Invoke-RestMethod -Uri "http://127.0.0.1:8080/v1/models" -Headers $headers
$body = @{
 model = $models.data[0].id
 messages = @(@{ role = "user"; content = "RAMとVRAMの違いを日本語で3文で説明してください。" })
 max_tokens = 128
 temperature = 0.7
} | ConvertTo-Json -Depth 6
$reply = Invoke-RestMethod -Uri "http://127.0.0.1:8080/v1/chat/completions" -Method Post -Headers $headers -ContentType "application/json; charset=utf-8" -Body ([Text.Encoding]::UTF8.GetBytes($body))
$reply.choices[0].message.content
初回とキャッシュ後の速度を測る
$model = (Resolve-Path .\models\Qwen3-4B-Instruct-2507-Q4_K_M.gguf).Path
.\rustingstrata.exe bench --model $model --gpu --pp 512,4096 --tg 128 --reps 3 --ctx 4224
Linux / Bash
MODEL="$PWD/models/Qwen3-4B-Instruct-2507-Q4_K_M.gguf"
export STRATA_API_KEY="replace-with-your-own-local-secret"
./rustingstrata serve --model "$MODEL" --gpu --ctx 4096 --addr 127.0.0.1:8080
導入時によくある問題と対処
link.exeやCコンパイラーがない:ソースビルドの問題です。C++ワークロードとWindows SDKを追加し、Developer PowerShellを開き直します。配布版の実行だけなら、この作業を追加する必要はありません。
NVRTCやCUDAの読み込みエラー:ドライバー、ランタイムの版、ライブラリ検索パスを確認してターミナルを再起動します。対応GPUなら–gpu –backend vulkanも試せます。illegal instructionは配布版のAVX2条件に合わないCPUの可能性があり、ソースビルドでの対応確認は別に必要です。
メモリ不足やデスクトップの停止感:モデルを止め、–ctxを減らす、小型・低ビットモデルにする、VRAMの余裕を増やす、他のGPU処理を閉じる順で確認します。ディスク使用が続いて最初の応答だけ遅い場合は、RAMとページキャッシュ不足を疑います。
未対応アーキテクチャやtensorエラー:モデル系統、分割ファイルの不足を確認します。mainへの更新で機能が増えても、検証対象の版が変わります。8080番の競合は既存サーバーを止めるか–addr 127.0.0.1:8081で回避し、画面とクライアントの接続先も変えます。会話の繰り返しはテンプレートやサンプリング設定の問題も考えられます。
NSFW対応・プライバシー・商用利用
NSFWへの応答は主に読み込むモデル次第です。RustingStrataはローカルのテキスト推論・API層で、公開資料から全モデル共通の「無検閲モード」は確認できません。対応するロールプレイ用派生モデルが成人向けの架空会話に応じる場合でも、通常のQwenは拒否することがあります。システムプロンプト、会話テンプレート、モデル利用条件も影響します。本稿ではNSFWの出力試験を行っていないため、成功率や無制限対応は断定しません。画像・動画のNSFW生成ツールでもありません。
ローカル動作は送信先を管理しやすい一方、自動的な完全秘匿ではありません。会話はブラウザーに保存され、拡張機能、接続アプリ、ログ、バックアップにも残る可能性があります。モデル取得時にはHugging Faceへ通信します。個人利用では127.0.0.1に限定し、連携時はAPIキーを設定します。認証なしのポートをインターネットへ公開せず、不要な履歴はブラウザーと接続先の両方から削除してください。
独自のRustingStrata License 1.0は個人・商用利用や、エンジンを使う有料チャット/APIサービスなどを認めますが、エンジン自体の有料再販等は制限します。配布時の表示・帰属条件があり、MITやApacheと同じではありません。モデルのライセンスは別なので、GGUFが読めることと商用再配布できることを混同しないでください。
どんな人に向いているか
対応Qwen、ブラウザーチャット、ローカルAPIをまとめて使いたいWindows・Linuxユーザーには試す価値があります。特にVRAMに収まらないエキスパートの分担に関心がある人向けです。配布版ならコンパイルの手間を避けられます。まず小型モデルとAPI接続を完成させ、実際の仕事で測ってから常用環境を移すのが無理のない進め方です。
一方、幅広いモデル互換性、特定の既存機能、十分な第三者検証を優先する人は、今のエンジンを残して比較してください。「軽い」は自分の環境で検証する価値のある特徴ですが、巨大モデルのRAM・SSD負担まで消えるという期待には根拠がありません。
確認日:2026年11月12日。公式v1.2.1リリースと同版README、現行の利用・サーバー・GPU・ベンチマーク資料、モデルファイル一覧、公開の議論を照合した文献ベースのレビューです。AirMoreによる実機性能試験・NSFW試験ではありません。main追加機能は配布版と区別しています。表紙にはAI生成イラストを使用しています。
関連 レビュー
Ideogram 4.0レビュー|審査制限突破・NSFW、文字生成AIとComfyUI活用を解説

SillyTavernの使い方【2026年版】AI酒場の始め方・キャラクターカードと世界書の作り方
2026 年最新版:おすすめのオンライン講座プラットフォーム 8 選

2026年版|厳選!使えるAI画像透かし除去ツール5選

写真をイラスト・線画に変換できるおすすめツール6選【2026】
PDFを高画質化するおすすめツール5選【2026年】