MOSS-Imageレビュー|日本語・アニメ・NSFW・必要VRAMとComfyUI設定
MOSS-ImageのBaseとSFT、文字描画、アニメ表現、JSON構図制御を解説。必要VRAM、ComfyUI設定、量子化、LoRA、NSFW、商用利用まで、公開仕様と利用者の報告から評価します。

MOSS-Imageは、文字入りのポスターや情報カード、人物の位置関係を指定したイラストをローカルで作りたい人に注目のモデルです。長い指示文、文字描画、JSONによるレイアウト制御を組み合わせられる点が強みで、キャラクターや画風の再現性まで専門モデルを全面的に上回るわけではありません。
2026年10月16日にBaseとSFTの重みが公開されました。文字と構図を重視するならSFTを入口に、画風の探索や追加学習ならBaseも比較するとよいでしょう。大きなテキストエンコーダーと標準50ステップの負荷には注意が必要です。公開済みの本体はテキストから画像を作るモデルで、参照画像を直接入力する編集機能は備えていません。
評価の結論と基本仕様
| 開発・公開日 | OpenMOSS · 2026年10月16日 |
|---|---|
| 構成 | 5B単流DiT+Qwen3.5-9Bエンコーダー+FLUX.2小型デコーダーVAE |
| 入力 | 自然文・タグ列・JSON · 最大4,096トークン |
| 出力の出発点 | 1024×1024から開始。推奨1〜2MP、縦横は16の倍数 |
| 基本設定 | Euler · 50 steps · CFG 3 · shift 5 · uncond skip 22 |
| 重み・利用方法 | Apache-2.0 · ローカル実行・公式オンラインデモ |
試す価値がある点
- 文字と物体の位置を、文章だけでなくBBoxで指定できる。
- 写真・イラスト・アニメを扱え、自然文とタグを使い分けられる。
- Base/SFTをダウンロードでき、量子化やLoRAの選択肢が増えている。
ほかのモデルも残したい理由
- 5Bという数字に大きなテキストエンコーダーは含まれない。
- 短い指示や絵師タグ、既存キャラ、手指などの安定性には課題が残る。
- 参照画像編集は未対応。高速化アダプターは別の条件で評価する必要がある。
BaseとSFTはどちらを選ぶべきか
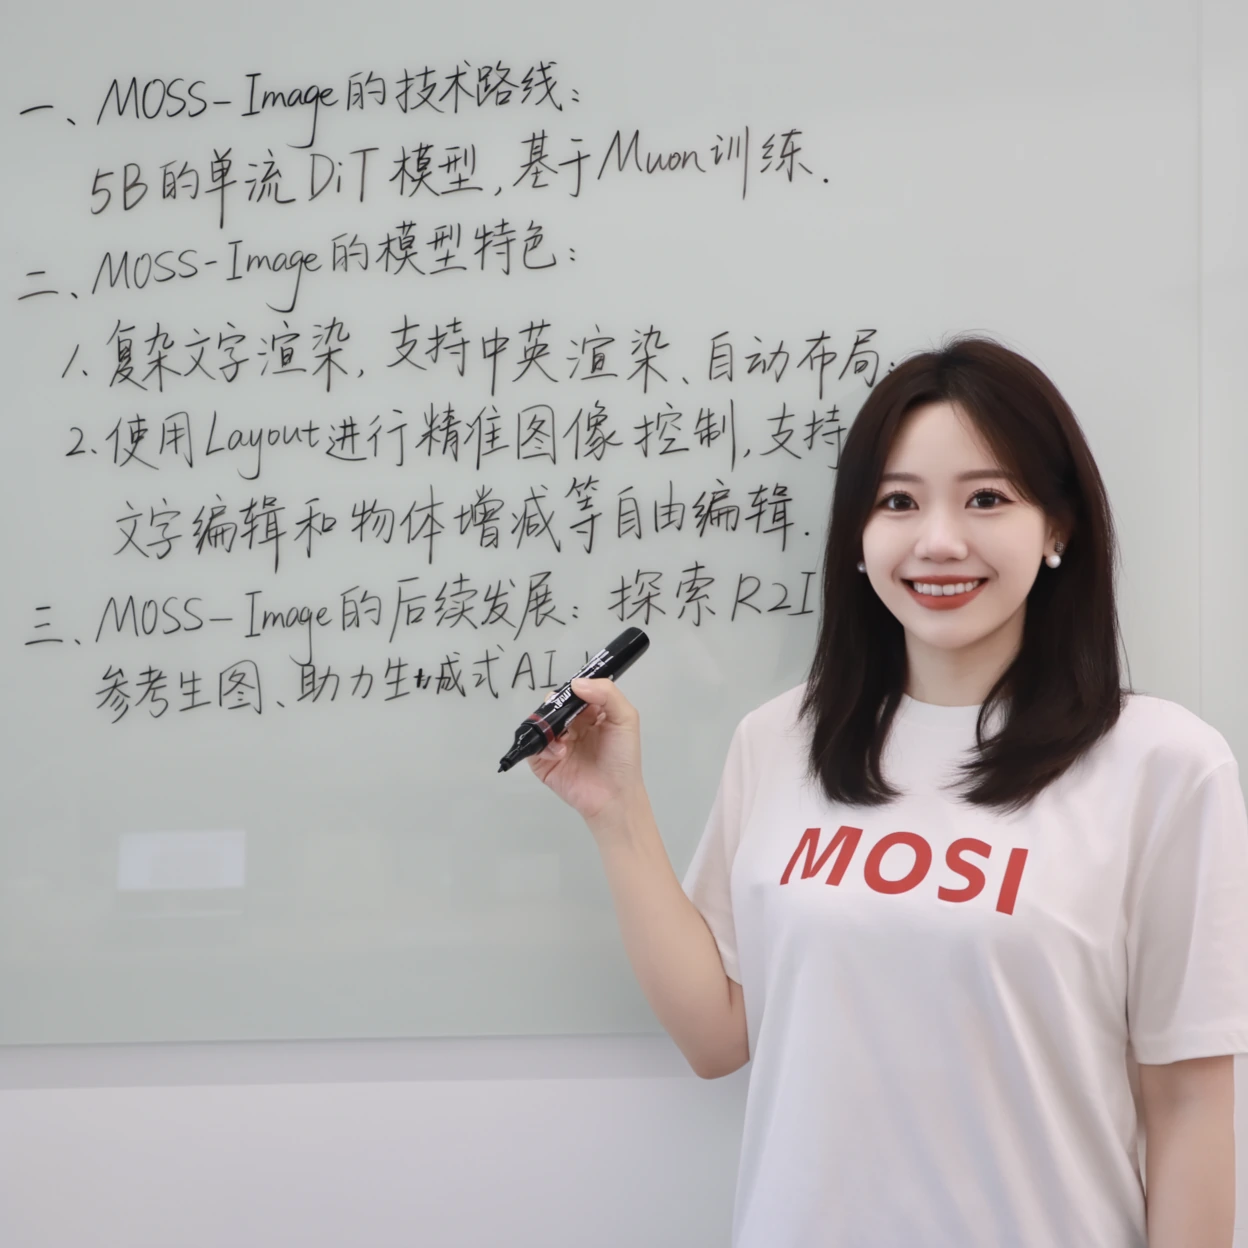
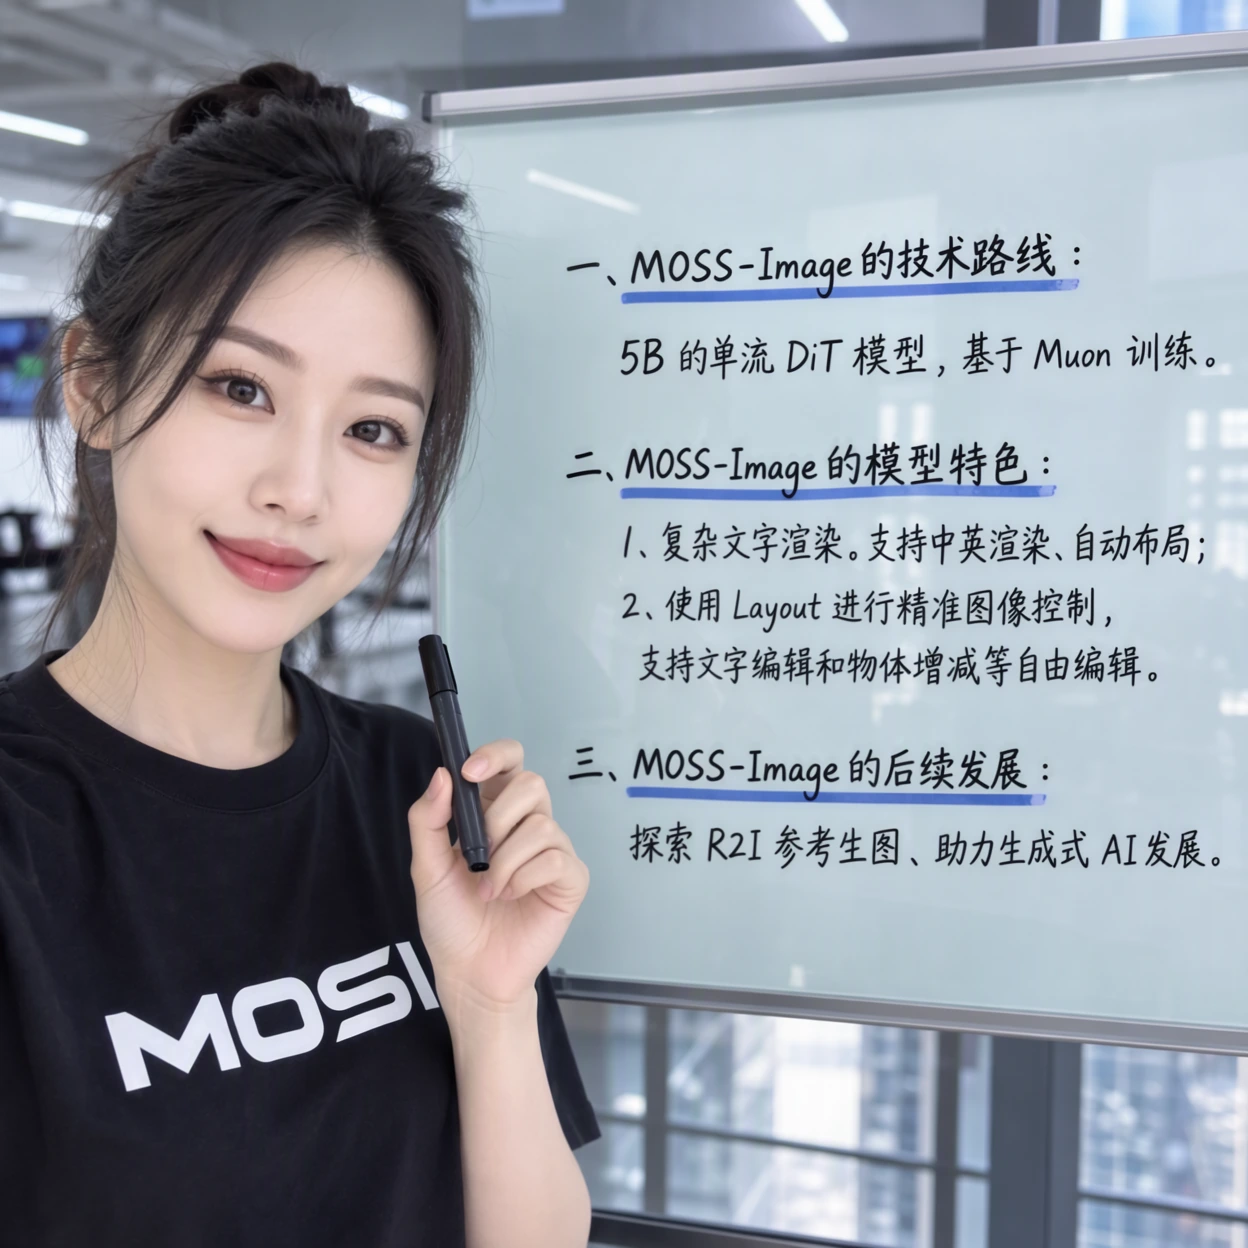
SFTは、Baseを選別データで追加学習したモデルです。公式のホワイトボード作例では、文字のまとまりや配置が見やすくなっています。看板や説明図から試すならSFTが扱いやすい入口ですが、すべての画風で優れているという意味ではありません。SFTモデルカード
Baseは追加学習の土台として情報を残したモデルで、公式ガイドもLoRA学習に勧めています。開発者AMAではBaseの写実的な雰囲気を好むという個人的な意見もあります。「自由度が高い」は出力傾向の違いとして捉え、無条件の品質保証や利用条件の説明に置き換えないようにしましょう。Baseモデルカード
以下は開発元が公開した比較用作例です。構図や人物の見た目も異なるため、同一人物の維持性能を測る比較ではありません。
画質・アニメ・日本語の文字描画
技術報告では、英語・中国語の長文描画を測るLongLongTextBenchでMean-6の文字カバレッジ96.3を報告しています。開発元による240課題の評価であり、誤字のなさ、デザイン品質、日本語の正確さを96.3%保証する数字ではありません。RealLayoutArenaのシステム比較で2位、同じ拡張プロンプトを使う別条件のバックボーン比較で1位という結果も、条件を分けて読む必要があります。技術報告と評価条件
日本語の看板やせりふを描けたという利用者の報告は有望です。ただし、縦書き、長い会話、複雑な漢字、吹き出しまで安定して描ける証明ではありません。公式ガイドは学習量の多い英語を推奨しています。入れたい日本語は引用符で正確に指定し、改行を明示して、最後は一文字ずつ確認してください。設定を公開した利用者テスト
Danbooru風タグを使えることと、すべてのキャラクターや絵師を知っていることは別です。AMAでは絵師名の効きが弱いという声があり、日本語の実践記事でも画風の言い換えによって安定性が変わっています。背景や人物配置の好例があっても、Animaを全面的に置き換える根拠にはなりません。手指、小さな顔、否定条件、複数人物の属性混ざりは確認したい部分です。AMAと利用者の意見 日本語の実践記事
「GPT風」「油っぽい」という印象は画風の好みであり、AI生成画像の混入を立証する情報ではありません。技術報告は重複除去と独自検出器によって約50億枚から約30億枚へ整理したと説明しています。これは開発側のデータ構築説明で、独立監査や全素材の権利処理を示すものではありません。学習データの説明
JSONとBBoxで構図を指定する
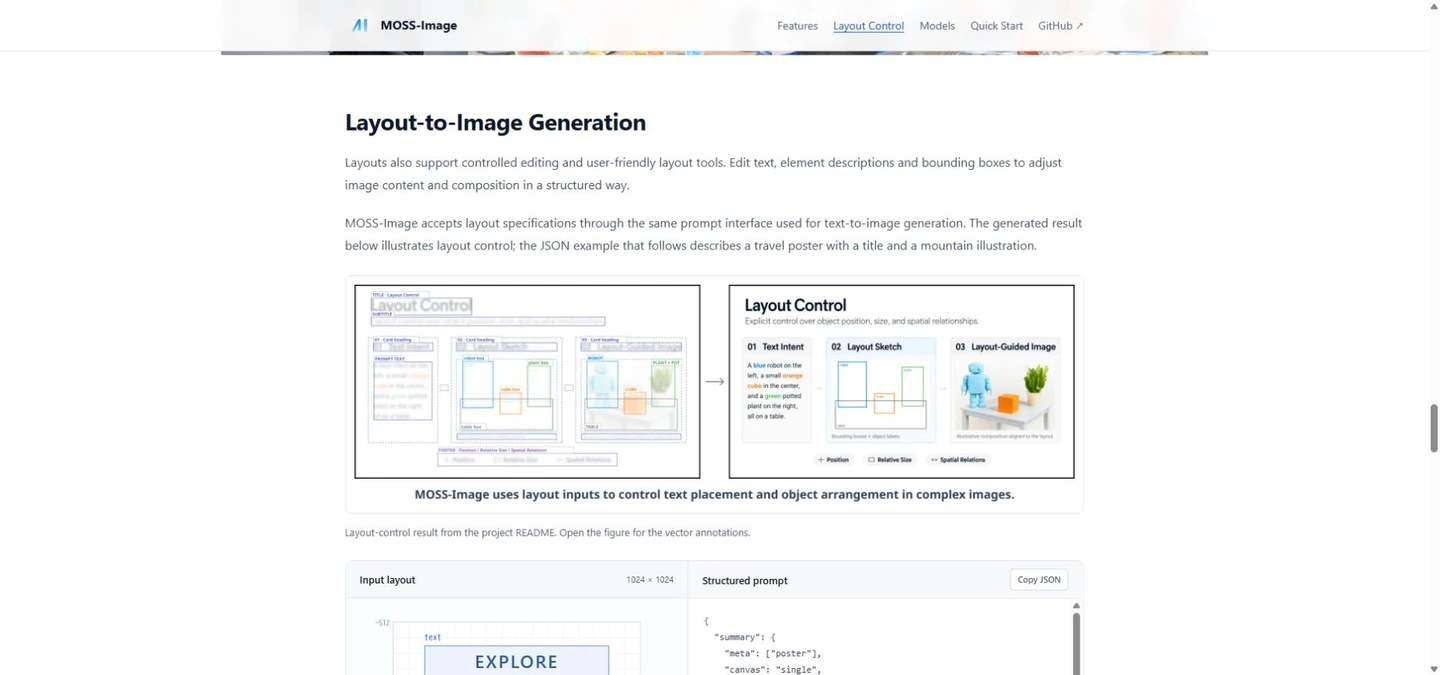
MOSS-Imageを導入する大きな理由は、全体の説明に加えて、文字や物体ごとに説明と枠を与えられることです。商品より上に見出しを置く、2人を左右に分ける、複数パネルを組む、といった場面で試す価値があります。JSONは必須ではなく、通常の自然文でも生成できます。公式入力ガイド
座標は間違えやすい点です。abs_centralized+yxyxでは、[y_min, x_min, y_max, x_max]を画像中心からのピクセル数で指定します。1024×1024なら各軸は−512〜+512です。左上を原点とする値や、拡張ノードの0〜1000座標とは、そのまま交換できません。
次の入力例は上部に日本語タイトル、その下に山を配置します。出力を1024×1024に合わせ、JSON全体をポジティブプロンプトへ貼り付けてください。枠は生成の誘導で、ベクターレイヤーでも厳密なピクセル指定でもありません。JSONを書き換えて再生成する操作は、写真を入力して一部だけ編集する機能とは異なります。
{
  "summary": {
    "meta": [
      "poster"
    ],
    "canvas": "single",
    "caption": "A minimalist travel poster with a cream background, a blue mountain illustration below, and the exact title 夏の市 at the top."
  },
  "items": [
    {
      "label": "text",
      "caption": "Large dark-blue title centered at the top.",
      "text": "夏の市",
      "bbox": [
        -416,
        -384,
        -288,
        384
      ]
    },
    {
      "label": "object",
      "caption": "A flat blue mountain illustration in the lower center.",
      "bbox": [
        -192,
        -288,
        384,
        288
      ]
    }
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
必要VRAM・ファイル容量・生成速度
重みの保存容量とピークVRAMは別です。10月20日時点のComfy-Orgのファイルでは、BF16のDiTが約10.16GB、エンコーダーが19.31GB、小型VAEが0.25GBで、合計約29.72GBです。環境やキャッシュは別途必要ですが、オフロードすれば全体を同時にGPUへ載せずに動かせます。コンポーネント一覧
8〜12GBのGPUでは、対応する量子化とCPUオフロードを組み合わせ、約1MP・1枚から始めるのが現実的です。16GBなら必ず快適、32GBならBF16常駐が確実、とはいえません。作業領域、プロンプト長、VAEの処理、システムRAMでも必要量が変わります。
RTX 3060 12GBの利用者は、初期の第三者INT8環境で約9.7GBのピークVRAM、1MP・50ステップで137秒、初期8-step DMDで約24秒と報告しています。その量子化作者は後にComfy-Org版への移行を勧めています。古い特定構成の報告として参考にし、現在の標準速度やほかのGPUの目安に換算しないでください。実測条件と追記
| 構成要素 | BF16の保存容量 | INT8などの保存容量 |
|---|---|---|
| DiT本体 | 10.16GB | INT8 ConvRot:5.41GB |
| Qwen3.5-9B | 19.31GB | INT8:9.75GB/W4A8 GPTQ:7.34GB |
| FLUX.2小型VAE | 0.25GB | 別コンポーネント |
10進GBによる概算で、必要VRAMではありません。ここでのW4A8はエンコーダーを指し、モデル全体が4bitになるわけではありません。
ComfyUIで始める手順と設定
まず経路を一つにそろえます。ComfyUI本体、フロントエンド、テンプレートを更新し、テンプレートでMOSS-Imageを検索して、BaseまたはSFTに合うComfy-Orgのファイルを使います。ネイティブ対応は10月16日に本体へマージ済みです。公式ページの「統合を進めている」という古い説明より、マージ記録を優先して状況を判断できます。ComfyUIへの対応PR
OpenMOSS公式プラグインのHF Loaderを使う場合は、transformer/、text_encoder/、tokenizer/、vae/を含むローカルのDiffusersフォルダーを指定します。Hubの名前やDiT単体ファイルとは別です。プラグインのグラフと本体のローダーを混ぜないでください。公式プラグインの手順
初回は1024×1024、50 steps、CFG 3、shift 5、Euler/sgm_uniform、対応欄があればuncond skip 22を出発点にします。通常のSLGを同時に重ねず、まず配布ワークフロー通りに確認しましょう。ノイズや斑点が出る場合は、対応する小型VAEも確認します。モデル形式を認識できない場合は、追加の高速化より先にテンプレートとファイルの組み合わせを戻します。
ComfyUI本体の単体ファイル方式での配置例。必要な精度の本体とエンコーダーを一つずつ選びます。
ComfyUI/models/
  diffusion_models/
    moss_image_sft_bf16.safetensors
    # OR moss_image_sft_int8_convrot.safetensors
  text_encoders/
    qwen3.5_9b_bf16.safetensors
    # OR qwen3.5_9b_int8_convrot.safetensors
  vae/
    flux2-vae_small.safetensors
日本語・タグ・自然文の書き方
被写体、動作、視点、位置関係、光、画風、描く文字を、矛盾のない指示にまとめます。詳細に書くことは4,096トークンを埋めることではありません。品質語を増やす前に、誰が何を持ち、どこにいるかを明確にしてください。
タグの推奨順はQuality→Score→Meta→Year→Character→Series→Artist→Generalです。品質語で傾向が変わることはあっても、「8K」を入れて出力解像度が上がるわけではありません。キャラ名だけに頼らず髪、服、持ち物も書くと比較しやすくなります。公式プロンプトの説明
まず日本語の自然文で試し、伝わりにくい場合は場面の説明を英語にし、描きたい日本語だけ引用符で残す方法があります。せりふの改行は明示し、同じシードで修正点を確認した後、複数のシードで安定性を見ます。
用途に合わせて変更できる入力例
朝の市場を描いた清潔感のあるイラスト。成人の店員が左右の別々の売り場に立っている。左の女性は赤いエプロンで黄色いレモンを一つ持ち、右の男性は青いエプロンで緑の洋梨を一つ持っている。上部に余白を設け、濃い青の大きな文字で「夏の市」と正確に描く。ほかの文字は入れない。
量子化・GGUF・LoRA・高速化
Comfy-OrgのINT8 ConvRotに加え、コミュニティからGGUFなどの軽量版も出ています。GGUFの本体、GPTQのエンコーダー、BF16は交換可能な同一形式ではありません。配布者が指定するローダーと組み合わせを確認し、細かな文字や質感を元の設定と比べましょう。GGUF版の説明
8-step DMDは開発途中のコミュニティ製アダプターで、公式Turbo版ではありません。現在のカードはLoRAローダーでの手順を案内し、以前の独自サンプラーやFP32の説明を非推奨扱いにしています。古い記事の手順や、通常サンプラーを8ステップに減らすだけの設定で代用しないでください。Spectrumなども別条件で品質と速度を評価します。更新中のDMDカード
追加学習はBaseを使い、テキストエンコーダーを凍結するのが公式の推奨です。画像内の文字を正確にキャプションへ残し、対象に合う学習例を確認しましょう。AnimaやSDXL、FLUXのLoRAは、名前が似ていてもそのまま使えるとは限りません。
NSFW・商用利用・費用の確認点
ローカル版の成人向け・NSFW出力は利用者から報告されています。ただし、すべてのホストが同じ方針とは限らず、外部のプロンプト拡張にも独自の制約があります。「無検閲」という呼び方で、解剖学的な正確さやサービス規約まで保証されるわけではありません。一般向け制作では公式ガイドのNSFWネガティブタグも参考にし、出力を確認します。利用者の議論 ネガティブ指定
重みと単体パイプラインはApache-2.0で公開されています。条件に従った商用モデル利用が可能ですが、外部コンポーネントやLoRAはそれぞれの条件を確認してください。生成物に既存キャラ、商標、人物の肖像が含まれる場合、モデルのライセンスだけで利用許可が得られるわけではありません。モデルのライセンス
ローカル版に一律の1枚料金はありません。GPU時間、保存容量、電力、採用できない候補の手間まで含めて判断します。公式デモの無料枠は恒久的な提供保証ではなく、クラウドの料金もサービスごとです。ダウンロードはOpenMOSSのプロジェクトと、そこからリンクされた配布先を起点にすると迷いにくくなります。
Anima・Krea 2・Qwen・FLUXとの使い分け
発売直後の「最強」という呼び方より、必要な機能で選びましょう。同一プロンプトのコミュニティ比較でもMOSSはH100・50ステップ、Krea TurboはMac・4ステップで、速度比較には使えません。Animaの更新が終了したと断定する根拠もありません。比較に使われた条件
| 比較先 | 残しておきたい用途 | MOSSとの使い分け |
|---|---|---|
| Anima | 2Bのアニメ特化モデルで、キャラ・画風と公式Turboが中心。長文描画の弱さも明記。公式カード | MOSSは文字入り構図、Animaは慣れたアニメ表現や対応資産で比較。Animaの評価 |
| Krea 2 | RAW/Turboで画風と美的探索を重視。公式公開ページ | 好みの画風と、必要な文字・配置の再現を分けて判断します。 |
| Qwen-Image-2.1 | 生成・画像編集・透過を統合。公式リポジトリ | 元画像を維持する編集なら、現状のMOSSとは用途が異なります。Qwenの評価 |
| FLUX 3 Image Klein | 生成・編集・複数参照に対応し、ライセンスは別条件。公式発表 | MOSSはレイアウト重視の別案。成人向けの好みを総合順位にしないことが大切です。FLUX 3の評価 |
アニメ特化版は開発方針として考える
開発者AMAでは、Turboに関する質問へ「現在はアニメ版の公開を優先」と回答し、既存データ中のアニメ比率が小さいことにも触れています。期待できる方針ですが、公開日やダウンロードできる新しい重みを示す回答ではありません。AMAの発言
アニメ特化版、公式Turbo、参照画像編集がすでに使える前提で、機材を買ったり既存環境を捨てたりするのは早計です。まず公開済みのモデルで判断し、新版が出たら別の条件として評価しましょう。
導入前によくある質問
無料で商用利用できますか?
重みはApache-2.0ですが、ローカル実行には機材と運用費がかかります。クラウド料金や追加LoRAの条件は別です。商用案件では配布元、版、ライセンスを残してください。
初心者はBaseとSFTのどちらから?
文字や整理されたレイアウトならSFTから試し、画風や追加学習の目的でBaseを比較するとよいでしょう。同じ指示と複数シードで確認し、1枚の好例だけで判断しないことが大切です。
VRAM 12GBでも使えますか?
量子化とオフロードを使った利用報告があります。ただしBF16全体が入るという意味ではありません。約1MP・1枚から始め、GPUだけでなくシステムRAMも確認してください。
日本語のせりふは正確に出ますか?
成功例はありますが保証はありません。公式長文評価は中英が対象です。実際に使う漢字、改行、吹き出しを試し、厳密な文字が必要なら後から文字組みできる工程を残します。
画像を入力してキャラを同じに保てますか?
公開本体は参照画像を直接条件にできません。同一シードとJSONで再生成を誘導することは、元画像や人物の同一性の維持保証ではありません。その用途は画像編集モデルで検討してください。
8ステップで画質が落ちるのはなぜ?
アダプター、重み、精度、サンプリングの組み合わせを確認します。まず標準50ステップの結果を残し、最新カードの対応手順に従って比較しましょう。高速化では光や細部、文字が変わることがあります。
いまMOSS-Imageを選ぶ価値
文字入りデザインと明示的な構図指定を、公開重みで試したい人には価値があります。SFTはポスターや情報カードの入口、Baseは追加学習や異なる画風の候補です。ただし、アニメ専門モデルを一律に不要にする製品ではありません。
採用前に、句読点付きのタイトル、服の違う2人、固定レイアウト、細部の多い場面を小さなテストセットにしましょう。エンコーダー、VAE、精度、シード、文字処理を含む所要時間を記録すると、実用的な設定を選べます。
評価範囲と確認に役立つ情報
2026年10月20日までの公開ファイル、公式作例、利用手順、条件を示したコミュニティ報告を扱う公開時点のレビューです。AirMore独自のGPUベンチマークではありません。開発元の作例と利用者の計測は区別しています。
仕様と条件を確認できる資料
関連 レビュー
写真をイラスト・線画に変換できるおすすめツール6選【2026】

MiniMax M3.1 Flashレビュー|料金・コーディング・公開ウェイト・必要GPU
Gemini Omni 1.1 Flashレビュー|Google動画生成AI、4K、API、NSFW制限まで解説

Canva Craftレビュー|2K・横長画像・日本語文字・料金と編集の実力
NovelAI Diffusion 4.5レビュー|無料30枚・i2i・インペイント・拡張機能まで解説
GPT-Image-2.5レビュー【2026年】料金・FlareとSunburst・NSFW対応を比較