Qwen-Image-2.1レビュー:透明画像・画像編集・API料金・NSFW対応
Qwen-Image-2.1の透明PNG生成、多画像編集、API料金、ComfyUI導入、必要VRAMを解説。実際のユーザー評価と商用利用・NSFWの注意点も比較。


Qwen-Image-2.1の魅力は、きれいな一枚を描くだけでなく、素材を作って編集する作業をまとめられることです。背景が透明な画像の生成、複数画像を参考にした合成、写真の一部修正に対応。ステッカーや商品画像、キャラクター差分の制作方法を試したい人に向いています。
ただし、公開された重みは研究用ライセンスです。また「7B」は画像生成部分の規模で、モデル全体のメモリ使用量を意味しません。まず公式デモで必要な作業を試し、有料案件に組み込む前に利用条件を確認するのが現実的です。情報・料金の確認日:2026年9月24日。
更新日:2026年10月13日。公式Turboの仕様・導入方法・API料金を追加しました。 Qwen-Image-2.1-Turboを追加:公式8ステップ版の使い方
Qwen-Image-2.1で何が変わった?
2026年9月20日に公開されたQwen-Image-2.1は、文章からの画像生成と画像編集を一つのモデルに統合しています。主な特徴は、ネイティブなRGBA透明画像、最大10枚の参照画像、書き込みやマスクによる部分編集、7Bの画像生成モジュールです。文字表現、ポートレートの照明、質感の改善も公式に挙げられていますが、すべての指示で旧版を上回るとは限りません。

| 機能 | 役立つ場面 | 確認したい点 |
|---|---|---|
| 透明RGBA | 切り抜き素材やステッカーの試作 | 市松模様が描かれているだけでなく、本当に透過しているか |
| 参照画像は最大10枚 | 人物・衣服・商品などを組み合わせる | 入力を増やすほど指示と計算負荷が複雑になる |
| ネイティブ2K | 細部を確認しやすい大きな画像 | 公式の正方形設定は2048×2048。VRAMも多く必要 |
| 生成・編集を統合 | 同じモデルで作成から修正まで行う | 旧版ワークフローやLoRAの互換性は別途確認 |
| 画像生成部分は7B | 生成モジュールを小型化 | Qwen3-VL 8BエンコーダーとVAEも必要 |
透明画像はPNGで保存し、白と黒の背景に重ねて髪・ガラス・半透明部分の縁を確認しましょう。「最大10枚」は入力上限であり、10人の顔や細かな商品文字を常に正確に保持する保証ではありません。
Qwen-Image-2.1-Turboを追加:公式8ステップ版の使い方
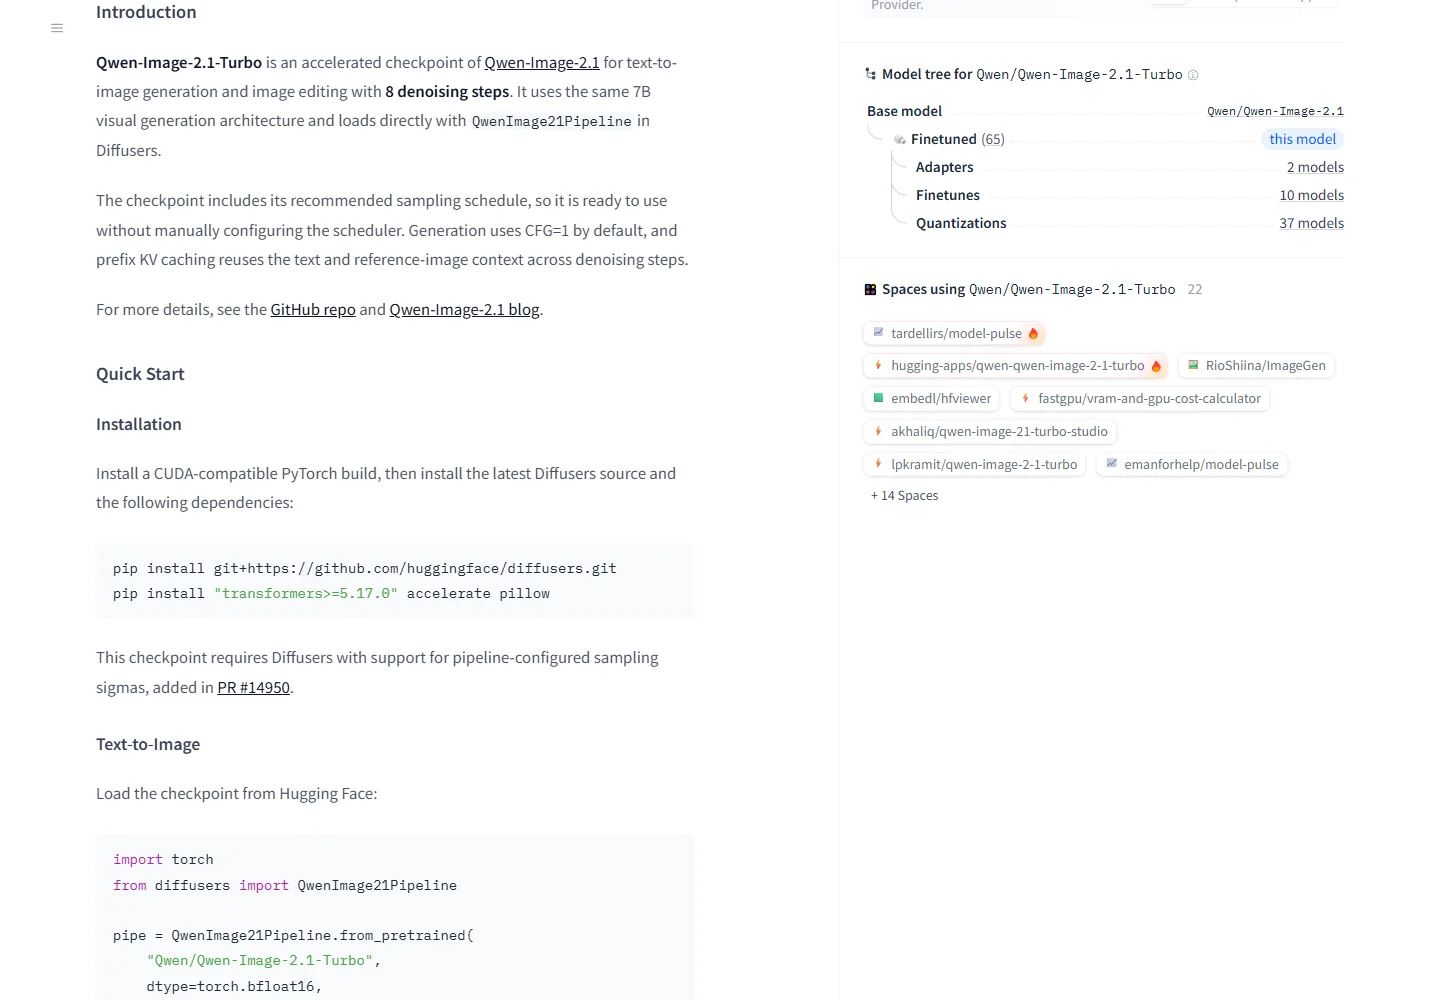
Qwenは2026年10月9日、画像生成と編集に対応するQwen-Image-2.1-Turboを公開しました。画像生成部分は同じ7B構成で、ノイズ除去を8ステップで行います。繰り返し修正しながら仕上げる作業では、待ち時間を減らす選択肢になります。ただし、通常版との画質比較は必要です。
公式Turboと加速LoRAは何が違う?
区別したいのは、公式のTurbo全体モデル、通常版に適用するComfy-Orgの抽出Turbo LoRA、そして先行するViggleなどのコミュニティ加速モデルです。同じ設定を使う別名ではありません。最初は公式Turboだけで比較し、既に高速化された全体モデルへさらに加速LoRAを重ねないでください。
通常版の公式生成例は40ステップ、Turboは保存済みの8ステップ設定で、CFGの初期値は1です。この例ではステップ数が80%減りますが、総処理時間が必ず5分の1になるわけではありません。テキスト処理、参照画像の読み込み、モデル転送、VAE処理も時間を使います。KVキャッシュは各ステップで共通する文章・参照情報を再利用します。
Qwen GitHub · Qwen-Image-2.1-Turbo
Diffusersで公式モデルを動かす
CUDAに対応したPyTorchを準備し、専用環境で最新のDiffusersソース版とtransformers 5.17.0以降を導入します。必要なのはPR #14950で追加された、モデル設定に保存されたsigmasを読み込む機能です。通常版が動く古い環境でもTurboの設定が正しく反映されるとは限りません。以下の短い指示は使用例であり、生成結果の実測ではありません。
python -m pip install git+https://github.com/huggingface/diffusers.git
python -m pip install "transformers>=5.17.0" accelerate pillow
import torch
from PIL import Image
from diffusers import QwenImage21Pipeline
pipe = QwenImage21Pipeline.from_pretrained(
"Qwen/Qwen-Image-2.1-Turbo",
dtype=torch.bfloat16,
).to("cuda")
image = pipe(
prompt="A studio photo of a blue ceramic cup on a wooden table, soft window light.",
width=2048,
height=2048,
use_kv_cache=True,
generator=torch.Generator("cpu").manual_seed(42),
).images[0]
image.save("turbo-generation.png")
source = Image.open("input.png").convert("RGBA")
edited = pipe(
prompt="Change the cup to white. Preserve its shape, camera angle, table and lighting.",
image=source,
width=2048,
height=2048,
use_kv_cache=True,
generator=torch.Generator("cpu").manual_seed(42),
).images[0]
edited.save("turbo-edit.png")推奨スケジュールはモデルから自動的に読み込まれます。num_inference_stepsだけを変えても置き換わりません。sigmasを明示すれば変更できますが、別のスケジュールは公式評価の対象外です。編集では同じパイプラインにRGBAで読み込んだ自分の画像を渡し、変更箇所と維持する箇所を指定します。まず1枚の参照画像と固定シードで試しましょう。
model_index.json — sample_sigmas
ComfyUIでの設定手順
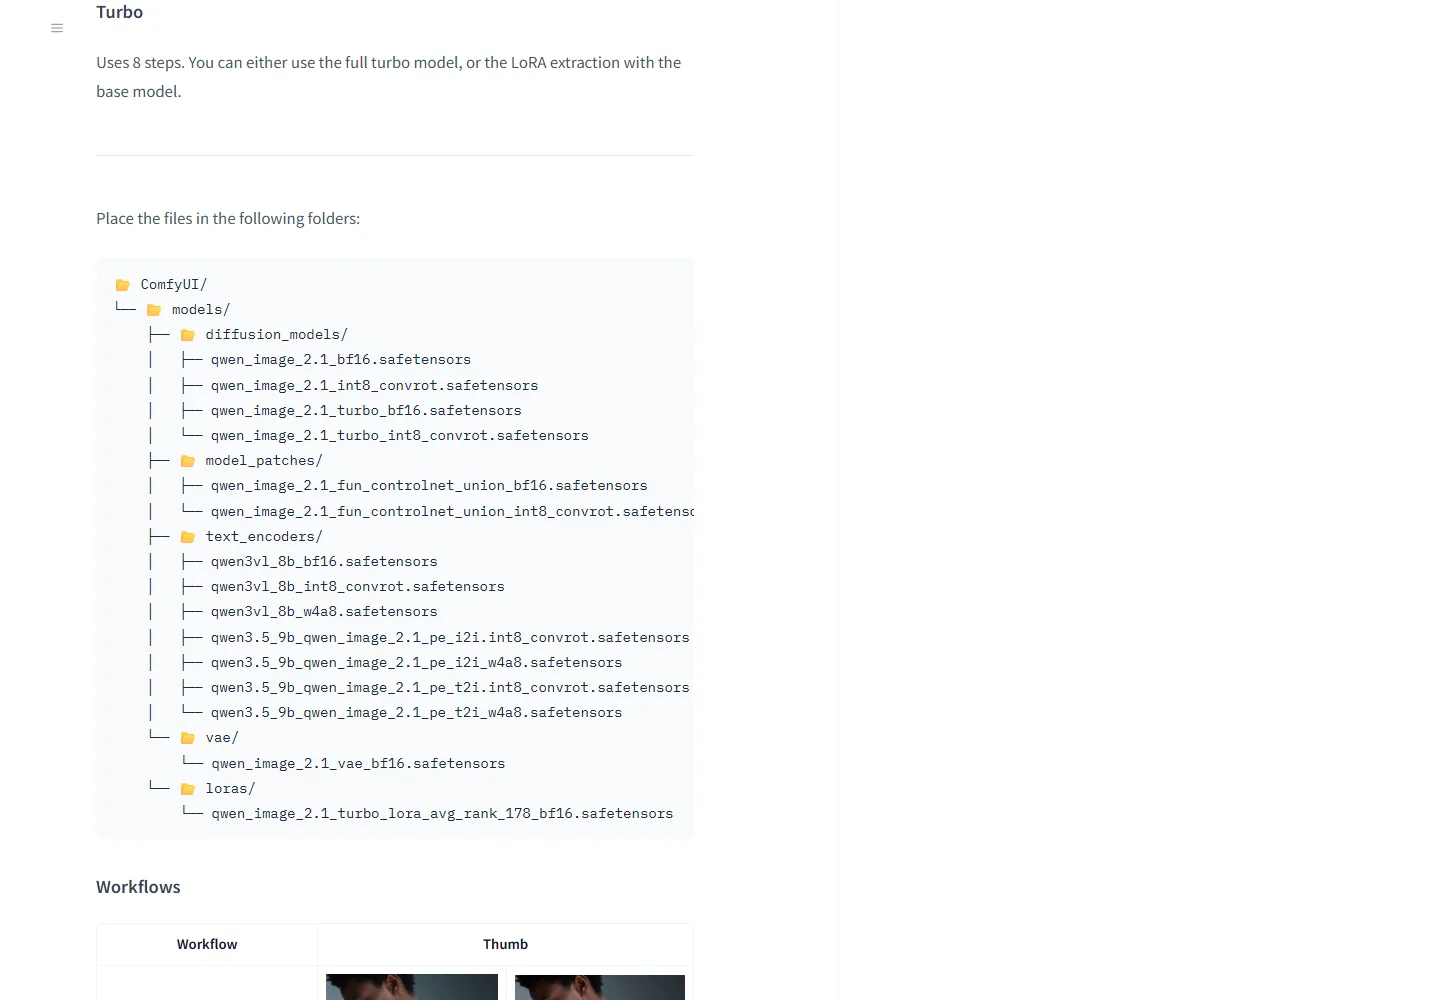
- ComfyUIを更新し、Comfy-Org配布のTurbo BF16またはINT8 ConvRotをmodels/diffusion_modelsに入れます。
- 対応するQwen3-VL 8Bをmodels/text_encoders、qwen_image_2.1_vae_bf16.safetensorsをmodels/vaeへ配置します。旧QwenのVAEや2511用ワークフローと混同しないでください。
- 現行のQwen-Image-2.1ワークフローを開き、Turboのファイルを選択。8ステップ、CFG 1、Turbo用sigmasを使います。一般的なスケジューラーを8ステップにするだけでは同じ経路になりません。
- 抽出LoRAを使う場合は通常版2.1とmodels/loras内の抽出ファイルを組み合わせます。全体Turbo版とは別のワークフローとして管理します。
- 最初は作風LoRAを外して基準画像を生成します。その後、参照画像や追加LoRAを一つずつ導入し、文字・透明輪郭・人物の一致を確認します。手動sigmasが必要ならリンク先のモデル設定を参照してください。
速度と画質:初期ユーザーの評価
初期のコミュニティ評価では編集の速さが支持される一方、文章からの生成の細部は評価が分かれています。2Kと手動sigmasの投稿ではブロック状のノイズ軽減と肌の平滑化が同時に報告され、衣服の模様への不満もあります。通常版+抽出LoRAと全体Turboを同じ8ステップで比べた投稿もありますが、統一条件のベンチマークではありません。
自分で比べる際は入力画像・指示・解像度・シード・プロンプト補強の有無を固定し、複数シードで確認します。小さな文字、肌、反復模様、ロゴ、変更しないはずの領域を原寸で見てください。透明PNGは白黒両方の背景に重ねます。各モデルの最良の1枚だけでは安定性を判断できません。
Reddit: 2K / sigmas · Reddit: Turbo / LoRA
8ステップでも必要メモリは別問題
7Bは視覚生成部分だけの規模です。Comfy-OrgのTurbo本体ファイルはBF16が約14.2GB、INT8 ConvRotが約7.26GBですが、さらにテキストエンコーダー、VAE、中間データ、参照画像が必要です。これはファイル容量で、必要VRAMではありません。8ステップ化しても重み全体が小さくなるわけではなく、オフロードを使うと速度の利点が小さくなる場合があります。
公式オンライン入口・API料金・ライセンス
公式発表からAlibaba Cloud Model StudioのTurbo APIとオンライン試用へ進めます。モデルIDはqwen-image-2.1-turbo。利用地域とAPIキー・接続先を合わせてください。通常版のHFデモを開いただけではTurboとは限りません。公式料金はシンガポールが1枚0.016米ドル、東京・フランクフルトなどの記載されたグローバル配置が0.014133米ドル。100枚なら1.60米ドルまたは1.4133米ドルです。公表上限は毎分120リクエストで、生成速度を保証する数字ではありません。
Alibaba Cloud Model Studio — Turbo · qwen-image-2.1-turbo — API
US$0.016 ≈ JPY 2.54 (2026-10-13). シンガポールの表示価格を参考換算した目安です。円建て請求の保証ではなく、税・決済手数料で変わります。
公開重みはQwen Research Licenseのままです。研究・評価が基本の許諾範囲で、モデル素材の商用利用には別途ライセンスが必要です。APIサービスの契約とローカル重みの条件を分けて確認してください。Turbo化によって無制限のNSFW利用が保証されるわけでもなく、ホスト側の審査や元モデルの制約は別に存在します。
通常版から切り替えるべき?
素早い編集案、参照画像を使う試作、プロンプト調整にはTurboから試す価値があります。質感、特定のLoRA、編集対象外の厳密な維持が重要なら通常版も残し、実際の出力で決めましょう。業務への導入ではAPI料金と利用条件を、ローカル運用費と別に評価します。
実際のユーザー評価:編集は好評、質感には賛否
Europa Pressの報道でも透明画像と編集の統合が紹介されています。ただし、発表内容の紹介と、同条件で画質を比較した実測は分けて読む必要があります。
Hugging FaceのユーザーTheTechnoXによる報告では、RTX 4060 Ti 16GBとComfyUI、INT8構成で局所的な編集が動作しています。生成は約20秒、編集は約60秒、VRAMのピークは約15GBとされています。ただし解像度やステップ数が十分に明記されていないため、そのまま手元のPCの所要時間とは考えないでください。
一方、Redditの使用レビューでは表情・ポーズ・背景の変更を評価しながら、黄色がかった色調、粒状感、人工的な質感、複雑な要素の組み合わせを課題に挙げています。単一の口コミを全体の結論にせず、自分が必要とする写真や構図で確認するのが確実です。
おすすめの試し方は、透明素材と変更範囲の狭い編集から始めること。実写の自然さや複数人物の一貫性は拡大して確認したい部分です。ここでの速度は第三者の報告であり、AirMoreが同一GPU条件で行ったベンチマークではありません。
オンラインで使う方法とAPI料金
Qwen公式のHugging Faceデモなら、対象バージョンを明確にして試せます。英語・中国語のプロンプト、画像のアップロード、プロンプト補強に対応します。共有デモなので混雑や利用条件は変わり、無制限利用や業務向けの稼働保証があるわけではありません。

- 文章から生成するときは画像を入れず、Prompt欄に一つの明確な指示を書きます。
- 編集するときは自分の画像をアップロードし、変える部分と維持する部分を指定します。
- 背景を透明にしたい場合は、RGBAと透明背景を明示します。保存形式はPNGにします。
- Enhance promptで追加された内容を確認します。余計な要素が増えるならオフにして比較します。
- Generate imageで生成し、保存後に原寸で文字や輪郭を確認します。
第三者サービスreAPIは、1Kが1枚0.02米ドル、2Kが0.04米ドルです。参考換算では約3.16円・約6.33円、100枚なら約316円・約633円。これはAlibaba公式のAPI料金ではなく、reAPIの表示価格です。税・決済手数料は別途確認してください。

円換算は2026年9月24日の参考レート、1米ドル=約158.13円による目安で、円建て請求の保証ではありません。APIドキュメントではモデルID qwen-image-2.1を指定し、非同期ジョブのIDで完了を確認します。自前のGPUでAPIを動かすならvLLM-Omniの手順があります。モデルの配布、共有デモ、有料APIは別のサービスです。
ComfyUI導入手順とVRAMの考え方
ComfyUIを更新し、Comfy-Org配布ファイルと公式の画像生成用JSONまたは画像編集用JSONを使います。2.1用のVAEとエンコーダーを組み合わせ、旧Qwenの構成をそのまま流用しないでください。

INT8構成の配置例は以下の通りです。BF16版もあります。読み込みノードでは、実際にダウンロードした精度・ファイル名を選びます。
ComfyUI/models/diffusion_models/
 qwen_image_2.1_int8_convrot.safetensors
ComfyUI/models/text_encoders/
 qwen3vl_8b_int8_convrot.safetensors
ComfyUI/models/vae/
qwen_image_2.1_vae_bf16.safetensors- 公式ワークフローJSONをComfyUIに読み込みます。
- 生成モデル・エンコーダー・VAEを上記フォルダーに置き、再起動またはモデル一覧を更新します。
- 各読み込みノードのファイルを選び直します。編集用では元画像も指定します。
- 最初は1024×1024、画像1枚から試し、動作してから解像度と参照枚数を増やします。
- シード・精度・解像度・設定を記録し、同じ条件で結果を比較します。透過画像は保存後のアルファチャンネルも確認します。
一律の「最低VRAM」は断定できません。vLLMのGB300測定例では1024×1024・40ステップのBF16構成で約34GBを使用しています。データセンター向けGPUでの数値なので、家庭用GPUの購入目安とは別です。前述の16GBでの動作報告は量子化と別の実行環境によるもので、2K・参照10枚まで保証するものではありません。
量子化やCPUオフロードでメモリ消費を抑えられる場合がありますが、速度や画質も変わります。RAMとSSDの余裕も必要です。別途配布される9Bのプロンプト補強モデルは任意で、初回から導入する必要はありません。
旧Qwen・FLUX.2 kleinとの比較
| モデル | 選ぶ理由 | 注意点 |
|---|---|---|
| Qwen-Image-2.1 | 透明素材と生成・編集を一つにまとめたい | 研究ライセンス。複雑な編集とメモリ負荷は要確認 |
| Qwen-Image-Edit-2511 | 既存の編集ワークフローを維持して比較したい | 旧世代の編集向けモデル。2.1と拡張の互換性は別 |
| FLUX.2 [klein] 4B | 高速な試行とApache-2.0の4B重みを重視する | 9B版はライセンスが異なるため混同しない |

服装だけの変更、商品ラベルの保持、背景の差し替えなど、普段使う画像で比較しましょう。一つの作業で改善しても、別の作業では前のモデルが適することがあります。

FLUX.2 klein 4BのAPIは最初の1メガピクセルで0.014米ドルから。追加ピクセルや参照画像の課金があるため、reAPIの1K・2K料金と単純には比較できません。透明素材の研究なら2.1、軽快な反復や重みの商用条件を重視するならklein 4Bが候補です。これは用途別の比較であり、同条件の画質ランキングではありません。
NSFW対応と商用ライセンス
ローカルで動くことは、公式に無制限のNSFW生成を保証する意味ではありません。ユーザー報告では文章からの生成と編集で挙動に違いがあり、補強モデルやホスト側のモデレーションも影響します。reAPIは入力・出力の審査を案内しているため、そのサービスのルールが適用されます。
Qwen Research Licenseは配布物の利用を研究・評価目的に制限し、商用利用には別のライセンスを求めています。窓口は model-business@notice.qwencloud.com。旧QwenのApache-2.0条件を引き継ぐとは考えないでください。有料APIを契約しただけで、すべての利用権が解決するわけでもありません。
使いやすいプロンプトとおすすめ用途
- 透明素材:被写体・素材・照明を指定し、背景は透明と明示。床や風景など矛盾する指定を増やさない。
- 商品写真:変更点だけでなく、形状・文字・反射・カメラ角度の維持を指示。結果でも確認する。
- 複数参照:1枚目は人物、2枚目は服など役割を明示。最初から10枚使わず、必要な画像を順に追加する。
- 文字入り画像:正確な文言を引用符で囲み、位置も指定。日本語の漢字・送り仮名・小さな文字は必ず校正する。
- アニメ・実写:顔や手の整合性、編集前後の同一性を確認。特定の画風や正確な人体を無条件に保証するモデルではない。
指示例:「透明RGBA背景の、オレンジ色の紙細工の花のステッカーを1個。花びらの輪郭は明瞭にし、周囲に余白を残す。文字なし」。編集なら「青い背景だけを薄緑に変更。ボトル本体、ラベル文字、反射、カメラ角度は維持」。これらは試すための例文で、生成結果を保証するものではありません。
よくある質問と結論
無料で使えますか?
重みには画像ごとのモデル利用料がありませんが、GPU・電力・クラウド実行費用は別です。研究ライセンスによる制限もあります。オンラインサービスの無料枠や料金は個別に確認してください。
7Bなら8GBのGPUで十分ですか?
そうとは限りません。エンコーダー、VAE、処理途中のデータもVRAMを使います。同じGPU、精度、解像度での動作報告を探すことが重要です。
旧版LoRAは使えますか?
2.1対応が明示されているか確認してください。旧モデル向けファイルを読み込めるとは限らず、まず公式テンプレート単体で動作を確認するのが確実です。
透過にならない場合は?
JPEGで保存していないか、実際にアルファチャンネルがあるかを確認します。背景を描く指示を外し、明暗の異なる背景に重ねて見てください。
今すぐ乗り換えるべき?
透明素材や局所編集の研究には試す価値があります。公式デモで必要な作業を絞って評価し、手元のGPUで再現できるならローカル導入へ進むと無駄がありません。速度・再現性・ライセンスを確認するまでは、使い慣れたモデルも残しておきましょう。
仕事での採用はサンプルの美しさだけで判断せず、利用条件を最初の選定基準に含めることをおすすめします。
関連 レビュー
【2026年】画像から3Dモデルを作るAIツール5選|特徴と用途を比較

Llama 4レビュー|Scout・Maverick・Behemoth、ローカル導入、NSFW対応まで解説

2026年版|厳選!使えるAI画像透かし除去ツール5選
Krea 2レビュー|ローカルAI画像生成モデルの特徴・使い方・注意点
HiDream O1レビュー|画像生成AI、LoRA、ローカル導入、NSFW対応まで解説
Gemini 4 Argonレビュー:料金・コーディング性能・長文処理・NSFWの制限