
Para anime, entrena sobre el checkpoint SDXL que utilizarás al generar, o elige el entrenador específico de Anima. Para fotografía, selecciona la arquitectura y versión exactas de Z-Image, Qwen, FLUX o Krea 2. Para vídeo, comienza con clips cortos en Wan, el entrenador oficial de LTX o una ruta específica de H3. Un LoRA es un adaptador de un modelo compatible, no un archivo de personaje universal.
Los errores caros suelen preceder al entrenamiento: usar pesos cuantizados solo para inferencia, mezclar generaciones, describir todas las imágenes igual o intentar enseñar movimiento con fotos aisladas. Una ejecución pequeña que llegue hasta guardar y cargar el adaptador vale más que copiar un preset enorme y esperar toda la noche.
Actualizado el 13 de octubre de 2026
Elige el modelo base antes que el entrenador
La división anime/fotografía describe usos habituales, no límites: FLUX y Krea también ilustran, y hay derivados SDXL realistas. Aquí WanX se interpreta como la familia Wan, con recetas concretas para 2.1 y 2.2. También debes concretar la generación de FLUX y LTX antes de descargar.
Pony V6 XL pertenece a SDXL; Pony V7 necesita otra arquitectura. Illustrious y NoobAI pueden compartir estructura pero variar en etiquetas y objetivo de predicción. Anima, Z-Image, Qwen y Krea 2 requieren módulos propios. Que un archivo cargue sin errores no demuestra que dé buenos resultados en otro checkpoint.
Qué herramienta de entrenamiento instalar
kohya_ss + sd-scripts
Para una interfaz gráfica de SDXL, usa el flujo LoRA/SDXL de kohya_ss. Indica checkpoint, carpeta de imágenes y descripciones, salida y configuración; guárdala antes de ejecutar. sd-scripts es la referencia de los argumentos. Una GUI que incluya una revisión antigua puede no exponer las funciones más recientes.
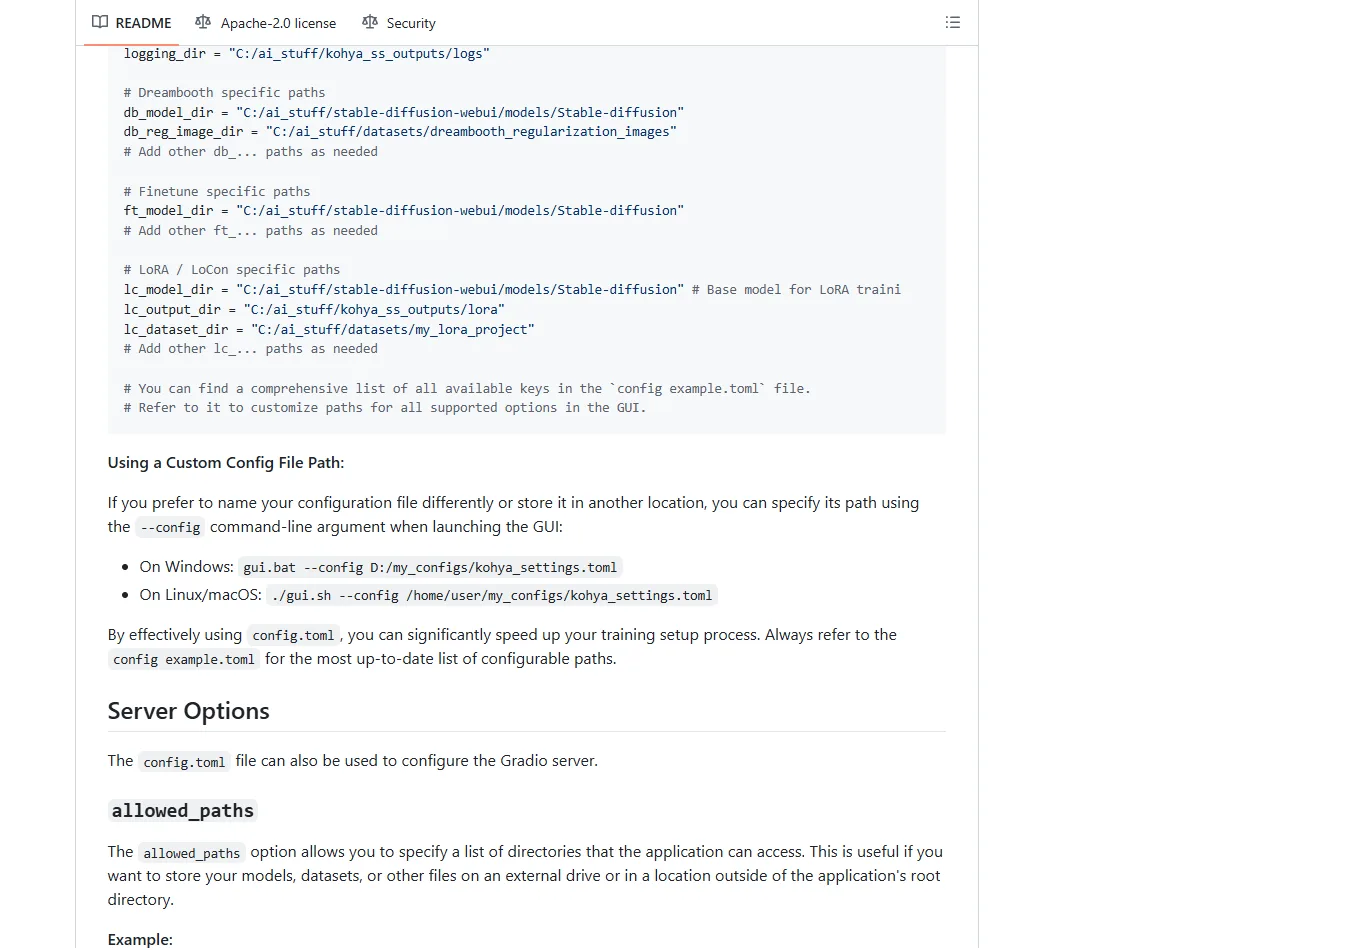
sd-scripts para Anima
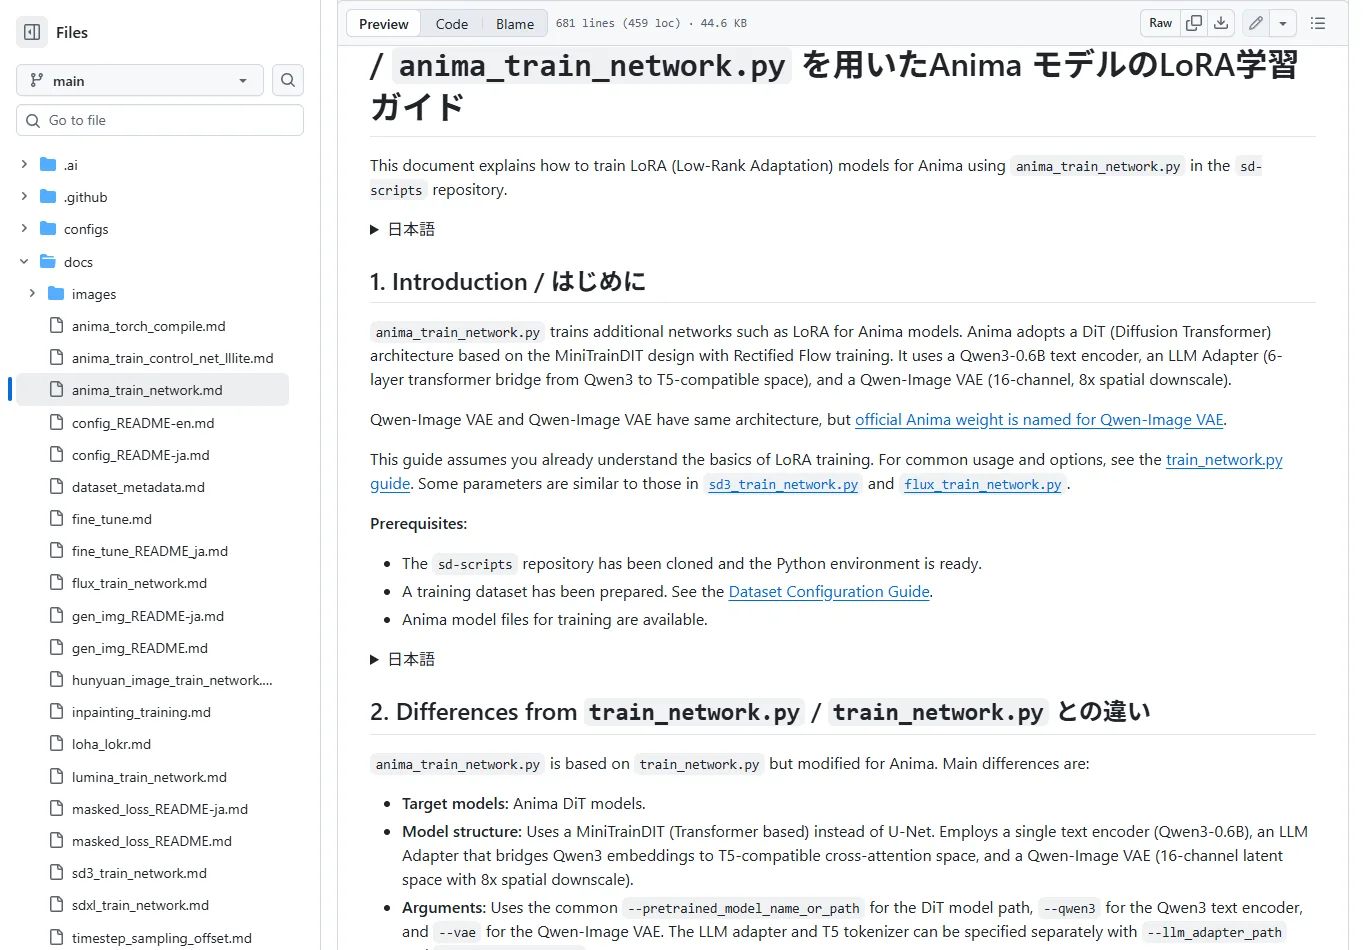
Anima utiliza anima_train_network.py, no el script de SDXL. Debes indicar DiT, codificador Qwen3 y VAE compatibles. Es una ruta apropiada si puedes editar un TOML y ejecutar comandos, y evita tratar todos los modelos de anime como una misma arquitectura.
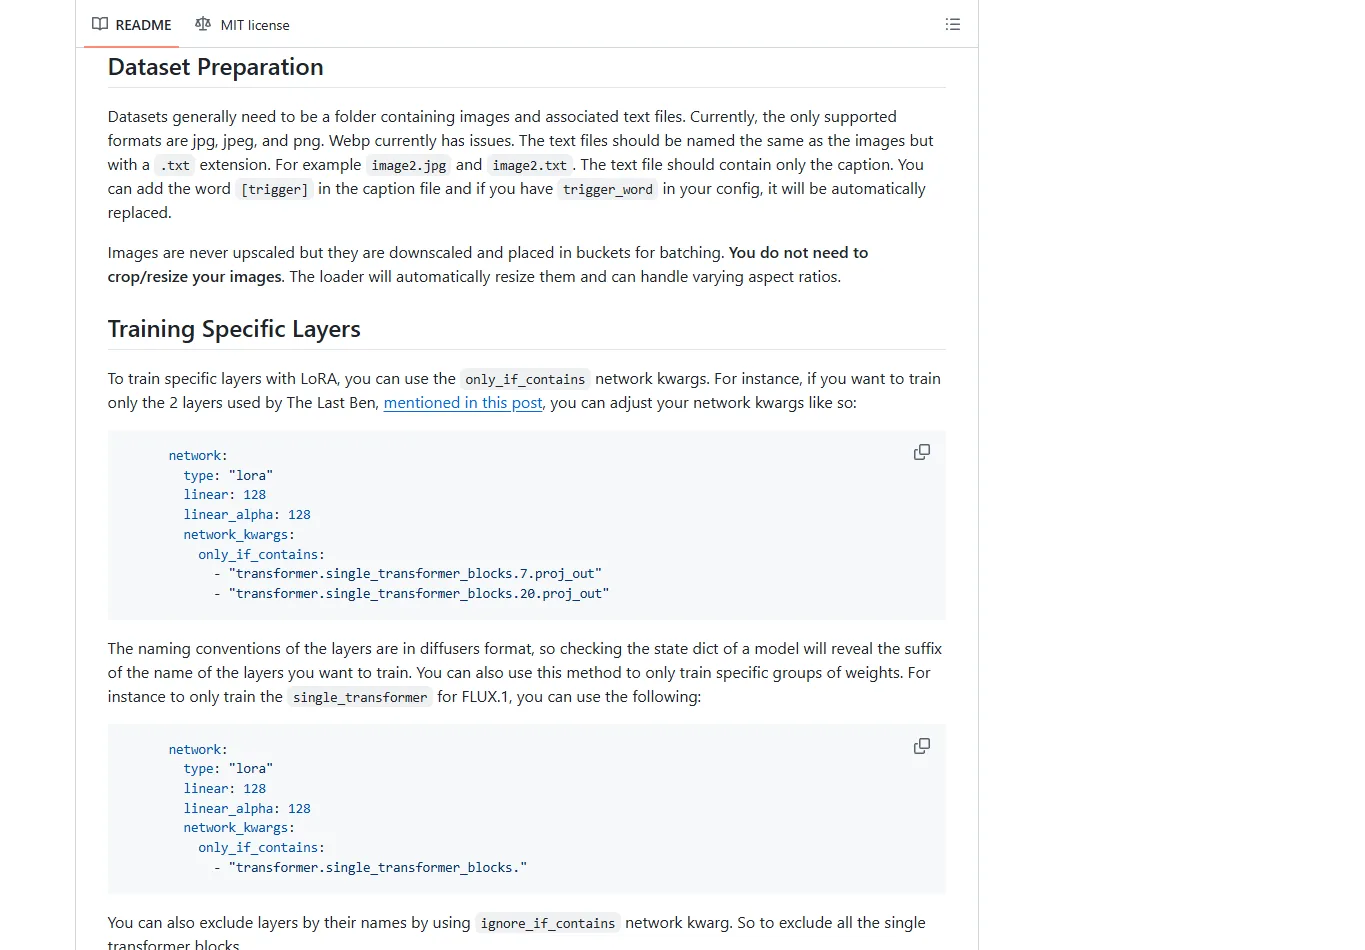
Ostris AI Toolkit
Ofrece GUI y trabajos YAML para distintas arquitecturas. Crea un trabajo, selecciona el modelo exacto, añade datos, token activador, prompts de validación y guardado periódico. Copia un ejemplo correspondiente al modelo; cambiar el nombre de un trabajo FLUX no lo convierte en Qwen. Protege con autenticación cualquier UI en la nube.
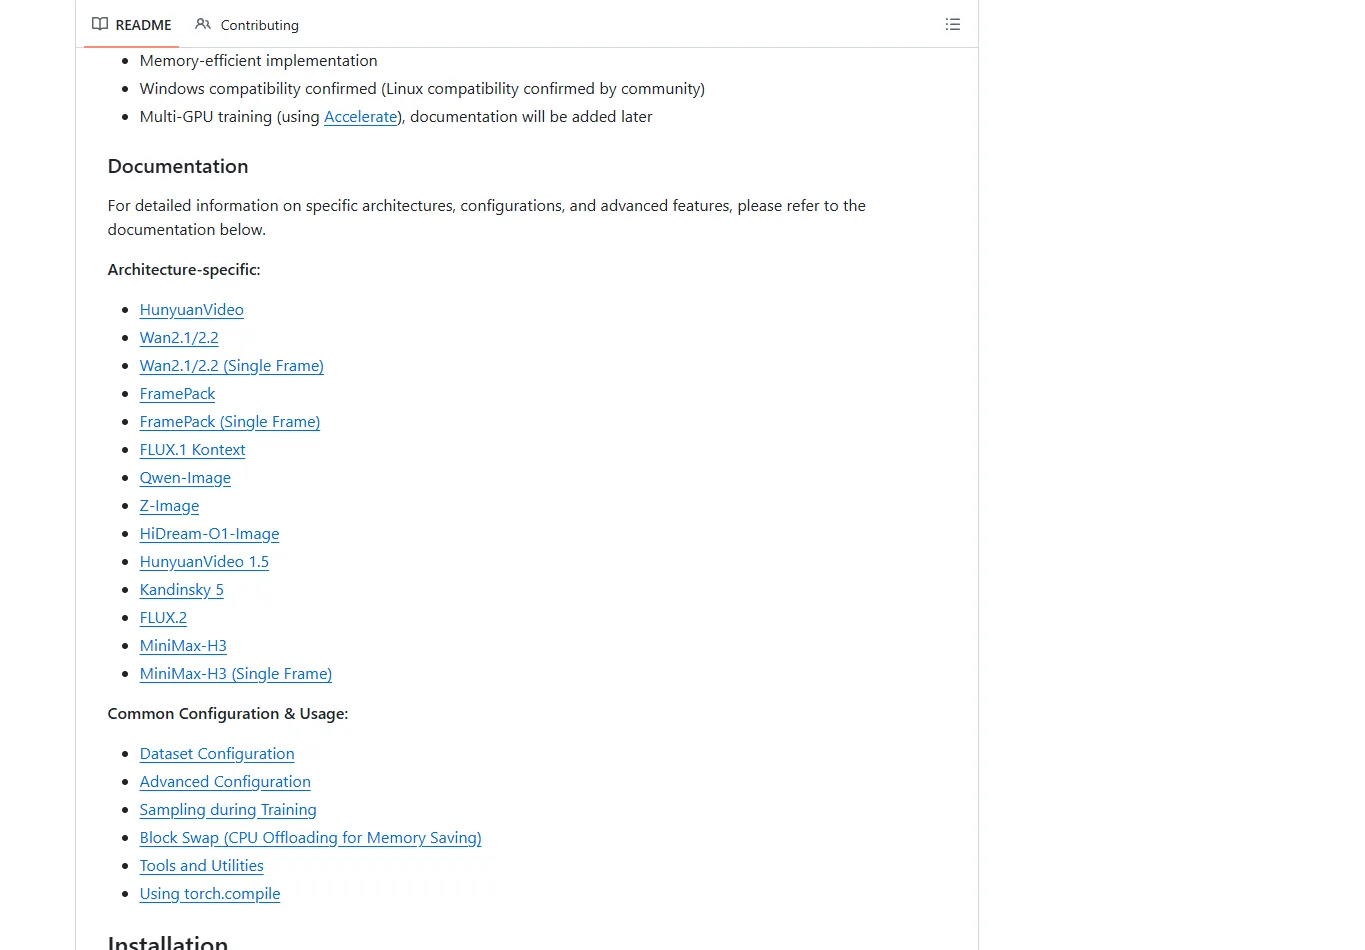
Musubi Tuner
Conviene para controlar caché, entrenamiento y opciones específicas, incluido intercambio de bloques con la RAM. Utiliza su entorno independiente: TOML de datos, caché de latentes, caché de texto y script de entrenamiento de la arquitectura. No reutilices cachés ni esquemas de ruido entre modelos incompatibles.
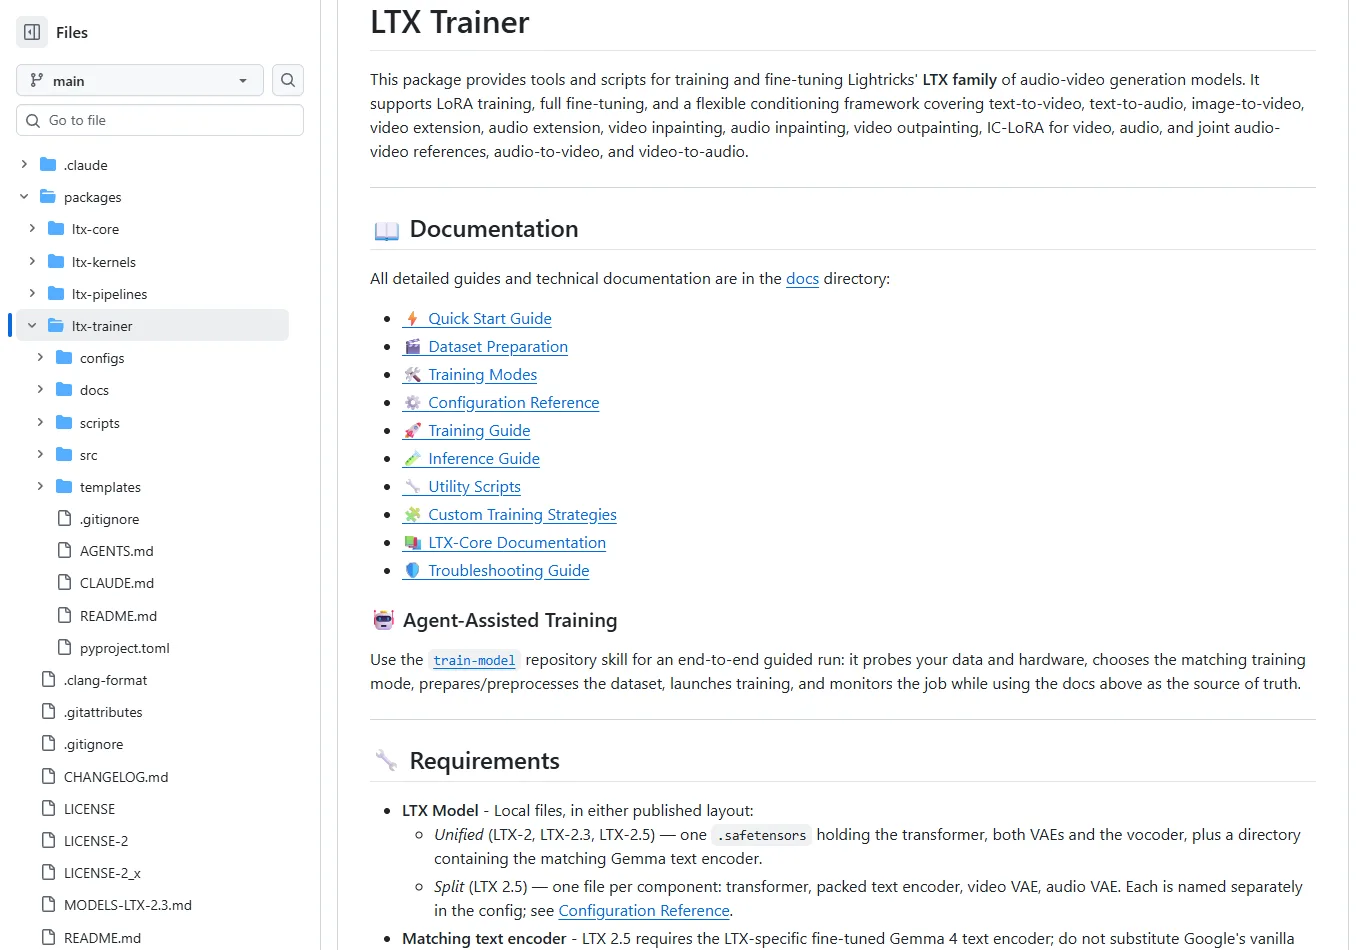
Lightricks LTX Trainer
Es la primera opción para LTX: preprocesado, entrenamiento y validación oficiales en el mismo repositorio. Copia el archivo de LoRA T2V estándar o de poca VRAM, no el de ajuste completo. Indica archivos locales de modelo y codificador compatibles.
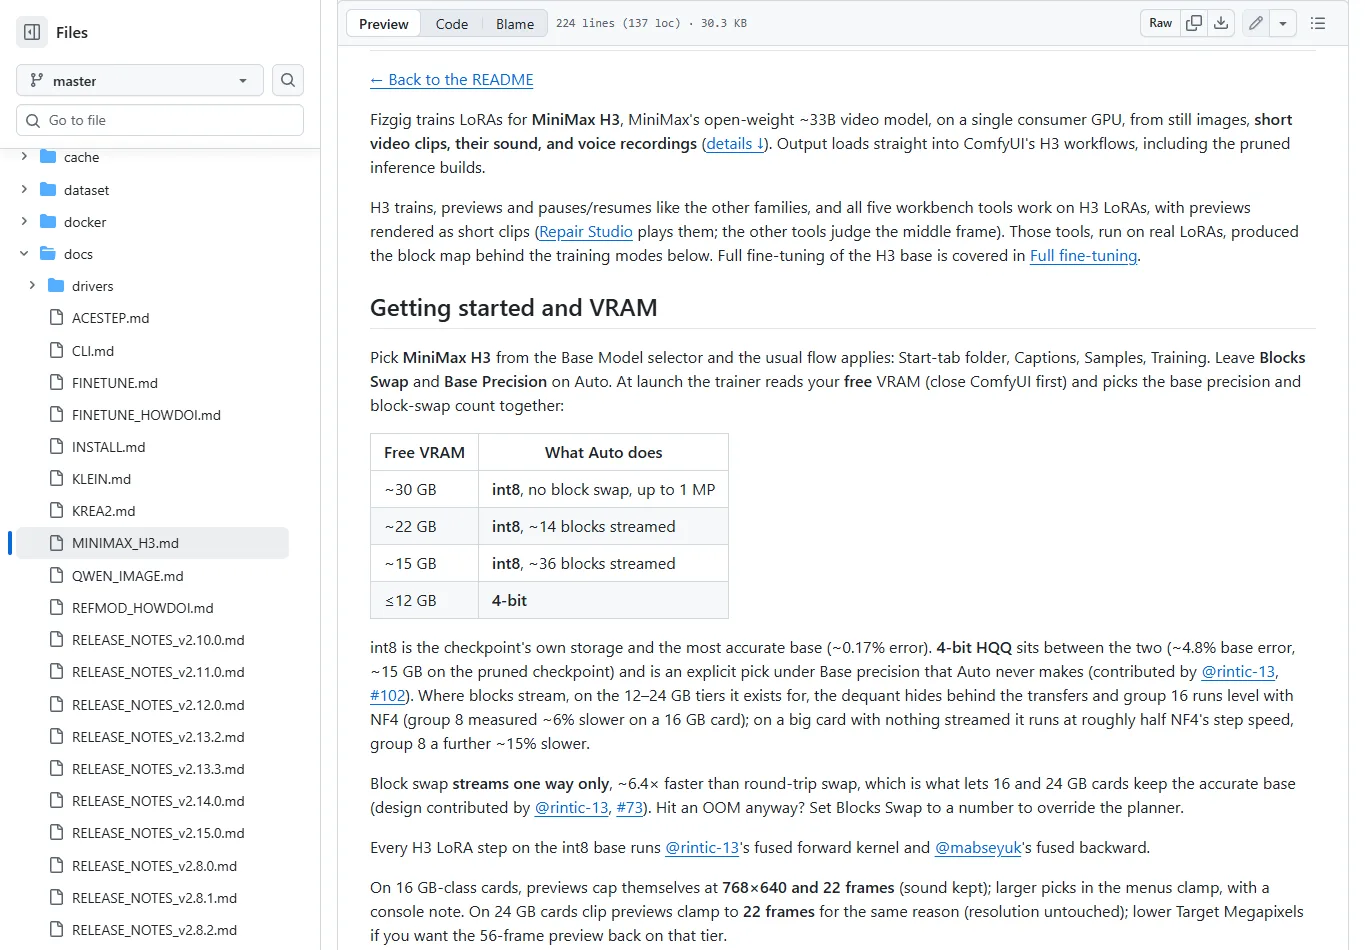
Fizgig para MiniMax H3
Es una alternativa comunitaria guiada. Selecciona MiniMax H3, prepara y describe imágenes o clips cortos, aplica Fast y revisa los checkpoints antes de ampliar duración. Su programación automática de aprendizaje no equivale a la tasa fija del ejemplo Musubi: conserva cada receta completa.
Prepara datos que enseñen el concepto correcto
- Define un solo objetivo: identidad, estilo, producto o movimiento. Un ensayo de imagen puede empezar con unas 20–50 imágenes distintas; es una recomendación manejable, no un mínimo garantizado. Un estilo necesita diversidad de temas.
- Elimina duplicados, anatomía rota, marcas de agua y compresión fuerte. Varía encuadre, pose, luz y fondo. Describe los elementos variables para que no queden ligados accidentalmente al activador.
- Empareja nombres como subject_001.png y subject_001.txt. Las etiquetas suelen encajar en varios modelos anime; las frases naturales, en muchos transformers. Revisa las descripciones automáticas: personas, acciones, izquierda/derecha y nombres.
- Reserva datos de evaluación realmente distintos. No dividas fotogramas vecinos de un mismo vídeo entre entrenamiento y evaluación: eso puede hacer pasar memorización por generalización.
- Corta vídeos en cambios de escena y conserva movimiento coherente. Registra FPS y duración. Una carpeta de fotogramas independientes enseña aspecto, pero no la secuencia temporal de una acción.
- Respeta resoluciones y números de fotogramas admitidos. Los modelos audiovisuales necesitan audio útil y sincronizado o un modo explícito solo de vídeo; añadir silencio no es una solución universal.
- Usa material propio o autorizado y obtén el consentimiento pertinente para personas y voces. La licencia del modelo, los derechos del material y la distribución del LoRA son cuestiones separadas.
- Guarda revisión del modelo, commit del entrenador, criterios de descripción y configuración. No actualices el entorno a mitad de ejecución; vuelve a generar cachés al cambiar texto, componentes o preprocesado.
Ejemplos propuestos de descripciones; no son resultados de una prueba de generación.
Anime: a1explorer, adult woman, blue jacket, standing, forest, daylight
Photo: A photo of a1subject wearing a blue jacket beside a window in soft daylight.
Video: a1subject walks from left to right, turns toward the camera, and stops. The camera remains fixed.
Parámetros iniciales: ejemplos y recomendaciones
Los ejemplos corresponden a documentos concretos de cada entrenador, no a valores óptimos medidos para cualquier conjunto. El rango SDXL es una propuesta inicial. Considera juntos rank, alpha, tasa de aprendizaje y optimizador: alpha=1 y alpha=rank no equivalen. Empieza con batch 1 y comprueba memoria.
| Modelo / variante | Ejemplo documentado o punto de partida |
|---|---|
| SDXL / Pony / Illustrious / NoobAI | SDXL: propuesta rank 16–32, alpha=rank, LR de U-Net 1e-4 y codificadores congelados. Buckets de 1024 si caben; 768 para una prueba limitada. Documentación |
| Anima | Anima: ejemplo sd-scripts rank 8, alpha 1 predeterminado, LR 1e-4, AdamW8bit y bf16. Si subes alpha, reconsidera la tasa. Documentación |
| Z-Image | Z-Image Base: ejemplo Musubi rank 32, LR 1e-4, AdamW8bit y shift 2.0. Turbo requiere una ruta específica de desdestilación/adaptador. Documentación |
| Qwen-Image | Qwen-Image original: rank 16, LR 5e-5 y shift 2.2 en Musubi. No es un preset universal para 2.1 o Edit. Documentación |
| FLUX | FLUX.1-dev: AI Toolkit usa 16/16, LR 1e-4, batch 1, 2.000 pasos y buckets 512/768/1024. FLUX.2 y Klein tienen arquitecturas separadas. Documentación |
| Krea 2 | Krea 2 RAW: ejemplo 32/32, LR 1e-4, bf16 y AdamW8bit; shift fijo 2.5 a 1024 o la opción krea2_shift dependiente de resolución. Documentación |
| Wan | Wan 2.1: rank 32, LR 2e-4, AdamW8bit y shift 3.0. Wan 2.2 necesita tratamiento por experto y rango temporal. Documentación |
| LTX | LTX de poca VRAM: 16/16, LR 1e-4, batch 1, 2.000 pasos, INT8 y checkpointing. 576×576×49 es una configuración de validación, no una forma obligatoria para todos los clips. Documentación |
| MiniMax H3 | MiniMax H3: ejemplo Musubi 16/16, LR 1e-4 y una receta completa de pérdida H3. Fizgig Fast usa 8/8, 50 épocas, 0,25 MP y programación automática desde 1e-6. Documentación |
LoRA de imagen: modelos de anime
Entrena primero en el checkpoint más cercano al resultado deseado. Entre derivados SDXL, la carga puede ser compatible mientras cambian semejanza, color o fuerza útil. Compruébalo con imágenes, no solo con el registro de carga.
Pony V6 XL: conserva la coherencia de base y etiquetas
Usa la ruta SDXL de kohya_ss/sd-scripts. Separa identidad o estilo de ropa y fondos variables. Para validar, sigue las etiquetas de calidad del Pony elegido; no las pegues automáticamente en todos los conjuntos Illustrious o NoobAI.
En la GUI selecciona checkpoint, datos, extensión de captions, buckets, rank/alpha y LR de U-Net. Congela inicialmente los codificadores y compara los mismos prompts en cada guardado. Si el activador obliga a una sola pose, prueba un checkpoint anterior. Esta receta no cubre Pony V7.
Documentación — Pony V6 XL: conserva la coherencia de base y etiquetas
Illustrious XL: no memorices el fondo
La herramienta general sigue siendo SDXL, pero importan versión y derivado. Elige el checkpoint de generación y su convención de descripción; algunas versiones posteriores dan más peso al lenguaje natural.
Prueba una identidad o estilo con rank 16–32 y codificadores congelados. Si aparece siempre el mismo fondo, mejora datos y captions antes de aumentar rank. Evalúa ropa y composiciones no vistas.
Documentación — Illustrious XL: no memorices el fondo
NoobAI XL: distingue epsilon y v-prediction
NoobAI tiene variantes de predicción. La ficha V-Pred especifica v-prediction y ajustes de inferencia de SNR terminal cero. La configuración de entrenamiento debe corresponder al objetivo y ruido de ese checkpoint, sin copiar un preset epsilon ni activar v-pred para cualquier Noob.
Tras elegir variante, haz el ensayo SDXL pequeño. Si fallan colores o contraste, revisa objetivo y scheduler de inferencia antes de culpar a los datos. La ficha enlaza una guía de LoRA v-pred; conserva esos ajustes junto al adaptador.
Documentación — NoobAI XL: distingue epsilon y v-prediction
Anima: una ruta DiT independiente
Prepara DiT de Anima, Qwen3-0.6B, VAE Qwen-Image compatible y los componentes de tokenizer/adapter que exija la versión. Usa anima_train_network.py y networks.lora_anima. Renombrar un LoRA Pony no cambia su arquitectura.
Para empezar, entrena solo DiT y almacena las salidas del codificador en caché. Trata rank 8/alpha 1 como una receta conjunta. Si entrenas texto después, desactiva esa caché y usa una tasa menor; las particularidades de dropout de Anima no se trasladan automáticamente a SDXL.
Cómo utilizarlo
- Crea el TOML y ajusta las rutas del ejemplo Anima.
- Usa bf16 cuando sea compatible, checkpointing y caché documentada, indicando entrenamiento solo de DiT.
- Guarda cada época y evalúa en la misma versión antes de añadir capacidad o módulos.
Documentación — Anima: una ruta DiT independiente
LoRA de imagen: fotografía y realismo
Z-Image: empieza preferentemente por Base
Musubi recomienda actualmente Base. El consejo antiguo de que solo existe Turbo está desactualizado. Turbo destilado necesita una ruta compatible De-Turbo o adaptador de entrenamiento y su tratamiento de inferencia.
Prepara DiT, VAE y texto; ejecuta las cachés Z-Image y después zimage_train_network.py con networks.lora_zimage. Prueba el ejemplo rank 32/LR 1e-4 y revisa la conversión si el cargador de inferencia espera otro formato.
Cómo utilizarlo
- Elige Base, De-Turbo o Turbo con adaptador y anótalo en el trabajo.
- Cachea con los componentes correspondientes y guarda varios checkpoints.
- Valida con el flujo Z-Image compatible y convierte el LoRA solo cuando la documentación lo requiera.
Documentación — Z-Image: empieza preferentemente por Base
Qwen-Image: generar y editar exigen datos distintos
El Qwen original tiene un ejemplo Musubi rank 16/LR 5e-5. Un LoRA de edición necesita imagen de entrada/control, objetivo e instrucción del cambio. Una carpeta de retratos descritos no enseña por sí sola esa operación.
AI Toolkit enumera generación y edición para Qwen-Image-2.1; las imágenes de control activan edición. Selecciona esa arquitectura exacta en vez de reutilizar model_version original. Evalúa en entradas nuevas tanto el cambio pedido como la conservación del resto.
Cómo utilizarlo
- Escoge generación o edición y la versión precisa.
- Para editar, alinea los pares e instrucciones y revisa ejemplos antes de cachear.
- Entrena pequeño y compara fuerza de edición y preservación en datos no vistos.
Documentación — Qwen-Image: generar y editar exigen datos distintos · AI Toolkit: Qwen-Image-2.1
FLUX: separa FLUX.1, FLUX.2 y Klein
Copia el YAML FLUX.1-dev de AI Toolkit, cambia datos, salida y activador y ejecútalo mediante python run.py. El ejemplo hace explícitos guardado, validación y pasos. Acepta la licencia necesaria y protege el token de acceso.
FLUX.2-dev y Klein requieren sus propias arquitecturas y componentes. Describe lo visible con frases naturales y un activador constante; elimina detalles inventados por el autoetiquetado. No conviertas un trabajo FLUX.1 en otro cambiando únicamente su nombre.
Cómo utilizarlo
- Parte del ejemplo o preset correcto.
- Fija prompts con un escenario nuevo y otro sin activador.
- En FLUX.1-dev compara alrededor del presupuesto de referencia de 2.000 pasos y detente antes si pierde flexibilidad.
Documentación — FLUX: separa FLUX.1, FLUX.2 y Klein
Krea 2: entrena RAW y valida Turbo
Musubi recomienda RAW para entrenar y Turbo para inferencia. Necesitas raw.safetensors, VAE Qwen-Image y Qwen3-VL-4B en archivo único. La secuencia utiliza krea2_cache_latents.py, krea2_cache_text_encoder_outputs.py y krea2_train_network.py.
Comienza con 32/32 y LR 1e-4. Shift 2.5 a 1024 y krea2_shift son opciones distintas. RAW necesita CFG; Turbo usa pocos pasos y CFG desactivado. Una muestra RAW borrosa sin CFG no demuestra por sí sola que el LoRA haya fallado.
Cómo utilizarlo
- Cachea con los componentes RAW y conserva Turbo por separado.
- Entrena RAW y usa validación Turbo cuando sea compatible con el modo de memoria.
- Prueba la referencia Turbo de 8 pasos/CFG 1 y compara identidad, poses y fondos.
Documentación — Krea 2: entrena RAW y valida Turbo
LoRA de vídeo: Wan, LTX y MiniMax H3
Wan 2.1/2.2: decide entre apariencia y movimiento
Selecciona T2V/I2V antes de cachear. El modo de un fotograma ayuda a apariencia, pero un movimiento necesita clips coherentes. Usa wan_cache_latents.py, wan_cache_text_encoder_outputs.py y después wan_train_network.py.
Wan 2.2 A14B separa expertos de ruido alto y bajo. La guía usa 0–900/900–1000 en I2V y 0–875/875–1000 en T2V, conservando la forma de distribución al entrenar un experto. Entrenar ambos eleva mucho la memoria.
Cómo utilizarlo
- Elige tarea, pesos y un bucket corto; inspecciona un clip decodificado.
- Cachea con VAE/T5 y componentes de la tarea y parte del ejemplo Wan.
- En 2.2 registra experto, rango y rama de inferencia de cada adaptador.
- Evalúa secuencias completas para detectar deriva y fallos de movimiento.
Documentación — Wan 2.1/2.2: decide entre apariencia y movimiento
LTX: el entrenador oficial también exige versiones compatibles
El entrenador cubre LTX-2, 2.3 y 2.5. Los dos primeros usan Gemma 3; 2.5 requiere el Gemma 4 ajustado específicamente por LTX. No sustituyas ese encoder ni reutilices embeddings de otra generación.
El ejemplo de 32GB usa 16/16, LR 1e-4, batch 1, 2.000 pasos, INT8 y checkpointing. El estándar recomienda 80GB. No significa que cualquier longitud y resolución quepa en una GPU de 32GB.
Cómo utilizarlo
- Instala el entorno y descarga componentes locales compatibles.
- Divide clips, revisa captions y ejecuta process_dataset.py con buckets admitidos en una carpeta nueva.
- Copia el YAML de poca VRAM o estándar, cambia rutas y lanza scripts/train.py.
- Para I2V, audio o referencias, elige estrategia y módulos correspondientes.
Documentación — LTX: el entrenador oficial también exige versiones compatibles · LTX: low-VRAM YAML
MiniMax H3: conserva la receta específica completa
Para un inicio guiado, Fizgig Fast combina 8/8, 50 épocas y 0,25 MP con programación adaptativa. Su ejemplo de 16GB admite hasta 56 fotogramas a 0,25 MP: es una condición de esa herramienta, no un mínimo universal de H3.
Musubi ejemplifica 16/16 y LR 1e-4, pero exige además una ruta completa de pérdida: adaptador de entrenamiento, guidance loss o teacher matching. El tiempo base usa uniform/none/shift 1.0; los shifts de audio y vídeo son internos. No copies el shift de Wan.
Cómo utilizarlo
- Elige Fizgig o Musubi sin mezclar sus tasas y programaciones.
- Comienza con imágenes para identidad o los clips de movimiento más cortos admitidos.
- En Musubi alinea tarea, pérdida y cachés de vídeo, audio y texto.
- Comprueba guardado y recarga y evalúa en el base final, no solo en muestras con el adaptador de entrenamiento.
Documentación — MiniMax H3: conserva la receta específica completa · Fizgig: MiniMax H3
Del conjunto de datos al primer adaptador
El siguiente ejemplo es una plantilla inicial para SDXL epsilon-prediction. Instala sd-scripts según sus instrucciones y sustituye todas las rutas. Congela los codificadores para utilizar caché. NoobAI V-Pred y otras arquitecturas necesitan sus propios ajustes: no ejecutes esta receta sin adaptar.
Ejemplo de configuración — dataset.toml
[general]
caption_extension = ".txt"
shuffle_caption = false

[[datasets]]
resolution = 1024
batch_size = 1
enable_bucket = true

[[datasets.subsets]]
image_dir = "/path/to/images"
num_repeats = 5
SDXL / Epsilon
accelerate launch sdxl_train_network.py --pretrained_model_name_or_path="/path/to/sdxl-epsilon.safetensors" --dataset_config="dataset.toml" --output_dir="output" --output_name="subject_lora" --network_module=networks.lora --network_dim=16 --network_alpha=16 --network_train_unet_only --learning_rate=1e-4 --optimizer_type=AdamW8bit --lr_scheduler=constant --max_train_steps=1000 --save_every_n_steps=250 --mixed_precision=bf16 --save_model_as=safetensors --gradient_checkpointing --cache_latents --cache_text_encoder_outputsHaz primero 100–200 pasos de optimizador para comprobar caché, backward, guardado y carga en inferencia. Amplía solo después de verificar que el adaptador funciona y compara checkpoints intermedios, no únicamente el último.
En Musubi: TOML → caché de latentes → caché de texto → entrenamiento específico → inferencia compatible. Copia la receta completa del modelo: componentes, módulos, tiempos y pérdida importan tanto como la tasa.
Evalúa los checkpoints y corrige errores
No cambia nada
Comprueba carga, activador, arquitectura y fuerza distinta de cero. Revisa claves ausentes antes de añadir pasos.
Repite una sola imagen
Prueba un checkpoint anterior o menor fuerza; mejora diversidad y reduce repeticiones antes de aumentar rank.
Baja la pérdida, empeoran los resultados
Usa prompts reservados y semillas fijas. La pérdida no mide por sí sola composición, identidad flexible ni movimiento.
Memoria insuficiente
Distingue caché, entrenamiento y validación. Reduce batch, resolución o duración y usa optimizaciones admitidas. Acumular gradientes no hace caber una muestra demasiado grande.
Parpadeo o falta de movimiento
Comprueba coherencia temporal, FPS, tarea y módulos audiovisuales. Un buen retrato no prueba aprendizaje temporal.
Ignora captions nuevos
Regenera cachés al cambiar texto, activadores o encoders. No uses latentes de otra base.
VRAM, tiempo y coste real
No compres una GPU por cifras de inferencia. El entrenamiento añade activaciones, gradientes y estado del optimizador; validar puede consumir más. SDXL es un inicio más ligero. Para DiT modernos, 16–24GB o más y offloading compatible pueden ser útiles, sin constituir mínimos certificados.
Musubi recomienda en general 12GB para imagen, 24GB para vídeo y 64GB de RAM; cada arquitectura puede exigir más. En la comparación Krea a 1024/batch 1, bf16 no cabe en una 3090, pero hay rutas cuantizadas. Los presets LTX de 32/80GB y el H3 limitado de Fizgig no justifican un mínimo único.
Presupuesta descarga y caché + pasos por segundos medidos + validación y guardado. Multiplica por la tarifa horaria vigente y añade almacenamiento, transferencia, impuestos y conversión de moneda si procede. En local cuenta equipo y electricidad; código gratuito no equivale a cómputo gratuito.
Batch efectivo = batch por GPU × acumulación × GPU. Con 40 imágenes, cinco repeticiones, batch efectivo 2 y diez épocas, la estimación simple es 1.000 pasos. Los buckets y lotes parciales pueden variar el total: comprueba el que muestra el entrenador.
Preguntas frecuentes
¿Un LoRA sirve para todos los modelos?
No: formas y capas dependen de la arquitectura. Incluso en SDXL, carga compatible no garantiza estética o identidad. Documenta base de entrenamiento e inferencia probada.
¿Entreno el codificador de texto?
Empieza congelándolo. Una caché fija no permite actualizarlo; prueba su entrenamiento por separado si está admitido, con tasa y caché compatibles.
¿Bastan 20 imágenes?
Pueden servir para una prueba de sujeto estrecha, sin garantía. Un estilo necesita temas variados y un movimiento clips coherentes. Mejora cobertura antes de multiplicar repeticiones.
¿Rank 32 siempre?
No. Rank aporta capacidad y consume memoria; alpha cambia la escala. Conserva la receta inicial y modifica una variable: alpha 1 de Anima no equivale a alpha=rank de Krea.
¿Las fotos enseñan una acción nueva?
Ayudan a apariencia, pero no codifican orden temporal. Usa entrenamiento de vídeo compatible y evalúa toda la secuencia.
¿Puedo entrenar Turbo o GGUF directamente?
Solo formatos y recetas expresamente admitidos. Algunas rutas cuantizan pesos congelados y otras requieren un adaptador previo. Compatibilidad de inferencia no implica entrenamiento.
¿Cómo uso el archivo final?
Cárgalo con base y loader compatibles, añade el activador y compara semillas y fuerzas, por ejemplo 0, 0,5 y 1. Aplica cualquier conversión de formato documentada.
Por dónde empezar
Empieza con una base, un concepto y una evaluación fija. SDXL con kohya_ss es una entrada directa para anime; si generarás con Anima, entrénalo en Anima. AI Toolkit facilita modelos fotográficos, mientras Musubi expone los detalles específicos.
En vídeo decide primero apariencia, movimiento, edición o audio. Conserva la receta completa, empieza corto y verifica el primer checkpoint antes de ampliar. Un adaptador pequeño y flexible suele ser más útil que uno que memoriza los datos.
Lecturas relacionadas: Mejores sitios de descarga de modelos de IA de imagen y LoRA: Checkpoints, LoRA y seguridad NSFW
Relacionados
15 mejores páginas web gratuitas de libros electrónicos para descargar y leer legalmente en 2026

Cómo usar Claude Code (Guía para principiantes)

5 mejores apps de salud con IA en 2026
6 mejores herramientas para resumir vídeos de YouTube en 2026
Los 6 mejores editores de vídeo con IA en 2026
Las mejores herramientas de IA para PDFs en 2026: edita, genera y optimiza tu trabajo