Claude Fable 5.1 und Mythos 5.1 im Review 2026: Preise, API, NSFW und GPT–Gemini-Vergleich
Claude Fable 5.1 und Mythos 5.1 im Vergleich: Preise, API, Pro-/Max-Limits, Neuerungen, Nutzererfahrungen, NSFW-Regeln und Alternativen von GPT und Gemini.

Claude Fable 5.1 ist besonders interessant, wenn wiederholte Korrekturen an einem schwierigen Projekt mehr kosten als die Modellnutzung. Eine Codebasis untersuchen, ein Manuskript gründlich überarbeiten oder Dokumente in mehreren Schritten erstellen: Das sind überzeugendere Gründe für einen Versuch als kurze Alltagsfragen. Mythos 5.1 ist eine Spezialoption für zugelassene Organisationen, kein höheres Privatkundenabo über Fable.
Vor dem Kauf ist entscheidend: Das reguläre Pro-Kontingent umfasst keine Fable-Nutzung, und auch Max ist nicht unbegrenzt. Meist lohnt es sich, mit einem bezahlbaren Modell anzufangen und Fable für anspruchsvolle Aufgaben zu reservieren, statt nach einem Mythos-Zugang zu suchen.
Fable 5.1 oder Mythos 5.1: Wofür bezahlt man?
Die am 1. September 2026 angekündigten Namen stehen für dasselbe zugrunde liegende Modell mit unterschiedlichen Schutzmaßnahmen. Fable ist breit verfügbar; Mythos unterstützt genehmigte Arbeiten, bei denen zusätzliche Beschränkungen für Cybersicherheit und Biowissenschaften relevant sind. Diese redaktionelle Bewertung mit Stand 11. September verbindet dokumentierte Angaben mit zugeordneten Erfahrungen Dritter. Wir haben keinen eigenen kontrollierten Modellbenchmark durchgeführt und keinen Mythos-Zugang erhalten. Offizielle Ankündigung.
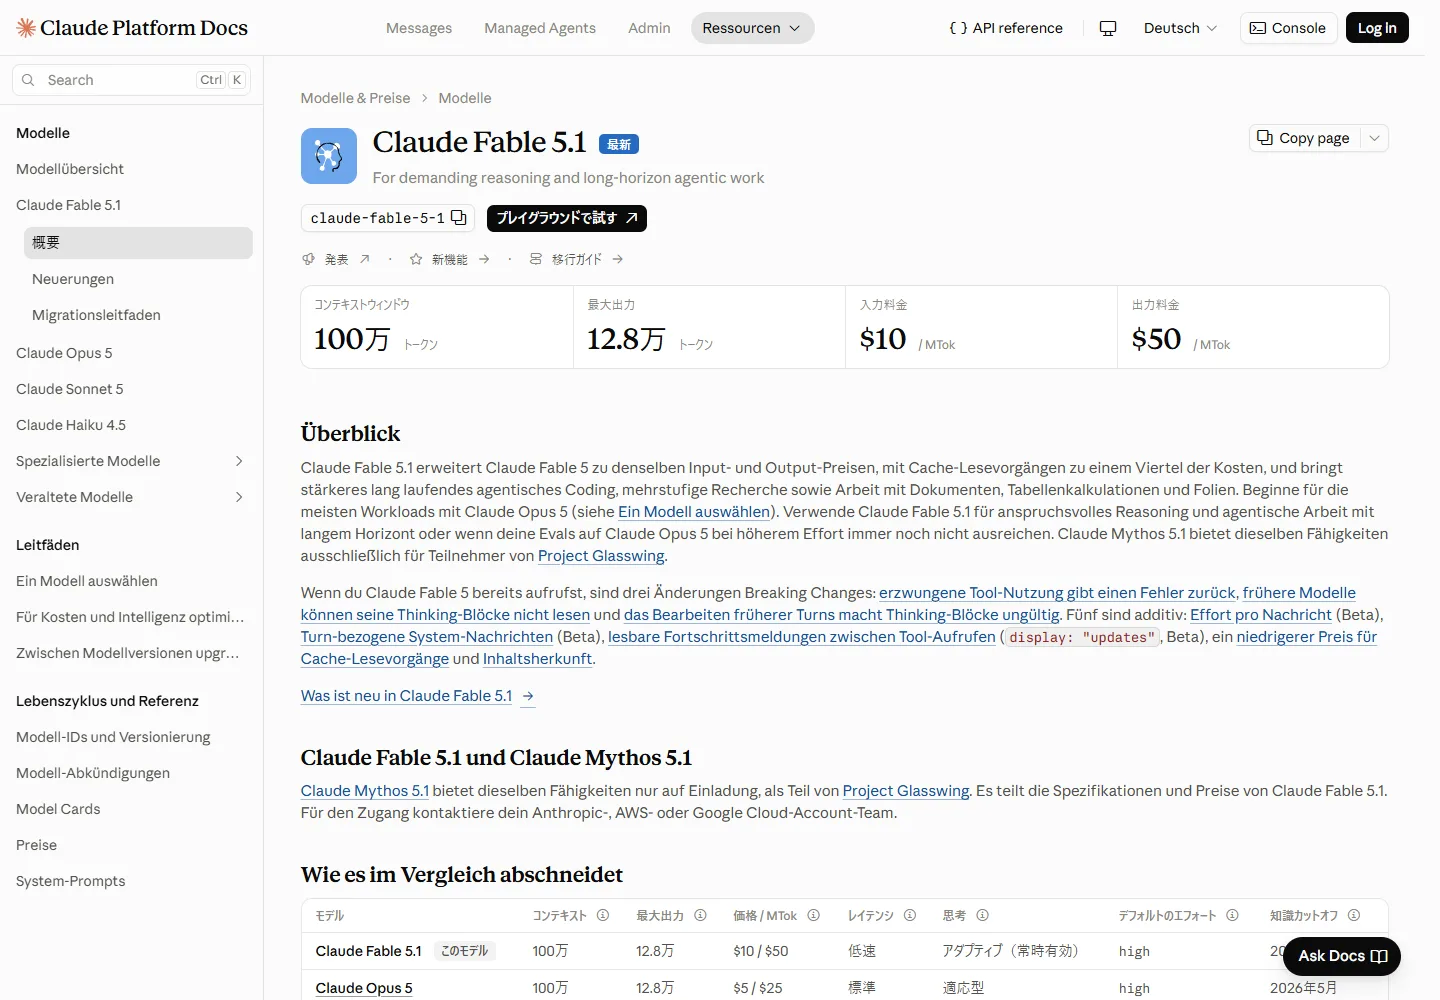
| Eigenschaft | Claude Fable 5.1 |
|---|---|
| Offizielle API-Modell-ID | claude-fable-5-1 |
| API-Kontextfenster | 1 Million Tokens |
| Maximale API-Ausgabe | 128.000 Tokens |
| Modalitäten | Text und Bilder als Eingabe; Text als Ausgabe |
| Denken | Adaptives Denken, immer aktiviert |
| Verlässlicher Wissensstand | Juni 2026 |
| Praktischer Schwerpunkt | Anspruchsvolles Schlussfolgern und lange Agentenaufgaben |
Das sind API-Spezifikationen, keine Zusage, dass jede Claude-App oder jedes Abo das gesamte Kontextfenster bereitstellt. Großer Kontext bedeutet zudem kein perfektes Erinnerungsvermögen: Recherchen brauchen nachvollziehbare Quellen, Codeänderungen eine Prüfung. Code zu erzeugen, der ein Diagramm erstellt, macht Fable nicht zum nativen Bildgenerator.
Offizielle Online-Nutzung und Anbieter mit API-Zugang
Für Privatnutzer ist Claude der Einstieg. Prüfen Sie Modellauswahl und Nutzungseinstellungen des vorgesehenen Bezahlkontos. Die offizielle Claude Platform bietet API-Zugang und eine Testumgebung. Chatabo und Entwicklerabrechnung sind getrennte Produkte; die Zahlung für eines schafft nicht automatisch Guthaben für das andere.
| Zugangsweg | Einstieg | Worauf achten? |
|---|---|---|
| Claude im Web oder als App | claude.ai | Bezahlplan, Fable-Guthaben oder berechtigtes Inklusivkontingent |
| Anthropic-API | Claude Platform | Modell-ID claude-fable-5-1, Abrechnung und Organisationslimits |
| Cloudplattformen | Offizielle Plattformlinks | Amazon Bedrock, Claude Platform on AWS, Google Cloud und Microsoft Foundry; Regionen und Verträge |
| Drittanbieter mit einheitlicher API | Fable 5.1 bei OpenRouter | ID anthropic/claude-fable-5.1, Anbieter, Datenschutz und Gebühren |
| Mythos 5.1 | Zugangsinformationen von Anthropic | Zulassungsvoraussetzungen; kein üblicher öffentlicher Registrierungsweg |
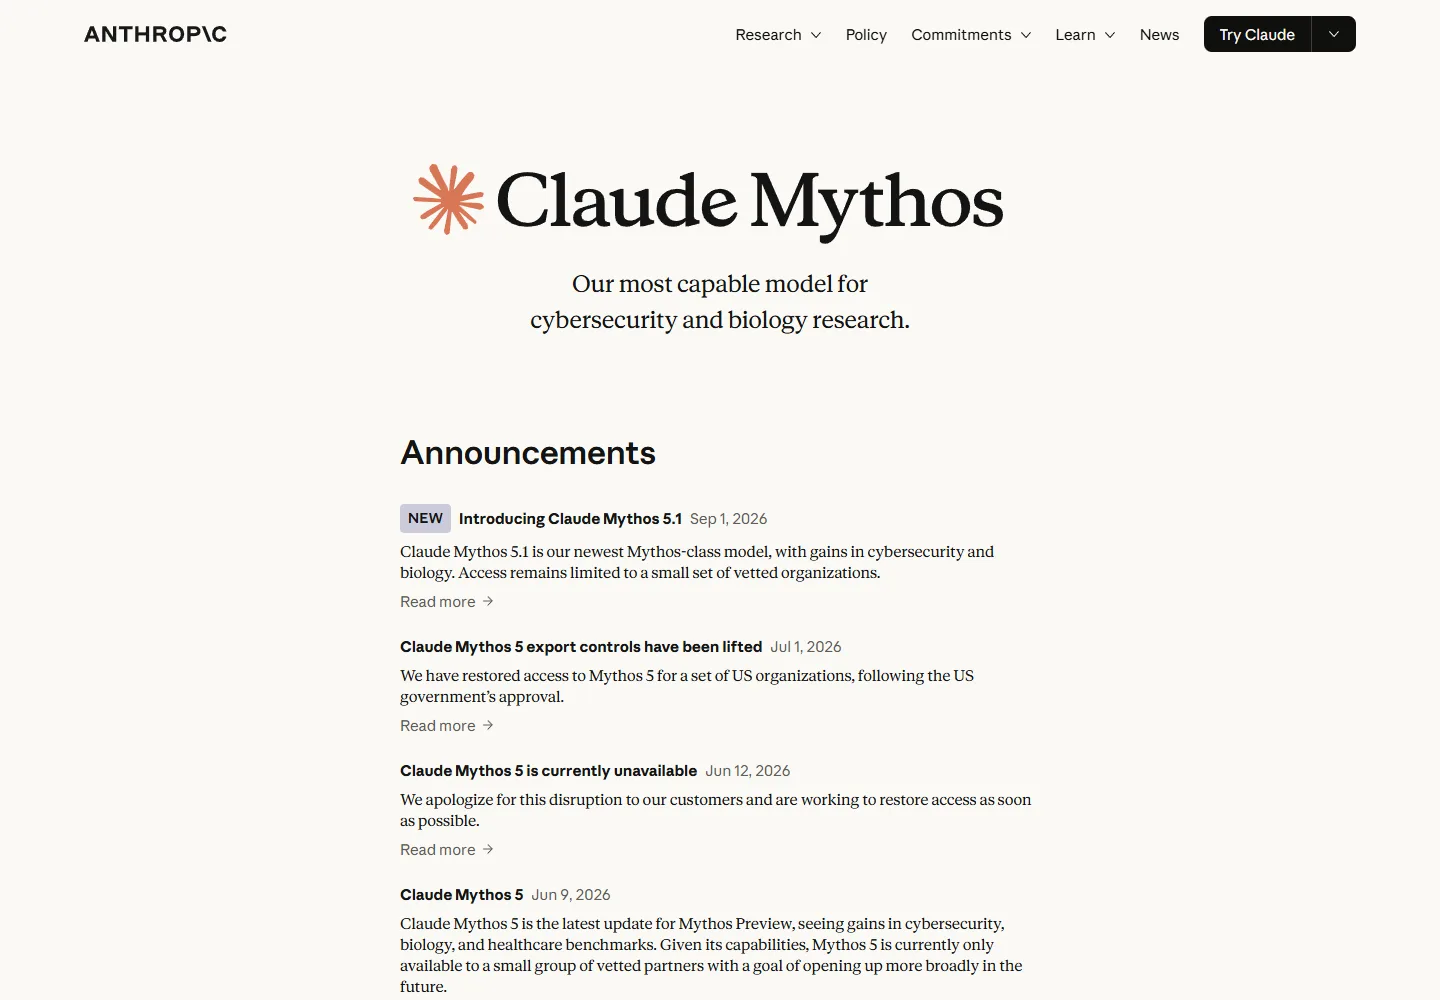
Die Mythos-Seite begrenzt die Verfügbarkeit derzeit auf ausgewählte US-Organisationen. Für Biowissenschaften gibt es eine Beta auf Einladung; Mythos-Zugang über das Cyber Verification Program wird für die nahe Zukunft angekündigt. Eine Bewerbung bedeutet daher noch keine Freischaltung. Der veröffentlichte API-Einstiegspreis beträgt 10 USD für Eingabe und 50 USD für Ausgabe je Million Tokens; die Zugangsvoraussetzungen bleiben bestehen.
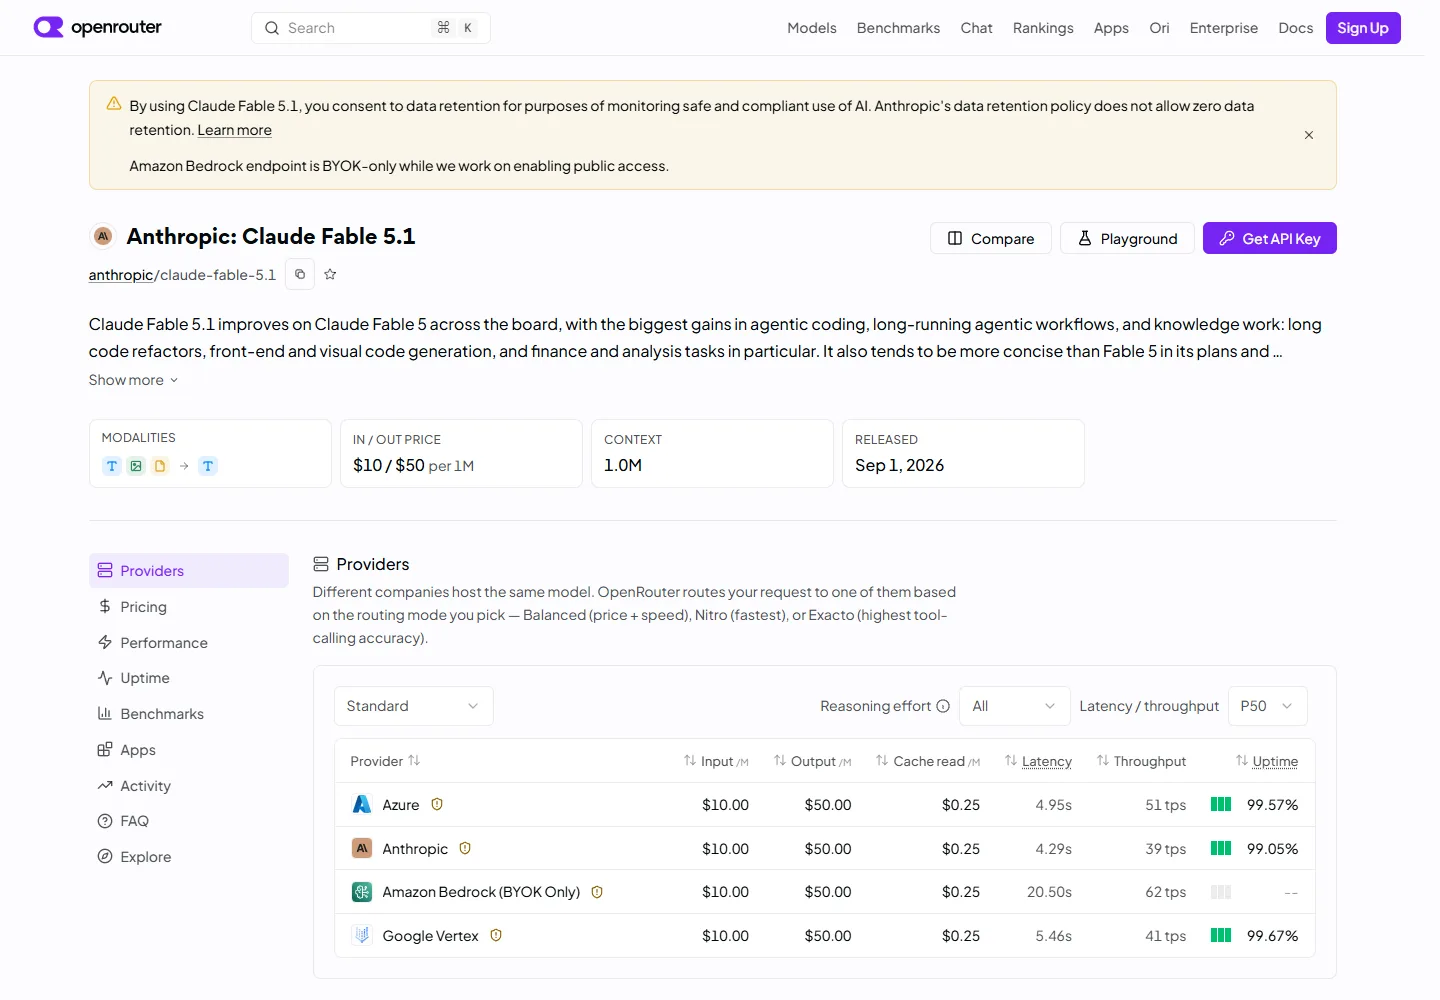
Der OpenRouter-Eintrag ist ein verifizierter Drittanbieterweg zur Fable-API, nicht Anthropics eigene Website. Bei der Prüfung war der Bedrock-Endpunkt als ausschließlich BYOK, also mit eigenem Schlüssel, gekennzeichnet und zeigte Bedingungen zur Datenspeicherung. Wählen Sie den tatsächlichen Anbieter bewusst: Direkte Unternehmensvereinbarungen mit Anthropic gelten nicht automatisch bei einem Vermittler. Ungeprüfte Websites mit angeblich uneingeschränktem Mythos-Zugang empfehlen wir nicht.
Abos, API-Kosten und die tatsächliche Cache-Ersparnis
Die öffentliche Preisliste nennt Pro für 20 USD monatlich oder 200 USD jährlich; Max ab 100 USD monatlich, zuzüglich Steuern. Auch die geprüfte deutsche Seite weist US-Dollar aus, keinen offiziellen Eurotarif. Kontrollieren Sie Währung und Endbetrag beim Bezahlen; eine Umrechnung ist kein zugesicherter regionaler Listenpreis. Abopreise.
| Plan oder Zugang | Abrechnung von Fable 5.1 |
|---|---|
| Free | Nicht enthalten |
| Pro und Standardplätze bei Team | Nutzungsabhängiges Guthaben außerhalb des regulären Kontingents |
| Max und Premiumplätze bei Team | Bis zu 50 % des gemeinsamen Wochenkontingents; Mehrverbrauch kann Guthaben erfordern |
| Enterprise | Abhängig vom Vertrag nach Plätzen oder Verbrauch; Arbeitsbereich prüfen |
| Entwickler-API | Separate Tokenabrechnung |
Die 50 % sind kein zusätzliches Kontingent. Andere Modelle verbrauchen denselben Wochenvorrat, Fable schneller. Eine monatliche Nachrichtenanzahl lässt sich ohne Aufgabenart, Gesprächslänge und Agentenaktivität nicht sinnvoll schätzen. Siehe die modellspezifischen Planregeln.
| API-Kosten je Million Tokens | Fable 5 | Fable 5.1 / zugangsbeschränktes Mythos 5.1 |
|---|---|---|
| Eingabe ohne Cache | 10 USD | 10 USD |
| Ausgabe | 50 USD | 50 USD |
| Cache-Schreiben für fünf Minuten | 12,50 USD | 12,50 USD |
| Cache-Schreiben für eine Stunde | 20 USD | 20 USD |
| Cache-Lesen | 1 USD | 0,25 USD |
Das sind Standardtarife aus der API-Preisliste. Die Senkung um 75 % gilt für Cache-Lesezugriffe, nicht für jede vollständige Anfrage. Anthropic schätzt etwa 25 % Ersparnis für typische tokenbasierte Aufgaben und bis zu rund 45 % für intensive Agentenarbeit. Das sind arbeitsabhängige Schätzungen, keine Aborabatte. Erläuterung der Fable-Preise.
Ein nachvollziehbares Beispiel: 100.000 Eingabetokens ohne Cache plus 10.000 abrechenbare Ausgabetokens kosten 1,50 USD. Kommt die gesamte Eingabe aus dem Cache, kosten Lesen und Ausgabe 0,525 USD, ohne vorheriges Schreiben und Werkzeuge. 100.000 Tokens in einen Fünf-Minuten-Cache zu schreiben kostet 1,25 USD. Wiederverwendung muss tatsächlich stattfinden; eine einzelne Anfrage hat nicht denselben Vorteil.
Messen Sie die Gesamtkosten je akzeptiertem Ergebnis einschließlich Wiederholungen und Prüfzeit. Eine günstige Antwort mit drei nötigen Überarbeitungen kann teuer werden; ein Premiummodell mit unnötiger Zusatzarbeit ebenso. Setzen Sie Ausgabenlimits und vergleichen Sie repräsentative Aufgaben, bevor Sie ein Standardmodell wählen.
Verbesserungen gegenüber Fable 5 und Migrationsrisiken
Der Nutzen liegt in ausdauernderer Arbeit, günstigerer Kontextwiederverwendung und präziseren Schutzmaßnahmen. Anthropic meldet ungefähr 60 % weniger Eingriffe der Cyber-Schutzmechanismen je Claude-Code-Sitzung gegenüber den bisherigen Fable-5-Schutzmaßnahmen, während das Finden von Schwachstellen im Quellcode möglich bleibt. Das ist keine Freigabe für uneingeschränkte Exploitentwicklung. Veröffentlichungsdetails.
Für API-Entwickler nennt der Neuerungen-Leitfaden Beta-Steuerungen für den Denkaufwand je Nachricht, auf einen Gesprächsschritt begrenzte Systemanweisungen, lesbare Fortschrittsmeldungen und Angaben zur Inhaltsherkunft. Das sind Integrationsfunktionen: Eine Drittanbieter-App muss sie zunächst umsetzen.
Es gibt auch inkompatible Änderungen. Erzwungene Werkzeugwahl mit tool_choice vom Typ „any“ oder „tool“ führt zu einem Fehler. Ältere Modelle können Denkblöcke von 5.1 nicht verarbeiten; Änderungen an früheren Nachrichten können aufbewahrte Denkschritte ungültig machen. Lesen Sie den Migrationsleitfaden und spielen Sie echte Abläufe mit Werkzeugen und Modellwechseln durch. Nur die Modell-ID zu ändern ist keine ausreichende Prüfung.
Mythos 5.1 erweitert die spezialisierten Forschungsfähigkeiten des Vorgängers, doch der Zugang bleibt die praktische Hürde. Bei normalem Schreiben, Analysieren oder Entwickeln geht es meist um Fable 5 versus 5.1 oder ein günstigeres Modell versus Fable, nicht um ein Privatkundenupgrade von Fable zu Mythos.
Offizielle Benchmarks: Wo liegen die Fortschritte?
Diese Auswahl stammt aus Anthropics Veröffentlichungstests. Es handelt sich um Herstellerangaben, nicht unsere eigenen Messergebnisse.
| Bewertung | Fable 5 | Fable 5.1 | Opus 5 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 24,7 % | 52,6 % | 29,0 % |
| Terminal-Bench 4.0 | 42,0 % | 55,8 % | 52,3 % |
| AutomationBench | 17,1 % | 31,4 % | 26,9 % |
| CursorBench 3.2.0 | 70,5 % | 73,4 % | 70,0 % |
Die Benchmarktabelle mit Methodikhinweisen zeigt bei einigen wissenschaftlichen und geschäftlichen Aufgaben größere Abstände als bei CursorBench. Sie beschreibt außerdem Schutzeingriffe und Ersatzmodelle. Die OSWorld-2.0-Ergebnisse verwenden die Aufgabenfassung vom August 2026; ein Vermischen mit älteren Werten ergäbe eine irreführende Rangliste. Hinweise zur Vergleichbarkeit.
Entscheidend ist, welche Fehler Sie reduzieren wollen. Beim Debuggen zählen reproduzierbare Defekte und geprüfte Reparaturen, in Berichten belegte Aussagen und fehlende Anforderungen, bei Agenten nötige menschliche Eingriffe. Eine allgemeine Intelligenzpunktzahl ersetzt diese Kriterien nicht und beweist keinen Sieg bei deutscher Prosa oder kreativem Geschmack.
Was Redaktionen und Nutzer tatsächlich erlebt haben
Manuskriptüberarbeitung: Amanda Caswell von Tom’s Guide beschrieb am 6. September einen Versuch mit ihrem eigenen Buch. Sie fand hilfreiche Strukturkritik und Überarbeitungen, die ihre Stimme respektierten, darunter ein übersehenes Kapitelproblem. Nicht alle Vorschläge wurden übernommen. Das spricht für einen Versuch als Lektoratshilfe, nicht für eine allgemeine Überlegenheit. Ihr Erfahrungsbericht.
Verständnis von Repositories: Ein Beitrag in r/claude vom 1. September berichtet, das Modell habe eine Berechnung durch ungefähr 40 Dateien verfolgt, statt anhand der Dateinamen zu raten. Trotz „den ganzen Tag“ im Titel beschreibt der Text nur wenige Stunden. Das ist eine im eigenen Repository überprüfbare Einzelbeobachtung, kein kontrollierter Vergleich. Originaldiskussion.
Hoher Kontingentverbrauch: In einem anderen r/ClaudeCode-Thread loben Nutzer die Fähigkeiten und berichten von schnell verbrauchten Max-Limits. Einer nennt ein Fünf-Stunden-Kontingent, das in etwa 30 Minuten aufgebraucht war; andere empfehlen weniger Denkaufwand. Unterschiedliche persönliche Aufgaben ergeben keine garantierten Limits oder reproduzierbaren Geschwindigkeitsmessungen. Nutzungsdiskussion.
Ein Gegenpol zur Begeisterung: Anthropics eigener Prompting-Leitfaden räumt ein, dass offene Funktionswünsche Zusatzänderungen oder überflüssige Tests auslösen können. Definieren Sie Ergebnis und Abschlusskriterium und lassen Sie sachfremde Entdeckungen getrennt melden. Das bleibt sinnvoll, ohne jede Erfolgsgeschichte der Startwoche zu glauben.
Öffentliche Erfahrungen sind für Fable deutlich umfangreicher als für Mythos. Fable-Eindrücke dürfen nicht als praktischer Mythos-Test ausgegeben werden. Wir haben weder einen repräsentativen deutschsprachigen Nutzerbenchmark noch einen unabhängigen Mythos-Direktvergleich etabliert.
Fable 5.1 gegen Opus 5, GPT-6 Astra und Gemini 3.8 Flash
Die Alternativen passen zu unterschiedlichen Budgets. Genannt sind Standardpreise der Text-API in USD je Million Eingabe-/Ausgabetokens, keine Chatabos. Kontext- und Werkzeuglimits gelten für das API-Produkt.
| Modell | Eingabe / Ausgabe | API-Kontext | Ein sinnvoller Auswahlgrund |
|---|---|---|---|
| Fable 5.1 | 10 / 50 USD | 1 Million | Schwieriges Schlussfolgern und lange Aufgaben mit teuren Korrekturen |
| Mythos 5.1 | Ab 10 / 50 USD | 1 Million | Genehmigte Spezialforschung; eingeschränkter Zugang |
| Opus 5 | 5 / 25 USD | 1 Million | Günstigere Claude-Basis für anspruchsvolle Arbeit |
| GPT-6 Astra | 10 / 50 USD zum Basistarif | 1,05 Millionen | Komplexe Arbeit mit OpenAI-Werkzeugen |
| Gemini 3.8 Flash | 0,75 / 3,75 USD zum Einführungspreis | Rund 1 Million | Knappes Budget und multimodale Eingaben |
Quellen: Fable, Opus, Astra, Gemini und Googles Preiszeiträume. Das ist ein Einkaufsvergleich, keine Behauptung gleicher Denkqualität.
Opus 5: eine günstigere Claude-Basis festlegen
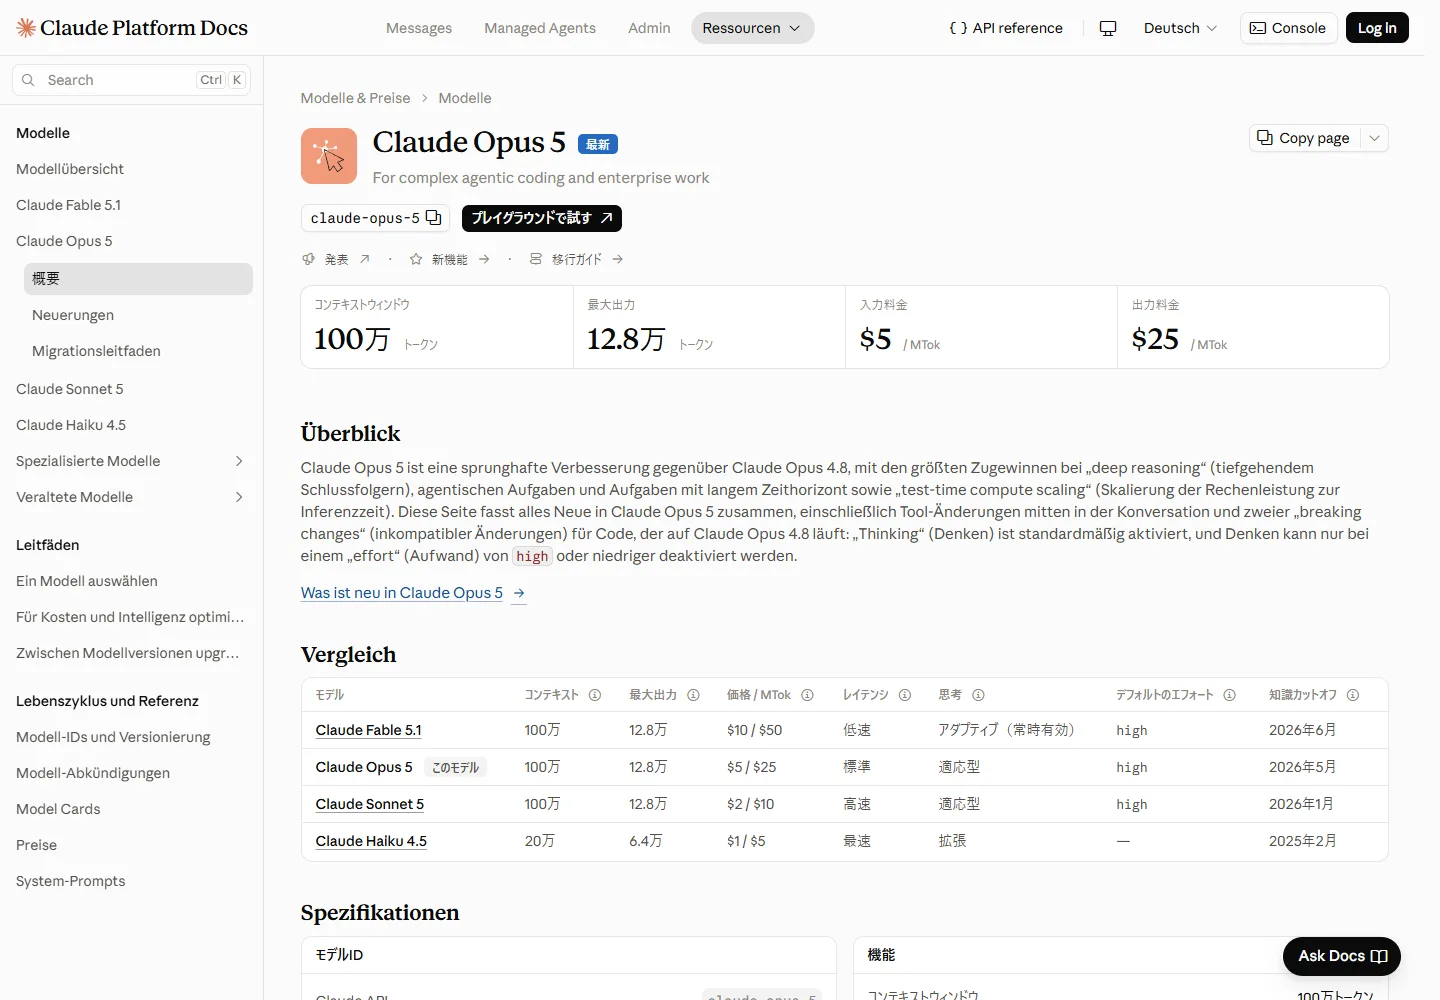
Opus 5 kostet bei Basiseingabe und -ausgabe die Hälfte von Fable und bietet dieselbe angekündigte Kontextgröße. Die Fable-Übersicht empfiehlt Opus als Ausgangspunkt für die meisten Aufgaben. Wenn bestehende Tests bereits bestehen, muss Fable seinen Mehrpreis durch weniger Korrekturen oder bessere Ergebnisse verdienen.
Vergleichen Sie beide an einer schwierigen, bekannten Aufgabe und bewerten Sie ohne sichtbaren Modellnamen. Halten Sie Anweisungen und Werkzeugzugriff vergleichbar. Braucht nur eine Stufe Fable, verwenden Sie es dort statt in der gesamten Verarbeitungskette.
GPT-6 Astra: den vollständigen Werkzeugablauf vergleichen
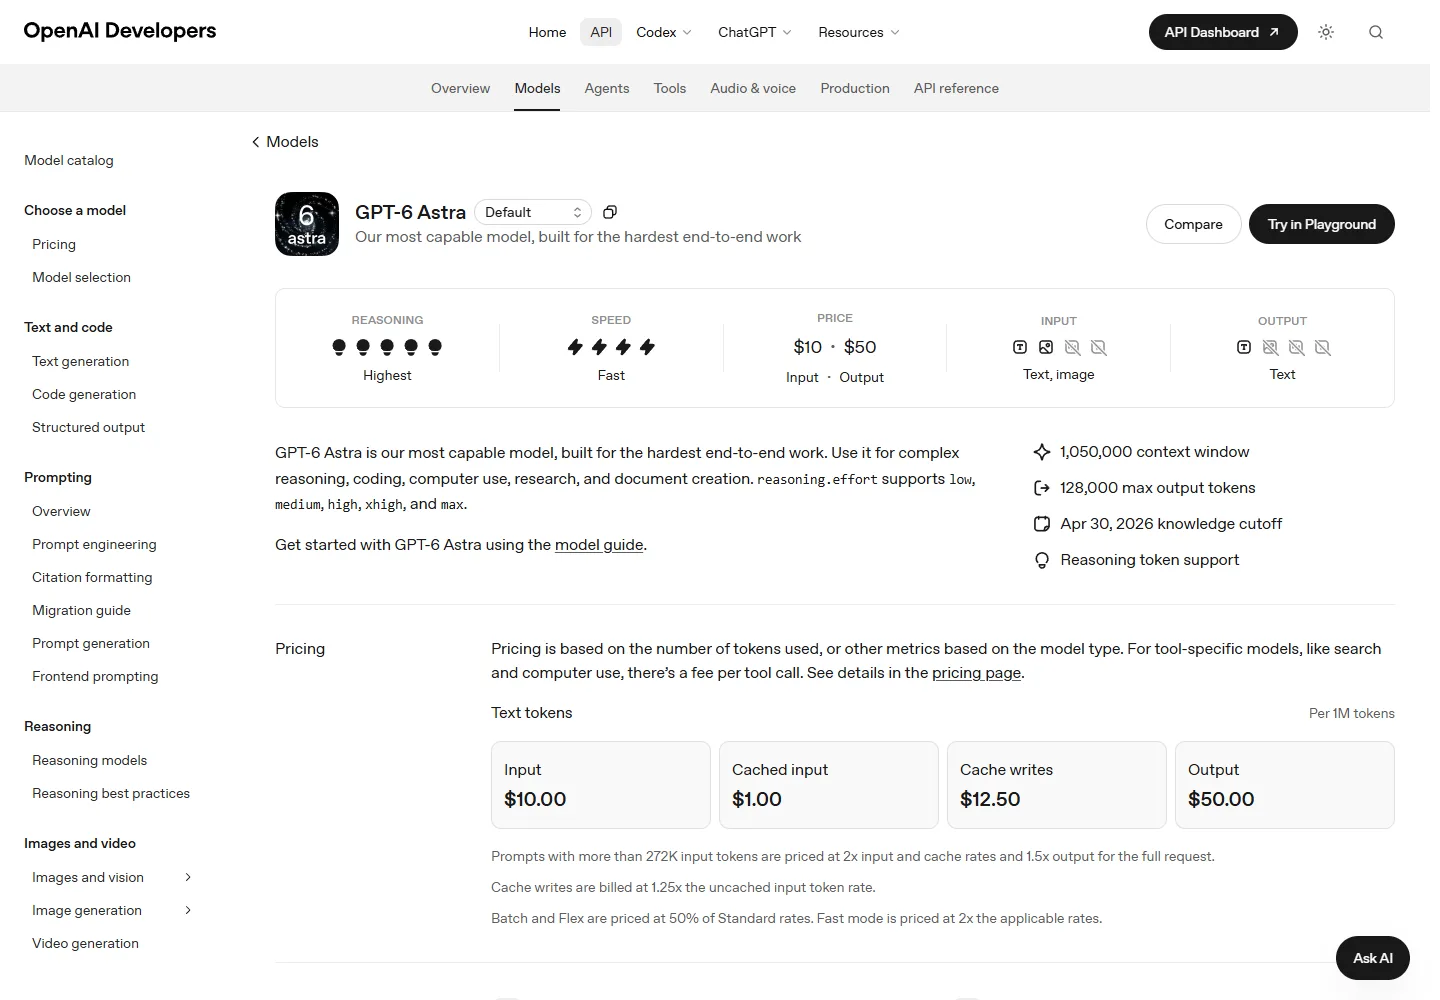
GPT-6 Astra richtet sich an komplexes Denken, Programmierung, Computernutzung, Recherche und Dokumenterstellung. Der Basispreis von 10/50 USD entspricht Fable; Cache-Eingaben kosten jedoch 1 USD je Million Tokens. Bei mehr als 272.000 Eingabetokens nennt OpenAI doppelte Eingabe-/Cache-Tarife und den 1,5-fachen Ausgabetarif für die gesamte Anfrage. Bei langen Kontexten zählt daher die tatsächliche Anfragengröße.
Bewerten Sie Ihre Arbeitsumgebung: Dateien, verbundene Werkzeuge, Prüfung und Durchsicht können wichtiger sein als kleine Punktedifferenzen. Offizielle Einstiege sind ChatGPT und die API-Plattform. Prüfen Sie vor einem Abo für eine konkrete Aufgabe die Modellberechtigung Ihres Kontos.
Gemini 3.8 Flash: günstiger, besonders bei Medienquellen
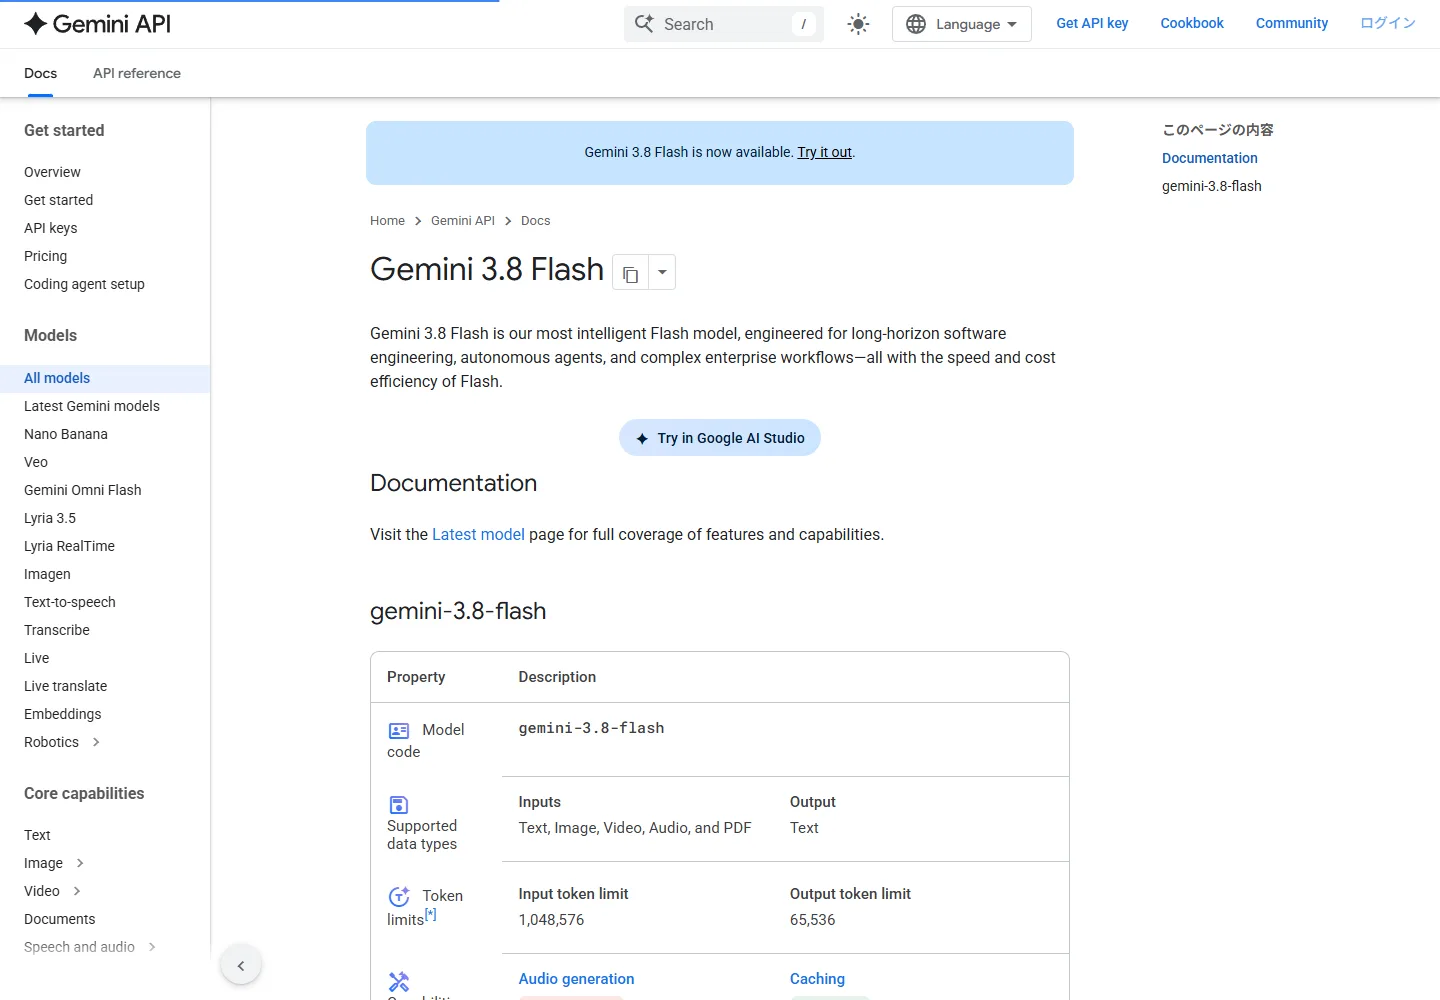
Gemini 3.8 Flash nimmt Text, Bilder, Video, Audio und PDFs entgegen und gibt Text aus. Ein Versuch lohnt sich, wenn Medienquellen für ein reines Text-/Bildmodell zunächst aufbereitet werden müssten. Einstiege sind Gemini und Google AI Studio.
Der Einführungspreis von 0,75/3,75 USD gilt bis 31. Dezember 2026; für den 1. Januar 2027 sind 1,50/7,50 USD angekündigt. Planen Sie bei einem dauerhaften Dienst auch den späteren Preis ein. Vergleichen Sie akzeptierte Ergebnisse und den gesamten Tokenverbrauch, statt Flash pauschal das bessere Preis-Leistungs-Verhältnis zuzuschreiben. Offizielle Veröffentlichung und Preise.
NSFW: Mythos ist kein unzensiertes Erwachsenenmodell
Explizite sexuelle Geschichten, erotische Chats und Fetischinhalte werden weder von Fable noch von Mythos offiziell unterstützt. Anthropics Nutzungsrichtlinie untersagt diese Zwecke. Die großzügigeren Mythos-Schutzmaßnahmen betreffen genehmigte Cyber- und biowissenschaftliche Arbeit, keinen öffentlichen Erwachsenenmodus.
NSFW umfasst unterschiedliche Inhalte. Nicht explizite Beziehungstexte, Aufklärung und verstörende fiktionale Themen sind nicht mit erotischer Generierung gleichzusetzen. Die Zulässigkeit hängt von Inhalt und Kontext ab. Testen Sie die konkrete Überarbeitung innerhalb der Richtlinien; ein Thema besprechen zu können bedeutet nicht, jede Szene zu erzeugen.
Eine Drittanbieteroberfläche belegt keine Genehmigung durch Anthropic. Auch der Screenshot einer einzelnen Antwort beweist keine stabile oder offiziell unterstützte NSFW-Fähigkeit. Ist explizite Erwachsenengenerierung Ihre Hauptanforderung, wählen Sie diese Modellfamilie nicht aufgrund angeblich versteckter Mythos-Einstellungen.
Empfohlene Einsätze und ein sinnvoller erster Versuch
Codewartung: Geben Sie einen fehlschlagenden Fall, Repository-Kontext und Abnahmekriterien vor. Verlangen Sie Ursache, notwendige Korrektur und Prüfung. Bewerten Sie den Patch statt den selbstsicheren Erklärungston. Unser englischer Einstiegsguide zu Claude Code erklärt den Start.
Lektorat und Übersetzungsprüfung: Liefern Sie Manuskript, Terminologie und Zielgruppe. Fordern Sie vor dem Umschreiben eine priorisierte Änderungsliste. Prüfen Sie im Deutschen Du/Sie, Satzbau, Bezüge, Figurenstimmen und wörtlich übersetzte Wendungen. Vergleichen Sie mit einer menschlich freigegebenen Passage; die Startbenchmarks messen diese Eigenschaften nicht.
Recherche und Geschäftsdokumente: Verlangen Sie eine Zuordnung von Behauptungen zu Quellen, offene Fragen und klare Lieferanforderungen. Bei Tabellenkalkulationen gehören Formeln und abgestimmte Summen dazu, bei Präsentationen die Prüfung des exportierten Layouts ebenso wie der Fakten.
Komplexe Agentenarbeit: Definieren Sie Budget, erlaubte Werkzeuge, Abschlussbedingungen und Prüfpunkte. Beginnen Sie mit dem geringsten Denkaufwand, der Ihren Versuch besteht, und erhöhen Sie ihn bei Bedarf. Der Leitfaden zu Kosten und Intelligenz empfiehlt ebenfalls Kosten je abgeschlossener Aufgabe statt allein je Token.
Ein anpassbares Beispiel: „Finde heraus, warum dieser Monatsbericht von der Quell-CSV abweicht. Liefere eine korrigierte Arbeitsmappe und eine kurze Erklärung. Behalte die Blattstruktur bei und zeige, wie die Summen übereinstimmen. Melde sachfremde Probleme separat und stoppe, bevor du die Datei an jemanden sendest.“ Das Ergebnis ist überprüfbar.
Häufige Fragen
Kann ich Fable 5.1 kostenlos nutzen?
Free enthält es nicht. Pro benötigt Fable-Nutzungsguthaben; berechtigte Max- und Premiumplätze enthalten einen begrenzten Anteil des Wochenkontingents. Prüfen Sie die genauen Regeln, nicht nur den Eintrag in der Modellauswahl.
Ist Mythos 5.1 intelligenter als Fable 5.1?
Anthropic beschreibt dasselbe zugrunde liegende Modell. Andere Schutzmaßnahmen und Berechtigungen können eingeschränkte Aufgaben beeinflussen. Das beweist nicht, dass Privatnutzer für Code oder Texte ein separates „intelligenteres“ Mythos-Abo suchen sollten.
Wird die API nach dem Upgrade 75 % günstiger?
Nur Cache-Lesen sinkt von 1 auf 0,25 USD je Million Tokens. Basiseingabe und Ausgabe bleiben unverändert. Rechnen Sie mit Cache-Treffern, Schreibvorgängen, Denk-/Ausgabetokens, Wiederholungen und Werkzeugen, bevor Sie Einsparungen erwarten.
Bedeutet eine Million Kontext, dass beliebige Dateien in den Chat passen?
Nein. Der Wert beschreibt die API-Kapazität. Die App hat eigene Kontext-, Upload- und Planlimits. Auch in der API zählen Anfragegröße und unterstützte Dateiverarbeitung. Prüfen Sie ein repräsentatives Dokument, bevor Sie den Ablauf auf das Maximum auslegen.
Ist Fable 5.1 die beste Wahl für deutsche Texte?
Ein Vergleich bei umfangreichem Lektorat und Dokumenten lohnt sich, aber wir haben keinen Sieg in einem kontrollierten deutschen Schreibbenchmark belegt. Nutzen Sie dieselbe Passage, dasselbe Glossar und denselben Ton und lassen Sie Genauigkeit und Natürlichkeit fachkundig beurteilen.
Sollte eine Fable-5-Integration sofort umgestellt werden?
Testen Sie zuerst. Erzwungene Werkzeugwahl und aufbewahrtes Denken ändern sich. Spielen Sie Gespräche, Modellwechsel und Wiederholungswege aus dem Migrationsleitfaden durch und vergleichen Sie Qualität und Kosten vor der Produktionsumstellung.
Unser Urteil: für weniger gescheiterte Aufgaben bezahlen
Fable 5.1 gehört auf die Auswahlliste für anspruchsvolle Code- und Wissensarbeit, besonders bei oft wiederverwendetem großen Kontext oder viel Nacharbeit an schwächeren Antworten. Offizielle Verbesserungen und erste Schreib- und Codeerfahrungen rechtfertigen einen ernsthaften Versuch, aber kein bedingungsloses Prädikat „bestes Modell“.
Starten Sie mit einer bewertbaren Aufgabe. Vergleichen Sie Opus, Astra oder Gemini bei realistischem Budget und behalten Sie Fable dort, wo sein Vorteil standhält. Mythos betrifft zugelassene Spezialorganisationen. Für alle anderen zählen das reale Fable-Kontingent, Kosten je akzeptiertem Ergebnis und die Einbindung in vorhandene Werkzeuge.
Verwandte Bewertungen
Hy4 Preview Test: Tencent Hunyuan 770B MoE, 1M Kontext, API, lokale Hardware und NSFW-Grenzen

Gemini Omni 1.1 Flash Test: Googles Video-KI, 4K, API und NSFW-Grenzen

HiDream O1 Test: Bild-KI, LoRA, lokales Setup und NSFW-Richtlinie
Best 8 Online Course Platforms in 2026
Die 5 besten Visitenkarten-Programme 2026
YuE2-3B: Lokale KI-Musik, Suno und ComfyUI