Die besten lokalen Open-Source-LLMs 2026: Leistung, NSFW und Hardware im Vergleich
Das beste lokale LLM ist längst nicht mehr zwingend das Modell mit den meisten Parametern. Im Jahr 2026 stellt sich eine konkretere Frage: Welches Open-Source-…
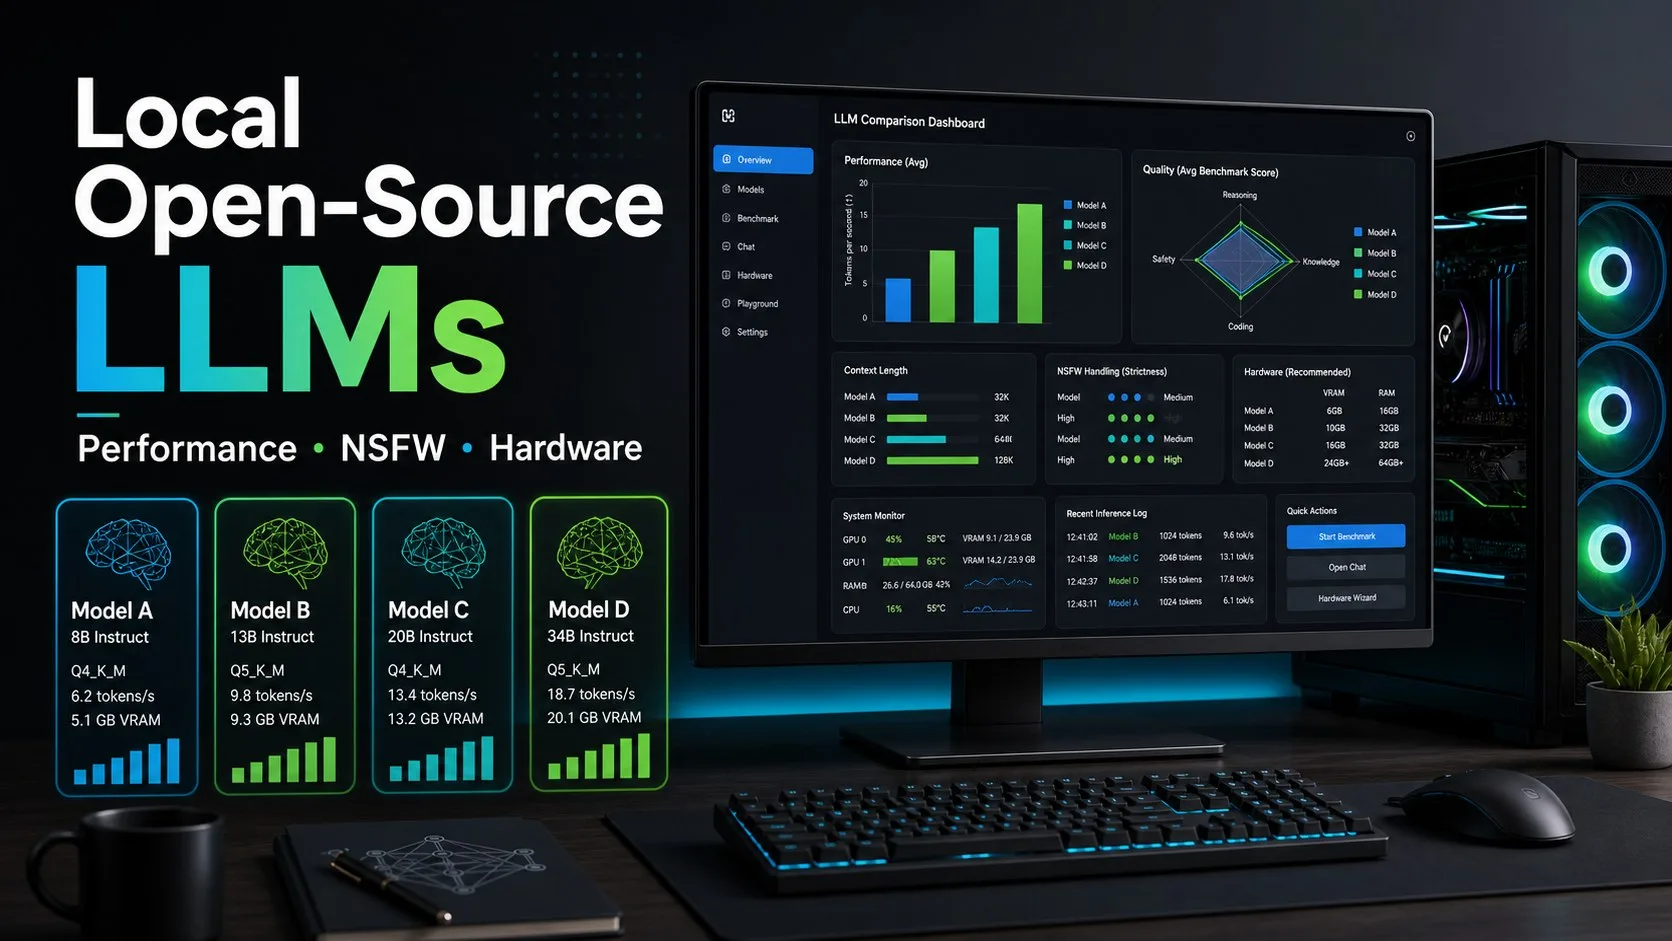

Das beste lokale LLM ist längst nicht mehr zwingend das Modell mit den meisten Parametern. Im Jahr 2026 stellt sich eine konkretere Frage: Welches Open-Source- oder Open-Weight-Modell bietet die optimale Balance aus Qualität, NSFW-Flexibilität, Hardwarekosten, Lizenzierung und lokaler Kontrolle?
Für die meisten Anwender fällt die praktische engere Auswahl überschaubar aus. Wählen Sie Qwen 3.8 für mehrsprachige Aufgaben, Programmierung und RAG; Gemma 4, wenn Sie ein Google-Modell mit offenen Gewichten und solider Dokumentation bevorzugen; Dolphin 3.0 bei hohen Anforderungen an NSFW-Flexibilität und Rollenspiele mit geringer Verweigerungsrate; sowie DeepSeek V4, wenn Sie Workloads mit langem Kontext, agentenbasierte Abläufe oder den unternehmenskorsettübergreifenden Einsatz anstelle eines normalen Desktop-Chat-Modells evaluieren.
Inhalt
Schnellempfehlung
| Anwendungsfall | Empfehlung | Grund |
|---|---|---|
| Bestes lokales Allround-LLM für Mehrsprachigkeit & Programmierung | Qwen 3.8 27B | Starkes mehrsprachiges Verhalten, Programmierfähigkeiten, Tool-Nutzung und ein praktischer 27B-Pfad für ambitionierte lokale Anwender. |
| Google-Ökosystem und klarere Sicherheitsdokumentation | Gemma 4 | Gute Modellkarte, offizielle Dokumentation, mehrere Größen und eine sicherere offizielle Ausrichtung. |
| NSFW, Rollenspiele und schreibende Aufgaben mit wenigen Verweigerungen | Dolphin 3.0 | Klassische, unzensierte Fine-Tune-Reihe für präzise System-Prompt-Kontrolle und weniger Blockaden. |
| Langer Kontext / Enterprise-Scale-Auswertung | DeepSeek V4 | Offene Gewichte, Ausrichtung auf Millionen-Token-Kontext sowie Pro/Flash-Optionen, allerdings mit hohem Hardwarebedarf. |
| Größtes Ökosystem an Feinabstimmungen (Fine-Tunes) | Llama 4 / Llama-Familie | Enorme Community, GGUF-Varianten sowie Ableitungen für Rollenspiele und unzensierte Inhalte. |
| Open-Weight-MoE für dedizierte Server | Mistral Large 3 | Starke europäische Open-Weight-Option, allerdings weit jenseits herkömmlicher Heim-Desktops. |
| Fokus auf KI-Agenten und Tool-Nutzung | Kimi K2 / Kimi K2 Thinking | Interessant für Coding-Agenten und Tool-Workflows, weniger auf NSFW ausgelegt. |
| Langer Kontext für Programmierung und Agenten-Workflows | GLM-4.6 | Gute Alternative, wenn 200K Kontext und agentenbasiertes Coden wichtiger sind als unzensiertes Verhalten. |
Leistung
Benchmarks sind nützlich, doch die Auswahl eines lokalen LLMs sollte stets beim konkreten Workload beginnen. Programmierung, japanische, chinesische und englische Texterstellung, RAG mit langem Kontext, Rollenspiele sowie Agenten-Workflows bewerten dasselbe Modell oft unterschiedlich. Ein kleineres Modell mit gelungener Quantisierung kann ein größeres Modell schlagen, sofern es nahtlos auf die GPU passt und schneller reagiert.
Öffentliche Bestenlisten wie Artificial Analysis und LMArena bieten zwar einen guten groben Anhaltspunkt, ersetzen jedoch keine praktischen Praxistests auf der eigenen Hardware. Beispielsweise kann ein in allgemeinem Chat starkes Modell bei privaten Dokumenten, Funktionsaufrufen (Tool Calls), der japanischen Tonfallsteuerung oder kreativen NSFW-Texten schwächeln.
| Modell | Leistungsprofil | Hauptkompromiss |
|---|---|---|
| Qwen 3.8 | Ausgewogene Wahl für Mehrsprachigkeit, Programmierung und alltägliche lokale Aufgaben. | Offizielle Modelle sind nicht als unzensierte NSFW-Modelle konzipiert. |
| Gemma 4 | Gut dokumentierte Open-Weight-Reihe mit Ausführungen in 12B, 26B und 31B. | Wirkt bisweilen stärker sicherheitsfokussiert und unflexibler als unzensierte Fine-Tunes. |
| Dolphin 3.0 | Starke Befolgung von System-Prompts, exzellente Schreib- und Rollenspielfähigkeiten. | Weniger auf reine Benchmarks optimiert; erfordert disziplinierten Umgang seitens des Nutzers. |
| DeepSeek V4 | Interessant für langen Kontext, Agenten und Bereitstellungen im Großbetrieb. | Kein komfortables Single-GPU-Desktop-Modell. |
| Llama 4 / Llama-Familie | Größtes Community-Ökosystem für Feinabstimmungen, GGUF-Builds und lokale Experimente. | Offizielle Versionen sind nicht primär auf NSFW ausgelegt; die Qualität hängt stark vom gewählten Fine-Tune ab. |
| Mistral Large 3 | Open-Weight-MoE-Modell mit enormem Leistungspotenzial für Server-Deployments. | Modelle der 675B-Klasse sind für den Heim-Desktop unpraktikabel. |
| Kimi K2 Thinking | Hervorragend geeignet für Coding-Agenten, Tool-Aufrufe und komplexe mehrstufige Aufgaben. | Eher auf Agenten als auf Rollenspiele oder NSFW ausgerichtet. |
| GLM-4.6 | Verbesserungen bei langem Kontext, Programmierung und Agenten, mit gut zugänglicher Open-Model-Distribution. | Im Westen weniger bekannt als Llama oder Qwen, aber für Coding-Workflows einen Test wert. |
NSFW und unzensiertes Verhalten
In puncto NSFW unterscheiden sich lokale LLMs am deutlichsten von Cloud-Assistenten. Gehostete Modelle beinhalten in der Regel plattformseitige Moderationen, während lokale Open-Weight-Modelle dem Besitzer die Wahl von Laufzeitumgebung, System-Prompt und zusätzlichen Filtern überlassen. Das bedeutet allerdings nicht, dass jedes lokale Modell uneingeschränkt frei agiert.
Dolphin 3.0 ist die eindeutigste NSFW-freundliche Option in dieser Gruppe. Es entstammt der klassischen Tradition unzensierter Feinabstimmungen und erfreut sich großer Beliebtheit bei privaten Rollenspielen, Fiktion, Erwachsenenliteratur sowie Experimenten mit Prompt-Steuerung. Seine Stärke liegt darin, dass es mehr Verantwortung an den Anwender überträgt.
Qwen 3.8 und Gemma 4 besitzen offiziell sicherheitsausgerichtete Veröffentlichungen, jedoch stellt die Community oftmals abliterierte oder unzensierte Derivate bereit. Diese können Verweigerungen reduzieren, stellen jedoch keine offiziellen Versionen dar und sollten als eigenständige Modelle mit separaten Vertrauens- und Lizenzprüfungen behandelt werden. DeepSeek V4 ist primär als Modell für langen Kontext und Agenten und weniger als NSFW-Modell zu betrachten.
Hardware- und VRAM-Anforderungen
Der häufigste Fehler im Bereich lokaler LLMs besteht darin, ein auf dem Papier überzeugendes Modell herunterzuladen, um anschließend festzustellen, dass es auf dem eigenen Rechner nur schleppend läuft. VRAM, Quantisierung, Kontextlänge und KV-Cache sind ebenso wichtig wie die reine Modellgröße.
| Hardware | Realistische Modelle | Hinweise |
|---|---|---|
| 8 GB bis 12 GB VRAM | 7B/8B GGUF, Dolphin 3.0 8B, kleinere Llama- und Mistral-Varianten | Gut geeignet für Chat- und Schreibtests, ungeeignet für umfangreiches RAG oder komplexe Agenten. |
| 16 GB VRAM | Modelle der 12B-Klasse, Q4/Q5 20B-27B mit Einschränkungen | Eine praxisnahe Enthusiasten-Stufe, sofern man einen kürzeren Kontext in Kauf nimmt. |
| 24 GB VRAM | Qwen 27B quantisiert, Gemma 31B/26B quantisiert, Dolphin 24B GGUF | Der ideale Sweet Spot für engagierte Privatanwender. |
| 48 GB bis 80 GB VRAM | Größere BF16-Modelle, langer Kontext, höherer Durchsatz | Optimal für Serving, RAG und den Mehrbenutzerbetrieb. |
| Multi-GPU / Server | DeepSeek V4 Pro/Flash, sehr große MoE-Modelle | Bereich für Unternehmen oder Forschung, ungeeignet für den gelegentlichen lokalen Chat. |
Modell-für-Modell-Übersicht
Qwen 3.8: Die beste ausgewogene lokale Wahl
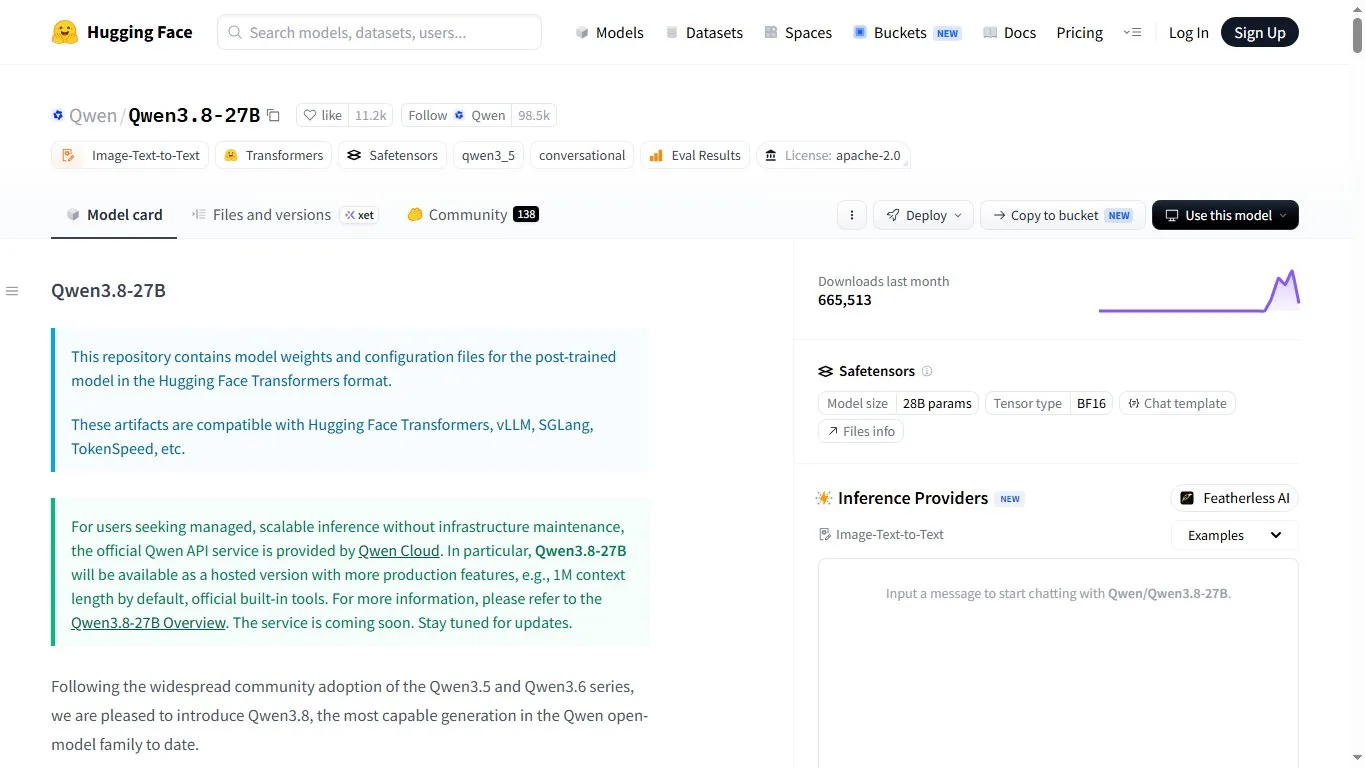
Qwen 3.8 ist die Modellfamilie, mit der ich für mehrsprachige Aufgaben, Programmierarbeiten, RAG und tägliche lokale Assistenzaufgaben beginnen würde. Der 27B-Zweig erweist sich als deutlich realistischer als die gigantische Max-Klasse und bietet dennoch spürbar mehr Leistungsfähigkeit als kleine 7B- oder 8B-Modelle.
Seine Schwachstelle liegt weniger in der Qualität als im Einsatzzweck. Offizielle Qwen-Modelle sind nicht als unzensierte NSFW-Modelle konzipiert. Sollte Ihr Hauptziel in einer geringeren Anzahl von Verweigerungen für erotische Rollenspiele liegen, ist Qwen nicht die erste Wahl – es sei denn, Sie wählen und testen gezielt eine von der Community abliterierte Version.
Gemma 4: Beste Dokumentation und Google-Ökosystem
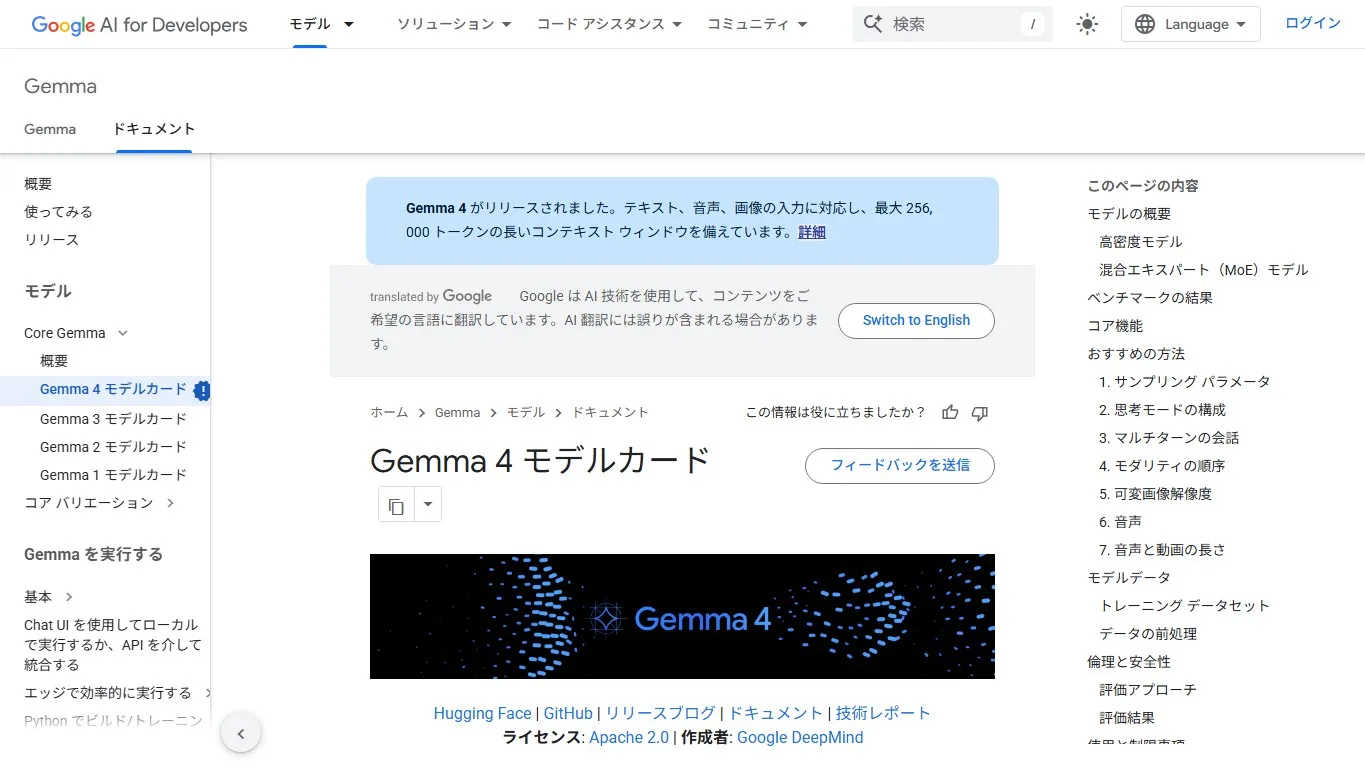
Gemma 4 ist attraktiv, wenn Sie offene Gewichte, offizielle Dokumentation und eine saubere Modellfamilie suchen. Die 12B-Version bildet den einfachsten Einstieg, während 26B-A4B und 31B ernsthafte Qualitätsziele für leistungsstärkere Hardware darstellen.
In der offiziellen Form ist Gemma 4 in Bezug auf NSFW eher konservativ ausgerichtet. Die Existenz unzensierter beziehungsweise abliterierter Community-Modelle macht das Ökosystem zwar interessant, diese sollten jedoch nicht mit der offiziellen Ausrichtung oder Sicherheitsphilosophie von Google verwechselt werden.
Dolphin 3.0: Am besten für unzensiertes NSFW und Rollenspiele
Dolphin 3.0 bleibt die eindeutigste Empfehlung, wenn die Suchabsicht unzensierte Inhalte, NSFW, Rollenspiele oder Texte mit geringer Verweigerungsrate umfasst. Es strebt nicht danach, der sicherheitskonformste allgemeine Assistent zu sein; stattdessen fungiert es als steuerbares lokales Modell, bei dem der Systembesitzer das Verhalten bestimmt.
Beginnen Sie mit der 8B- oder GGUF-Variante, falls Sie einen normalen Desktop nutzen. Wechseln Sie zu Mistral 24B, wenn Sie von verbesserten Schreib- und Argumentationsfähigkeiten profitieren möchten und die Hardwarekosten tragen können. Für öffentliche Bereitstellungen empfiehlt sich die Ergänzung eigener Moderations- und Nutzungsregeln.
DeepSeek V4: Leistungsstark, aber schwerfällig im Betrieb
DeepSeek V4 ist technisch beeindruckend und verdient Beachtung, insbesondere bei Aufgaben mit langem Kontext, Agenten-Workflows und serverbasierten Anwendungen. Die Aufteilung in Pro und Flash erweist sich als nützlich, da Teams so zwischen höherer Ausgabequalität und günstigerem Durchsatz abwägen können.
Für den durchschnittlichen lokalen Anwender liegt das Problem in der Hardware. DeepSeek V4 ist keine empfehlenswerte Lösung für ein einzelnes GPU-System. Es eignet sich besser für Teams, die vLLM- oder SGLang-konforme Infrastrukturen betreiben, Kosten kontrollieren und das Modell an einem echten Workload messen können.
Llama 4 und Llama-Fine-Tunes: Das beste Ökosystem
An der Llama-Familie führt nach wie vor kein Weg vorbei. Llama 4 Scout und Maverick haben Metas Open-Model-Linie weiter in Richtung Multimodalität und MoE geführt, während das umfassende Llama-Ökosystem die unkomplizierteste Anlaufstelle für GGUF-Builds, Rollenspiel-Fine-Tunes, Coding-Varianten und Installationsanleitungen bleibt.
Der Nachteil besteht darin, dass Llama nicht nur ein einzelnes Modell darstellt. Ein offizielles Vanilla-Release, ein Coding-Fine-Tune, eine Rollenspiel-Anpassung und ein unzensiertes Derivat können sich völlig unterschiedlich verhalten. Wer maximale Auswahl sucht, findet in Llama eine exzellente Basis. Wer hingegen eine klare, unkomplizierte Empfehlung wünscht, fährt mit Qwen oder Gemma oft übersichtlicher.
Mistral Large 3: Open Weights für anspruchsvolle Infrastrukturen
Mistral Large 3 verdient Erwähnung, da es eine andere Art von lokalem beziehungsweise Open-Weight-Anspruch repräsentiert. Es handelt sich um ein großes MoE-Modell für Open-Deployments auf Spitzenniveau, das deutlich höhere Anforderungen an die Infrastruktur stellt als ein 12B- oder 27B-Desktop-Modell.
Für Privatanwender ist Mistral Large 3 selten der erste lokale Download. Für Teams mit Server-GPUs gehört es jedoch neben DeepSeek V4 und anderen großen MoE-Modellen in die engere Auswahl. Sein NSFW-Verhalten sollte anhand des konkreten Instruct-Checkpoints, der Provider-Schicht und der Bereitstellungsrichtlinie bewertet werden, nicht allein anhand des Modellnamens.
Kimi K2: Spezialist für Agenten und Tool-Nutzung
Kimi K2 Thinking ist für Anwender interessant, die Wert auf Tool-Nutzung, Coding-Agenten und lange, mehrstufige Abläufe legen. Für einfache Desktop-Chats ist es nicht die naheliegende Wahl, entfaltet jedoch Stärken beim Aufbau von Agentensystemen oder der Auswertung komplexer Task-Ausführungen.
Im Vergleich zu Dolphin fungiert Kimi nicht primär als unzensiertes Rollenspielmodell. Verglichen mit Qwen positioniert es sich eher als spezialisierter Agenten- und Programmierkandidat. Wer Coding-Agenten, Browser-Automatisierungen oder Workflow-Prozesse entwickelt, sollte diesem Modell einen separaten Test widmen, anstatt es hinter allgemeinen Chat-Punktzahlen zu verstecken.
GLM-4.6: Kandidat für langen Kontext und Programmierung
GLM-4.6 stellt eine weitere Modellreihe dar, die in einen fundierten Vergleich für das Jahr 2026 gehört. Viele westliche Leser sind damit zwar weniger vertraut als mit Llama oder Mistral, doch das Modell ist hochrelevant für Workloads mit langem Kontext, Programmierung und Agenten – insbesondere für Nutzer, die chinesische Open-Model-Ökosysteme vergleichen.
Seine praktische Rolle ähnelt in gewisser Weise Kimi und Qwen: Testen Sie es anhand Ihrer eigenen Programmier-, Mehrsprachigkeits- und Dokumentenaufgaben. Wählen Sie es nicht allein aufgrund guter Bestenlisten-Platzierungen, sondern dann, wenn es Ihre tatsächliche Kontextlänge, Funktionsaufrufe und lokale Serving-Architektur besser bewältigt als Alternativen.
Auswahlhilfe
- Beginnen Sie mit Ihrer konkreten Aufgabe: Programmierung, Schreiben, RAG, Rollenspiele, lange Dokumente oder Agenten.
- Wählen Sie das größte Modell, das auf Ihrer Hardware noch schnell genug läuft, und nicht das absolut größte Modell, das sich rein technisch laden lässt.
- Nutzen Sie GGUF oder 4-Bit-Quantisierung für Desktop-Tests und wechseln Sie erst bei Bedarf zu BF16 oder Server-Deployments.
- Testen Sie für NSFW- oder kreative Arbeiten mit geringen Verweigerungen Modelle im Dolphin- und Llama-Fine-Tune-Stil separat von offiziell sicherheitsausgerichteten Modellen.
- Überprüfen Sie für geschäftliche Anwendungen die exakte Lizenz, die Basismodell-Bedingungen und die Frage, ob Community-Fine-Tunes zulässig sind.
FAQ
Was ist insgesamt das beste lokale Open-Source-LLM?
Für die meisten ambitionierten lokalen Anwender ist Qwen 3.8 27B der ausgewogenste Startpunkt. Es bietet starke mehrsprachige Fähigkeiten, Programmierleistung und praktische lokale Bereitstellungsoptionen. Liegt Ihr Schwerpunkt auf NSFW-Rollenspielen, stellt Dolphin 3.0 die passendere Wahl dar.
Welches Modell sollte ich auf einer RTX 4090 mit 24 GB VRAM ausführen?
Nutzen Sie Qwen 27B, Gemma 31B/26B, Dolphin 24B oder vergleichbare Modelle in quantisierter Form. Wenn Sie eine flüssigere Geschwindigkeit und einen längeren Kontext wünschen, empfiehlt sich der Schritt auf 12B oder 8B. Ein reibungslos laufendes Modell erweist sich im Alltag meist als nützlicher als eines, das gerade so an der Kapazitätsgrenze kratzt.
Sind Open-Source-LLMs sicher für die geschäftliche Nutzung?
Das können sie sein – allerdings erst nach sorgfältiger Lizenzprüfung, Datenschutzkonzeption, Protokollierungsentscheidungen und Ausgabekontrolle. Offene Gewichte lösen Compliance-Fragen nicht automatisch. Bei sensiblen Dokumenten erhöht ein lokales Deployment zwar den Datenschutz, dennoch ist im Team eine entsprechende Governance erforderlich.
Welches lokale LLM eignet sich am besten für NSFW?
Dolphin 3.0 ist unter den hier besprochenen Modellen die eindeutigste Empfehlung. Qwen und Gemma bieten zwar von der Community unzensierte Varianten, doch ihre offiziellen Versionen sind keine primären NSFW-Modelle.
Sollte ich Ollama, LM Studio, vLLM oder SGLang verwenden?
Ollama und LM Studio sind am einfachsten für Desktop-Tests geeignet. vLLM und SGLang-basierte Bereitstellungen bieten hingegen Vorteile für API-Server, Batch-Verarbeitung, Experimente mit langem Kontext und den Team-Einsatz.
Fazit
Das universell beste lokale Open-Source-LLM für jeden Anwendungsfall existiert nicht. Qwen 3.8 ist der beste praktische Allrounder, Gemma 4 repräsentiert die sauberste Google-gestützte Open-Weight-Reihe, Dolphin 3.0 ist die stärkste Option für unzensierte NSFW-Inhalte und Rollenspiele, während DeepSeek V4 und Mistral Large 3 ernstzunehmende Server-Lösungen darstellen und Llama, Kimi sowie GLM zusätzliches Ökosystem, Agenten- und Kontext-Tiefe beisteuern.
Der klügste Weg ist unspektakulär, aber verlässlich: Beginnen Sie mit einem quantisierten Modell, das zu Ihrer GPU passt, testen Sie es mit Ihren realen Prompts, vergleichen Sie das Verweigerungsverhalten, die Kontextstabilität sowie die Latenz, und wechseln Sie erst dann zu größeren Modellen, wenn das kleinere Modell erkennbar an seine Grenzen stößt. Lokale KI wird genau dann spannend, wenn sie schnell genug arbeitet, um sie täglich zu nutzen.
Quellen
Verwandte Bewertungen
NoobAI XL Review: VRAM, LoRA, V-Pred, Prompts und NSFW-Nokale Nutzung

Llama 4 Test: Scout, Maverick, Behemoth, lokale Nutzung und NSFW-Politik

Beste lokale Anime-KI-Bildmodelle im Vergleich: LoRA, VRAM und NSFW-Nutzung
FLUX 3 im Test: Video, Bild, Open Weights und NSFW-Richtlinie
Grok 4.6 Review: Reasoning, Agenten, Preis und NSFW-Richtlinie
Nucleus Image Review: 17B Sparse MoE, lokales Setup, NSFW-Unterstützung und Apache-2.0-Open-Weights