Anima 模型評測|base v1.0、Turbo 與 Aesthetic 版本特色解析
Anima 是 CircleStone Labs 與 Comfy Org 合作推出的 anime 圖像生成模型。本文以台灣繁體中文整理 base v1.0、Turbo、Aesthetic 版本差異、ComfyUI 使用感、Civitai 派生模型與非商用授權注意事項。


Anima 是 CircleStone Labs 與 Comfy Org 合作推出的 2B 參數級 text-to-image 圖像生成模型,主打 anime、插畫與非寫實藝術表現。和一般「打開網頁就能用」的線上產圖服務不同,Anima 更偏向給熟悉本機模型、ComfyUI、LoRA 與派生 checkpoint 的使用者測試與深度調整。
結論先說:如果你想在本機或 ComfyUI 裡深入製作動漫風格插畫,Anima 是 2026 年值得關注的新模型之一。base v1.0 的彈性、Turbo 的高速性、Aesthetic 版本的初始畫面品質,以及 Civitai 社群正在增加的 LoRA 與派生模型,都是它的亮點。
不過,Anima 並不是寫實照片模型,也不是商用條件完全自由的模型。官方模型卡標示 CircleStone Labs Non-Commercial License,模型與派生模型的使用需要留意非商用條件;至於生成圖片本身的使用方式,也應以官方授權說明為準。本文會以台灣繁體中文整理 anima-base-v1.0、Turbo/Aesthetic 版本差異、實際使用感、Civitai 派生資源與推薦設定。
目錄
Anima 最新動態:Turbo-v1.1 與社群衍生模型
截至 2026 年 8 月下旬,目前能確認的 Anima 最新官方更新是 Anima Turbo-v1.1。CircleStone Labs 在 2026 年 8 月 24 日前後於 Civitai 更新 Turbo 系列,重訓了大部分蒸餾與風格調整元件。實際效果上,Turbo-v1.1 的畫面較不容易顯得平面,細節更豐富,對畫師風格的反映也比早期 Turbo 版本更好。
| 官方 Anima 系列 | 定位 | 適合用途 |
|---|---|---|
| Anima-Base | 預訓練基礎版,保留最大彈性。 | LoRA 訓練、微調、需要多樣風格的工作流。 |
| Anima-Aesthetic | 經過美學微調,預設畫質更穩定。 | 一般圖像生成、想要更穩定第一張成品的使用者。 |
| Anima-Turbo | 蒸餾加速版。官方建議 CFG 1、約 8–12 steps。 | 快速試 prompt、線上生成成本敏感的情境。 |
Anima-Base v1.0 正式版是在 Preview 1–3 之後,於 2026 年 5 月 15 日公開。之後官方主要動態集中在 Turbo/Aesthetic 迭代與官方 LoRA;同時,社群衍生模型也變得非常活躍。
社群方面,Anima-2.9B 值得留意,但它不是 CircleStone Labs 官方版本。它是把原本 28 層架構擴展到 40 層的社群版本,另外訓練約 170 萬張動畫與插畫資料,知識截止時間標示到 2026 年 7 月。Anima-3.8B 這類實驗性擴展,以及 AnimaIka 這類合併模型也在持續出現,但建議和官方 Base/Aesthetic/Turbo 系列分開評估。
Anima-Ref-Adapter v2:用參考圖保留角色外貌
Anima-Ref-Adapter 讓你不必先訓練角色 LoRA,就能依一張參考圖製作新場景。臉、髮型與服裝等外貌取自圖片,動作、表情、背景和構圖則由提示詞控制,尤其適合模型不認識名字的原創角色。但它保留的是可辨識的特徵,並非逐像素複製設定稿,也不保證每件配飾都能留下。
這是 ElectronGirl/ArcAnima 的獨立專案,並非 CircleStone Labs 官方產品或背書功能。它需要專用 ComfyUI 節點與適配器權重,不能只把 .safetensors 丟進一般 LoRA 載入器。v2 使用 rank 64,將參考特徵每張圖計算一次並快取,減少各採樣步驟的重複工作。
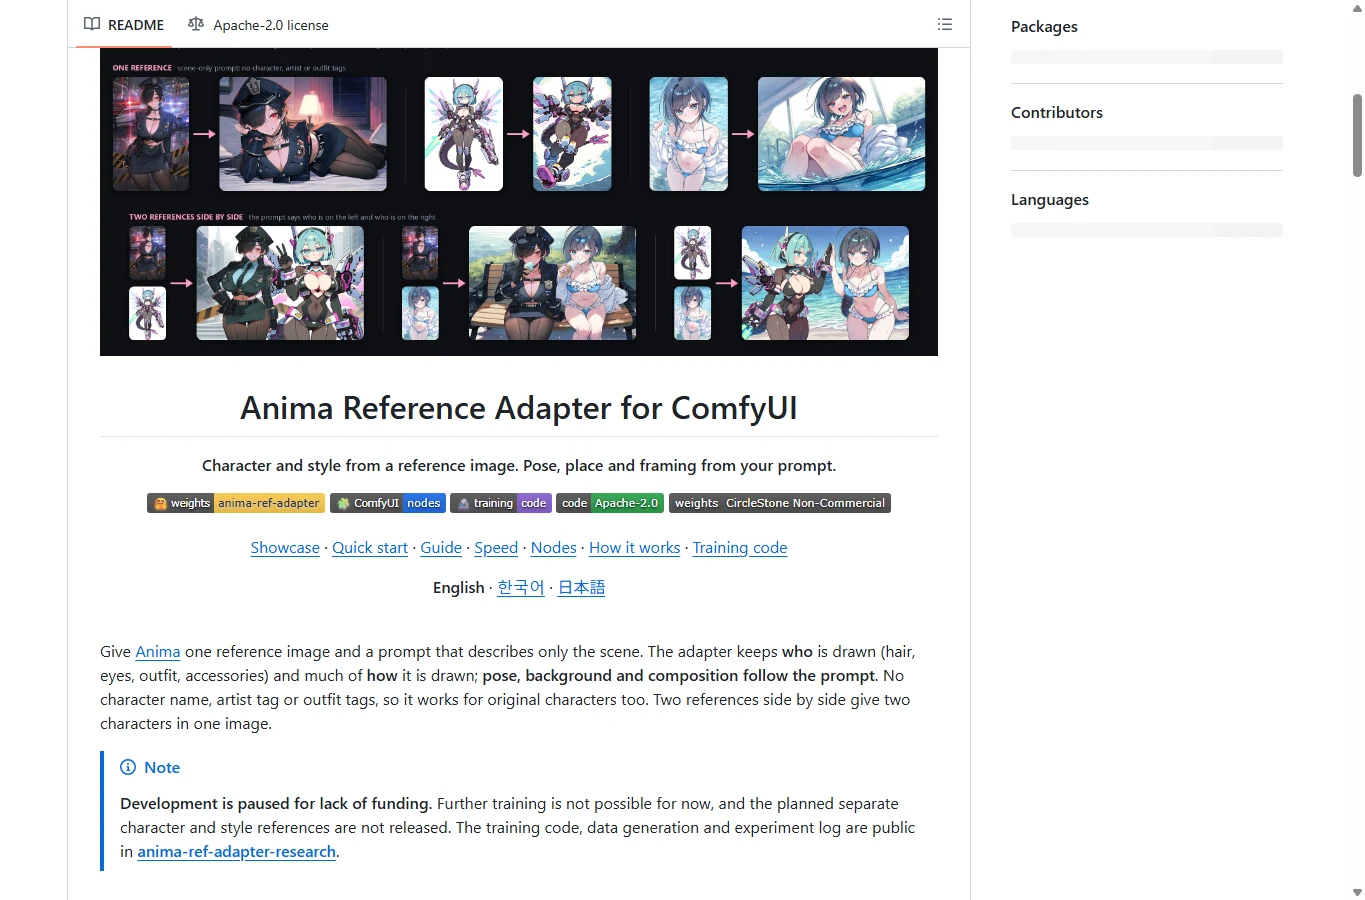
安裝與第一次生成
先確認 ComfyUI 能正常使用 Anima Base v1.0 生成。基準配置的模型檔案與位置如下:
ComfyUI/models/diffusion_models/anima-base-v1.0.safetensors
ComfyUI/models/text_encoders/qwen_3_06b_base.safetensors
ComfyUI/models/vae/qwen_image_vae.safetensors- 用下列命令將專案放入 ComfyUI/custom_nodes,再重新啟動 ComfyUI;也可下載專案 ZIP 並解壓至該資料夾。基本工作流程不需要其他自訂節點套件。
- 將專案內 workflows/anima_ref_adapter.json 拖入畫布,選擇上述 Base、文字編碼器與 VAE,在 Load Image 載入參考圖。
- 在 Anima Ref Adapter 選 anima_ref_adapter_v2_r64.safetensors。首次執行會下載約 183 MB 權重至 ComfyUI/models/loras/,之後重用。不要將初次下載時間計入生成效能。
- 先用 er_sde 或 Euler、simple、30 steps、KSampler CFG 4.5;節點設定 ref_guidance 4.5、correction apg、strength 1.0、ref_end 1.0、ref_megapixels 1.0。不疊加其他適配器,先測一張。
- 整合既有流程時,順序為 MODEL → 一般畫風/細節 LoRA → Anima Ref Adapter → 採樣器 MODEL。將參考 IMAGE 與 VAE 接入適配器,文字條件照常送入採樣器;這不等同於 img2img 的 denoise 強度控制。
cd ComfyUI/custom_nodes
git clone https://github.com/ArcAnima/ComfyUI-Anima-Ref-Adapter.git
選參考圖及撰寫場景提示詞
- 選臉、髮型及重要衣服清楚的單一角色圖。若要求鞋子或下半身服裝一致,全身圖通常比大頭照更有資訊;沒有拍到的背面、腿部與配飾只能由模型推測。
- 起步時用乾淨參考圖搭配場景提示詞。無須角色名、畫師標籤與整串服裝描述;矛盾的外貌標籤可能與參考競爭。雙角色需要辨識左右時,簡短特徵描述仍有用。
- 明確要求不同的姿勢與景別。評估時固定 seed 和參數,一次改一種場景條件,分別檢查臉、頭髮輪廓、衣服顏色及小物;這是檢查方法,不是角色一致率測量。
以下是成人原創角色的示例提示詞。測試不同姿勢時維持同一張參考圖:
masterpiece, best quality, safe, 1girl, solo, adult woman, full body, walking across a stone bridge, carrying a closed umbrella, autumn park, morning mist, looking to the side值得調整的參數
| 參數 | 起始值 | 實際調整方式 |
|---|---|---|
| ref_guidance | 4.5 | 角色走樣可試 5–6;顏色過強可降至 3–4。設為 1 仍有參考作用,但省去額外引導的模型呼叫,較快、約束通常較弱。 |
| correction | apg | 抑制強引導造成的色彩問題;rescale 是替代方式,none 表示不補正。 |
| ref_end | 1.0 | 可試 0.6 提早結束額外參考引導;不是在後續步驟移除參考圖本身。 |
| ref_megapixels | 1.0 | 調整參考圖面積,而非輸出尺寸。顯存吃緊可試 0.5–0.7,但微小特徵可能流失。 |
| strength | 1.0 | 適配器權重強度,與 ref_guidance 不同;逐項修改才能判斷效果來源。 |
| KSampler CFG/steps | 4.5/30 | 文字引導與採樣次數。下方 Base+Turbo LoRA 加速配置另有設定,不宜套用到一般 Base。 |
雙角色:合併參考圖並指定左右
使用 workflows/anima_ref_adapter_two_characters.json:兩個 Load Image 經 ComfyUI 內建 Image Stitch 水平拼接。這是把兩人合成一張參考圖,不是尚未發布的「角色圖與畫風圖分開指定」。
- 第一張放預定在左方的角色,第二張放右方角色。
- 將 solo 改為 2girls、2boys 或 1boy, 1girl,簡短說明左右各是誰。
- 先用 1216×832 等橫幅與並排站立構圖;複雜互動應另外驗證,不能視為保證能力。
- 檢查配飾互換、身份混合與服裝省略。兩張圖的畫風容易融合,並非各自獨立鎖定。
masterpiece, best quality, safe, 2girls, adult women, the woman on the left has short dark hair, the woman on the right has a long silver braid, standing side by side, waving, train station platform, daytime使用參考圖到底慢多少?
以下為開發者的 RTX 3060 Ti 8GB、fp16、832×1216、單一參考圖測試,取兩次中較快的一次;不是 AirMore 實測,也不保證其他 GPU 有相同結果。
| 配置 | 每張時間 | 條件 |
|---|---|---|
| Base,不用參考圖 | 33 秒 | er_sde、30 steps、CFG 4.5 |
| pilot 適配器 | 105 秒 | ref_guidance 4.5 |
| v2 適配器 | 65–67 秒 | ref_guidance 4.5 |
| v2,ref_guidance 1 | 50 秒 | 省去額外參考引導計算 |
| Base+Turbo LoRA+v2 | 11 秒 | 10 steps、CFG 1、ref_guidance 1;畫風有取捨 |
「約兩倍快」須分清測量對象:RTX PRO 6000 單步由 0.58 降至 0.28 秒,吞吐約 2.1 倍;3060 Ti 整張由 105 降至 65–67 秒,約為 1.6 倍吞吐、耗時減少約 36–38%,仍慢於不加參考的 33 秒。
開發者驗證的是 Base 前段使用 anima-turbo-lora-v0.2、strength 1 的配置:角色特徵可留下,但畫風會向 Turbo LoRA 靠攏。這不代表完整 Anima-Turbo 或 Aesthetic checkpoint 也經開發者驗證。
指南估計 1MP 參考圖的快取比一般 Anima 多需約 1GB VRAM。8GB 動作案例不是所有配置的最低保證;VAE、輸出解析度、其他 LoRA 與背景程式也需要空間。
什麼情況能省下角色 LoRA?
少量 OC 插圖或快速換場景,合適的參考圖可能讓你省下收圖、寫 caption 與角色 LoRA 訓練。若要長期系列中精確維持標誌、傷痕、耳飾、服裝背面或濃厚筆觸,還不能說 LoRA 已不需要。兩種方法處理不同的一致性問題,也可將其他 LoRA 放在適配器前方搭配使用。
獨立公開測試方面,lilting channel 在 10 月 30 日以 M1 Max 64GB、896×1152 測試,記錄多個場景可維持髮型與衣服,但部分視角仍遺失鞋子。測試曾修改 APG 精度以配合 MPS;2.9B 派生版需重映射區塊,未修改版會失敗。這是特定實驗,不是直接相容保證或全社群共識。
排錯順序
看起來不像參考角色 — 先檢查採樣器是否接收適配器的 MODEL 輸出、是否用 v2 權重,以及一般 Base 能否正常生成,再調 ref_guidance。
顏色過強、角色變成背景海報或人偶 — 保留 apg、降低 ref_guidance;角色以物件重複出現是已知問題,可更換 seed。
姿勢不變 — 明確指定另一個動作與景別;它是外貌參考,不是精確姿勢控制圖。
顯存不足或下載失敗 — 降低 ref_megapixels 或輸出尺寸。自動下載失敗時,從專案取得上述正確名稱的權重,放入 models/loras/。ZIP 多包一層資料夾或忘記重啟也可能導致找不到節點。
授權與開發暫停的實際影響
角色外貌傳遞比畫風傳遞穩定;強烈繪畫風、微小花紋、特殊膚色與大面積衣服色彩仍可能偏移。訓練資料僅來自 Anima 生成圖片,也會繼承基礎模型偏差,應以實際用途尺寸檢查。
截至 2026 年 11 月 4 日,開發者明示因資金不足暫停開發。角色/畫風分離參考、進一步訓練、筆觸與細節改善尚未發布。既有 v2 檔案仍可取得;這不表示已安裝的本機推論停止運作。
節點程式為 Apache-2.0,權重為 CircleStone Labs Non-Commercial License v1.2。不能簡化為「所有生成圖都不可商用」:授權另允許輸出在條款限制下商用;收費模型代管或在營利產品嵌入權重涉及另一層許可,參考圖本身的權利也需處理。
本節於 2026 年 11 月 4 日更新,依適配器程式、指南、授權與具名公開測試整理。AirMore 未在本機執行此適配器;示例與評估方法屬編輯建議。
Anima 是什麼?

Anima 是以動漫角色、概念、風格為核心訓練方向的圖像生成模型。Hugging Face 模型卡中說明,它使用數百萬張規模的 anime 圖像,以及約 80 萬張非 anime 藝術圖像進行訓練,且沒有使用合成資料。anime 學習資料的知識截止時間為 2025 年 9 月。
模型基礎來自 NVIDIA Cosmos-Predict2-2B-Text2Image 系列,並搭配 Qwen 系文字編碼器與 Qwen-Image VAE。因此,Anima 雖然是 2B 級模型,但導入方式比傳統 SDXL 系列稍微專業一些,更接近 ComfyUI 使用者會研究的本機模型。
截至日文原文整理時的 2026 年 7 月 10 日,Hugging Face 上的下載量已超過 78 萬次、喜歡數超過 1,800;Civitai 官方 Anima 頁面也有高下載量與社群評價。這代表 Anima 公開後,很快就獲得動漫 AI 圖像社群的測試與派生模型關注。
anima-base-v1.0 的特色
anima-base-v1.0 是 Anima 系列的基準版。官方將它描述為「pretrained, unrefined base model」,也就是比較接近未過度修飾的基礎模型,重點放在彈性、多樣性與風格跟隨能力。若要訓練 LoRA,官方也建議以 base 版本作為基礎。
| 項目 | anima-base-v1.0 的重點 |
|---|---|
| 擅長領域 | 動漫、插畫、非寫實藝術表現 |
| 不擅長領域 | 寫實照片、長文字繪製、過短且模糊的提示詞 |
| 推薦設定 | 512² 至 1536²、30 至 50 steps、CFG 4 至 5 可作為起點 |
| 提示詞 | 支援 Danbooru 風格標籤、自然語言,以及標籤與自然語言混用 |
| LoRA 訓練 | 官方建議使用 base 版進行 LoRA 訓練 |
| 授權 | 模型使用有非商用條件,生成圖片的使用仍需確認官方授權 |
實際使用上,base 版不像一開始就把畫面「調味」到很強烈的完成品,比較像是一張保留調整空間的畫布。Aesthetic 版或 Turbo 版的初始輸出可能更容易討喜,但 base 版更適合透過作者標籤、品質標籤、年代標籤、LoRA 或 finetune 來做出方向。
實際使用感評測
Anima base-v1.0 的第一印象是,它作為動漫系模型的守備範圍很廣,線條與色彩的平衡相對中性。它不容易被固定在某一種過濃的畫風,因此角色插畫、帶背景的一枚圖、偏草稿感的數位藝術、非寫實奇幻表現都可以嘗試。
但如果只用很短的提示詞,就想穩定得到漂亮成品,Aesthetic 版或 Turbo 版有時會更容易使用。base 版彈性高,但也更需要品質標籤、安全標籤、構圖說明與 negative prompt 來穩定結果。
官方模型卡推薦的正向接頭語包括 masterpiece, best quality, score_7, safe,,負向提示詞則可使用 worst quality, low quality, score_1, score_2, score_3, artist name, blurry, jpeg artifacts, chromatic aberration 等。Aesthetic 版則提到可以不放品質標籤,因此不同版本應該用不同提示詞設計。
Turbo / Aesthetic 最新版本

截至 2026 年 7 月,Anima 不只有 base-v1.0,也已公開 turbo-v1.0、aesthetic-v1.0、aesthetic-v1.0b。Hugging Face repository 在 2026 年 7 月 9 日更新,Civitai 側也在 2026 年 7 月 7 日至 9 日反映新版本。
| 模型 | 特色 | 適合用途 |
|---|---|---|
| anima-base-v1.0 | 接近未調整的基準版,彈性、多樣性與風格跟隨能力高 | LoRA 訓練、finetune、細緻調整、比較測試 |
| anima-turbo-v1.0 | 高速生成用的蒸餾版,官方目安為 CFG 1、8 至 12 steps | 大量試稿、提示詞探索、降低線上環境成本 |
| anima-aesthetic-v1.0 | 提升品質與一致性的 Aesthetic 版,初始輸出較容易整理 | 想用較少調整得到好看插畫 |
| anima-aesthetic-v1.0b | Aesthetic 的另一個版本,官方也補充 1.0 可能更符合偏好 | 想比較 1.0 與 1.0b 差異的測試用途 |
從開發方向來看,Anima 似乎是以 base 保留自由度,用 Turbo 提升速度,用 Aesthetic 整理初始品質,再透過 Civitai 與 ComfyUI 社群增加 LoRA 和派生模型。未來 Anima 專用 LoRA、工作流程、ControlNet 類輔助,以及輕量化或高速化版本,應該還會繼續增加。
和其他動漫系模型比較
評估 Anima 時,可以和 Illustrious XL、Noob XL、Pony XL、NovelAI Diffusion Anime V4.5 這些既有動漫系模型比較。不過,這些模型或服務在公開權重、派生社群、商用服務定位上都不同,不建議只做單純畫質排名,而是依用途比較。
| 模型 | 強項 | 注意點 | 適合對象 |
|---|---|---|---|
| Anima | 新的 anime / illustration 特化模型,base、Turbo、Aesthetic 分工明確,適合 ComfyUI 與派生學習 | 導入稍微專業,模型使用有非商用授權條件 | 想在本機深入製作、測試 Anima 系 LoRA 的人 |
| Illustrious XL | 高解析動漫表現與標籤設計研究背景完整,與 SDXL 社群資產相性好 | 派生模型多,畫風和品質取決於選擇 | 想活用既有 SDXL / Illustrious 資產的人 |
| Noob XL | Civitai 周邊很受歡迎,角色 LoRA 與派生 checkpoint 多 | 版本與派生多,初學者容易選擇困難 | 想跟上 Civitai 流行工作流程的人 |
| Pony XL | 角色、姿勢、LoRA 資產非常豐富,提示詞文化成熟 | 用途很廣但也較有個性,不只一般動漫圖 | 重視 LoRA 相容性和角色再現的人 |
| NovelAI 4.5 | 作為付費服務,UI、便利性與穩定生成體驗強 | 不適合自由本機部署或 finetune 模型權重 | 想少碰設定、快速在服務內完成的人 |
實務上可以把 Anima 看作「新興、成長中的本機 / ComfyUI 動漫模型」;Illustrious、Noob、Pony 是「成熟的 SDXL 系社群資產」;NovelAI 4.5 則是「付費服務型完成度」。這樣會比只問哪個畫質最好更容易選。
Civitai 上熱門的派生模型與 LoRA
Civitai 上除了官方 Anima checkpoint,也有 Turbo 系 LoRA、Aesthetic 補強、RL 系、風格 LoRA、社群派生 checkpoint。以下是日文原文在 2026 年 7 月 10 日整理時提到的主要熱門資源。
| 名稱 | 類型 | 發布者 | 公開指標目安 | 用途 |
|---|---|---|---|---|
| Anima Turbo LoRA | LoRA | circlestone_labs | 約 47K DL / 1.9K 喜歡 | 高速生成、少步數試稿 |
| Anima Highres/Aesthetic Boost | LoRA | circlestone_labs | 約 25K DL / 1.5K 喜歡 | 補強高解析感與整體觀感 |
| Anima RL | LoRA | circlestone_labs | 約 6.9K DL / 343 喜歡 | 調整質感與細節 |
| Greg Rutkowski Style – Anima | LoRA | circlestone_labs | 約 3.2K DL / 305 喜歡 | 測試繪畫風、奇幻風格 |
| ANIMA-V1-Turbo-AIO | Checkpoint | n_Arno | 約 1.8K DL / 174 喜歡 | 想集中處理 Turbo 系的人 |
另外,原文也提到 civitai.red 上有幾個以 Anima base 為基礎的派生 checkpoint 很受歡迎,例如 WAI-ANIMA、MiaoMiao Harem、Nova Anime AM。這些模型通常會有各自的推薦 steps、CFG、sampler 與授權條件,使用前要看清楚說明。
如果只想先抓重點,建議先確認官方 Anima checkpoint,再視需求測試 Anima Turbo LoRA 與 Anima Highres/Aesthetic Boost。角色 LoRA 正在增加,但目前還不像 Pony XL、Illustrious / Noob 系那樣累積到非常龐大的互換資產。
推薦設定與注意事項
- base 版:可從 30 至 50 steps、CFG 4 至 5、512² 至 1536² 的範圍開始。
- Turbo 版:官方目安為 CFG 1、8 至 12 steps,適合大量試稿與快速確認。
- Aesthetic 版:如果品質標籤放太多,畫面可能過度;出現噪點或細節混亂時,可降低 CFG 並整理 score 類標籤。
- 安全標籤:若要避免非預期輸出,positive 與 negative prompt 都應明確寫出安全性與品質需求。
- 文字繪製:長文字或 logo 風文字不是它的強項,含文字圖片建議後製。
- 商用利用:模型有非商用授權條件,API 提供、商用平台整合、派生模型販售等用途都應先確認官方授權。
常見問題
Anima 可以用來做寫實圖片嗎?
不建議。官方模型卡也說明 Anima 主要面向 anime、illustration、非寫實藝術,不適合 realism。
第一次使用應該選 base、Turbo 還是 Aesthetic?
如果是驗證或 LoRA 訓練,建議選 base-v1.0;如果想快速試方向,可選 turbo-v1.0;如果想用較少調整得到好看的初始輸出,aesthetic-v1.0 會比較合適。
Anima 可以商用嗎?
模型本身以 CircleStone Labs Non-Commercial License 公開,因此模型與派生模型的商用使用有限制。另一方面,生成圖片本身在模型卡中有列出部分允許例。若要用在實際案件,務必閱讀完整授權本文。
Civitai 上應該先下載哪個?
建議先從官方 Anima checkpoint 開始;需要速度就測 Anima Turbo LoRA,想提升畫面觀感就試 Anima Highres/Aesthetic Boost。派生 checkpoint 則應依用途和授權條件選擇。
總結
Anima 是 2026 年動漫系圖像生成模型中相當有勢頭的新選擇。base-v1.0 彈性高,適合 LoRA 訓練與細緻風格控制;turbo-v1.0 擅長高速試稿;aesthetic-v1.0 則適合想快速整理初始輸出品質的情境。
和 Illustrious XL、Noob XL、Pony XL、NovelAI 4.5 相比,Anima 的社群資產還在成長中,但模型架構與開發速度有新鮮感。如果你想在 ComfyUI 裡深入製作 anime / illustration 圖像,並願意追蹤後續 LoRA 和派生 checkpoint,Anima 值得放進觀察清單。
相關 評測
YuE2-3B 評測:本機 AI 音樂、Suno 比較與 ComfyUI

Seedance 2.5 評測:AI 影片生成模型的功能、使用體驗與限制

2026 年 5 款最佳 AI 圖片偵測工具
2026 年 10 大 AI 聊天機器人推薦
MOSS-Image 評測:文字、構圖、NSFW、顯存需求與 ComfyUI 設定
2026 年 6 款最佳 AI 聲音克隆工具推薦