
IA de imagens local ou online: qual escolher em 2026?
Comece online se você gera imagens ocasionalmente, usa notebook ou celular, ou precisa editar por conversa. A opção local faz sentido se você já tem uma GPU adequada e reutiliza os mesmos modelos, LoRAs e fluxos. Comprar uma GPU cara apenas para economizar uma assinatura de US$ 20–30 costuma levar anos para se pagar.
“Local” indica onde o modelo roda. Não significa automaticamente qualidade superior, menor compreensão de prompts, direitos de conteúdo ilimitados ou custo zero. O mesmo modelo disponível para download pode rodar no seu PC e em uma API hospedada paga. Pesos, precisão, configurações e moderação importam mais do que o local de execução isoladamente.
| Critério | Inferência local | Geração online |
|---|---|---|
| Investimento inicial | GPU ou computador adequado existente; armazenamento e tempo de configuração | Geralmente dispensa comprar GPU; testes gratuitos, assinaturas ou créditos de API |
| Qualidade da imagem | Depende do modelo, do fluxo e da memória disponível | Acesso a modelos hospedados e fechados; o provedor define o processamento |
| Texto e prompts | Modelos modernos entendem linguagem natural; alguns antigos ou especializados preferem tags | A conversa facilita revisões; a escrita na imagem ainda precisa de conferência |
| NSFW | Depende do modelo, da licença e do aplicativo; não há permissão universal | Varia por serviço: alguns aceitam somente SFW; outros têm maior capacidade para conteúdo sensível |
| Velocidade e limites | Hardware, resolução e tamanho do lote; sem cota do provedor em execução totalmente local | Filas, plano, créditos, limites de requisição e modo de qualidade |
| Anime / realismo | Modelos especializados e LoRAs compatíveis oferecem controle | Serviços de anime e modelos gerais têm pontos fortes diferentes |
| Manutenção / privacidade | Você gerencia dependências, arquivos e backups; fluxos offline podem manter os dados no PC | Pouca configuração; tratamento de dados e visibilidade dependem do serviço |
Este guia de compra se baseia em fontes conferidas em 8 de setembro de 2026, não em um teste controlado de todos os modelos. Identificamos os tempos divulgados pelos fabricantes e explicitamos as hipóteses dos cálculos. Salvo indicação contrária, os valores estão em dólares americanos, e não em reais ou euros.
Um fluxo prático: gerar primeiro, finalizar depois
1. Escolha o ambiente de inferência. O ComfyUI é uma interface de fluxos e um mecanismo de inferência de código aberto, não um modelo de imagens. Ele permite combinar geração, edição e outras etapas. Um fluxo instalado localmente pode conter nós de APIs remotas pagas: confira os nós antes de concluir que as imagens permanecem no computador.
2. Finalize apenas a imagem escolhida. Se o resultado estiver correto, mas pequeno, o Ampliador de imagens com IA do AirMore é uma ferramenta opcional no navegador para aumentar suas dimensões em pixels. Ele amplia imagens, mas não substitui um gerador. Também não corrige erros de escrita de forma confiável nem garante que detalhes reconstruídos sejam precisos. Para arquivos sensíveis ou confidenciais, escolha uma finalização compatível com seus requisitos de dados.
Separar geração e finalização evita gastar créditos de alta resolução em dezenas de conceitos antes de escolher a composição. Confira o rascunho pequeno primeiro e depois invista tempo e processamento no resultado selecionado.
Comparação de preços: comprar GPU, assinar ou usar API?
Para gerar localmente, considere o sistema completo: memória da GPU, RAM, espaço no SSD, fonte compatível e refrigeração. Os modelos também podem ocupar muito armazenamento. Como referência inicial, 16 GB de VRAM e 32 GB de RAM oferecem mais flexibilidade do que uma GPU de entrada com pouca memória, mas não garantem espaço para qualquer fluxo grande. Modelos pesados podem exigir mais memória ou descarregamento para CPU, com menor velocidade.
| Exemplo de GPU | Memória gráfica | Preço inicial de lançamento nos EUA | Como interpretar |
|---|---|---|---|
| RTX 5060 Ti | 16 GB | US$ 429 | Referência de capacidade, sem garantia de velocidade de topo de linha |
| RTX 5070 Ti | 16 GB | US$ 749 | Mais processamento não aumenta o limite de memória |
| RTX 5090 | 32 GB | US$ 1.999 | Mais espaço para fluxos, com custos de compra e do sistema muito maiores |
Esses são valores de lançamento da NVIDIA para a família 5060 e a série 50, não cotações atuais de compra. Uma recente reportagem de preços do Tom’s Hardware nos EUA listou a 5060 Ti de 16 GB por cerca de US$ 761 e a 5090 mais barata por pelo menos US$ 5.000. Estoque, país, impostos e projeto da placa podem mudar totalmente a decisão. Obtenha uma cotação no seu mercado antes de calcular o retorno.
| Opção online | Cobrança mensal / preço da API | O que você compra |
|---|---|---|
| ChatGPT Plus | US$ 20/mês | Acesso ao ChatGPT com limites de imagens; API cobrada separadamente |
| Midjourney | Basic US$ 10; Standard US$ 30; Pro US$ 60; Mega US$ 120 | As horas Fast de GPU variam por plano; Standard e superiores incluem imagens em Relax |
| NovelAI | Tablet US$ 10; Scroll US$ 15; Opus US$ 25 | Anlas e benefícios do plano; gerações gratuitas do V5 Opus têm limite com reposição gradual |
| API FLUX.2 klein 4B | A partir de US$ 0,014 por imagem de 1 MP | Pagamento por imagem; saídas maiores e edições podem aumentar o custo |
| API GPT Image 2 | Por milhão de tokens de imagem: US$ 8 de entrada / US$ 30 de saída; texto de entrada: US$ 5 por milhão | Preço padrão por tokens; qualidade, tamanho e imagens de entrada afetam o total |
Fontes: ChatGPT Plus, planos do Midjourney, assinaturas do NovelAI, preços da BFL e preços da API da OpenAI. Entradas em cache e processamento em lote têm outras tarifas. Mensalidade e cobrança anual não são equivalentes, e impostos podem ser acrescentados. Uma assinatura web não inclui automaticamente créditos de API.
Exemplo de retorno do investimento: suponha US$ 800 em hardware adicional, cancelamento de um plano de imagens de US$ 30/mês e despesas locais recorrentes de US$ 5/mês. O prazo é 800 ÷ (30 − 5) = 32 meses. Um PC completo de US$ 1.500 levaria 60 meses nas mesmas condições. Se você mantiver a assinatura, essa economia não existe. Revenda, reparos e tempo de configuração ficaram fora do cálculo.
É possível medir a energia: consumo hipotético do PC inteiro de 0,35 kW × 30 horas × US$ 0,20/kWh = US$ 2,10. Substitua tudo pelas suas medições e tarifa; não é uma medição real de consumo de GPU. O custo mais difícil costuma ser o tempo de trabalho: corrigir um fluxo quebrado pode custar mais do que a economia obtida em muitas imagens.
Para uso ocasional, pagar por consumo pode sair mais barato do que assinar ou comprar hardware. Em produção intensa com uma GPU que você já possui, a inferência local fica mais atraente. Compare o custo por imagem aprovada: uma tentativa hipotética de US$ 0,03 custa US$ 0,12 por imagem utilizável com taxa de aprovação de 25%, antes do retoque.
Capacidade dos modelos locais: escolha pela tarefa
O FLUX.2 [klein] 4B é um candidato compacto para geração e edição local. Seus pesos 4B usam Apache 2.0; os 9B têm outra licença, não comercial salvo autorização separada. Não suponha que todos os downloads FLUX tenham as mesmas condições comerciais. Guia oficial de uso local e licenciamento.
A BFL informa cerca de 8,4 GB e 1,2 segundo para inferência do 4B destilado em uma RTX 5090; seu guia mais amplo de fluxo menciona aproximadamente 13 GB. São escopos de memória diferentes, sem garantia para placas de 8 GB. Reserve espaço para codificadores, decodificação e entradas de edição. O tempo da 5090 não deve ser aplicado à 5060 Ti. Tabela de desempenho do fabricante; orientações de fluxo.
O Qwen-Image-2512 é um modelo de aproximadamente 20 bilhões de parâmetros disponível para download, interessante para testar temas realistas e composições com texto. A ficha oficial destaca avanços no realismo e na escrita em inglês e chinês. É um modelo grande: quantização e descarregamento para CPU podem ajudar a executá-lo, mas alterar velocidade e resultados. Usamos essa versão específica para comparação, sem afirmar que seja o produto mais recente de toda a família Qwen. Ficha oficial e licença Apache 2.0.
O Z-Image-Turbo é uma opção destilada de 6 bilhões de parâmetros voltada à eficiência. O desenvolvedor informa 8 avaliações de função, saída fotorrealista, escrita em inglês e chinês e adequação a dispositivos de consumo de 16 GB. A latência anunciada abaixo de um segundo foi obtida em uma H800 empresarial, não em uma GPU doméstica comum. Ficha oficial do modelo.
Para anime, um modelo especializado ou LoRA compatível pode importar mais do que o maior modelo geral. LoRA é uma adaptação pequena vinculada a determinada família de modelos, não um complemento universal de estilo. Comece por um exemplo funcional da versão base exata. Nosso guia de downloads de modelos e LoRA, em inglês, explica como avaliar fontes e compatibilidade.
Modelos online: edição, estética e especialização em anime
Acesso oficial pelo navegador: ChatGPT · Midjourney · NovelAI.
ChatGPT Images 2.0 / GPT Image 2 é a opção conversacional desta comparação. Você descreve uma cena e pede alterações específicas usando a imagem anterior como contexto. Isso facilita conceitos de marketing e layouts cujo briefing muda durante a conversa. O modelo da API tem documentação separada do produto ChatGPT. Anúncio oficial do Images 2.0; documentação da API GPT Image 2.
O Midjourney V8.2 se tornou padrão em 24 de julho de 2026, segundo a documentação de versões. Ele enfatiza estética e personalização, com um novo Edit Model. Para anime, o mesmo serviço oferece o Niji 7. É uma opção quando definir a direção visual é o principal desafio; isso não prova superioridade em rótulos exatos de produtos ou instruções complexas. Versões atuais e diferenças entre modelos.
O NovelAI Diffusion V5 combina geração de anime, prompts em linguagem natural, suporte a japonês, controles de múltiplos personagens e escrita melhorada. Full tem cobertura de treinamento mais ampla; Curated busca reduzir conteúdo sensível indesejado. Esses recursos são especialmente relevantes para cenas de personagens e quadrinhos. Informações oficiais do modelo V5.
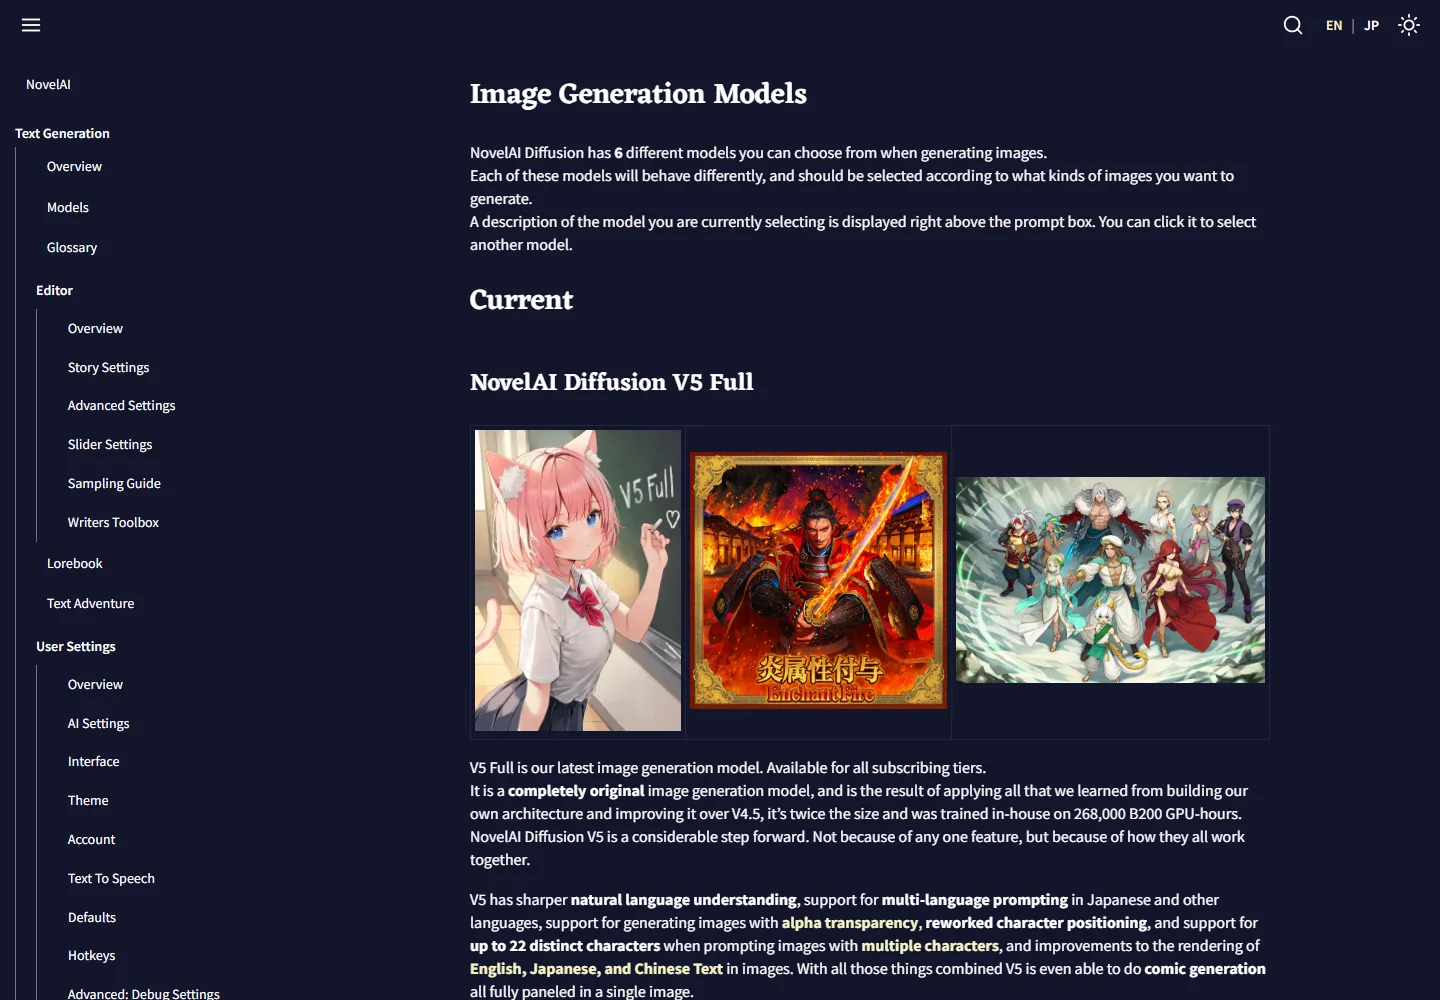
São formas diferentes de trabalhar, não um ranking universal. Prefira edição por conversa para briefings variáveis, sistemas de estilo para explorar direção artística e controles explícitos de personagens para cenas recorrentes. Teste seus exemplos difíceis antes de pagar um ano.
Escrever na imagem e entender o prompt são capacidades distintas
Compreensão do prompt significa atribuir corretamente objetos, cores, posições e ações. Renderização de texto significa desenhar os caracteres solicitados com precisão dentro da imagem. Um modelo pode criar um cartaz bonito com título errado ou escrever corretamente e ignorar quem deve segurar o produto.
| Teste | O que pedir | O que conferir |
|---|---|---|
| Relações | Caneca vermelha à esquerda de um livro azul; planta verde atrás dos dois | Número de objetos, posições e correspondência das cores |
| Texto exato | Título curto entre aspas e um preço separado | Letras faltando, números alterados, palavras extras e alinhamento |
| Tipografia multilíngue | Frase em português com acentos, ã e ç; em japonês, kanji, kana e números | Acentos, pontuação e espaçamento; em japonês, kana pequenos e marcas de vogal longa |
| Edição | Mudar apenas o fundo, mantendo embalagem e rótulo | Se detalhes que deveriam permanecer iguais foram redesenhados |
Comece com um pedido simples: “Crie um cartaz quadrado para uma cafeteria fictícia. Coloque uma xícara azul à esquerda e o título ‘Café da manhã’ no topo. Deixe o terço inferior livre.” Depois faça uma correção por vez. Normalmente é mais fácil diagnosticar problemas assim do que com um parágrafo de adjetivos de estilo conflitantes.
Modelos locais modernos também aceitam prosa. Um modelo de anime treinado com tags pode responder melhor às tags e ponderações documentadas; um serviço conversacional interpreta a intenção por diálogo. A dificuldade vem do modelo e dos controles escolhidos, não apenas da execução local. Não copie uma receita antiga de prompt negativo para todo modelo novo.
Para peças em português, teste acentos, til e cedilha: exemplos em inglês não bastam. Da mesma forma, demonstrações em inglês ou chinês não comprovam a escrita em japonês. Faça um teste no idioma e revise no tamanho final. Para preços, textos legais, contatos e parágrafos densos, gere a ilustração e acrescente texto editável em um editor de design; isso também reduz o custo de correções.
Velocidade e cotas: compare imagens finalizadas por hora
Conte o tempo desde o envio do pedido até ter um arquivo aceitável. Inclua carregamento do modelo, transferência, filas, prévias, novas tentativas, ampliação e correções manuais. Um segundo de inferência anunciado pelo fabricante é apenas uma parte do processo.
| Ambiente | Limite relevante | Consequência prática |
|---|---|---|
| Totalmente local | Memória gráfica, processamento, temperatura e armazenamento | Sem cota do serviço, mas lotes grandes podem esgotar a memória; descarregamento pode reduzir a velocidade |
| ChatGPT | Limites do plano e complexidade da solicitação | Gerações complexas podem levar minutos; não presuma a mesma cota diária fixa para todas as contas |
| Midjourney | Horas Fast de GPU e filas Relax | Basic: 3,3 horas Fast; Standard: 15; Pro: 30; Mega: 60. Relax em Standard ou superior troca espera por volume |
| NovelAI V5 Opus | Cota gratuita com reposição gradual, mais Anlas | Gerações gratuitas elegíveis são limitadas; depois, use Anlas ou espere a recuperação |
| API hospedada | Limites de requisições, créditos e concorrência | Automação é conveniente, mas lotes ainda exigem orçamento e tratamento de novas tentativas |
Fontes: ajuda de imagens do ChatGPT, tabela de planos do Midjourney e FAQ de limites do NovelAI Opus. Segundo o NovelAI, a cota V5 se recompõe continuamente e leva cerca de uma semana para voltar ao máximo após esgotada. Modelos anteriores elegíveis mantêm regras diferentes de geração ilimitada. Não apresente V5 simplesmente como “ilimitado”.
Para comparar de forma justa, execute os mesmos dez briefings em dimensões semelhantes. Registre tentativas, imagens aprovadas, tempo e gasto total. Separe o teste com o modelo local já carregado na memória da inicialização a frio. Isso é mais útil do que comparar vídeos de velocidade nas redes sem condições equivalentes.
Anime, pessoas realistas e consistência de personagens
Anime e mangá: teste NovelAI ou Niji do Midjourney para começar online; pesquise modelos de anime e LoRAs compatíveis se precisar controlar um estilo repetível em local. Layout dos quadros, mãos, quantidade de personagens e consistência entre páginas devem ser avaliados separadamente da beleza de um retrato.
Pessoas e produtos fotorrealistas: compare os modelos gerais citados em textura da pele, tecidos, reflexos, geometria e fidelidade às referências. Um rosto convincente não comprova que logotipo, tamanho da embalagem ou posição das mãos estejam certos. As alegações de realismo de Qwen e Z-Image são motivos para testá-los, não prova independente de superioridade sobre todos os serviços online.
Personagens recorrentes: escolha um fluxo que aceite as referências ou adaptações necessárias. Salve versão do modelo, prompt, semente quando disponível e configurações de edição. A semente sozinha não garante a mesma pessoa após trocar de modelo ou fluxo. Na produção, meça o esforço de manter o personagem em dez cenas, não apenas um resultado de sorte.
NSFW: controle local não significa permissão irrestrita
NSFW pode incluir nudez artística, material sexual explícito ou violência gráfica. São categorias diferentes nas políticas. A tabela resume capacidades gerais e restrições documentadas; este guia não realizou testes de geração explícita nem de contorno de filtros.
| Opção | Situação de NSFW | Limite importante |
|---|---|---|
| Modelos locais para download | Varia por pesos, treinamento e aplicativo instalado | Retirar o serviço hospedado não elimina os termos do modelo nem torna todo resultado legal |
| ChatGPT Images / GPT Image 2 | Restrito; não é um serviço adulto sem censura | Filtros se aplicam a prompts e imagens; deepfakes sexuais têm restrições específicas |
| Midjourney / Niji | Somente SFW | Conteúdo adulto e gore é proibido, inclusive em servidores privados e no modo Stealth |
| NovelAI V5 | Full e Curated diferem na capacidade para conteúdo sensível | Curated busca reduzir imagens sensíveis indesejadas; isso não autoriza todo uso adulto |
| Modelos abertos hospedados | Aplicam-se as regras do provedor | A API pode impor restrições diferentes da instalação local |
Fontes: relatório de segurança do OpenAI Images 2.0, diretrizes do Midjourney, diferenças de modelos do NovelAI, termos do NovelAI e política de uso da BFL. A documentação do NovelAI citada não estabelece uma lista universal de conteúdo permitido para toda situação explícita; “Full” não deve ser entendido como essa garantia.
Antes de assinar para projetos adultos, diferencie capacidade técnica de permissão contratual. Use apenas conteúdo adulto legal e consentido; evite conteúdo sexual envolvendo menores ou representações íntimas sem consentimento. Executar localmente não justifica esses usos. Armazenamento privado e permissão para gerar uma categoria também são questões diferentes.
Privacidade, licenças e decisão de compra
Um fluxo totalmente local pode manter as imagens originais no computador após instalar os componentes. Confira nós remotos e extensões antes de chamá-lo de offline. Serviços online diferem: as criações do Midjourney são públicas por padrão, e Stealth só está em Pro e Mega. Os controles de dados do ChatGPT para consumidores são outra configuração; um plano pago não vira automaticamente um ambiente offline ou confidencial.
Em trabalho comercial, confira a licença exata do modelo e das adaptações, o plano e os direitos das referências. Pesos disponíveis para download não significam uso comercial irrestrito. A licença do fornecedor também não garante autorização para todo logotipo ou semelhança gerados.
- Imagens ocasionais, sem GPU adequada: comece com teste ou um mês online. É difícil justificar hardware só pela economia de assinatura.
- GPU existente, lotes repetíveis: teste um modelo local e um fluxo estável. Acompanhe resultados aprovados e tempo de manutenção antes de expandir.
- Cartazes em português ou japonês e briefings variáveis: priorize testes de idioma, edição pontual e tipografia final editável.
- Produção de anime: compare controles de personagens, recursos de estilo compatíveis e limites reais do V5 e do plano.
- Trabalho misto: mantenha tarefas rotineiras validadas em local e use um modelo hospedado quando a edição ou o resultado economizar tempo suficiente.
Um fluxo híbrido costuma ser útil, mas manter os dois significa um custo adicional de serviço. Veja outras opções iniciais no nosso guia de geradores de imagens com IA.
Perguntas frequentes
Gerar imagens com IA local é grátis?
O software e alguns pesos podem ser gratuitos para download. Hardware, energia, armazenamento, manutenção e seu tempo ainda têm custo. Já possuir um computador adequado facilita justificar o uso local.
8 GB de VRAM são suficientes?
Para alguns fluxos pequenos ou quantizados, sim. Não é uma meta confiável para todos os modelos. Confira o processo completo, dimensões e entradas de edição; a memória só do modelo exclui outros componentes.
Mais VRAM melhora a qualidade da imagem?
Permite acomodar modelos ou fluxos maiores e reduzir o descarregamento. Não melhora automaticamente o mesmo modelo com configurações idênticas. Velocidade de processamento e capacidade de memória resolvem problemas diferentes.
A IA online pode gerar imagens NSFW?
Não há resposta única. Midjourney só permite SFW, OpenAI aplica restrições de segurança e outros serviços diferenciam variantes de modelos e regras de conteúdo sensível. Verifique o modelo atual e a política do provedor.
Qual opção escreve melhor em português ou japonês?
Escolha conforme testes com o modelo e seu texto exato, não apenas entre local e online. Confira acentos, cedilha, pontuação, números e, em japonês, kana. Mantenha o texto final importante editável em vez de depender só das letras geradas.
Devo comprar uma GPU para substituir a assinatura?
Só depois de testar o fluxo local e calcular a economia das assinaturas que você realmente cancelará. Inclua cotação real do hardware, despesas recorrentes e taxa de imagens aproveitáveis. Um preço alto pode levar o retorno além do ciclo razoável de atualização do equipamento.
Nossa conclusão
Para a maioria sem hardware adequado, a geração online é a primeira compra mais simples. A local ganha força quando você já tem GPU, precisa de controle repetível e consegue manter o fluxo. Nenhuma localização garante o melhor anime, rostos realistas ou escrita precisa.
Escolha o modelo para a tarefa, confira seus limites NSFW e comerciais e compare custo e tempo por imagem realmente utilizável. Em 2026, essas diferenças práticas importam mais do que “local é grátis” ou “a nuvem é sempre melhor”.
Relacionados
7 Melhores Apps Online e Gratuitos para Criar Headshots Profissionais com IA

Como Usar o Claude Code (Guia para Principiantes)

Best AI Business Name Generators to Find Brandable Company Names

Top 7 Ferramentas Gratuitas de Design de Jardins com IA para Criar Espaços Exteriores Incríveis
Top AI Calorie Tracking App and Food Recognition Tools 2026
As 10 Melhores Extensões para o Chrome em 2026: Complementos Práticos que Vale a Pena Instalar