
O LM Studio é um bom ponto de partida para baixar um modelo e conversar por uma interface gráfica. Prefira o Ollama para conectar outros aplicativos a um motor local; o Jan para um chat de desktop de código aberto; o GPT4All para consultar pastas simples; ou o AnythingLLM para organizar documentos em espaços de trabalho.
Esses aplicativos são voltados principalmente a modelos de linguagem: escrita, ajuda com código e perguntas sobre documentos. Não substituem um ambiente de geração de imagens como o ComfyUI. O aplicativo gerencia o modelo, mas boa parte da qualidade vem do próprio modelo; uma interface diferente não transforma um modelo pequeno em uma IA de nuvem de ponta.
Atualizado em 14 de outubro de 2026
Qual aplicativo combina com sua tarefa?
Escolha pela tarefa que pretende concluir, não pelo tamanho do catálogo. Os cinco oferecem um caminho gratuito para inferência local, mas computador, energia, armazenamento, nuvem opcional e licença do modelo precisam ser avaliados separadamente. A comparação é por uso, não um ranking de velocidade medido no mesmo equipamento.
| Aplicativo | Indicado para | Custo do uso local | Principal limitação |
|---|---|---|---|
| LM Studio | Buscar modelos e conversar pela interface | Uso local gratuito disponível | Confira a arquitetura do Mac e as opções de nuvem |
| Ollama | API local e integrações | Execução local gratuita | Documentos podem exigir outra interface |
| Jan | Chat de desktop de código aberto | Uso local gratuito | Compatibilidade de modelo e motor |
| GPT4All | Coleções simples de documentos | Aplicativo gratuito | Arquiteturas novas podem não carregar |
| AnythingLLM | Espaços de trabalho com documentos | Desktop gratuito | Mais configurações; Desktop é individual |
5 aplicativos e como começar
1. LM Studio: para começar sem depender do terminal
O LM Studio reúne descoberta, download, chat e servidor local. Suporta GGUF via llama.cpp e MLX em Apple Silicon. É uma opção prática para comparar dois modelos pequenos, observar como escrevem em português e ajustar o contexto sem montar um servidor separado. Também permite anexar documentos para perguntas.
O site atual apresenta o Bionic e inferência opcional em nuvem. Modelos locais estão incluídos no plano gratuito; uma assinatura de nuvem não é necessária para o chat local básico. Porém, escolher um modelo remoto ou uma ferramenta de busca online continua envolvendo serviços externos.
Site oficial · Documentação de configuração
Como começar
- Baixe o instalador correto. No Mac, confira o processador: os requisitos publicados do LM Studio Desktop não incluem Macs Intel.
- Na busca de modelos, escolha um modelo pequeno de instruções e uma quantização que deixe memória livre para o sistema.
- Carregue o modelo e faça uma pergunta curta. Para integração, inicie o servidor local e copie o endereço mostrado na sua versão.
A documentação recomenda 16 GB de RAM. Nos Macs compatíveis, é necessário macOS 14 ou superior; no Windows x64, AVX2. Isso não garante memória suficiente para qualquer modelo.
2. Ollama: para compartilhar o motor com outros aplicativos
O Ollama é útil como serviço local para assistentes de programação, ferramentas de documentos e scripts. Há aplicativo nativo para Windows e Mac, sem exigir Docker como primeiro passo. Também existe interface de desktop; tratá-lo como uma ferramenta apenas de linha de comando seria impreciso.
A vantagem é reutilizar o mesmo motor em clientes diferentes. Uma biblioteca documental completa pode depender do aplicativo conectado. Selecione explicitamente um modelo local: opções de nuvem rodam remotamente. A inferência local não exige chave de API de nuvem.
Site oficial · Documentação de configuração
Como começar
- Instale o Ollama, escolha um modelo local no aplicativo ou catálogo oficial e confira o tamanho antes de baixar.
- Use os comandos abaixo para listar os modelos, executar o nome correto e verificar CPU/GPU. Substitua MODEL_NAME por um nome da lista.
- Configure o cliente para o endpoint local, normalmente http://localhost:11434. Para uso pessoal, mantenha o acesso restrito ao próprio computador.
ollama list
ollama run MODEL_NAME
ollama ps
A documentação prevê CPU em Macs Intel compatíveis com macOS 14 ou superior e GPU em Apple Silicon. Para desativar a nuvem, configure OLLAMA_NO_CLOUD=1 e reinicie, conforme a FAQ oficial.
3. Jan: para quem prefere um aplicativo de código aberto
O Jan combina uma interface de conversa conhecida com gerenciamento de modelos locais. O Hub reúne downloads e exibe orientações de compatibilidade com o hardware. Use o formato aceito pelo motor selecionado: as rotas llama.cpp e MLX para Apple Silicon têm particularidades.
Também é possível adicionar provedores remotos. Isso facilita alternar modelos, mas um nome na tela de um app instalado não prova que o processamento seja local. O Jan oferece servidor API; confira o endereço na versão em uso, em vez de repetir uma porta de um tutorial antigo.
Site oficial · Documentação de configuração
Como começar
- Instale o Jan e baixe pelo Hub um modelo local pequeno que caiba no equipamento.
- Selecione o modelo em uma conversa nova e teste um resumo ou uma reescrita em português.
- Ative a API apenas se precisar. Para trabalhar offline, não utilize provedores remotos nem ferramentas conectadas à web.
Se o modelo não carregar, confira a arquitetura e o motor antes de baixar repetidamente outras quantizações.
4. GPT4All: para consultar uma pasta de documentos
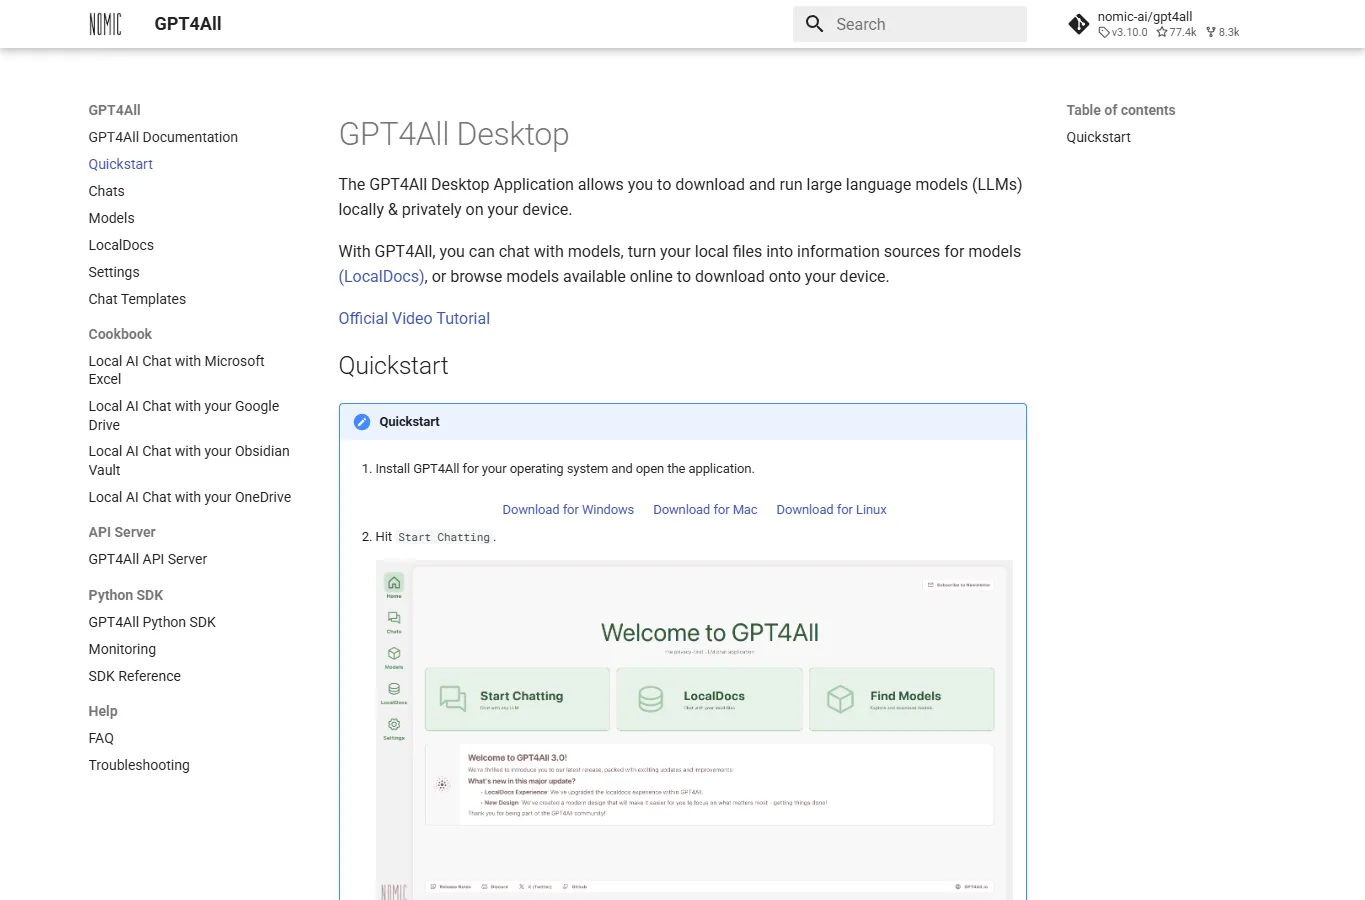
O GPT4All inclui o LocalDocs, que transforma pastas escolhidas em coleções pesquisáveis. Serve para manuais, anotações ou um pequeno acervo de estudo sem montar um servidor de equipe. Você baixa um modelo compatível e seleciona a coleção relevante no chat.
A recuperação não treina permanentemente o modelo com todas as páginas. Ela encontra trechos e os coloca no contexto da resposta. Um PDF escaneado sem texto legível, indexação incompleta ou busca ruim pode prejudicar o resultado. Comece por arquivos cujo conteúdo você conhece.
Site oficial · Documentação de configuração
Como começar
- Em Models, use Add Model para baixar um modelo compatível e teste a conversa em Chats.
- Crie uma coleção LocalDocs com uma pasta pequena e aguarde a indexação. Baixe também o modelo de embeddings local necessário.
- Selecione a coleção e faça uma pergunta com resposta conhecida. Confira os trechos citados antes de aceitar a conclusão.
O nome não significa rodar o GPT-4 da OpenAI no computador. A extensão GGUF também não garante suporte a uma arquitetura nova.
5. AnythingLLM: para organizar documentos por projeto
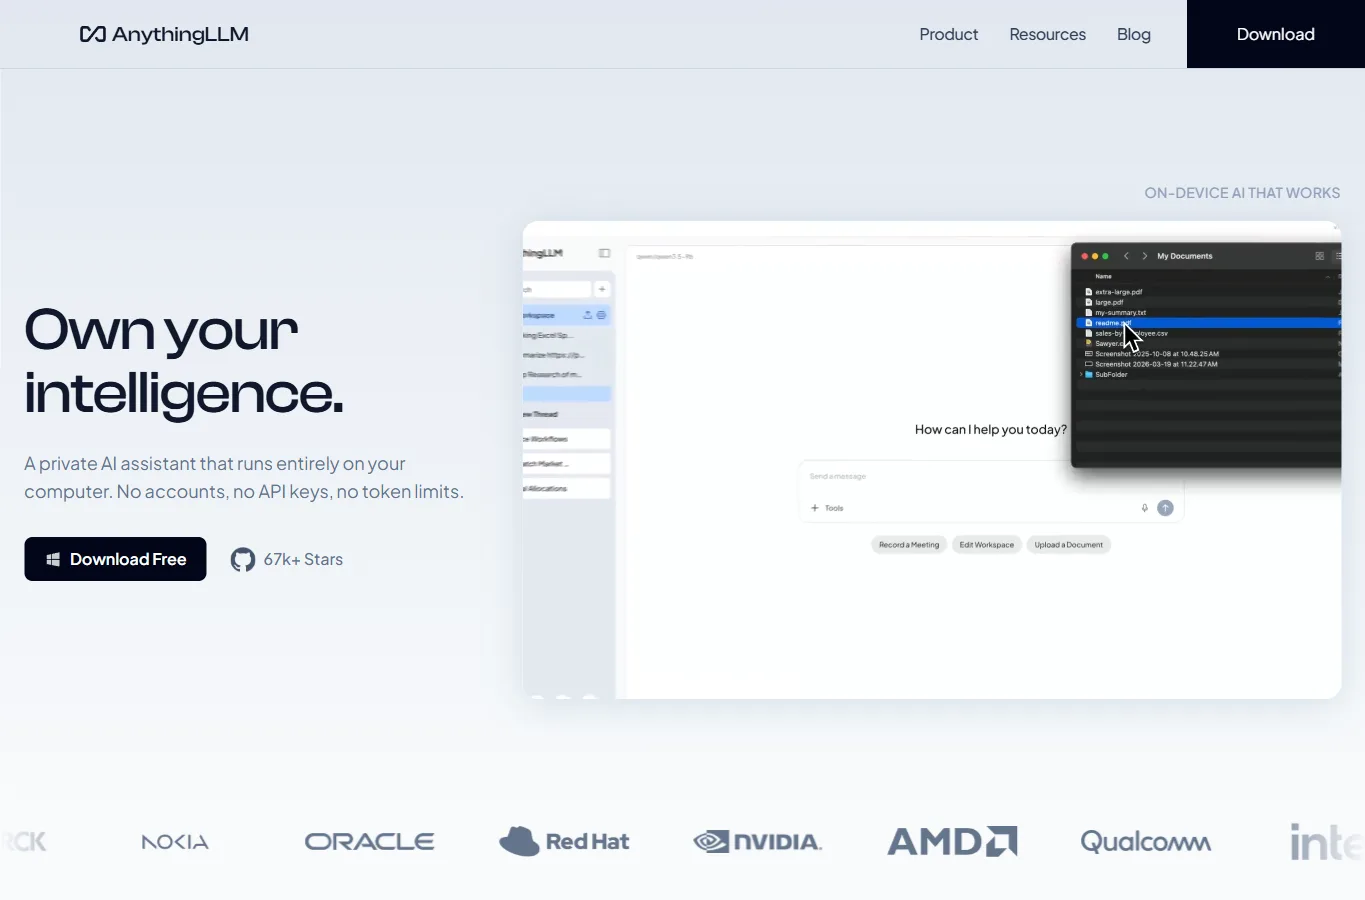
O AnythingLLM organiza o trabalho em espaços: especificações de um projeto em um, material de estudo em outro. Combina chat, recuperação documental e agentes opcionais. O Desktop inclui uma rota local e pode se conectar ao Ollama. Faz sentido para quem pretende manter uma biblioteca em crescimento, não apenas experimentar um chatbot.
Confira o modelo de chat, o provedor de embeddings e o armazenamento. Um chat local com embeddings enviados para uma API remota não é um fluxo totalmente local. O Desktop é individual; contas compartilhadas e permissões de equipe pertencem à rota separada de servidor/Docker.
Site oficial · Documentação de configuração
Como começar
- Instale o Desktop e selecione provedores locais para chat e embeddings. Se optar pelo Ollama, inicie-o primeiro.
- Crie um espaço, adicione poucos documentos legíveis e conclua a indexação. Separe projetos sem relação entre si.
- Peça respostas com trechos de origem. Adicione ferramentas de agente só depois de validar a busca básica e revisar os acessos.
Espaços separados ajudam a organizar a recuperação, mas não equivalem a autenticação e controle de acesso de um servidor multiusuário.
De qual hardware você precisa?
As faixas abaixo são sugestões conservadoras, não mínimos oficiais nem garantias de velocidade. O modelo divide memória com o sistema e precisa de espaço adicional para contexto e processamento.
| Configuração disponível | Ponto de partida sugerido |
|---|---|
| 8 GB de memória | Experimente um modelo quantizado de cerca de 1–3B e conversas curtas. Feche outros aplicativos e espere limitações. |
| 16 GB de memória | Um modelo de cerca de 4–8B em Q4 pode ser um primeiro teste, desde que seu consumo real caiba com folga. |
| 32 GB ou mais | Explore modelos maiores ou mais contexto, estimando antes o consumo da opção exata. |
| Windows com pouca VRAM | Descarregar parte do trabalho na CPU pode funcionar, mas reduz a velocidade. RAM e VRAM não são intercambiáveis. |
| Mac com Apple Silicon | A memória unificada é compartilhada com o sistema e a GPU; não destine toda a capacidade ao modelo. |
Q4 reduz a precisão dos pesos para economizar memória; não significa quatro gigabytes de consumo. Contextos longos precisam de recursos adicionais. Compare velocidade usando o mesmo computador, modelo, quantização, texto e contexto.
Sua primeira sessão de IA local
- Escolha um aplicativo e uma tarefa pequena, como revisar um parágrafo ou explicar código.
- Baixe conectado o aplicativo, motor, modelo e embeddings necessários. Várias quantizações podem ocupar muitos gigabytes duplicados.
- Use um modelo pequeno de instruções e contexto moderado. Peça uma reescrita que preserve nomes, números e datas.
- Para documentos, comece com texto selecionável e uma pergunta verificável. Confira acentos e a variante do português; para público brasileiro, peça português do Brasil.
- Desconecte a rede e repita em uma conversa nova. Isso testa o uso offline, mas não substitui uma avaliação completa de segurança.
Use somente o texto fornecido. Liste decisões, prazos explicitamente informados e perguntas pendentes. Inclua um trecho curto que sustente cada item. Quando faltar informação, diga isso; não invente datas nem compromissos.Uso offline, privacidade e custos
Inferência local evita cobrança por tokens do provedor, mas não elimina computador, energia e armazenamento. API remota e hospedagem são custos opcionais separados. Não é necessário contratar uma assinatura para testar um modelo local pequeno nestes aplicativos.
Privacidade depende do endpoint, embeddings, busca web, conectores, registros e pastas sincronizadas. Um histórico salvo localmente pode sair do computador se estiver em uma pasta de sincronização na nuvem.
Rodar localmente não remove a licença do modelo nem suas recusas. Roleplay e conteúdo adulto dependem do modelo e dos serviços conectados, não do nome do aplicativo. Confira as condições antes de uso comercial.
Problemas comuns e como resolver
O modelo não carrega
Verifique formato, arquitetura e motor. Depois tente quantização menor, menos contexto e mais memória livre.
A resposta demora
Separe carregamento inicial de geração. Confira GPU, economia de energia e pressão de memória; no Ollama, use ollama ps.
O documento é ignorado
Confirme a indexação e a coleção selecionada. PDFs escaneados podem precisar de OCR antes da consulta.
A API não conecta
Confira servidor, porta e nome do modelo. O localhost dentro do Docker não é o mesmo do computador anfitrião.
Perguntas frequentes
Posso usar sem internet?
Sim, após baixar todos os componentes e escolher uma configuração local. Nuvem, busca web e conectores remotos ainda exigem conexão. Prepare também os embeddings para consultar documentos offline.
Preciso de uma GPU NVIDIA?
Não. Modelos pequenos podem rodar na CPU. Apple Silicon, AMD e Intel têm caminhos que variam por aplicativo e motor; confira sua versão e drivers.
Qual usar em um Mac Intel?
Os requisitos do LM Studio Desktop não incluem Intel. O Ollama documenta CPU em Macs Intel compatíveis com macOS 14 ou superior. Confira o instalador e o sistema antes de baixar modelos grandes.
Trocar de aplicativo melhora a resposta?
Modelo, quantização e instruções costumam pesar mais. A interface pode melhorar recuperação e modelos de prompt, mas não garante exatidão. Teste com seu próprio material em português.
Também servem para gerar imagens e vídeos?
A seleção é voltada a linguagem. Entender imagens não é o mesmo que gerá-las; use um fluxo compatível de geração, como ComfyUI, com modelos e requisitos próprios.
Dá para conectar o motor a outro app?
Sim, quando as APIs forem compatíveis. Confira URL base, nome do modelo e recursos implementados; compatibilidade com OpenAI não cobre necessariamente todas as funções.
Comece com um app e um modelo pequeno
Comece por LM Studio ou Jan para uma experiência visual. Escolha Ollama se a integração desejada já pede esse motor. Para documentos, GPT4All atende coleções modestas; AnythingLLM ajuda a manter espaços organizados.
Valide qualidade em português, memória e uso offline com uma tarefa pequena antes de ampliar o projeto. Para decidir qual modelo baixar, continue com a comparação de modelos locais abaixo.
Guias relacionados: Melhores LLMs de Código Aberto Locais em 2026: Desempenho, NSFW e Hardware Comparados · Como montar uma estação de IA com GPU na nuvem: imagens, vídeos, LLM e NSFW (2026) · SillyTavern: guia para iniciantes em 2026, fichas de personagem e lorebooks
Relacionados
As melhores ferramentas de assistente de reunião com IA para resumir chamadas e poupar tempo

Best AI Product Photo Generators for Ecommerce
Os Melhores Criadores de Sites com IA em 2026 — Escolha o Ideal para o Seu Projeto
Gerador de Publicações com IA para Redes Sociais: As Melhores Ferramentas para Criar Posts Mais Depressa
Melhores ferramentas de expansão de imagem com IA: ampliar fotos e fazer outpainting

6 melhores ferramentas de reescrita com IA em 2026