Dolphin 3.0 Review: LLM Local Sem Censura para NSFW, Roleplay e Programação
O Dolphin 3.0 é um dos nomes clássicos no ecossistema de LLMs locais e sem censura. Não se trata apenas de mais um modelo de…

O Dolphin 3.0 é um dos nomes clássicos no ecossistema de LLMs locais e sem censura. Não se trata apenas de mais um modelo de referência: as pessoas procuram o Dolphin porque pretendem um modelo mais recetivo a seguir o prompt do sistema, mais flexível para escrita e roleplay, e menos filtrado do que os assistentes comerciais tradicionais.
Em suma: o Dolphin 3.0 R1 Mistral 24B destaca-se como a principal escolha de referência, caso disponha de memória de vídeo (VRAM) suficiente, enquanto o Dolphin 3.0 Llama 3.1 8B surge como o modelo de desktop mais acessível para Ollama, LM Studio e testes locais rápidos. É ideal para escrita criativa, roleplay, programação, matemática e fluxos de trabalho locais do tipo agente, embora a implementação pública exija as suas próprias regras de segurança.
Índice
O que é o Dolphin 3.0?
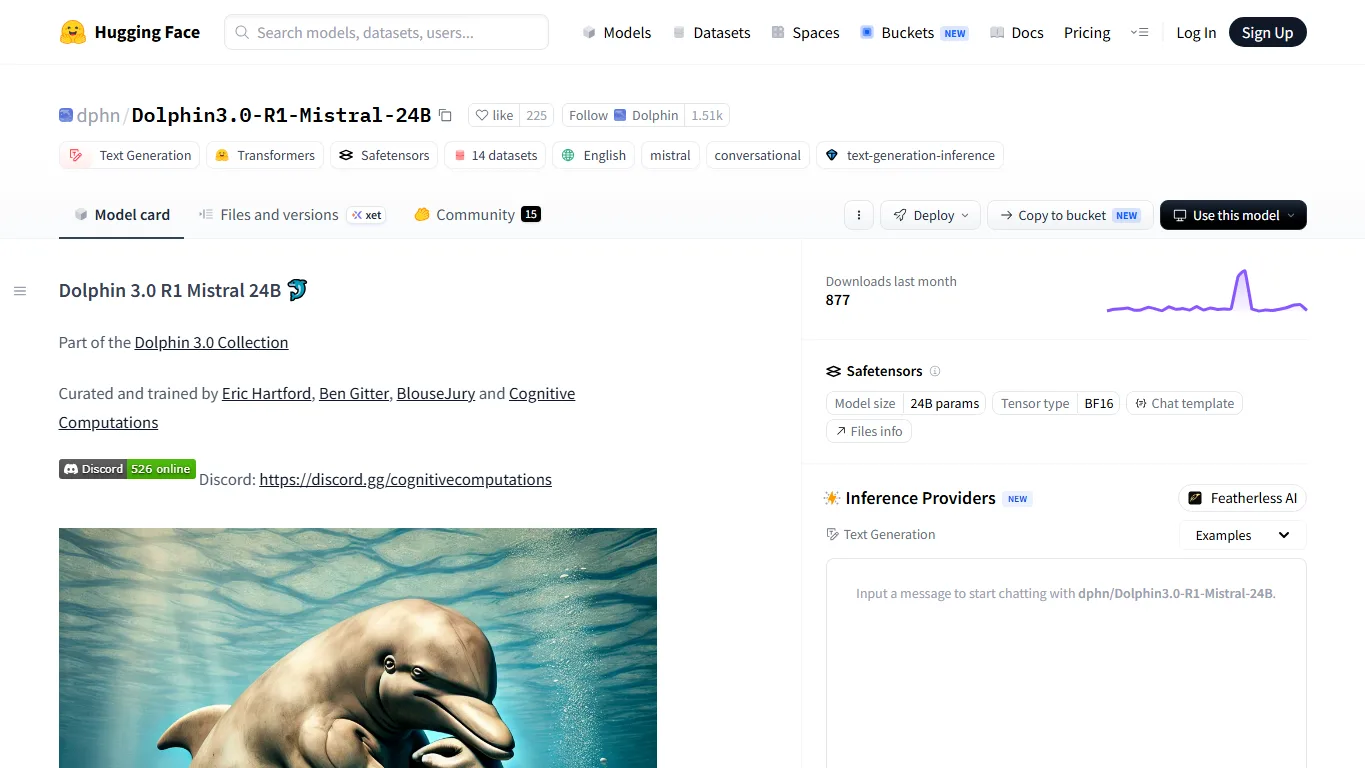
O Dolphin 3.0 é uma família de modelos locais ajustados para instruções (instruction-tuned), curados por Eric Hartford, Ben Gitter, BlouseJury e Cognitive Computations. A página do modelo Dolphin3.0-R1-Mistral-24B descreve-o como um modelo local de uso geral para programação, matemática, tarefas baseadas em agentes, chamada de funções (function calling) e conversação ampla. Além disso, evidencia a filosofia do Dolphin: o proprietário do sistema, e não o criador do modelo, deve definir o prompt do sistema e a política de alinhamento.
É precisamente esta filosofia que tem mantido a popularidade do Dolphin na comunidade local. É frequentemente escolhido por utilizadores que consideram os assistentes convencionais demasiado restritivos no que respeita a ficção, roleplay privado, experimentação local ou investigação do comportamento de prompts. Contudo, convém lembrar que o Dolphin continua a ser apenas um modelo: pode sofrer de alucinações, seguir prompts incorretos e gerar conteúdos inadequados para produtos públicos sem moderação.
Transações Oficiais
| Modelo | Ideal para | Descarregar |
|---|---|---|
| Dolphin 3.0 R1 Mistral 24B | Melhor qualidade geral na linha clássica Dolphin 3.0; programação, matemática, roleplay e tarefas de agentes | Hugging Face 24B |
| Dolphin 3.0 Llama 3.1 8B | Testes em GPUs de consumo, chat local no desktop, roleplay rápido e escrita | Hugging Face 8B |
| Dolphin 3.0 Llama 3.1 8B GGUF | llama.cpp, LM Studio, KoboldCPP e utilização local estilo Ollama | GGUF 8B Oficial |
| Dolphin 3.0 R1 Mistral 24B GGUF | Testes quantizados de 24B em desktop/servidor | GGUF 24B de Bartowski |
| Ollama dolphin3 | Configuração local rápida com um único comando para 8B | Ollama dolphin3 |
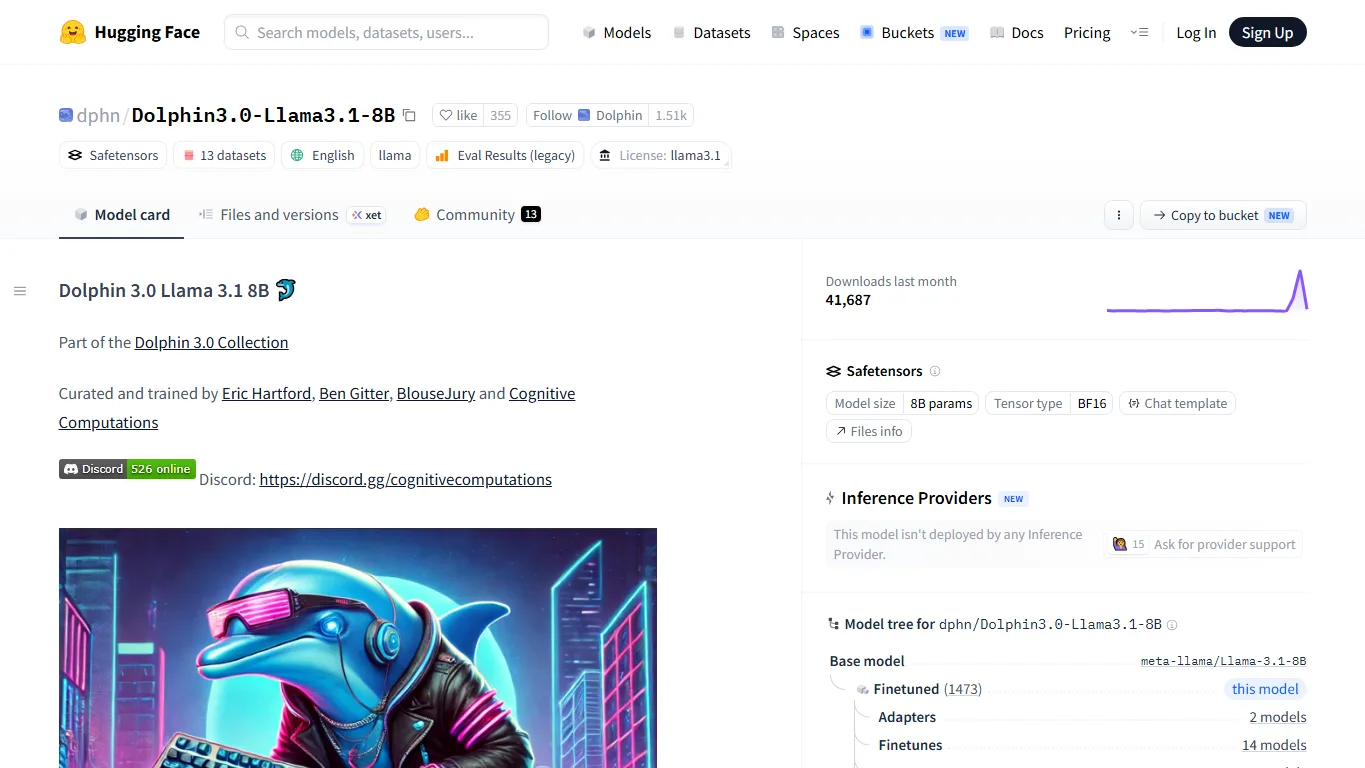
Se está a dar os primeiros passos com o Dolphin, comece pela versão de 8B ou pelo Ollama. Avance para o modelo de 24B apenas quando dominar os seus prompts, o comprimento do contexto e os limites do seu hardware. Embora o modelo de 24B seja o mais interessante para análise, a variante de 8B é a que a maioria dos utilizadores consegue executar sem alterar a sua estação de trabalho.
Impressões dos Utilizadores e Pontos Fortes
O interesse da comunidade no Dolphin foca-se habitualmente em três aspetos: obediência aos prompts, estabilidade na escrita/roleplay e menor incidência de recusas. Este modelo não pretende ser o assistente geral mais seguro possível, mas sim um modelo local controlável que permite ao utilizador definir o comportamento através do prompt do sistema.
Comparativamente a muitos modelos de chat oficiais, o Dolphin revela-se mais direto e menos paternalista. Tal torna-o particularmente útil para escrita de ficção, diálogo de personagens, brainstorming privado, agentes locais e assistentes de programação em que o utilizador exige um forte cumprimento de instruções. Em contrapartida, exige maior rigor por parte do utilizador: se o prompt for deficiente, o resultado sê-lo-á de forma evidente.
Comparação com Outros LLMs Locais
| Modelo | Como se compara com o Dolphin 3.0 | Quem deve escolhê-lo |
|---|---|---|
| Dolphin 3.0 | Abordagem clássica de ajuste sem censura, forte controlo via prompt de sistema, popular para escrita e roleplay. | Utilizadores que pretendem flexibilidade local e menos recusas. |
| Qwen 3.8 | Ecossistema multilíngue/de programação mais abrangente e nova família de modelos de grande porte; maior alinhamento de segurança nas vias oficiais. | Utilizadores que necessitam de trabalhar em japonês, chinês e inglês, além de programação e RAG. |
| Gemma 4 | Família de modelos apoiada pela Google, com documentação oficial mais limpa e foco multimodal; menos centrado em conteúdos sem censura por predefinição. | Utilizadores que preferem pesos abertos tradicionais e documentação de segurança consolidada. |
| Ajustes de Llama 3.1 / Llama 4 | Ecossistema massivo e muitos derivados sem censura; o Dolphin destaca-se como uma linha curada reconhecível. | Utilizadores que procuram o máximo leque de opções de modelos comunitários. |
| Mistral Small 24B | O estilo base subjacente à rota de 24B é capaz, mas o Dolphin altera o perfil de cumprimento de instruções e recusas. | Utilizadores que preferem um modelo de instruções mais convencional. |
| Modelos Nous / Hermes | Também sólidos em roleplay e seguimento de instruções; habitualmente menos comercializados explicitamente como sem censura. | Utilizadores que comparam a escrita criativa e o comportamento de agentes. |
Configuração Local
A via mais simples para o modelo de 8B é o Ollama. Oculta a maioria dos detalhes de instalação e revela-se adequado para testes rápidos de chat, experiências com prompts e fluxos de trabalho de escrita local.
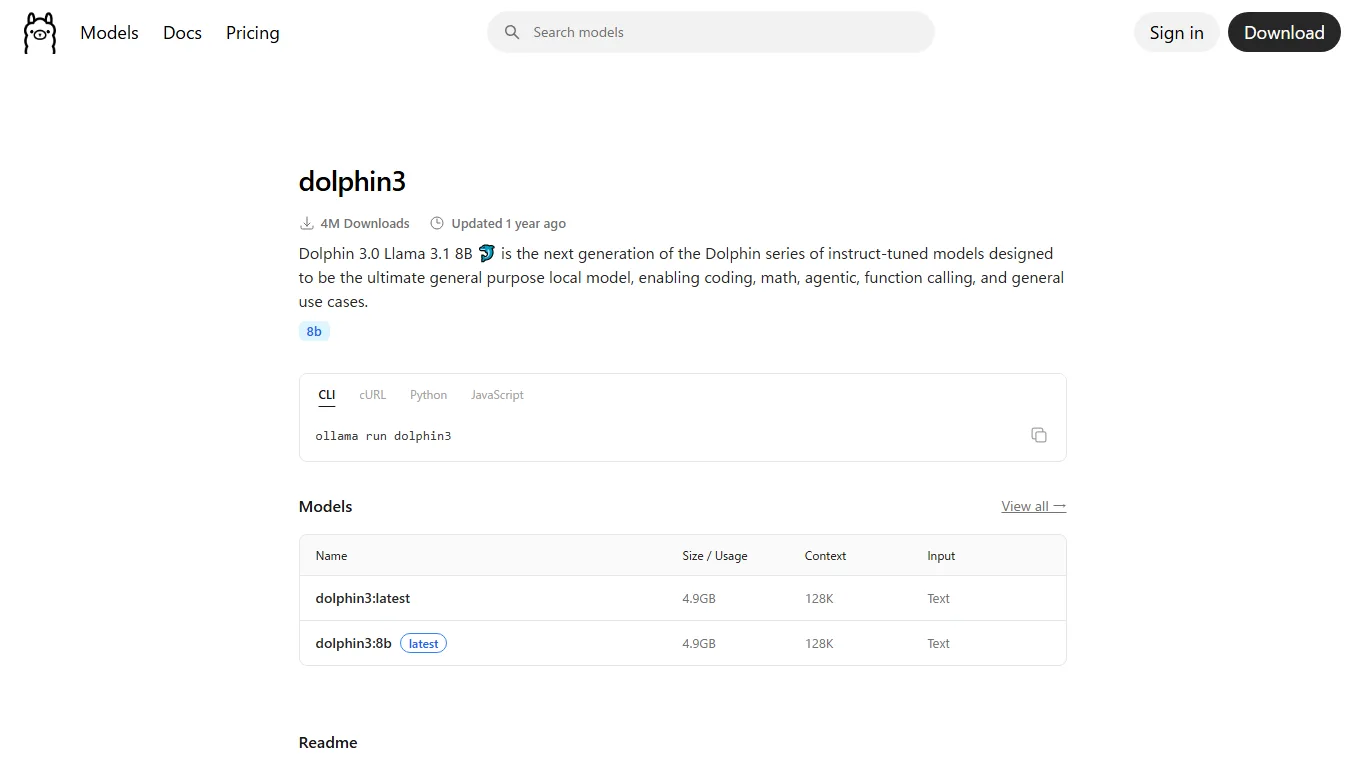
ollama pull dolphin3 ollama run dolphin3Para ficheiros GGUF, utilize o LM Studio ou o llama.cpp. No caso do modelo completo Safetensors de 24B, utilize o Transformers ou uma pilha de alojamento como o vLLM, caso o seu hardware o permita.
pip install -U transformers accelerate torch safetensors python - <<'PY' from transformers import AutoModelForCausalLM, AutoTokenizer model_id = "dphn/Dolphin3.0-R1-Mistral-24B" tok = AutoTokenizer.from_pretrained(model_id) model = AutoModelForCausalLM.from_pretrained( model_id, torch_dtype="auto", device_map="auto", ) PYRequisitos de Hardware (GPU)
| Modelo | Estimativa BF16 | Abordagem prática | Notas |
|---|---|---|---|
| Dolphin 3.0 Mistral 24B | Cerca de 48GB+ para os pesos, mais com contexto longo e cache KV | Uma GPU de 24GB pode ser viável com construções GGUF/quantizadas de 4 bits e contexto mais reduzido | Excelente qualidade, mas não é o modelo local mais fácil de correr. |
| Dolphin 3.0 Llama 3.1 8B | 16GB+ é confortável para utilização em formato BF16 | 6GB-12GB podem funcionar com quantização GGUF | O melhor primeiro modelo para GPUs domésticas. |
| GGUF apenas com CPU | Não requer VRAM, mas é mais lento | Utilize GGUF Q4/Q5 com llama.cpp ou LM Studio | Adequado para testes de escrita, mas desaconselhado para agentes longos. |
| API / Chat online | Sem GPU local | Utilize o web chat do Dolphin, o OpenRouter ou outro fornecedor | Ideal para avaliação antes de efetuar o descarregamento. |
Os requisitos reais de memória dependem da quantização, do comprimento do contexto, do tamanho do lote (batch size), da cache KV, da descarga para GPU (offload) e da ferramenta de execução. Em cenários de roleplay ou escrita com contexto longo, o consumo de memória aumenta rapidamente. Se um modelo carregar, mas ficar lento ou bloquear, reduza o comprimento do contexto antes de assumir que o modelo está inutilizável.
Utilização Online Quando o seu Hardware não é Suficiente
O ponto de acesso web oficial do Dolphin encontra-se em dphn.ai/chat, sendo que a organização Dolphin no Hugging Face também encaminha os utilizadores para os canais oficiais do projeto. Esta é a opção mais limpa para começar, caso pretenda compreender o projeto antes de descarregar um modelo local.
Para testes com recurso a API, a página de Computações Cognitivas do OpenRouter pode ser útil. Lista os modelos de Cognitive Computations e permite aos programadores comparar preços, janelas de contexto e capacidades. O Venice constitui outro serviço de chat de IA online frequentemente considerado por utilizadores focados na privacidade e adeptos de chats menos restritos, embora deva ser encarado como um serviço separado e não como o site oficial do Dolphin.
Comportamento NSFW e Sem Censura
O Dolphin 3.0 destaca-se como uma das famílias de modelos locais sem censura mais conhecidas. Para utilização privada local, mostra-se consideravelmente mais recetivo a prompts adultos, de roleplay ou criativos sensíveis do que os assistentes comerciais tradicionais. Esta é a principal razão pela qual os utilizadores procuram o Dolphin utilizando termos como NSFW, sem censura, roleplay e LLM local livre de jailbreak.
Ainda assim, “sem censura” não significa inofensivo ou ilimitado. O Dolphin pode gerar conteúdos para adultos, sugestões inseguras, material tendencioso ou conteúdos legalmente sensíveis, caso receba instruções nesse sentido. O modelo não substitui automaticamente a definição de políticas de utilização. Se o implementar para acesso público, necessitará de estabelecer as suas próprias regras, filtros, procedimentos de registo e gestão de abusos. Para uso pessoal, mantenha-o em ambiente local e informe-se sobre as leis e as regras da plataforma aplicáveis na sua região.
A melhor forma de encarar o Dolphin não é como um modelo mágico isento de consequências, mas sim como um ajuste local altamente controlável. Revela-se excelente quando pretende que o prompt do sistema seja rigorosamente respeitado e assume a responsabilidade pelo que solicita ao modelo.
Perguntas Frequentes
O Dolphin 3.0 é realmente sem censura?
Apresenta uma taxa de recusa muito inferior à dos assistentes comerciais tradicionais e é amplamente reconhecido na tradição de modelos ajustados sem censura. No entanto, o comportamento continua a depender da variante do modelo, do prompt, da ferramenta de execução e de qualquer camada de moderação que decida acrescentar.
Com que modelo do Dolphin 3.0 devo começar?
Comece pelo Dolphin 3.0 Llama 3.1 8B através do Ollama ou GGUF, caso disponha de um computador de secretária convencional. Experimente o Dolphin 3.0 R1 Mistral 24B quando pretender obter melhor qualidade e possuir VRAM suficiente ou uma versão quantizada.
Uma RTX 4090 de 24GB consegue executar o modelo de 24B?
O modelo BF16 completo de 24GB é demasiado volumoso para uma utilização confortável em 24GB de VRAM, mas as versões GGUF de 4 bits ou outras construções quantizadas tornam-se viáveis com um contexto mais curto e definições cuidadosas.
O Dolphin é adequado para japonês?
Consegue responder em japonês, mas não é primariamente reconhecido como um modelo especializado nessa língua. O Qwen ou outros modelos multilíngues podem revelar-se mais robustos para escrita em japonês polido. O principal apelo do Dolphin reside na obediência aos prompts e no comportamento de roleplay sem censura.
É seguro utilizar o Dolphin online?
Os fornecedores online possuem as suas próprias políticas de privacidade, registos de dados (logs), moderação e termos de serviço. Para prompts sensíveis, a utilização local é sempre mais segura. Para avaliações rápidas, os sites online são práticos, desde que não carregue material confidencial.
Posso utilizar o Dolphin comercialmente?
Deve verificar a licença do modelo exato, bem como de qualquer modelo base ou conversão GGUF que descarregue. A licença e os termos de utilização aceitável podem variar entre os pesos base, os ajustes (fine-tunes) e as versões quantizadas carregadas por terceiros.
Veredito
O Dolphin 3.0 continua a ser um dos exemplos mais claros da via clássica de ajustes locais sem censura. É fácil de recomendar quando o leitor procura escrita criativa, roleplay, prompts orientados a agentes, assistência em programação e um menor número de recusas em comparação com os assistentes de chat tradicionais.
O melhor ponto de partida é o modelo de 8B através do Ollama ou GGUF. O modelo Mistral de 24B representa a opção de qualidade mais exigente para quem dispõe de hardware superior. No que respeita a utilizações NSFW e sem censura, o modelo é potente precisamente porque devolve o controlo ao utilizador, o que também significa que cabe a este assumir uma maior responsabilidade.
Referências
Relacionados Avaliações
Seedream 5.0 Pro: Análise ao Modelo de IA de Imagem, Acesso à API e Política de Conteúdos Sensíveis (NSFW)

Análise de Z-Image: Turbo, Base, VRAM, LoRA e Uso Local NSFW
NoobAI XL Review: VRAM, LoRA, V-Pred, Prompts e Utilização Local NSFW
Análise do Nucleus Image: 17B Sparse MoE, Instalação Local, Suporte para NSFW e Pesos Abertos Apache 2.0
Review do Grok 4.6: raciocínio, agentes, preço e política NSFW

Análise do FLUX 3: Vídeo, Imagem, Open Weights e Política de NSFW