【2026年最新】AIモデルTOP10:Arena順位・料金・用途を比較
2026年10月のArena上位10エントリーを比較。Gemini、Claude、Museの仕様、API料金、利用先、実際のレビューから用途に合うモデルを選べます。

最新のText Arena総合ランキングではGemini 4 Argonが首位です。ただし、最初に試すモデルは用途で変わります。難しい開発や文書作成ならClaude Opus 5.5、継続的な処理で費用を抑えるならGemini 3.8 Flash、長時間動くエージェントを試すならMuse Wonderが候補です。
今回のTOP10は、チャットサービス10社の比較ではありません。同じモデルでも推論設定が異なると別のエントリーになり、Opus 4.6も2回登場します。順位を候補選びの入口にし、実際の成果、利用条件、1件の仕事を終える費用で判断しましょう。
確認日:2026年10月14日。ランキングのデータ日:2026年10月13日。
Arena最新TOP10を一覧で比較
対象はArenaのText → Overallです。画像、動画、コーディング、エージェント専用の順位とは異なります。スコアは回答比較での好まれ方を表し、正答率ではありません。近い順位は誤差が重なり、例えばWonderの順位範囲は1〜11位です。2位と3位に明確な差があるとは限りません。
high、max、xHighは評価時の設定を示す表記で、パラメータ数ではありません。各アプリで同じ設定を選べるとも限りません。上位10件はすべてプロプライエタリモデルで、参照した公式仕様ではパラメータ数は非公開です。1Mコンテキストは約100万トークンの作業領域を指し、モデルの重みの数とは別物です。
| 順位 | Arenaのエントリー名 | スコア・誤差 | 投票数 | API料金(米ドル/100万トークン):入力/出力 | コンテキスト |
|---|---|---|---|---|---|
| 1 | gemini-4-argon-high | 1525 ±9 * | 4,903 | $2 / $10 | 1M |
| 2 | muse-wonder-max | 1513 ±13 | 1,944 | $4 / $20 | 1M |
| 3 | claude-opus-5.5-high | 1508 ±8 | 7,687 | $4 / $20 | 1M |
| 4 | claude-fable-5-high | 1503 ±4 | 41,439 | $10 / $50 | 1M |
| 5 | claude-opus-4-6-high | 1503 ±3 | 80,827 | $5 / $25 | 1M |
| 6 | claude-opus-4-7-high | 1501 ±4 | 65,125 | $5 / $25 | 1M |
| 7 | claude-fable-5.1-max | 1501 ±6 | 14,121 | $10 / $50 | 1M |
| 8 | claude-opus-4-6 | 1498 ±3 | 85,445 | $5 / $25 | 1M |
| 9 | gemini-3.8-flash-high | 1496 ±5 * | 35,670 | $0.75 / $3.75 | 1M |
| 10 | muse-spark-1.2 (xHigh) | 1495 ±7 | 7,611 | $1.25 / $4.25 | N/A |
表は標準APIの入力/出力単価(100万トークン当たり・米ドル)です。日本向け月額料金や税込円価格ではありません。推論、出力量、キャッシュ、ツール利用でも総額は変わります。Argonの$2/$10は2026年11月30日までで、以降は$4/$20。Flashの導入料金は12月31日までです。*はArenaの暫定スコア、N/Aはコンテキスト値の記載なしを意味します。
各モデルの特徴と選ぶ理由
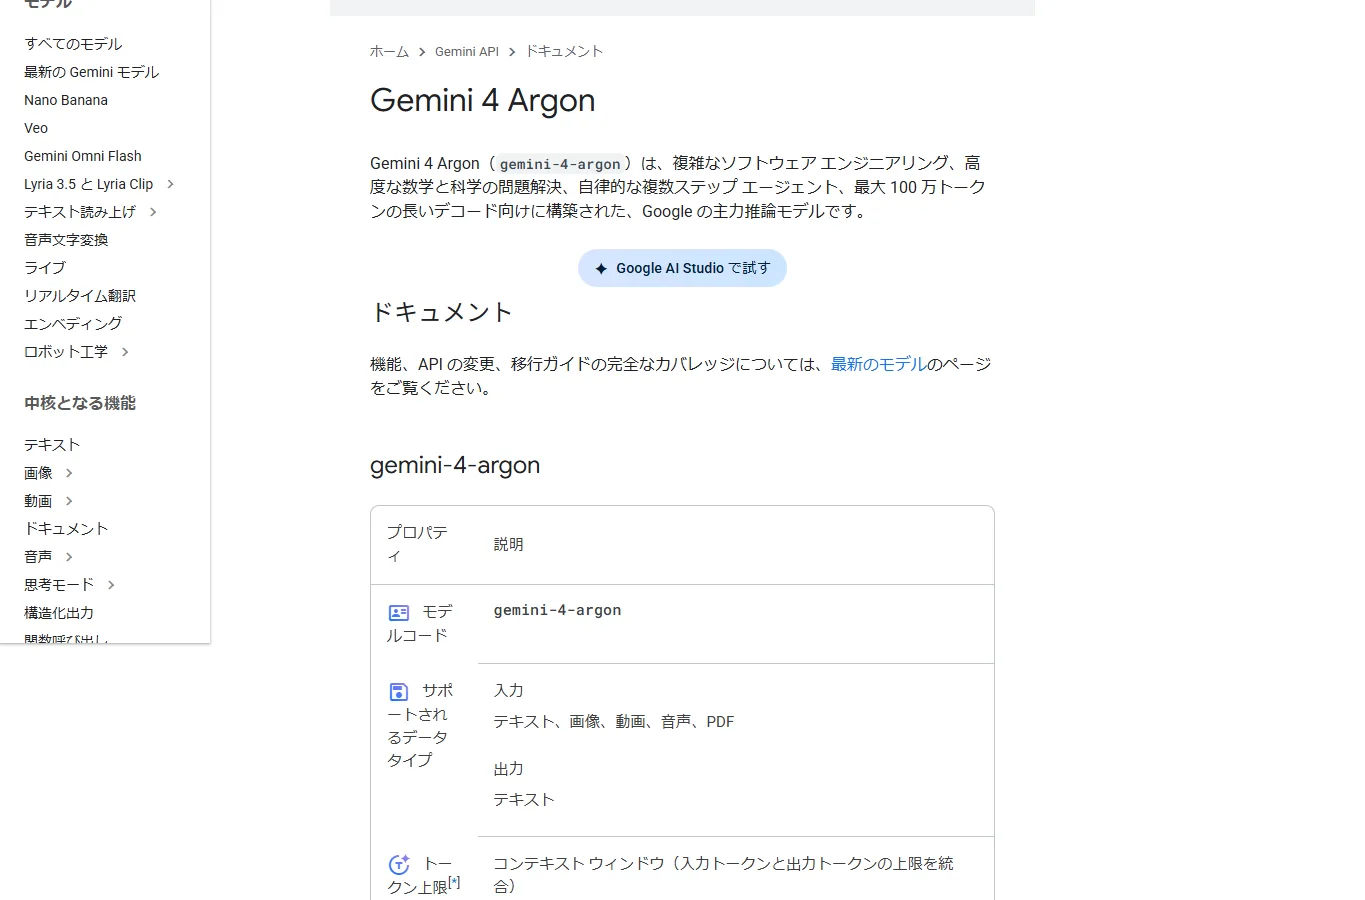
1. Gemini 4 Argon(high) — 難しいマルチモーダル作業向けの首位モデル
主な仕様: パラメータ数非公開。入力・推論・出力で共有する1,048,576トークンの枠。テキスト・画像・音声・動画・PDF入力、テキスト出力。通常の同期出力は65,536トークン。
資料、画像、動画を組み合わせて考えさせる仕事が有力な用途です。長い出力にも対応しますが、入力と推論も同じ枠を使います。「100万トークン入力+別枠で100万出力」ではありません。ランキングではhigh設定で、APIの標準はmediumです。
10月13日からGeminiアプリのGoogle AI Pro/Ultra利用者にも開放されました。開発には有料Gemini APIを使えます。開発者向け案内ではAI StudioやAntigravityのUltra向けアクセスも説明されています。月額契約にAPI無制限利用が含まれるわけではありません。
レビューと選び方: Tim Simmonsの先行体験では、ゲーム制作や動画編集などで粘り強く作業を進めた一方、人の仕上げ確認も必要でした。一発で完成する保証ではなく、具体的なワークフローの体験談として読むのが適切です。highを常用する前に待ち時間と費用を比べましょう。
公式モデル情報 · オンライン利用・API · API / AI Studio
2. Muse Wonder(max) — 長時間のエージェント処理に注目
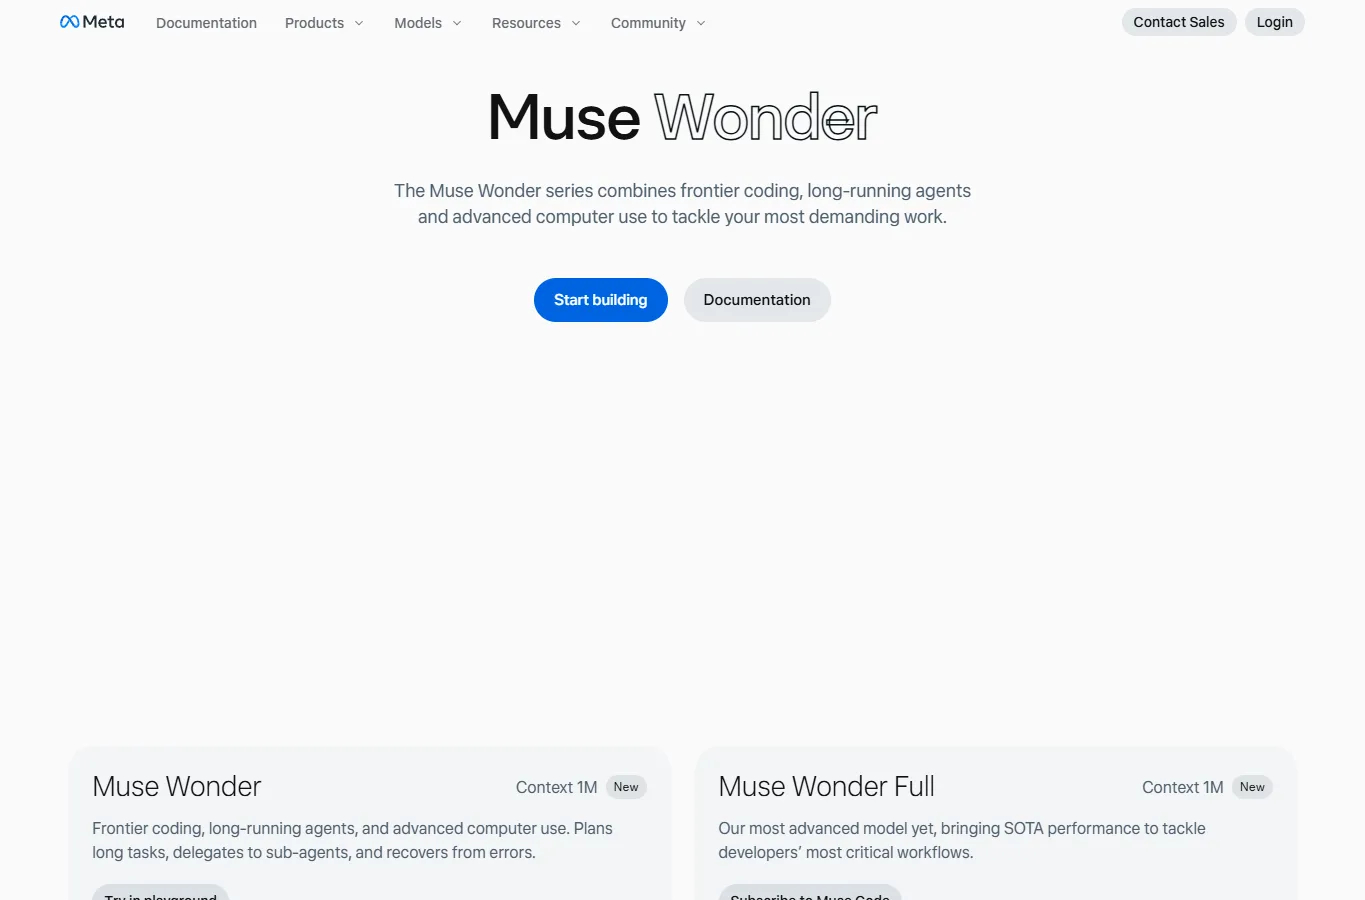
主な仕様: パラメータ数非公開。1Mコンテキスト。入力$4/出力$20。順位はWonderのmaxで、Wonder Fullではありません。
Metaが重視するのは会話をまたぐ記憶と、複数段階の仕事を継続する力です。Meta Model API、Muse Code、開発者向けプレイグラウンドが利用先です。別モデルのWonder Fullは対象のMuse Code契約が必要で、今回の2位と混同できません。
Axiosは新たなフロンティアモデルの登場として報道しています。Spring Promptの10月13日の実測では、与えた調査データの分析は良好でも、スライドの配置や販売文の根拠に問題が残りました。主にmediumでの標準Wonderの試験であり、maxの成績とは区別すべきです。
レビューと選び方: 実際に使うツール環境で、修正回数と完成物を確認しましょう。テキスト順位だけでは、記憶機能や外部ツールを含むエージェント全体の性能までは分かりません。
公式モデル情報 · オンライン利用・API · API / Meta
3. Claude Opus 5.5(high) — 新しくClaudeを使う人の有力な出発点
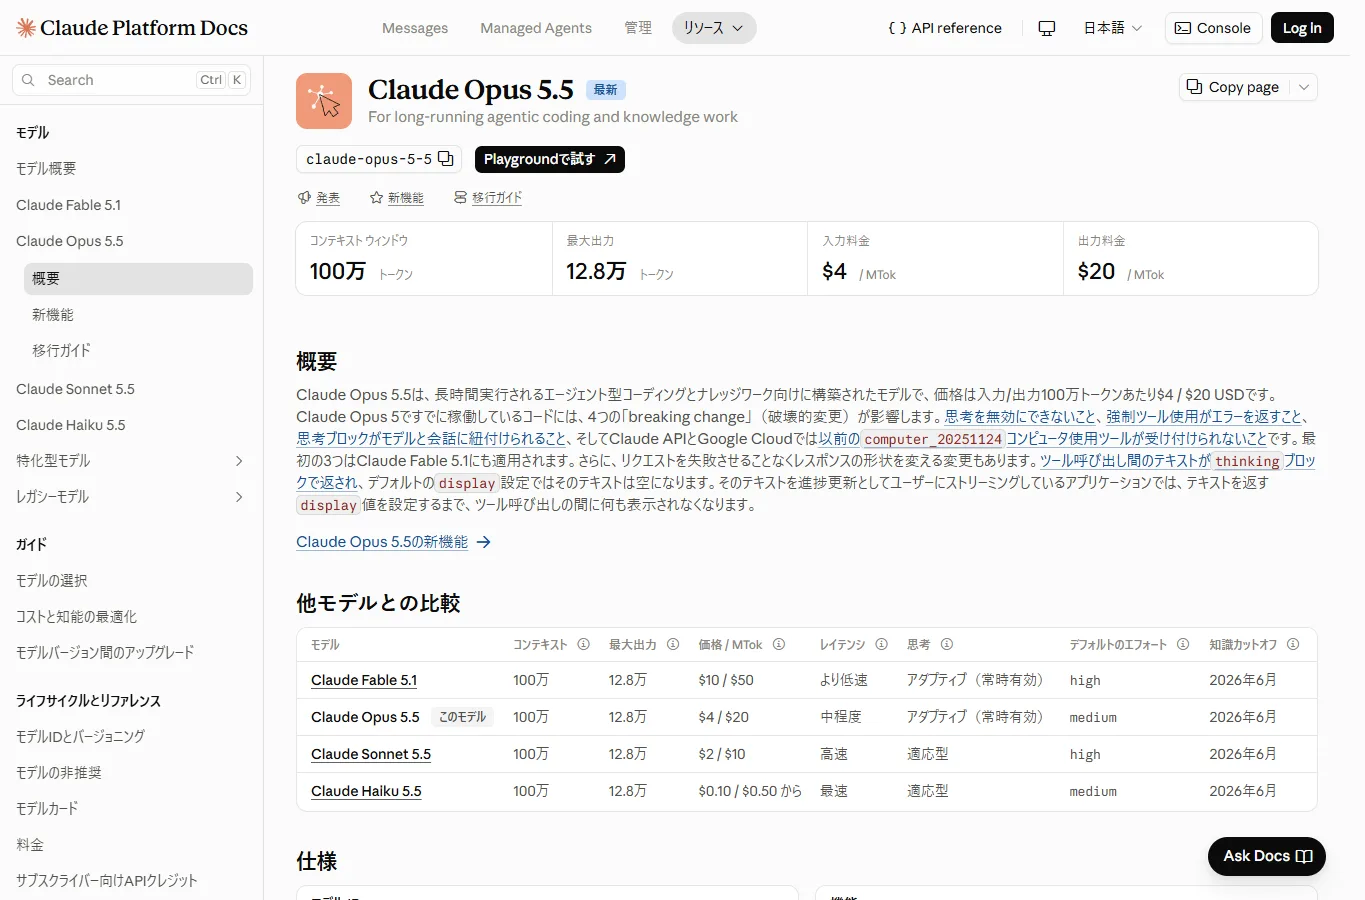
主な仕様: パラメータ数非公開。1Mコンテキスト、最大128K出力。テキスト・画像入力。入力$4/出力$20。
難しいコード、調査、文書作成を任せたい場合の候補です。表にある旧Opusより標準単価が低く、API IDはclaude-opus-5-5。チャットはClaude、開発はClaude Code、API連携はClaude Platformから始められます。利用上限やツールはプランで異なります。
MacRumorsの紹介は主にAnthropicによる性能・料金改善の発表を伝えたものです。一方、DataLLM Labの9問の小規模Python試験では全問を処理できましたが、安いモデルも同じ試験を通過しています。簡単な仕事で高額モデルを使う理由にはなりません。
レビューと選び方: 新規のClaude環境ではまず5.5を試し、単純な処理はFlashとも比較するのがおすすめです。旧モデルの順位が近いという理由だけで、高い単価を選ぶ必要はありません。
公式モデル情報 · オンライン利用・API · API / Claude Platform
4. Claude Fable 5(high) — 順位は高いが、最新のFableではない
主な仕様: パラメータ数非公開。1Mコンテキスト。入力$10/出力$50。
Fable 5は長時間の開発、分析、視覚情報の理解を重視した一般向けモデルです。制限付きのMythosと同じ利用条件ではありません。旧バージョンを使うなら、現在のモデル一覧や契約で選べるか確認してください。
Tom’s Guideの体験記事は、単発の回答から長いプロジェクトを進める方向への変化を評価しています。ただし新規契約ならFable 5.1とOpus 5.5を先に比較する方が合理的です。
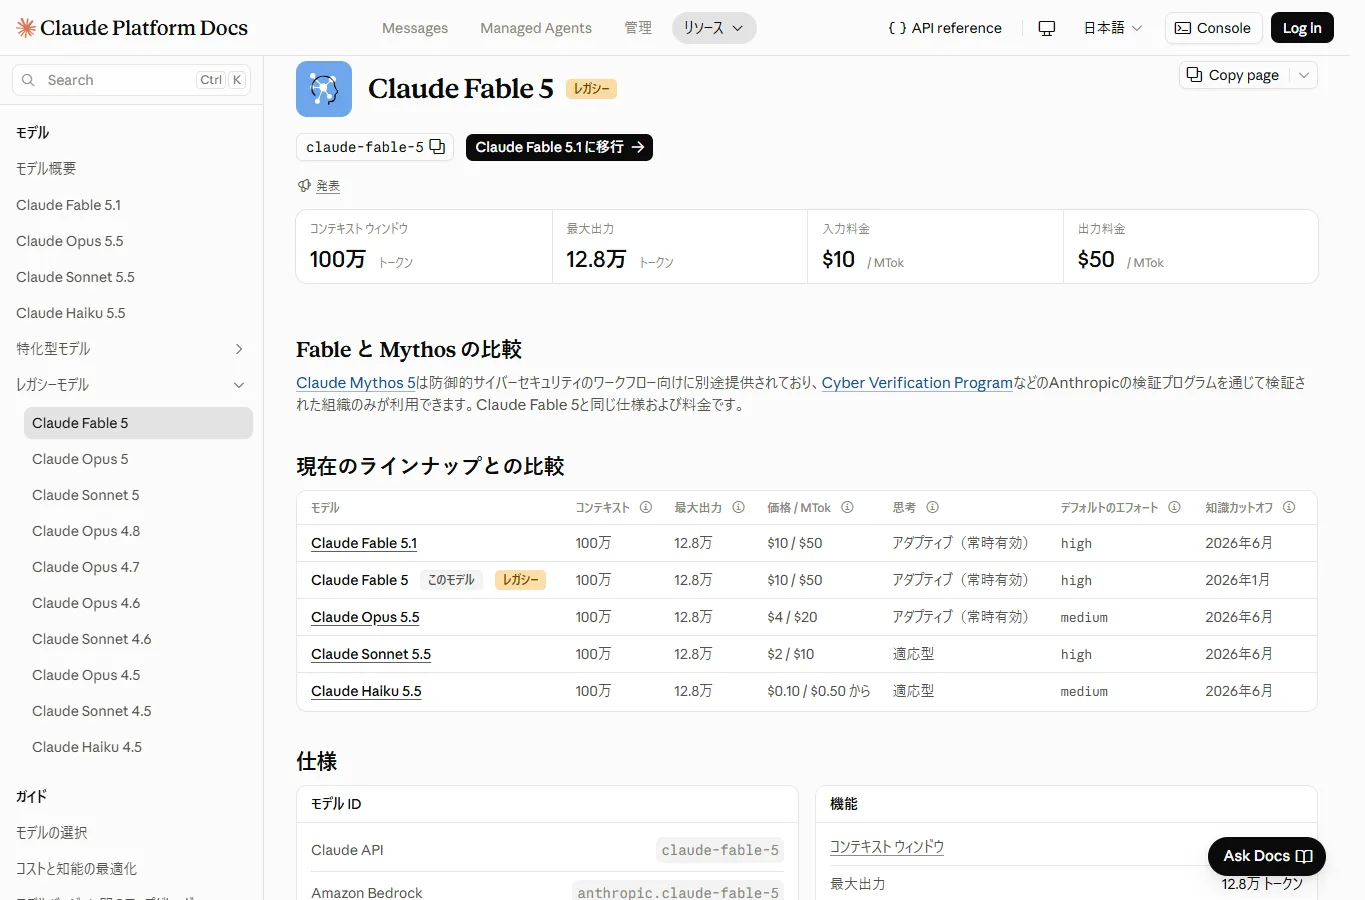
レビューと選び方: 既存のFable 5用プロンプトや検証済みシステムがある人向け。ランキングを理由に古い世代へ戻すより、実作業で移行の影響を調べましょう。
公式モデル情報 · オンライン利用・API · API / Claude Platform
5. Claude Opus 4.6(high) — 投票数が多い旧世代の実力派
主な仕様: パラメータ数非公開。1Mコンテキスト、通常最大128K出力。入力$5/出力$25。
8万票以上が集まった構成で、新登場モデルより標本が大きい点は参考になります。現在の公式文書ではレガシー扱いで、5.5への移行検討が推奨されています。1Mの利用も現在は標準単価です。
開発者Simon Willisonは2月の利用報告でClaude CodeのOpus 4.6を多用していました。ただしこれは当時の体験であり、10月時点で5.5より優れるという意味ではありません。
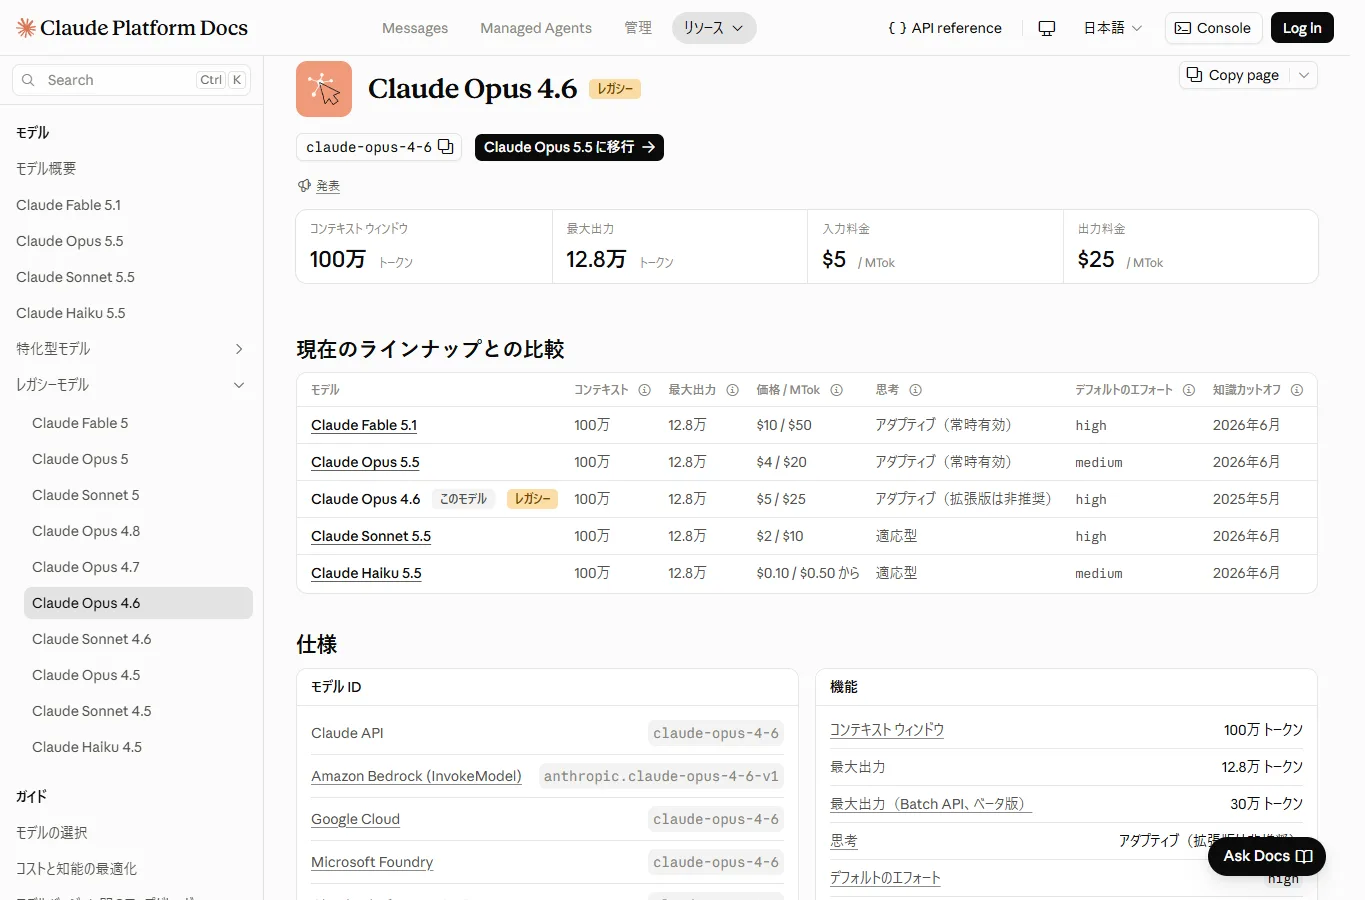
レビューと選び方: 既存の評価で優位性が確認できるなら継続する理由があります。highの推論時間が、日常の小さな作業でも必要かは別途判断しましょう。
公式モデル情報 · オンライン利用・API · API / Claude Platform
6. Claude Opus 4.7(high) — 開発・画像理解の改善とトークン数の注意点
主な仕様: パラメータ数非公開。1Mコンテキスト。入力$5/出力$25。4.6より高解像度の画像理解を強化。
複雑なコード修正、指示の精密な実行、出力の自己検証を重視した世代です。図表やUI、リポジトリを扱う作業も候補になります。現在のClaude既定モデルとは限らないため、旧バージョンの指定にはAPI提供状況の確認が必要です。
Willisonの測定では、ある長文のトークン数が新トークナイザーで約1.46倍になりました。全作業の請求が1.46倍になるという意味ではありません。またペリカンのSVG比較では小型ローカルモデルを好んでおり、単一の順位で全用途を判断できないことも示しています。
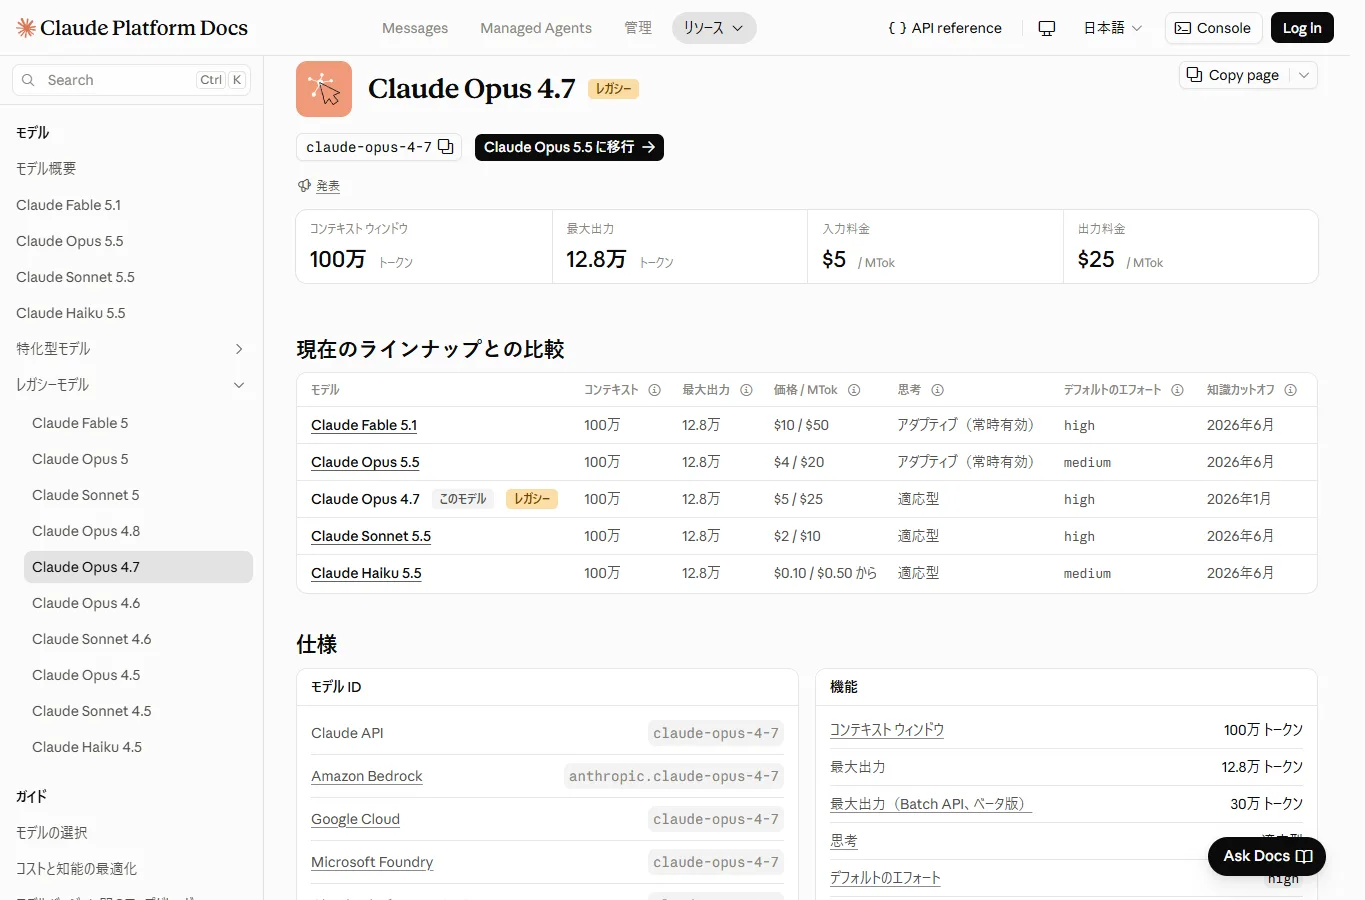
レビューと選び方: 自分の文書のトークン数と完成までの費用を比較してください。同じ単価でも同じ総額にはならず、順位の微差だけでは更新の価値も判断できません。
公式モデル情報 · オンライン利用・API · API / Claude Platform
7. Claude Fable 5.1(max) — 高度な長文作業向け。キャッシュが費用を左右
主な仕様: パラメータ数非公開。1Mコンテキスト、128K出力。入力$10/出力$50、キャッシュ読み取り$0.25/100万トークン。
人の修正時間を大きく減らせる難しい分析、執筆、エージェント作業で検討したいモデルです。値下げの中心はキャッシュ読み取りで、通常の入力・出力単価はFable 5と同じです。毎回短い新規質問をする使い方とは節約効果が異なります。
Fable 5.1は一般提供され、Claude APIなどで利用できますが、Mythos 5.1は制限付きです。No Code MBAのレビューと開発者テストでも、日常的なアプリ制作にこの価格が必要かが論点になっています。
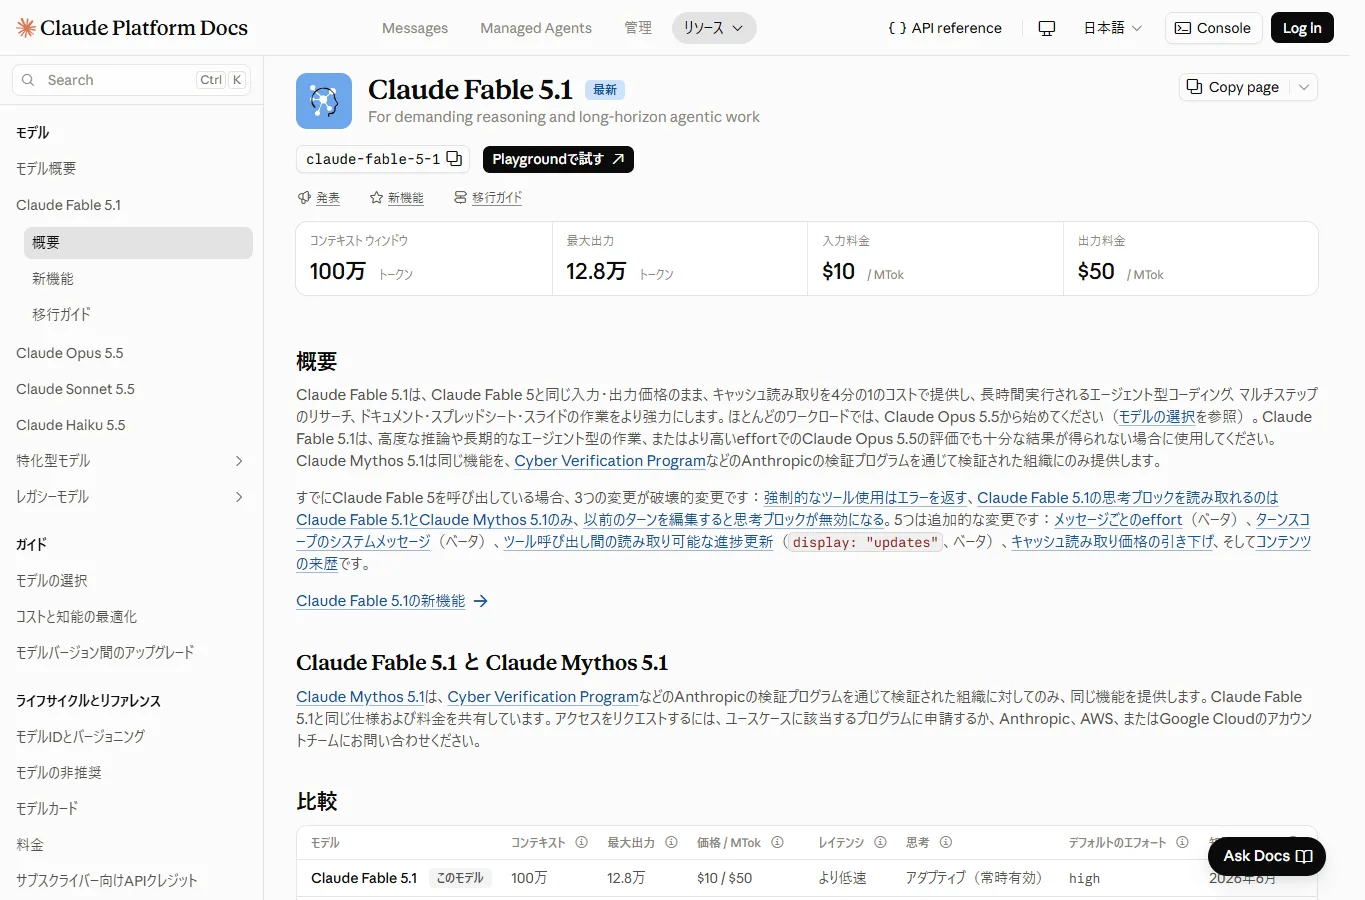
レビューと選び方: まず安いモデルで同じ仕事を試し、品質差が出る場合に選びましょう。Arenaのmax設定が、すべての契約でそのまま使えるとは限りません。
公式モデル情報 · オンライン利用・API · API / Claude Platform
8. Claude Opus 4.6(別エントリー) — 別製品ではなく、同じモデル系列
主な仕様: Opus 4.6と同じ系列。パラメータ数非公開。1Mコンテキスト、入力$5/出力$25。
high表記のない別行ですが、それだけで「推論なし」と断定はできません。行の情報だけでは評価時の全設定は分かりません。high版との点差は5で、表示上の誤差も重なっています。
利用先とモデル系列のレビューは5位と共通です。別のサービスを契約するより、自分の作業で推論設定を比べる材料にしてください。10種類の異なる系列を選ぶなら、Arenaの上位10行そのものとは別の選定方法になります。
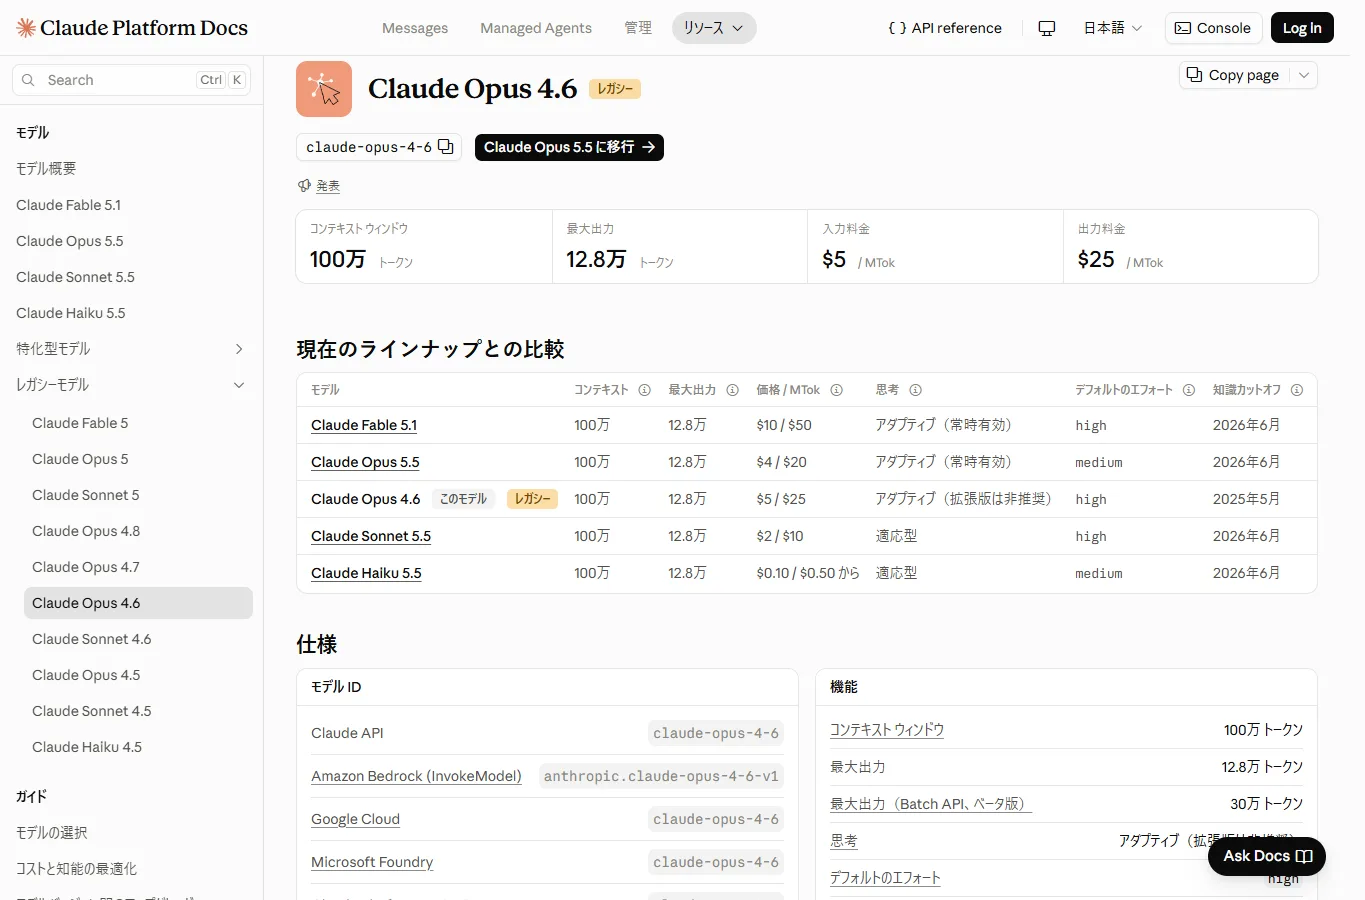
レビューと選び方: 独立した製品や別仕様があるようには扱いません。詳細は5位の説明とOpus 4.6公式文書を参照してください。
公式モデル情報 · オンライン利用・API · API / Claude Platform
9. Gemini 3.8 Flash(high) — このTOP10で標準単価が最も低い選択肢
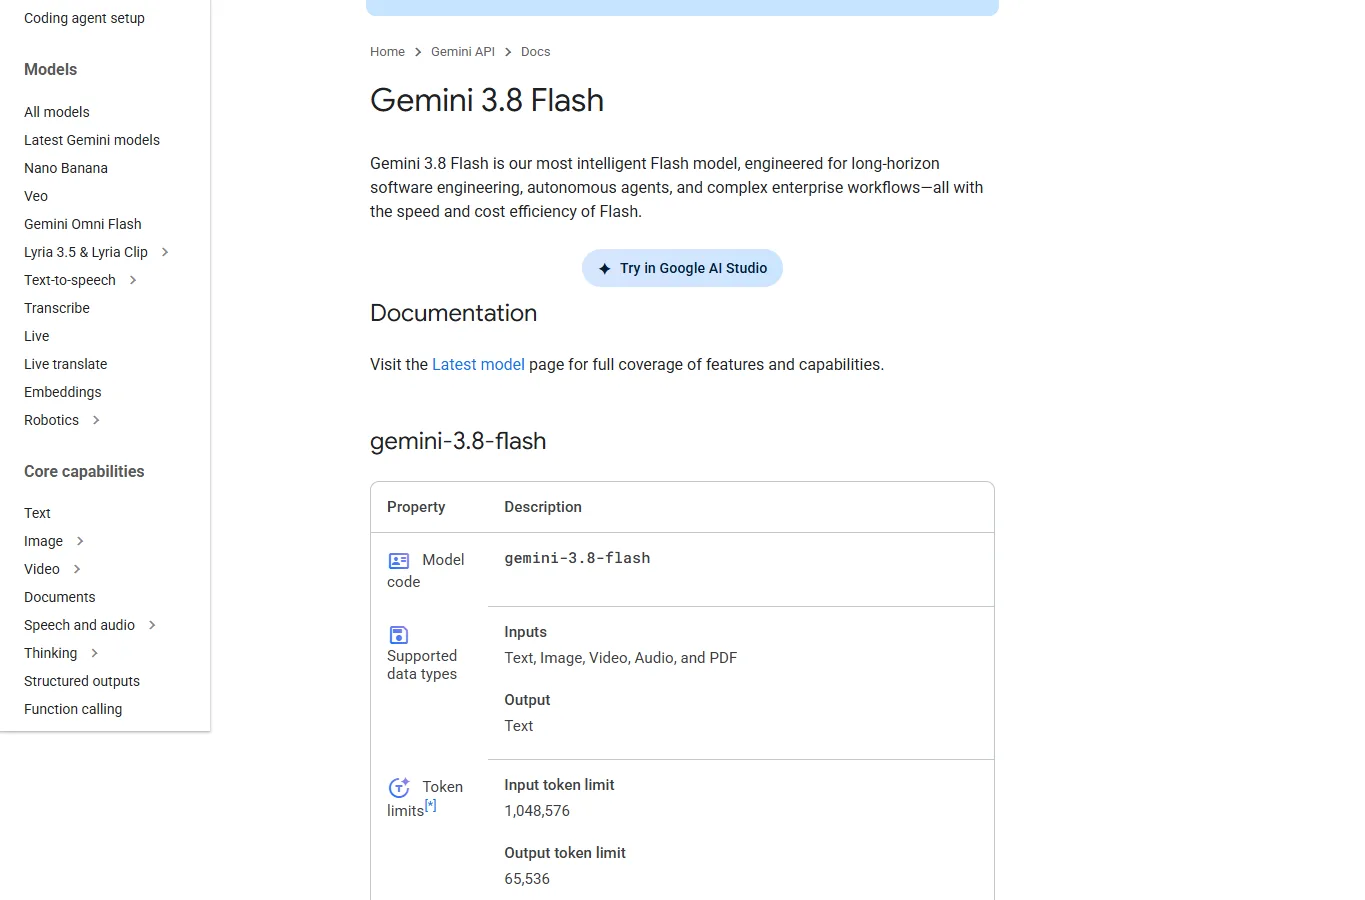
主な仕様: パラメータ数非公開。入力1,048,576/出力65,536トークン。画像・音声・動画・PDF対応。導入単価は入力$0.75/出力$3.75。
繰り返す文書処理や動画についての質問で費用を抑えたい人に向きます。Geminiアプリの対象プラン、AI Studio、Gemini APIが入口です。high設定は即答を保証しないので、出力速度だけでなく完了までの時間も測りましょう。
Tom’s Guideは動画を直接理解できる点を実用上の違いとして紹介しています。総合品質の対照試験ではありませんが、講義や映像の分析では順位以上に重要な選択条件になります。
レビューと選び方: 低コストの基準モデルとして試し、難しい案件だけ上位候補へ回す方法が実用的です。暫定順位と導入料金は固定値ではありません。
公式モデル情報 · オンライン利用・API · API / AI Studio
10. Muse Spark 1.2(xHigh) — 低単価だが、現行版との混同に注意
主な仕様: パラメータ数非公開。Arenaのコンテキスト欄はN/A。入力$1.25/出力$4.25。1.3の仕様を1.2へ転用しないでください。
Metaの発表では、計画、リポジトリ全体の作業、長時間開発を強化し、Muse CodeとMeta Model APIで提供しました。現在のメインページは1.3を案内しているため、1.2を指定できるか確認が必要です。
Redditに公開されたユーザーテストでは、コードレビュー事業者が速さとバグ検出を評価しています。ただし小規模な自己報告で、関連製品の開発者によるものです。xHighが全用途で旗艦モデルと同等だと証明する内容ではありません。
レビューと選び方: 提供が続いていれば低コスト比較の候補です。旧版が1.3より1つ上の順位だからという理由だけでは選ばず、実際の修正量も確認しましょう。
公式モデル情報 · オンライン利用・API · API / Meta
用途別に、どれから試す?
資料・音声・動画を組み合わせるなら難しい仕事はArgon、反復処理はFlash。Claudeを新規導入するならOpus 5.5から始め、品質差が費用に見合う場合にFable 5.1を追加すると選びやすくなります。
エージェント用途のWonderは、実際に使うアプリや連携ツール込みで比較しましょう。既存のOpus 4.6/4.7やFable 5は、移行前に回帰テストを行う価値があります。
正解を確認できる問題、実際の文書またはコード修正、日本語の文章作成を同じ条件で試してください。誤り、修正回数、時間、総費用を記録し、複数回実行します。英語の好評がそのまま日本語の書き味を保証するわけではありません。
契約前に確認したい疑問
ChatGPTやDeepSeek、Qwenがないのはなぜ?
指定日時のText Arena Overall上位10行をそのまま扱っているためです。ChatGPTはアプリ名で、OpenAIのモデルは表の別の位置にあります。カテゴリや日時が変われば順位も変わります。
highやmaxはモデルの大きさ?
推論・評価設定の表記です。今回の公式仕様ではパラメータ数は非公開なので、コンテキスト、出力上限、費用など公開された情報で判断します。
全部無料で使える?
いいえ。Arenaの比較利用は、全モデル・全設定・全ツールを自由に使える無料契約ではありません。アプリの月額契約とAPI請求も別です。
旧モデルが新モデルより上なのはなぜ?
回答の好み、問題、推論設定、投票数は、開発やエージェントの評価と異なります。誤差が重なる小さな順位差だけで能力の優劣は断定できません。
一番安いのは?
表の標準単価ではFlashです。ただし推論や再試行、出力量、キャッシュによって変わるため、仕事を1件完了させる総額で比べてください。
ローカルで動かせる?
今回のモデルは公開重みをダウンロードするローカル向けモデルではありません。オフラインが必須なら別のオープンウェイト候補を選び、オンラインではサービスのデータ設定を確認しましょう。
まず2モデルで自分の仕事を比べる
まずOpus 5.5とArgonで品質を比べ、Flashを費用の基準にすると選びやすくなります。エージェント中心ならWonder、既存環境との比較なら旧ClaudeやSparkにも意味があります。
最後に残すべきなのは、少ない修正で正しく使える成果を出すモデルです。Arenaの順位を参考にしつつ、日本語での実作業の結果を優先してください。
関連記事:ローカルモデルと実行アプリ: ローカルLLM · ローカルAI実行アプリ
関連 レビュー
Pony V7レビュー|AuraFlow化、LoRA生態系、V6比較、NSFW対応まで解説

MiniMax M3.1 Flashレビュー|料金・コーディング・公開ウェイト・必要GPU
Grok 4.6レビュー|推論・Agent・料金・NSFW対応まで実用目線で解説

ローカルLLM比較 2026|性能・NSFW・必要GPUで選ぶオープンソース大規模言語モデル
Krea 2 Editレビュー|モデル配布・ComfyUIワークフロー・プロンプト実例
Gemma 4レビュー|ローカル導入・必要GPU・NSFW対応とUncensoredモデル