Hy4 Flashレビュー|ローカル実行・100万トークン・必要メモリ・料金・NSFW制限
Tencent Hy4 FlashのInstruct・FP8・Baseを比較。GGUF容量、導入コマンド、推論モード、API料金とNSFW対応の限界を解説。

Hy4 Flashは、文書処理、画像の理解、日常的なコード修正を低コストで繰り返したい人の候補です。重みの公開により自分で動かせますが、12Bの活性化パラメーターは12B相当のメモリで動くという意味ではありません。回答を試すならまずAPI、ローカル導入なら全ファイル容量と対応エンジンを先に確認しましょう。
公開されたモデルと224B・220Bの違い
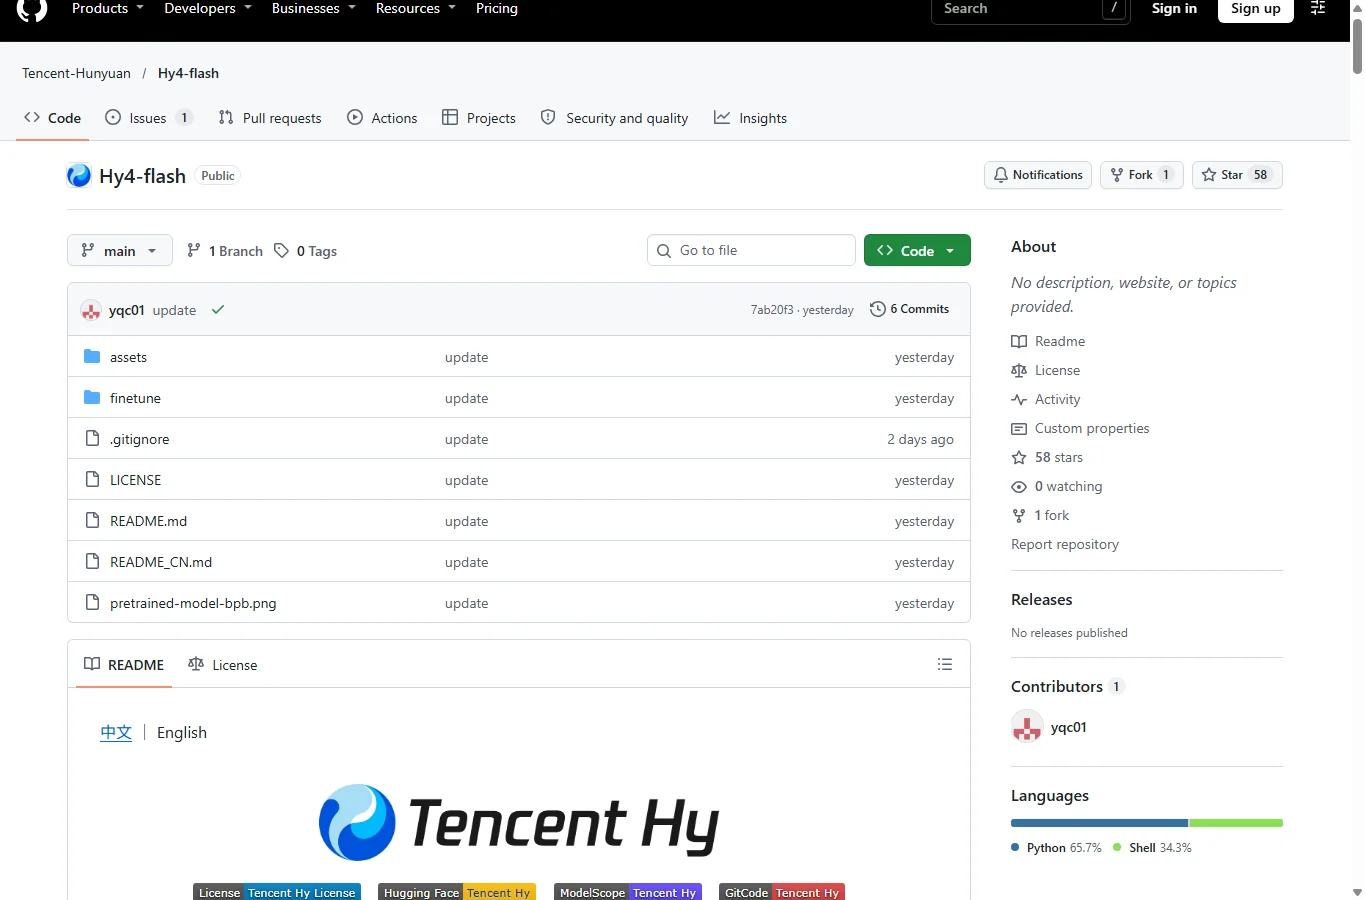
Tencentは2026年11月16日にホスト型モデルを発表し、その後Hy4-flash、Hy4-flash-FP8、Hy4-flash-baseの重みを公開しました。GitHubは説明とコード、実際の大きな重みはHugging Face、ModelScope、GitCodeで配布されています。既存のHy4 Previewとは規模も用途も異なるモデルです。
発表記事は224Bですが、現在のリポジトリは約220Bと説明しています。内訳は本体155.5B、Engram 63.5B、視覚0.43B、ドラフター0.85Bで約220.28B。以前の224Bとの関係は公式に整理されていません。トークン当たり約12Bを使っても残りの重みの保存は必要です。文章・画像を入力して文章を出力するモデルで、画像生成や音声・動画の直接出力とは別です。
得意分野・比較・評価の根拠
LatentMoE、疎な注意とスライディング窓の組み合わせ、Engramの参照表で効率を狙います。DFly2はキャッシュなどを共有する投機的デコード用ドラフターで、対応環境では生成を速められますが、入力処理や全メモリを不要にはしません。文書からの抽出、図表理解、小規模な修正や反復Agent処理が主な候補です。
公式WorkIndexはFlash 42.1、Hy4 Preview 39.7、Hy4 51.4。内部課題の費用比や150トークン/秒超はTencentの測定であり、個人PCの速度ではありません。Baseのfew-shot成績をチャット版の実力に読み替えないこと。本記事では独立したFlashの総合知能スコアを確立できておらず、よく見かける35点は別モデルHy4の値です。
LocalLLaMAでは、ホスト型Flashをゲーム開発に使い速度と費用を評価しつつ、手元のQwen Flash Nextより能力が低いと感じる投稿や、量子化劣化・容量への疑問が見られます。別スレッドにはM5 Max・Q3で約20トークン/秒との投稿もありますが、再現条件は不足しています。少数の感想を共通評価にはせず、同じ課題の合格率、総トークン、所要時間で比較してください。
100万トークンと実際の必要メモリ
仕様は最大1,048,576トークンですが、アプリやAPIが既定で最大値を使える意味でも、全情報を正確に思い出す保証でもありません。まず8K、次に32Kと必要に応じて増やします。長い入力では最初の返答までが重くなり、出力用の余白も必要です。文書IDと原文引用で検索精度を確認してください。100万トークンは100万語ではありません。
AngelSlim公開値はQ4_K_Mが156.79GiB、Q3_Kが144.70GiB、IQ2-AHが125.73GiBで、実行領域・キャッシュ・画像用projectorは別です。混合精度とEngram表があるため、Q4という名前だけで220B×4bitとは計算できません。220BをBF16で持つ単純概算は重みだけで約440GB(十進)です。12GB GPUに全体が入る規模ではありません。
量子化チームはM5 Max 128GB・4K~32KでQ4の生成約44~48トークン/秒を掲載していますが、最適化・オフロードを含む提供者の条件であり、全重みがGPUに入る証拠ではありません。ディスク参照は容量とI/Oの交換で、スワップを無料のRAMとは考えないでください。1Mの実機試験や低VRAMのStrata手順は確認できず、GGUFページはStrata版を今後提供予定としています。
Instruct・FP8・Base・GGUFの選び方
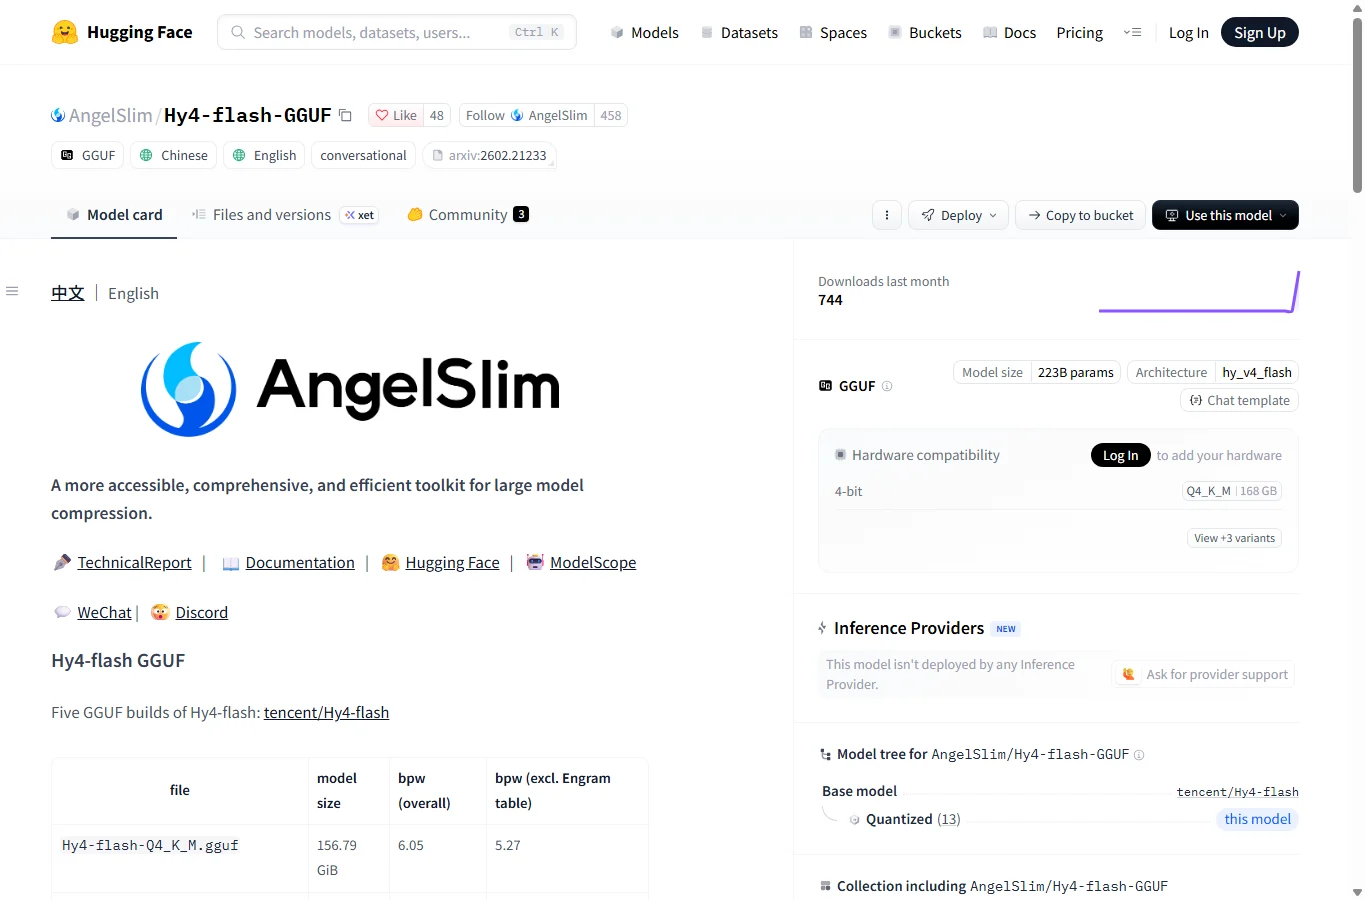
通常の会話はHy4-flash Instruct、対応GPUサーバーならFP8版が候補です。Baseは事前学習モデルで、会話用の手軽な版や無検閲版ではありません。AngelSlimのGGUFは容量と品質のバランスで選び、最小ファイルだけを理由に決めないこと。画像入力には対応するmmprojも必要です。
確認時点ではTransformersが指定PR、llama.cppがPR 32517の導入を必要とします。古いOllamaやLM Studioにファイルを入れるだけでは対応の証拠になりません。公式vLLM手順は専用Dockerタグと8並列を使います。下のGGUF手順はLinux/macOSのシェル向けで、Windowsネイティブ実行の検証済み手順ではありません。Windowsでサーバー版を使うなら対応Linux/WSL2環境を検討します。
GGUFをローカルで動かす手順
Git、CMake、C++コンパイラー、ダウンロード用Python/pip、十分なSSDとメモリを用意し、専用作業フォルダーで実行します。以下は公式が案内するPRブランチを基にしています。2分割の重みを同じフォルダーへ取得し、1番目だけで完了と思わないでください。表示された重み容量以上の空き領域も確保します。
/absolute/path/modelを自分の保存先に置き換え、まず8Kで起動します。-ngl 99はGPUへの転送希望であり、収まる保証ではありません。失敗したらレイヤー数・文脈長を下げるか、十分なメモリの機械を使います。NVIDIAではCMakeに-DGGML_CUDA=ONを追加し、macOSは標準でMetalを使います。公式のMac専用固定コミット・patch手順と一般ブランチは同一条件ではないため、公称速度を保証しません。
サーバー起動後は提供されるローカルWeb画面か次節のクライアントで質問します。ログで2分割の読み込みと正常な起動を確認してください。画像はmmprojを取得して下の画像入力例を使います。これは確認した文書から整理した導入例であり、本記事で巨大モデルを実行した結果ではありません。
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
git fetch origin pull/32517/head:hy4-flash
git checkout hy4-flash
cmake -B build
cmake --build build --config Release -j
python -m pip install -U huggingface_hub
hf download AngelSlim/Hy4-flash-GGUF --include "Hy4-flash-Q4_K_M-*.gguf" "mmproj-Hy4-flash-bf16.gguf" --local-dir /absolute/path/model
./build/bin/llama-server -m /absolute/path/model/Hy4-flash-Q4_K_M-00001-of-00002.gguf -c 8192 -ngl 99 --jinja --host 127.0.0.1 --port 8080
./build/bin/llama-mtmd-cli -m /absolute/path/model/Hy4-flash-Q4_K_M-00001-of-00002.gguf --mmproj /absolute/path/model/mmproj-Hy4-flash-bf16.gguf --image photo.png -p "Describe the visible labels. Mark uncertainty." -c 8192 -ngl 99 --jinjaサーバー・API・推論モード
公式vLLM例はvllm/vllm-openai:hy4-flash、tencent/Hy4-flash-FP8、tensor-parallel-size 8、FLASHMLA_SPARSE、hy_v4のtool/reasoning parser、DFlyを指定します。8GPUは公開された構成で、理論上の全環境共通最小台数ではありません。GPU世代、ドライバー、接続速度も確認が必要です。個人サーバーはループバックに限定し、認証なしで外へ公開しないでください。
Instructのreasoning_effortは既定highと直接回答のno_think。ローカルOpenAI互換例ではchat_template_kwargsへ渡し、推奨temperature 0.9/top_p 1.0です。下のPython例はvLLMの8000番とserved名hy4-flashを想定します。GGUF手順の8080番とは異なり、エンジンによってモデル名や推論指定の対応も変わります。
ホスト型なら対応サービスで登録し、Hy4 Flashを選択、キー・URL・IDを取得して予算上限を設定します。OpenRouterはtencent/hy4-flashを掲載しますが、地域・規約は別です。確認時の割引は入力100万トークン0.035米ドル/出力0.1405ドル、Tencent発表の標準参考は約0.070/0.281ドルで、キャッシュ命中はさらに別料金。割引条件なら入力100万+出力10万の計算例は約0.04905ドルですが、手数料などを除きます。恒久価格でもローカルの電気代でもありません。
docker run --gpus all -p 127.0.0.1:8000:8000 --ipc=host -v ~/.cache/huggingface:/root/.cache/huggingface vllm/vllm-openai:hy4-flash tencent/Hy4-flash-FP8 --tensor-parallel-size 8 --speculative-config '{"num_speculative_tokens":5,"method":"dfly"}' --attention-backend FLASHMLA_SPARSE --tool-call-parser hy_v4 --reasoning-parser hy_v4 --enable-auto-tool-choice --port 8000 --served-model-name hy4-flashpython -m pip install openai
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
response = client.chat.completions.create(
 model="hy4-flash",
 messages=[{"role": "user", "content": "Explain your capabilities briefly."}],
 temperature=0.9, top_p=1.0, max_tokens=512,
 extra_body={"chat_template_kwargs": {"reasoning_effort": "no_think"}},
)
print(response.choices[0].message.content)
NSFW・プライバシー・商用ライセンス
重みの公開はNSFW許可や無検閲動作の証明ではありません。Flash固有の性的ロールプレイ、露骨な内容の拒否率、言語別検閲を再現可能に測った資料は確認できません。ローカルでもInstructに学習された応答傾向は残り、Baseも制限なし会話への確実な切り替えではありません。本記事で露骨な試験は実施していません。
ホスト側の規約・フィルターはモデル自体と別です。通常の成人の話題、創作、健康情報、露骨な性的会話を一括して「対応率」で表せません。ロールプレイ用途なら人格保持、長い会話での拒否、使う言語での挙動が未確認の論点です。合法で同意を尊重する用途を選び、利用先の許可を確認してください。回避手順は提供しません。
Tencent Hy License v1.0はApache 2.0そのものではありません。大規模MaaS事業者には連続12か月の総売上5,000万米ドル超、または月間利用者1億超のサービスに関する別許諾条件があり、定義された内部利用の例外もあります。小規模商用利用の全面禁止ではなく、配布表示等も確認が必要な条項概要です。法的な許可証明ではありません。ローカルでも外部画像URL、ツール、APIへ接続すればデータは外へ送られ得ます。
プロンプト例とトラブル対処
文書には「添付資料だけを根拠に回答し、各主張に文書IDと原文引用を付ける。根拠がなければ不明とする」。コードには「指定関数だけの最小差分、前提とテスト方法を示す。ツールの実行前に確認する」。画像には読めるラベルと不確実な点を尋ねます。これらは評価の出発点で、精度を実証したプロンプトではありません。
起動失敗は対応ブランチ、分割ファイル、空きメモリ、キャッシュ割り当て、projectorを確認します。tool呼び出しが生の文字列ならテンプレートとhy_v4 parserを確認。思考が長い場合はno_thinkがサーバーに届くか調べます。速度比較は同じ量子化・文脈長で行い、日本語の専門用語も自分の課題で検証してください。公開された多言語の一部ベンチマークは全言語の品質保証ではありません。
結論として、低価格APIと十分なメモリのローカル検証には有望ですが、普通の低メモリPCで最初に落とすモデルには不向きです。Instructと短い文脈から始め、正しい結果1件の費用で判断します。2026年11月19日時点の公式資料、提供者測定、出典を区別した利用者投稿をAI補助で整理した評価で、当サイトの実機速度・NSFW・百万トークン負荷試験ではありません。
関連 レビュー
Hy4 Previewレビュー|Tencent Hunyuan 770B MoE、1Mコンテキスト、API、ローカル要件、NSFW制限まで解説

Canva Craftレビュー|2K・横長画像・日本語文字・料金と編集の実力

FLUX 3レビュー:Image・Kleinの画質、編集、必要VRAMと商用利用
Step 5 Previewレビュー:料金・API・オープンウェイト・NSFW制限を解説
Viggle Remakeレビュー|ローカル動画編集の導入・使い方・必要VRAM・NSFWの制限
ERNIE-Imageレビュー|オープンソース画像生成AI、LoRA、ローカル導入、NSFW対応まで解説