GPU Unlockレビュー|RTXのAI性能・対応GPU・導入リスク
gpu-unlock、KohakUnlock、Ada版を検証資料から比較。対応RTX、ComfyUIの生成時間、LLMの限界、消費電力、起動時のリスクを解説。

GPU Unlockは、既存のGeForceでローカルAIの処理を速められる可能性があるツール群です。効果が期待できるのは、対応GPUで浮動小数点のTensor Core演算が処理時間の大きな割合を占める場合です。VRAMが増えるわけでも、すべてのモデルが2倍速になるわけでもなく、RTX 5090向けの対応版でもありません。
予備のRTX 30系Linux環境で復旧手段を確保できる人には、検討する価値があります。一方、仕事の主力PC、INT8中心のワークフロー、Windowsで汎用インストーラーを探している人には負担が大きめです。選ぶべきなのは「解放」という言葉ではなく、自分の構成に合う実装と、実際に短縮できる処理です。
目次
GPU Unlockが変える演算経路
対象は、低精度の値を乗算してFP32で累積するTensor Coreの経路です。FP16入力でもFP16累積なら別の経路であり、通常のFP32 CUDA演算や整数演算とも区別が必要です。NVIDIAのAda白書にもモードごとの速度差が記載されており、「AI TOPS」の数字をそのまま比較基準にはできません。
主な実装は、通常のNVIDIAドライバーがGPUを管理する前に特権付きファームウェアを実行し、演算速度の選択レジスターを変更してから純正ドライバーに引き継ぎます。「ドライバー設定を切り替えるだけ」という説明では仕組みを捉えきれません。確認した方式はVBIOSの書き換えや電圧上昇を必要としませんが、特権実行のリスクは残ります。
開発者は製品の差別化による制限と説明しています。確認できるのは特定命令の実行速度が変わる点であり、すべての消費者向け処理が半速だったことや、NVIDIAが改変を承認したことを示す資料ではありません。以下の結果からゲームのFPS向上も確認できません。
評価範囲:2026年10月29日時点の公式プロジェクト資料、所有者の公開測定、報道を分析したレビューです。AirMoreでは解放処理、CUDAベンチマーク、耐久試験を実行していません。表は公開時間から再計算したもので、画面は資料の表示です。調査・執筆・翻訳にAIを使用し、表紙は編集用イラストです。
4つのプロジェクトの役割と違い
gpu-unlock — Zagitta
Ampereを調べる際の中心になるLinuxプロジェクトです。確認したREADMEはv2.0.0で、パッケージ化やinitramfsへの組み込みに対応し、RTX 30系に加えてTuringとAdaも実験的対応として掲載しています。ただし、一覧への掲載や「stable」という表示は開発者の分類であり、全ボードの独立した認証ではありません。
通常のドライバーより先に動く必要があり、NVIDIAがGPUを管理した後に手動でモジュールを読み込んでも解放されません。GPUの商品名より、カーネルヘッダー、読み込み順、正確なPCI ID、通常起動に戻せる構成が重要です。モジュールはGPL-2.0-onlyの無償ソースで、NVIDIAファームウェアには別の条件が適用されます。
開発者は、関連する公式Webサイト、暗号資産、汎用インストーラーはないと明記しています。同名の検索結果を公式配布と誤認せず、作者とリビジョンを確認してください。パッケージがあっても起動環境の調整やシステム更新後の再確認は必要です。
gpu-unlock-ada — JustAResearcher
gpu-unlock-ada — JustAResearcher
Ada向けのファームウェア処理を統合したLinuxフォークです。確認したREADMEはv1.1.1で、RTX 4090の詳細な測定記録があります。別の所有者による比較では、同じGPU・実行ファイル・ドライバー・450 W上限が維持されており、条件の異なるピーク画像を並べるより判断しやすい資料です。RTX 4070 Ti SUPERにも実験記録がありますが、40系全体の対応証明ではありません。
命令スループット、cuBLAS GEMM、計算結果の確認を分けている点が長所です。一方、実機の数と長時間の検証は限られます。別途公開されたMSI RTX 4070 Ti向けWindows参照実装も、Windows全般の対応や、そのGPUのLinux対応を意味しません。
FP8の扱いにも注意が必要です。Adaの記録にはFP32累積のFP8命令が速くなる例がある一方、対応させたFP8 GEMMがほぼ変わらない例もあります。「8bitなら全部速くなる」「FP8は絶対に無関係」のどちらも不正確で、実際のカーネルと累積形式、ボトルネックが決め手です。
KohakUnlock — KohakuBlueleaf
ソースと検証資料を重視した研究プロジェクトで、汎用のワンクリックツールではありません。メモリを物理改造したRTX 2080 TiのLinux実験、RTX 4090のWindows/UEFI経路、Zagittaの実装を使ったRTX 3090運用が記録されています。一部の報告にある22 GBや48 GBのVRAMは物理改造によるもので、このソフトが増設した容量ではありません。
公開Linux実装は、標準では実機処理が無効で、個体やファームウェアの厳しい確認条件があります。Windows版はローカルで用意したEFI処理から純正ドライバーへ引き継ぎます。署名済みEFIの実機成功例でもSecure Bootは無効だったため、署名対応のコードがあるだけでSecure Boot有効時の実証済みとは言えません。
測定の限界も具体的です。2080 Tiの行列サイズ比較は改造済みの別個体同士で、3090の復元された標準値は電力上限が異なります。また、公開用の構成と過去に測定したバイナリーは完全同一ではありません。復旧手段を持つ開発者の参考資料にはなりますが、日常PCの手軽な高速化手段としては勧めにくい内容です。
AD103_win_unlocker — TOTORONG
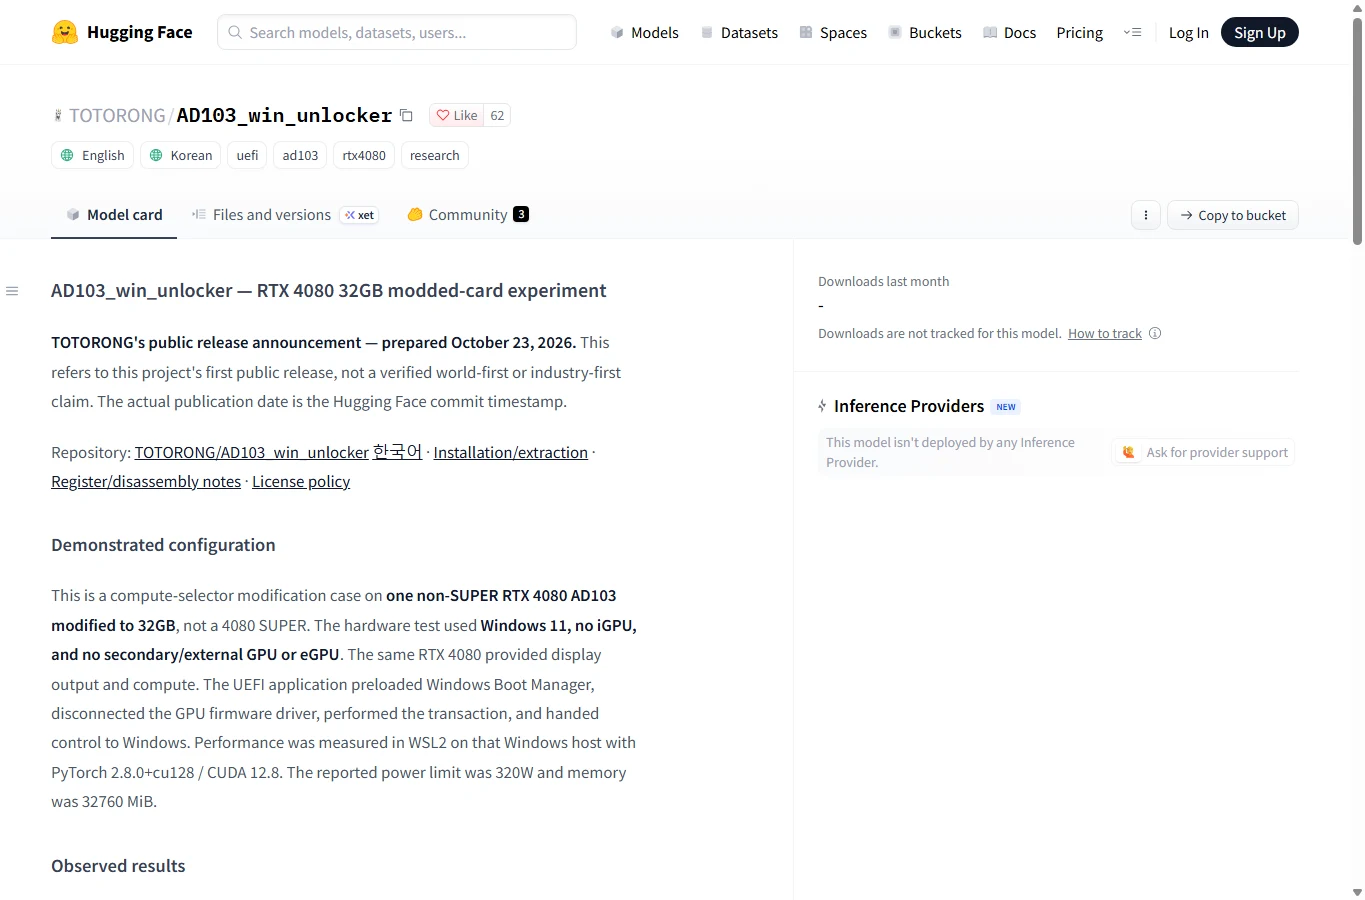
Hugging Faceで公開されたAda向けWindows/UEFI研究資料で、画像生成モデルやGPU貸し出しサービスではありません。確認された構成は、32 GBへ物理改造した非SUPER版RTX 4080の1台、Windows 11、WSL2/PyTorch、電力上限320 Wです。Ada向け開発の経緯を理解するうえで重要です。
配布EFIはデバイス・サブシステムIDとROMのハッシュに結び付いており、同じ「RTX 4080」でも拒否される場合があります。GEMMの向上率は行列サイズによって変わり、LLM全体、DLSS、レイトレーシングの高速化は主張されていません。ソースや抽出ツールがあっても、IDやハッシュを書き換えるだけでは移植の検証になりません。
対応するRTXとOSの見極め方
| 世代 | 参考になる実機記録 | 確認すべき限界 |
|---|---|---|
| RTX 30 / Ampere | 3090・3090 Ti・3060など。主流実装の運用例が多い | 個体・PCI ID・カーネル・ドライバー・リビジョンを確認。一覧全体の検証密度は同じではない |
| RTX 40 / Ada | 4090の条件をそろえた比較と、特定ボードの実験 | LinuxとWindows/UEFIを区別。1台の成功を全機種に広げない |
| RTX 20 / Turing | 2080 TiのFP16→FP32測定 | ネイティブBF16・TF32は追加されない。改造メモリ個体の結果に注意 |
| RTX 50 / Blackwell | 確認した方式では非対応 | 5090の動作確認済み版は確認できない。「難しい」と「使える」は別 |
10月29日の上流READMEは、10月24〜26日の報道時点より対応一覧が広がっています。異なる時点の情報として読むべきで、どちらも全機種への保証ではありません。ノートPCでは、独立GPUへの給電が切れると一時的な状態が消えるため、電源管理やスリープ復帰も個別確認が必要です。
利用言語でGPU対応は変わりません。公式資料は英語が中心で、TOTORONGには韓国語資料もあります。日本語の説明が読めても、対応ハードウェアや起動処理の難易度が変わるわけではありません。
公開された計算テストの読み方
AdaリポジトリのRTX 4090比較は、Linux 7.2.11-arch1-1、NVIDIA 615.78.08、同じ450 W上限で実施されています。FP16/FP32命令は160.4→320.4 TFLOPS、BF16/FP32は159.7→320.2でした。しかしcuBLAS GEMMのFP16中央値は12〜34%向上にとどまり、BF16は2種類のサイズで約16〜20%向上、4096³ではほぼ変化なしでした。1人の所有者による結果で、アプリ全体の2倍速ではありません。
ZagittaのIssue #150には、12 GBのRTX 3060、170 W、Ubuntu 26.04.1、NVIDIA open 595.99.02、PyTorch 2.14.1+cu130の記録があります。8192³ GEMMはFP16が約78%、BF16が81%、TF32が76%向上したと報告されています。この構成の3060で実現した証拠にはなりますが、すべての3060の画像生成速度を測った値ではありません。
KohakUnlockの2080 Ti同一個体テストでは、FP16→FP32命令が59.9→111.0 TFLOPSとなり、FP16→FP16とINT8の対照値はほぼ変わりませんでした。行列サイズ探索の最高中央値57.71対88.24 TFLOPSは別個体・異なる最適サイズの比較です。「同じカードで53%向上」と言い換えるべきではありません。
Tom’s HardwareとNotebookcheckも公開と性能差を報じていますが、主に開発者や所有者の測定を紹介した記事です。独立した実験室で追加の追試を2回行った証拠としては数えられません。
Tom’s Hardware · Notebookcheck
ComfyUI・LLM・学習で期待できる効果
ComfyUIの具体例は、u/under-_-nullによるEVGA FTW3 RTX 3090 Tiの測定です。Ubuntu、NVIDIA 615.71.09、ComfyUI 0.42.1、標準クロック、上限450 Wで、バッチ1、同じプロンプト・シード・モデルを使用。各静止画設定で予備3回を除外し、両状態を15枚ずつ測定しています。中央値は初回モデル読み込みを除くリクエスト全体です。
| ワークフロー | 標準 → 解放後 | スループット向上 | 所要時間の短縮 |
|---|---|---|---|
| MOSS-Image SFT BF16 | 71.98 s → 45.40 s | +58.5% | 36.9% |
| MOSS-Image SFT INT8 | 27.31 s → 27.23 s | +0.3% | 0.3% |
| Qwen-Image 2.1 Turbo BF16 | 8.51 s → 5.41 s | +57.3% | 36.4% |
| Qwen-Image 2.1 Turbo INT8 | 3.92 s → 3.75 s | +4.5% | 4.3% |
| Z-Image Turbo BF16 | 6.79 s → 4.35 s | +56.1% | 35.9% |
| Krea 2 Turbo BF16 | 15.65 s → 10.70 s | +46.3% | 31.6% |
MOSSは1024×1024・50ステップ、Qwen・Z-Image・Krea Turboは1024×1024・8ステップです。表は、スループットを「標準時間÷解放後時間−1」、短縮率を「1−解放後時間÷標準時間」で再計算しています。原文との差は丸めによるものです。約59%のスループット向上は、待ち時間では約37%の短縮であり、59%短縮ではありません。
所有者は対応する静止画150組でデコード後のRGB画素が一致したと報告しています。そのワークフローの参考にはなりますが、すべての計算結果の同一性を保証しません。FLUXのFP8ファイルも、この構成ではBF16演算でした。INT8構成にも浮動小数点処理が残る場合があり、効果の大小はプロファイルで確かめる必要があります。
LLMではプロンプトを処理するprefillと、続きを出すdecodeを分けましょう。別の電力上限固定のコミュニティ測定では、3060のprefillが約15%向上し、decodeはほぼ変わりませんでした。整数カーネル、メモリ帯域、CPUオフロード、PCIe転送が支配的なら効果は限られます。BF16学習やLoRAにも可能性はありますが、行列演算だけで学習全体の時間や収束を判断できません。
計算例として、対象演算が全体の40%で、その部分だけ2倍速になっても、全体は1÷(0.60+0.40/2)=1.25倍、時間短縮は20%です。これは実測ではありません。命令レベルの2倍と、アプリの控えめな向上率が両立する理由を示しています。
消費電力・温度・1回あたりの電力量
処理が早く終われば、瞬間的な電力が増えても1枚あたりの電力量は減る場合があります。Wで示す電力、Jで示す電力量、温度は別の指標です。公開結果から「解放すると必ず消費電力が下がる」とは言えません。
3090 Tiの所有者が測ったMOSS BF16の平均コア温度は、標準77.9°C、解放後78.7°Cでした。低温になった設定もありますが、開始温度や室温は統一されず、VRAMジャンクションやホットスポットも未測定です。冷えるという証拠にも、長期安全性の証明にもなりません。
比較では電力上限をそろえます。上限を下げる効率調整は別の実験として行うべきで、向上幅も小さくなる可能性があります。TFLOPSを追うために電圧や上限を上げるより、処理全体の時間、出力確認、電力量、温度を記録する方が判断に役立ちます。
導入・復旧・更新にかかる負担
VBIOSを書き換えないことと、確実に復旧できることは別です。KohakUnlockはGPU・ホストの停止、起動失敗、データ破損、ハードウェア損傷の可能性を明記しています。通常の再起動ですべての状態が消えるとは限らず、永続的な起動設定があれば解放処理も再適用されます。
検討するなら、正確なボードとリビジョンを確認し、バックアップとディスク暗号化の回復キー、変更していない通常起動項目、ローカルまたはBMCのコンソール、完全な電源操作手段を確保します。Secure BootやIOMMUを安易に無効化したり、確認条件を外したり、ドライバー管理中のGPUに処理を強制したりするべきではありません。ネットワーク起動前に止まればSSHは使えません。
判定は、起動と純正ドライバーへの引き継ぎ、数値確認とXidエラーの有無、同じ条件での実アプリ測定の3段階で行います。どれか1つだけでは耐久性を保証しません。カーネル・ドライバー更新やスリープ復帰後も再確認が必要です。ファームウェアの配布条件を守り、ログ共有時はホスト識別情報を除きます。
確認したソースプロジェクトに月額料金はありませんが、導入・保守・復旧・停止時間が実質的なコストです。特権を持つローカル部品なので、未知のバイナリーを実行するリスクは単にモデルファイルを開く場合より大きくなります。
どのユーザーに向いているか
向いているのは、対応する予備のRTX 30系や、資料と一致するAda/Turing構成を持ち、BF16・FP16中心の処理と復旧手段がある経験者です。遅い精度設定だけを比較相手にせず、画質を許容できる既存の量子化ワークフローとも比べてください。
重要な仕事用PC、非対応の5090、構成不明のノートPC、メモリ帯域やINT8が中心の用途なら、標準環境を保つ判断が合理的です。魅力は既存Tensor Coreの特定経路をより活用できる点。実際の短縮時間が、起動構成の複雑さや長期安定性の不確実さを上回るかで決めるべきです。
関連 レビュー
Qwen Imageレビュー|3.0・2.0比較、LoRA/GGUF、NSFW対応まで解説

【2026年】プロジェクト管理ソフトおすすめ5選|機能・料金を比較

AIポスター作成ツールおすすめ5選【2026年版】
2025年版:無料&有料のおすすめ音声→テキスト変換ツール10選

Matrix-Game 4.0レビュー|RTX 5090で動くAIゲーム、導入方法とNSFWの限界
Manus 2.0レビュー:Studio・料金・APIと進化したポイント