Análise do MiniMax-Music3: Modelo de IA de Música de Peso Aberto para Canções de 5 Minutos
O MiniMax-Music3 é um modelo de geração de música por IA de pesos abertos capaz de criar músicas completas com cerca de cinco minutos de…

O MiniMax-Music3 é um modelo de geração de música por IA de pesos abertos capaz de criar músicas completas com cerca de cinco minutos de duração a partir de letras e de uma descrição musical detalhada. Em vez de se focar apenas em pequenos loops ou clipes de fundo, o seu objetivo é a estrutura completa de uma canção: introdução,verso, refrão, ponte, pausa instrumental e desfecho.
Em suma: o MiniMax-Music3 não oferece a mesma facilidade de utilização imediata do que o Suno ou o Udio para criações casuais no navegador, mas revela-se muito mais interessante para programadores, utilizadores do ComfyUI, investigadores e criadores que procuram fluxos de trabalho locais. Os seus pontos mais fortes são a estrutura de longa duração, o controlo através de letra e descrição, além de caminhos documentados para SGLang-Omni, Diffusers e ComfyUI.
Índice
- O que é o MiniMax-Music3
- Principais Características e Especificações
- Experiência Prática e Qualidade dos Resultados
- Descarregamento e Configuração Local
- VRAM e Requisitos de Hardware
- Comparação com os Principais Modelos de Música por IA
- Licença, Utilização Comercial e Direitos de Autor
- Exemplo de Prompt
- Perguntas Frequentes
- Referências
- Resumo
O que é o MiniMax-Music3
O MiniMax-Music3 é um modelo de texto para música lançado pela MiniMax. A página oficial do modelo no Hugging Face descreve-o como um gerador de música de alto desempenho para canções completas até cinco minutos, condicionado por letras e por uma descrição musical detalhada. O modelo produz vocais expressivos, arranjos dinâmicos e áudio estéreo WAV de 32 kHz e 16 bits.
A nível arquitetónico, o modelo combina um LLM global de 8B para a estrutura musical de longo alcance com um LLM local de 0.6B para o detalhe acústico ao nível dos fotogramas (frames). Para a síntese de áudio, são utilizados Flow Matching e Flow-VAE. Esta divisão é fundamental porque gerar uma canção completa não se resume a produzir bons blocos de áudio; o modelo tem de manter temas, ritmo, identidade vocal e a progressão dos arranjos ao longo de vários minutos.
Principais Características e Especificações
| Elemento | Detalhes |
|---|---|
| Nome do modelo | MiniMax-Music3 / MiniMax Music 3 |
| Utilização principal | Geração de músicas baseadas em letras, música vocal, banda sonora curta, geração instrumental |
| Entradas | Letra e descrição musical / legenda estruturada |
| Duração máxima | Até cerca de cinco minutos |
| Formato de saída | WAV estéreo de 32 kHz e 16 bits |
| Etiquetas de estrutura | [Intro], [Verse], [Pre-Chorus], [Chorus], [Bridge], [Instrumental], [Solo], [Outro] |
| Rotas de execução | SGLang-Omni, Diffusers, ComfyUI |
| Plataforma do modelo | Hugging Face e GitHub |
| Licença | Licença Comunitária do MiniMax-Music3 |
O fluxo de trabalho assenta em duas entradas distintas. A letra define as palavras a cantar, enquanto a descrição musical estabelece o género, subgénero, BPM, tom, arco emocional, estilo vocal, instrumentação, arranjo e perfil de produção. Para um controlo mais preciso, a ficha do modelo recomenda uma legenda estruturada (Structured Caption) com metadados globais, detalhes vocais e arranjos.
Esta é uma das diferenças mais úteis em comparação com os geradores de música mais simples. Um prompt vago resume-se a “pop animado”. Uma legenda mais completa especifica: “dance pop, 124 BPM, voz feminina brilhante, baixo sintetizador com side-chain, verso com pestanejos de guitarra espaçados, refrão com bateria ampla e harmonias em camadas, mistura limpa pronta para a rádio”. O MiniMax-Music3 fornece uma estrutura para redigir este nível de detalhe explicitamente.
Experiência Prática e Qualidade dos Resultados
A forma mais fácil de compreender o modelo é consultar a página oficial de demonstração. Inclui exemplos de vários géneros, como pop, rock, R&B, hip-hop, dance pop, country, soul, funk, blues, bossa nova e urbano. Vários exemplos utilizam títulos em inglês, existindo também exemplos em chinês, o que torna a demonstração útil para avaliar tanto a musicalidade geral como o processamento de idiomas que não o inglês.
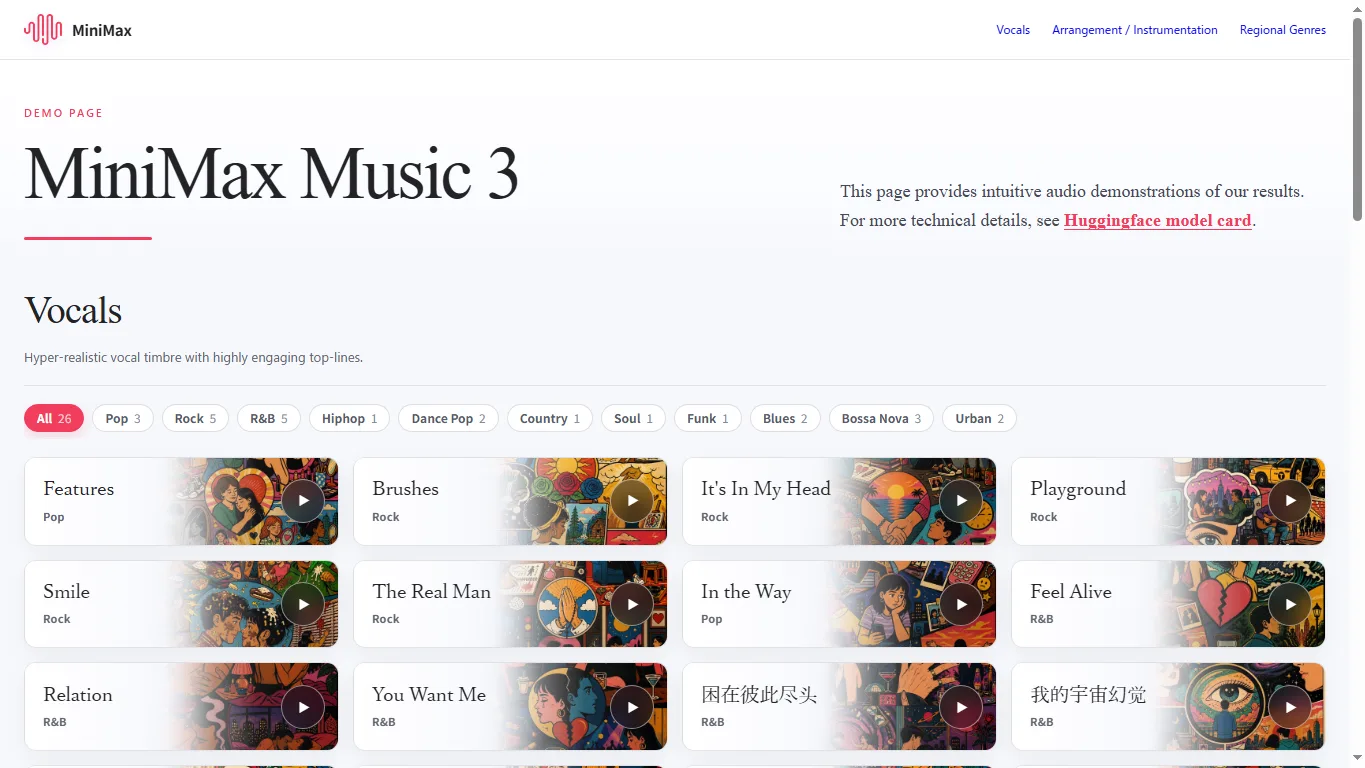
Ao ouvir as músicas geradas, analise mais do que apenas o primeiro refrão. Verifique se a transição entre o verso e o refrão soa natural, se o timbre vocal se mantém consistente, se a letra permanece inteligível, se o arranjo evolui ao longo do tempo e se a canção termina de forma orgânica. Muitos sistemas de IA conseguem criar um clipe impressionante de 20 segundos; o verdadeiro desafio é manter uma canção completa coerente.
Os primeiros comentários da comunidade são entusiásticos, mas pragmáticos. As discussões no Hugging Face incluem o agrado pelo lançamento de pesos abertos, dúvidas sobre o suporte ao ComfyUI, configurações com pouca VRAM, licenciamento e velocidade de geração. Isto confere ao lançamento um caráter muito próprio: é impressionante e promissor, mas continua a ser um modelo destinado a quem está disposto a testar, afinar e ler a documentação, em vez de um produto de consumo de um só clique.
Descarregamento e Configuração Local
O modelo oficial está disponível em MiniMaxAI/MiniMax-Music3 no Hugging Face, e o repositório do projeto encontra-se em MiniMax-AI/MiniMax-Music3 no GitHub. Para inferência em formato de servidor, a ficha do modelo aponta para o SGLang-Omni. Um comando de servidor básico tem o seguinteaspeto:
sgl-omni serve --model-path MiniMaxAI/MiniMax-Music3 --port 8000Os pedidos de geração utilizam o formato partilhado de ponto final de voz: a letra é inserida em input e a legenda musical em instructions. Isto é importante porque o MiniMax-Music3 não é um modelo de conversão de texto em voz (TTS) com um locutor selecionável. O resultado não é controlado através de um parâmetro de voice; a descrição do género vocal, timbre, estilo de interpretação, harmonias e efeitos é feita diretamente na legenda.
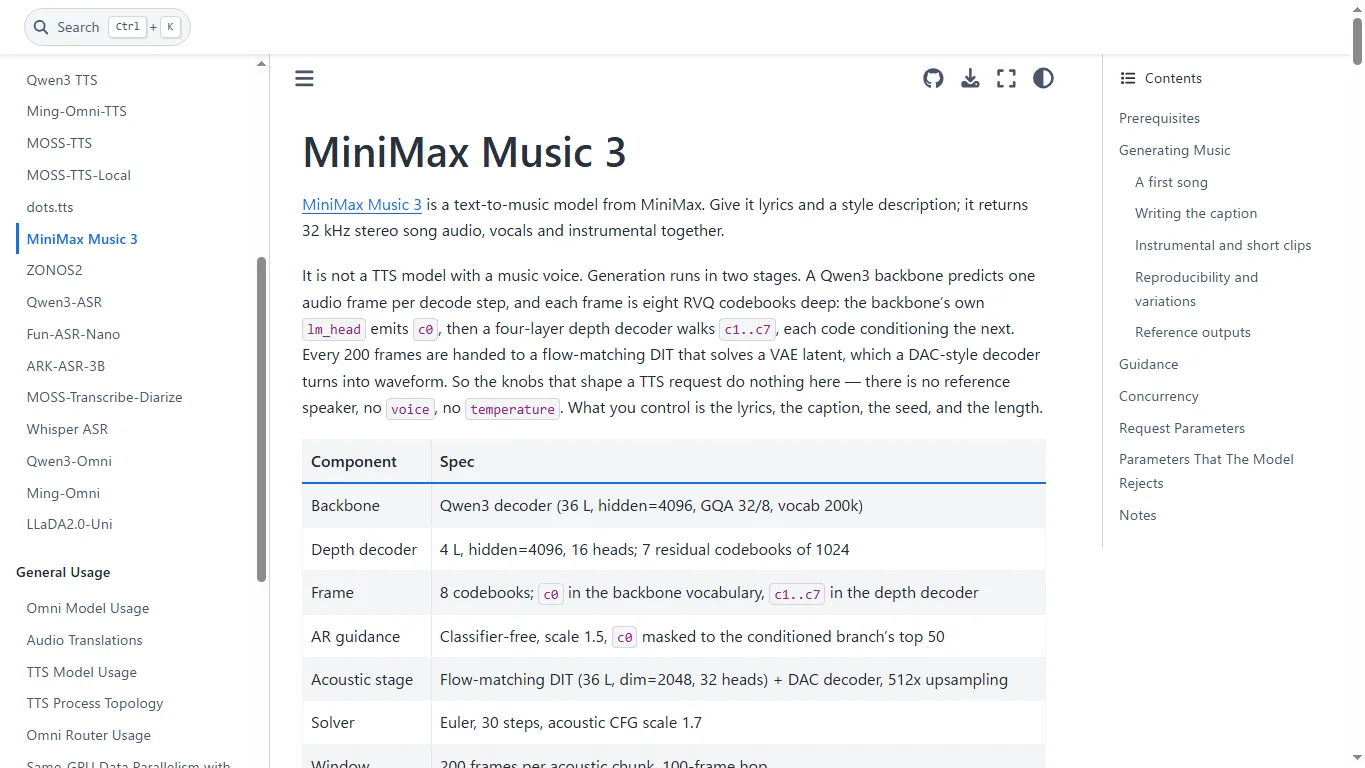
O suporte para Diffusers também está documentado como uma rota ModularPipeline. No momento da publicação da ficha do modelo, a instalação aponta para um commit de PR específico do Diffusers, pelo que deve verificar se o suporte total já foi integrado na sua versão instalada do Diffusers antes de assumir que uma instalação padrão por pip é suficiente.
VRAM e Requisitos de Hardware
A ficha oficial do modelo apresenta uma imagem surpreendentemente clara do hardware necessário. A precisão total cabe em menos de 24 GB de VRAM. Com a desativação automática (offload) para o CPU, a geração consome cerca de 22 GB. Através do streaming camada a camada para o modelo de linguagem, o pipeline pode funcionar em placas gráficas de 8 GB, embora este método seja mais lento e deva ser encarado como uma alternativa para computadores com pouca VRAM, em vez de uma configuração de produção ideal.
| Configuração | Perspetiva Prática | Ideal Para |
|---|---|---|
| GPU de 24 GB+ | A via local mais limpa; placas da classe RTX 4090 são mais realistas para testes | Utilizadores locais de IA e investigadores |
| ~22 GB com offload para o CPU | Poupa VRAM, mas pode reduzir a velocidade | Utilizadores com hardware ligeiramente abaixo dos 24 GB |
| 8 GB com streaming offload | Possível de acordo com a ficha do modelo, mas muito mais lento | Testes rápidos e verificações de viabilidade |
| Caminho de baixa VRAM no ComfyUI | Ficheiros de modelo INT8 e descodificação por blocos facilitam as experiências | Criadores baseados em nós |
| GPU na nuvem ou API | Menos complicações de configuração e testes mais fáceis de músicas longas | Equipas e avaliação de produção |
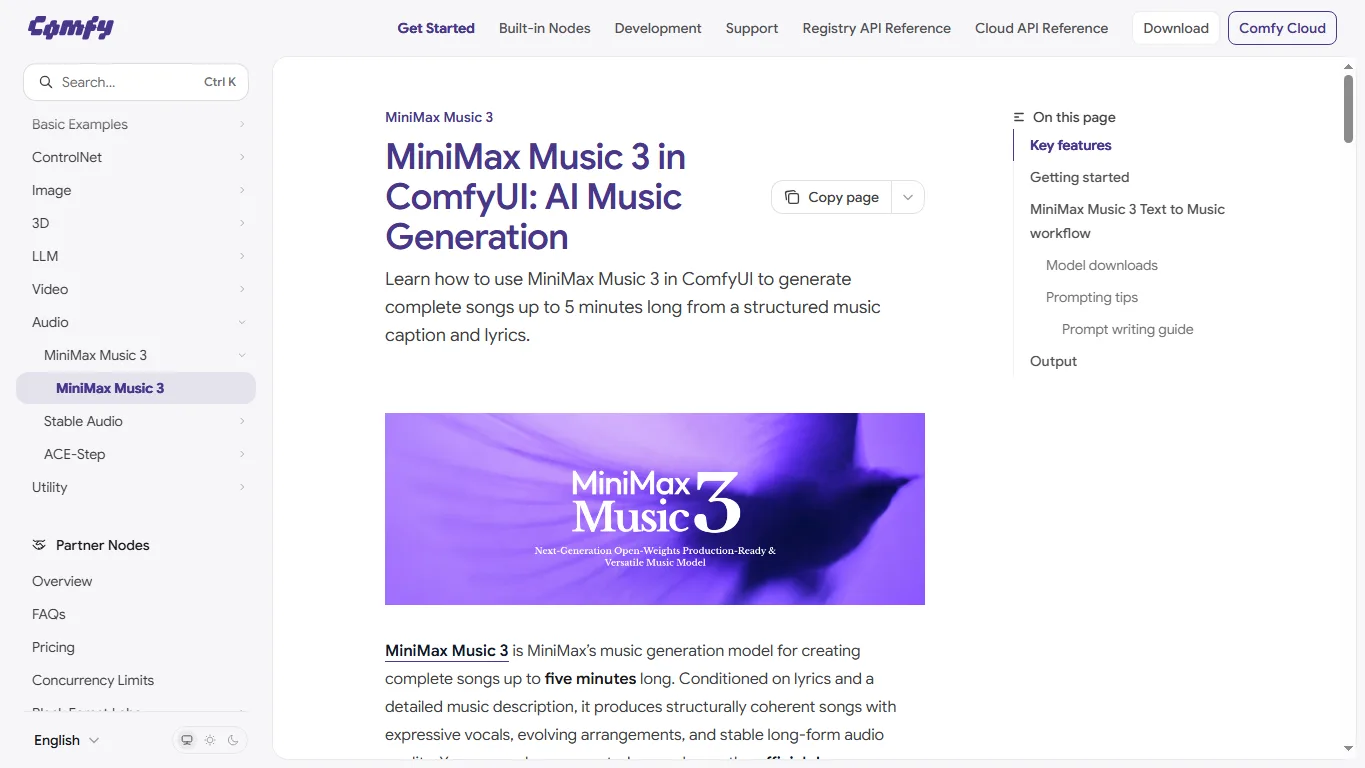
Para os utilizadores do ComfyUI, o tutorial oficial do ComfyUI para o MiniMax Music 3 constitui o ponto de partida mais prático. O documento enumera os modelos de difusão FP16 e INT8, um codificador de texto INT8, ficheiros VAE, a localização das pastas, o fluxo de trabalho de Texto para Música, dicas de escrita de prompts e a localização dos ficheiros de saída.
Descarregar o Fluxo de Trabalho Oficial do ComfyUI
Se pretender testar o MiniMax-Music3 no ComfyUI, utilize o JSON oficial do modelo da Comfy-Org: audio_minimax_music_3.json. Descarregue o ficheiro, carregue-o para o ComfyUI e poderá inspecionar diretamente o fluxo de trabalho de Texto para Música. Certifique-se de que coloca os ficheiros de modelo necessários nas pastas corretas do ComfyUI antes de iniciar a execução.
O tutorial oficial do ComfyUI explica as descargas dos modelos, os ficheiros INT8 para poupança de VRAM, bem como as definições de max_duration, seed e tiled_decode. Uma abordagem prática passa por testar primeiro clipes curtos, afinar a legenda e a letra, e só depois avançar para a criação de uma canção completa com três a cinco minutos.
Comparação com os Principais Modelos de Música por IA
O MiniMax-Music3 posiciona-se num ponto intermédio entre os serviços comerciais de música por IA e os modelos de investigação locais. As ferramentas online como o Suno, o Udio e o ElevenLabs Music são mais fáceis de utilizar. Modelos abertos como o Meta MusicGen, o Stable Audio Open e o YuE aproximam-se mais do espírito do MiniMax-Music3, embora respondam a necessidades diferentes em termos de duração, controlo e fluxos de trabalho.
| Modelo / Serviço | Tipo | Ponto Forte | Nota de Atenção |
|---|---|---|---|
| MiniMax-Music3 | Modelo de pesos abertos | Até cinco minutos, letra + legenda detalhada, rotas ComfyUI/SGLang/Diffusers | Exige configuração, planeamento de VRAM e análise de licença |
| Suno | Serviço online | Fluxo de trabalho muito simples no navegador e excelente experiência de consumo | Sem controlo de modelo local ou implementação de pesos abertos |
| Udio | Serviço online | Excelente para músicas vocais, edição e fluxos de extensão | Os resultados e direitos de utilização dependem dos termos do serviço |
| ElevenLabs Music | Serviço online/API | Adequado para APIs de produção e fluxos de trabalho de áudio | Não se trata de um modelo local de pesos abertos |
| Stable Audio Open | Modelo aberto | Útil para áudio curto, efeitos e elementos de fundo | Menos focado em canções completas baseadas em letras |
| Meta MusicGen | Modelo aberto | Base de investigação consolidada para a geração de música curta | Requer a criação de um fluxo de trabalho adicional para músicas vocais completas |
| YuE | Modelo aberto | Um ponto de comparação relevante para a geração de canções completas | A configuração e a qualidade do resultado dependem fortemente do ambiente e da versão |
Se o seu objetivo for publicar rapidamente uma música para as redes sociais, o Suno ou o Udio serão habitualmente mais práticos. Se a sua prioridade for testar estruturas musicais de longa duração, controlar legendas, gerir sementes (seeds), construir fluxos de trabalho no ComfyUI ou estudar um modelo de música de pesos abertos, o MiniMax-Music3 constitui a alternativa mais interessante.
A estratégia geral da MiniMax para a geração de conteúdos também merece atenção. O modelo de vídeo da empresa é analisado na nossa análise ao MiniMax H3, e as tendências recentes na geração de vídeo também se relacionam com a nossa análise ao LTX-2.5. O Music3 integra-se na mesma tendência rumo a produções mais longas, multimodais e adaptadas a fluxos de trabalho.
Licença, Utilização Comercial e Direitos de Autor
O MiniMax-Music3 utiliza a Licença Comunitária do MiniMax-Music3, e não uma licença permissiva simples do tipo MIT ou Apache. A licença inclui a obrigatoriedade de atribuição em produtos comerciais, um limite de receitas que pode exigir autorização adicional, requisitos de segurança para serviços alojados e uma política de utilização aceitável.
A geração de música acarreta igualmente riscos ao nível dos direitos de autor e da gestão de direitos para além da licença do modelo. As letras, a imitação do estilo de artistas, a semelhança vocal, as regras das plataformas de distribuição e os requisitos de divulgação são aspetos cruciais. Caso planeie publicar ou comercializar música gerada, guarde registos dos prompts, da titularidade das letras, da versão do modelo e de quaisquer edições efetuadas após a geração.
Exemplo de Prompt
Um prompt prático para o MiniMax-Music3 separa a letra da descrição musical. No caso de canções em inglês, redija ambos os elementos em inglês. Para outros idiomas, pode manter a descrição musical em inglês caso isso proporcione um controlo de estilo mais estável.
[Verse] Morning light is breaking through the rain I keep walking past the places we became [Chorus] Hold on, we are brighter than the night Two hearts burning like a signal in the sky Music description: Emotional pop rock, 104 BPM, female lead vocal with airy harmonies, clean electric guitar in the verse, full drums and wide synth pads in the chorus, hopeful but nostalgic, radio-ready modern mix, gradual build to a final anthemic chorus.Para uma iteração eficiente, comece por gerar blocos de 30 a 60 segundos antes de avançar para uma música completa. Assim que a voz, o tempo, a instrumentação e a energia do refrão estiverem corretos, aumente a duração. As gerações longas exigem mais tempo e memória, pelo que testar as legendas é fundamental.
Perguntas Frequentes
O MiniMax-Music3 é gratuito?
Os pesos do modelo estão disponíveis no Hugging Face, mas a utilização local continua a implicar custos de hardware, armazenamento e tempo de configuração. Se utilizar GPUs na nuvem, inferência alojada ou uma API, esses serviços poderão aplicar tabelas de preços próprias.
O MiniMax-Music3 consegue gerar vocais?
Sim. Foi concebido para gerar vocais e acompanhamento instrumental em simultâneo. A identidade vocal é controlada através da legenda musical e não através de um parâmetro de seleção de locutor independente.
Consegue funcionar numa gráfica de 8 GB?
A ficha oficial do modelo indica que é compatível com placas gráficas de 8 GB através de streaming offload, mas deve contar com uma geração mais lenta. Para uma experiência local mais fluida, uma GPU da classe de 24 GB ou um fluxo de trabalho com pouca VRAM no ComfyUI são opções mais realistas.
É melhor do que o Suno ou o Udio?
Nem sempre para todos os utilizadores. O Suno e o Udio são mais fáceis para criações rápidas no navegador. O MiniMax-Music3 torna-se mais apelativo se pretender acesso a pesos abertos, fluxos de trabalho locais, integração com o ComfyUI, reprodutibilidade e um controlo mais refinado através de legendas.
Posso utilizá-lo para fins comerciais?
É uma possibilidade, mas terá de analisar cuidadosamente a Licença Comunitária. A atribuição no produto, o volume de receitas, as salvaguardas de segurança e os direitos de terceiros são aspetos determinantes. A distribuição de música também acarreta considerações legais de direitos de autor e políticas das plataformas.
Consigo criar música instrumental?
Sim. Utilize uma legenda clara como “instrumental cinematic ambient, no vocals” ou “lofi background music, no vocal lead”, e teste durações mais curtas em primeiro lugar.
Referências
- MiniMaxAI/MiniMax-Music3 – Hugging Face
- MiniMax-AI/MiniMax-Music3 – GitHub
- MiniMax Music 3 Demo
- MiniMax Music 3 in ComfyUI
- SGLang-Omni MiniMax Music 3 cookbook
- MiniMax-Music3 Community License
Resumo
O MiniMax-Music3 representa um dos lançamentos mais importantes no domínio da música por IA, uma vez que se foca em canções completas e não apenas em pequenos clipes. O seu suporte para letras, legendas estruturadas, duração de cinco minutos, saída em estéreo WAV e rotas para fluxos de trabalho locais torna-o particularmente valioso para programadores e criadores avançados.
No entanto, não se trata de uma aplicação de consumo livre de fricção. Os requisitos de hardware, os modos mais lentos para baixa VRAM, o licenciamento e a gestão de direitos de autor exigem atenção. Para a maioria dos leitores, o melhor caminho consiste em ouvir a demonstração oficial, testar gerações curtas através do ComfyUI ou do SGLang-Omni e só depois avançar para músicas mais longas ou fluxos de trabalho comerciais.
Últimos Avaliações
Melhores óculos inteligentes de 2026: 6 modelos para IA, AR e esporte

Como montar uma estação de IA com GPU na nuvem: imagens, vídeos, LLM e NSFW (2026)

Manus 2.0: análise do Studio, preços, API e novidades
Meta Muse 2026: avaliação do agente de IA, preços e Muse Spark
Onde ficam os downloads do Spotify? Dá para exportar em MP3?
MiniMax H3 Image Studio: análise, edição no ComfyUI e referências para vídeo