
アニメ系LoRAは、生成に使うSDXL系チェックポイントと同じ系統で学習するか、Anima専用の学習スクリプトを選ぶのが基本です。写真系ではZ-Image・Qwen・FLUX・Krea 2の正確なモデル種類を指定し、動画ではWan、公式LTX Trainer、H3専用の手順から短い試行を始めます。LoRAは対応モデルに追加する差分であり、どのモデルでも使えるキャラクターファイルではありません。
大きな失敗は学習開始前に起きがちです。推論用の量子化ファイルをそのまま使う、世代の異なるモデルを混ぜる、全画像に同じ説明を付ける、静止画だけで動きを覚えると思い込む、といった点を避けましょう。最初は小規模なデータと固定の評価プロンプトで、保存と読み込みまで確かめる方が効率的です。
2026年10月13日更新
ツールより先に学習元モデルを決める
アニメ/写真という分類は主な用途の整理です。FLUXやKreaでもイラストを作れますし、SDXL派生にも写真向けモデルがあります。ここでWanXはWan系として扱い、具体例はWan 2.1/2.2に分けます。FLUXとLTXも、名前だけでなく世代を決めてからファイルを取得してください。
Pony V6 XLはSDXL系ですが、Pony V7にはこのSDXL設定を流用できません。IllustriousとNoobAIの派生は、似た構造でもタグや予測方式が異なる場合があります。Anima・Z-Image・Qwen・Krea 2はそれぞれ専用の実装が必要です。読み込みエラーがないことと、期待どおりの出力になることは別です。
LoRA学習ツールの選び方
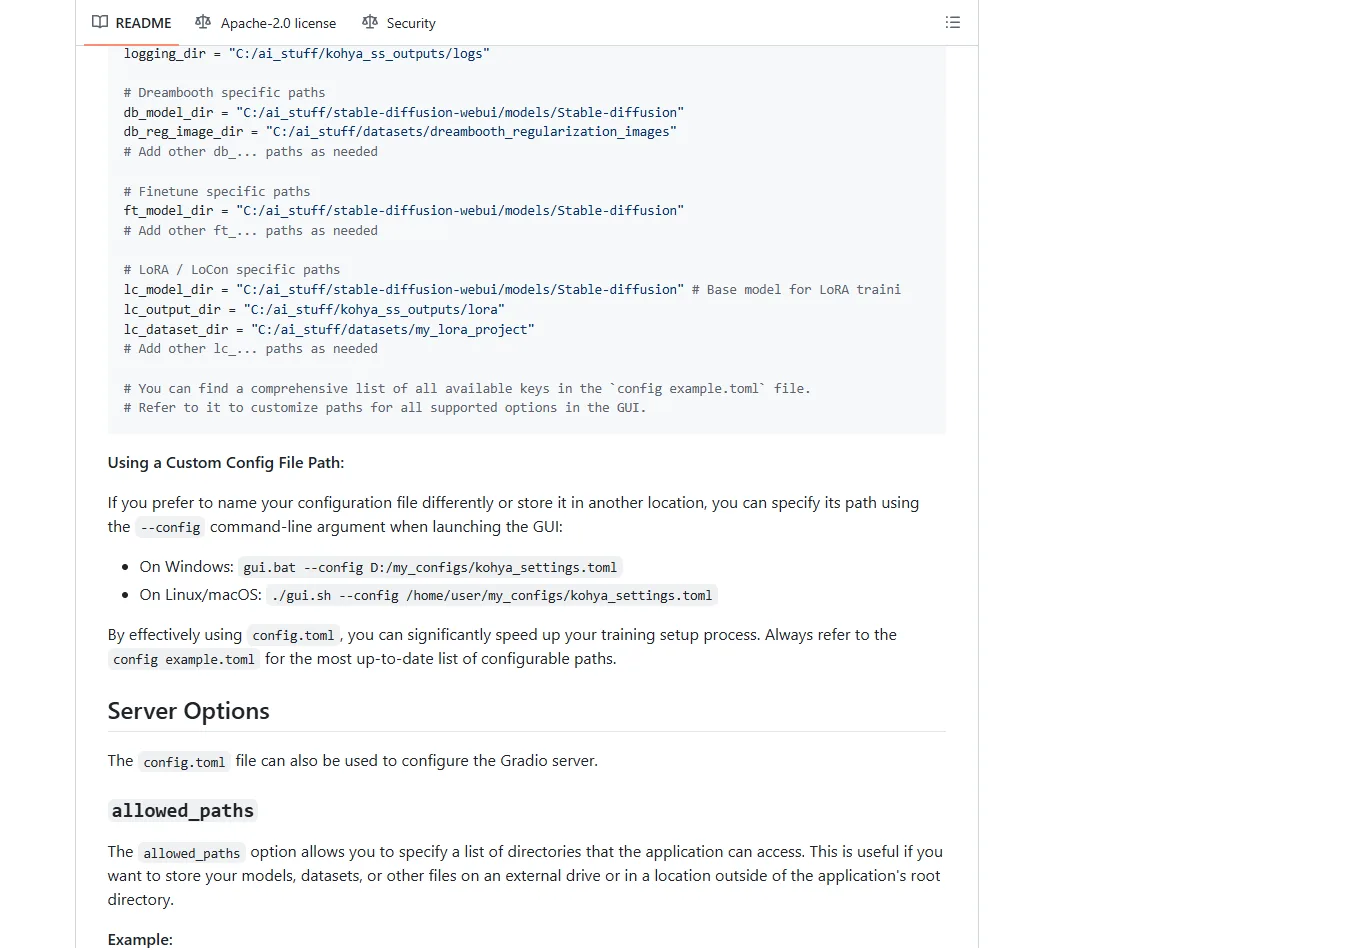
kohya_ss+sd-scripts
SDXLをGUIで学習したいならkohya_ssが入り口になります。LoRA/SDXLの学習画面で、元モデル、画像・キャプションのフォルダー、出力先を指定し、設定を保存してから開始します。引数の基準は内部で使われるsd-scriptsです。GUIに同梱された版が古い場合、最新のモデル対応やオプションが表示されないことがあります。
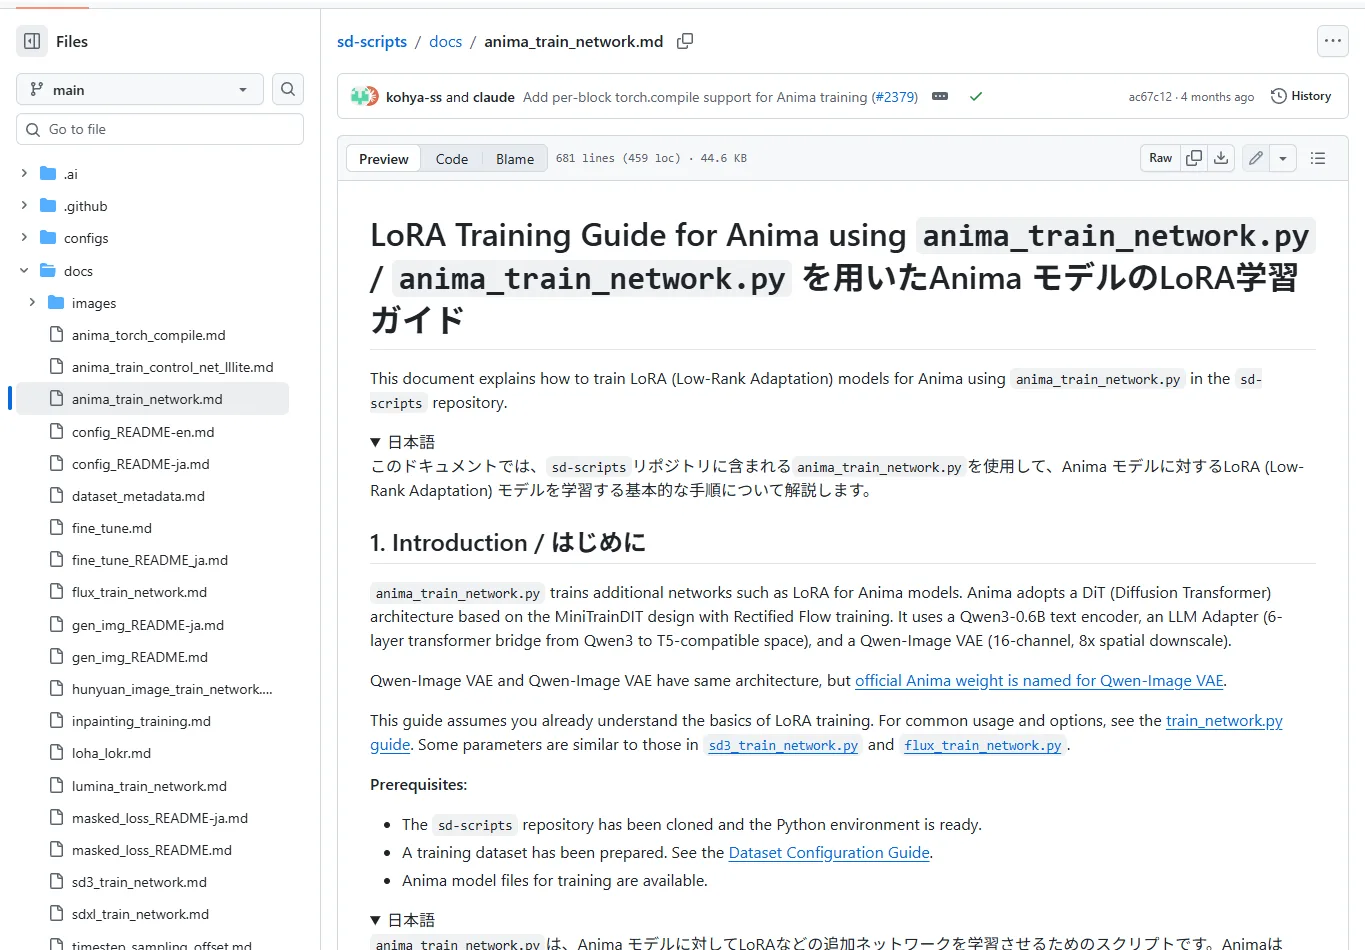
Anima向けsd-scripts
AnimaではSDXL用ではなくanima_train_network.pyを使います。DiT、Qwen3エンコーダー、VAEを個別に指定でき、モデルの取り違えを避けやすいルートです。データセットTOMLとコマンドを編集できる人に向いています。専用ドキュメントには日本語の説明もあります。
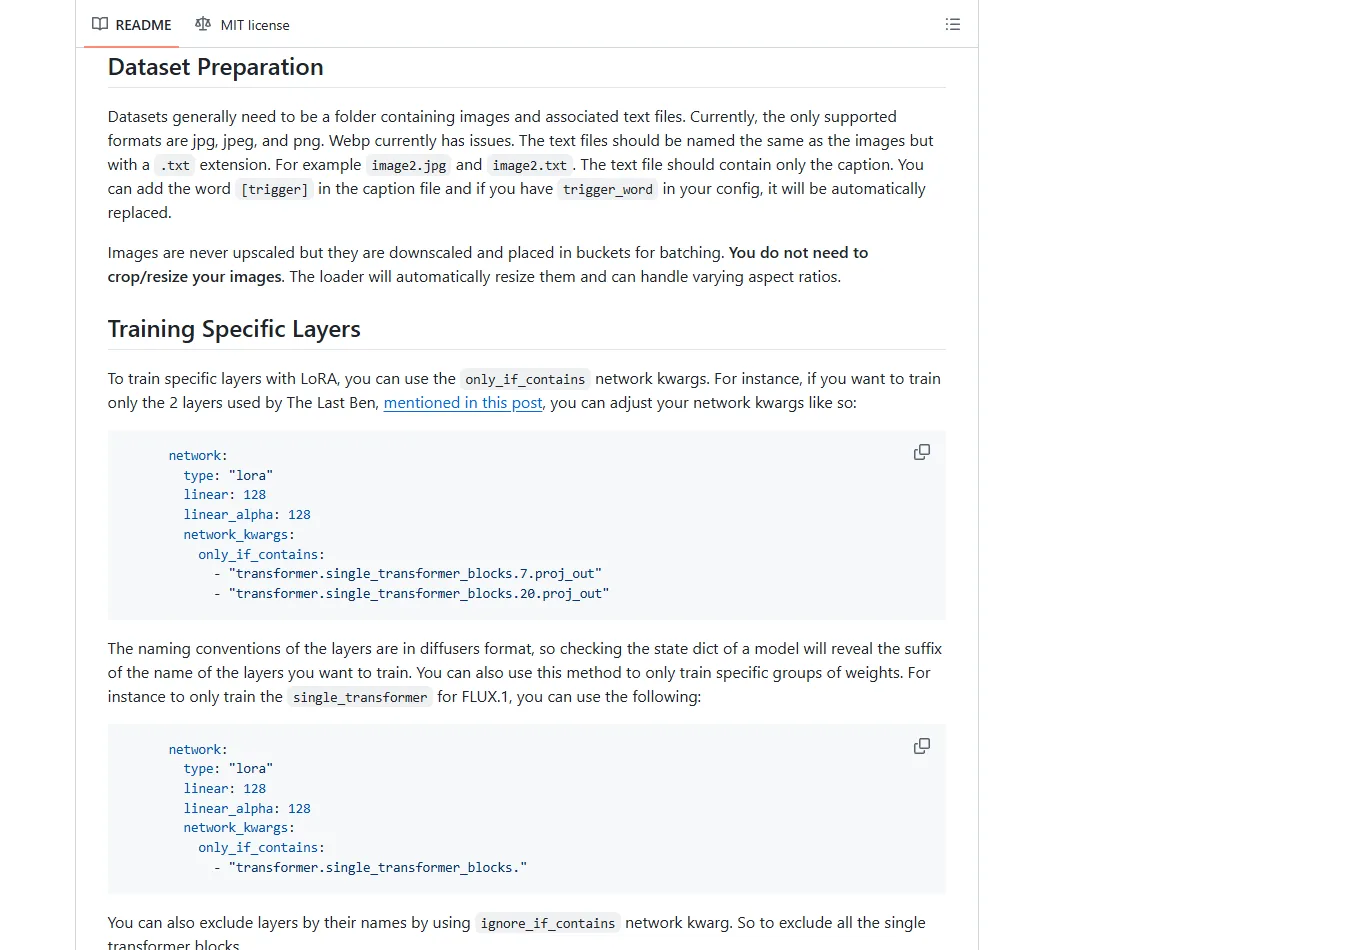
Ostris AI Toolkit
複数の画像モデルをGUIやYAMLで扱いたい人に便利です。ジョブを作り、正確なモデル種類、データフォルダー、トリガー、固定の評価プロンプト、保存間隔を設定します。FLUX用ジョブの名前だけQwenに変えるのではなく、そのモデル向けの例を使います。クラウドでUIを開く場合は認証を設定し、公開状態にしないでください。
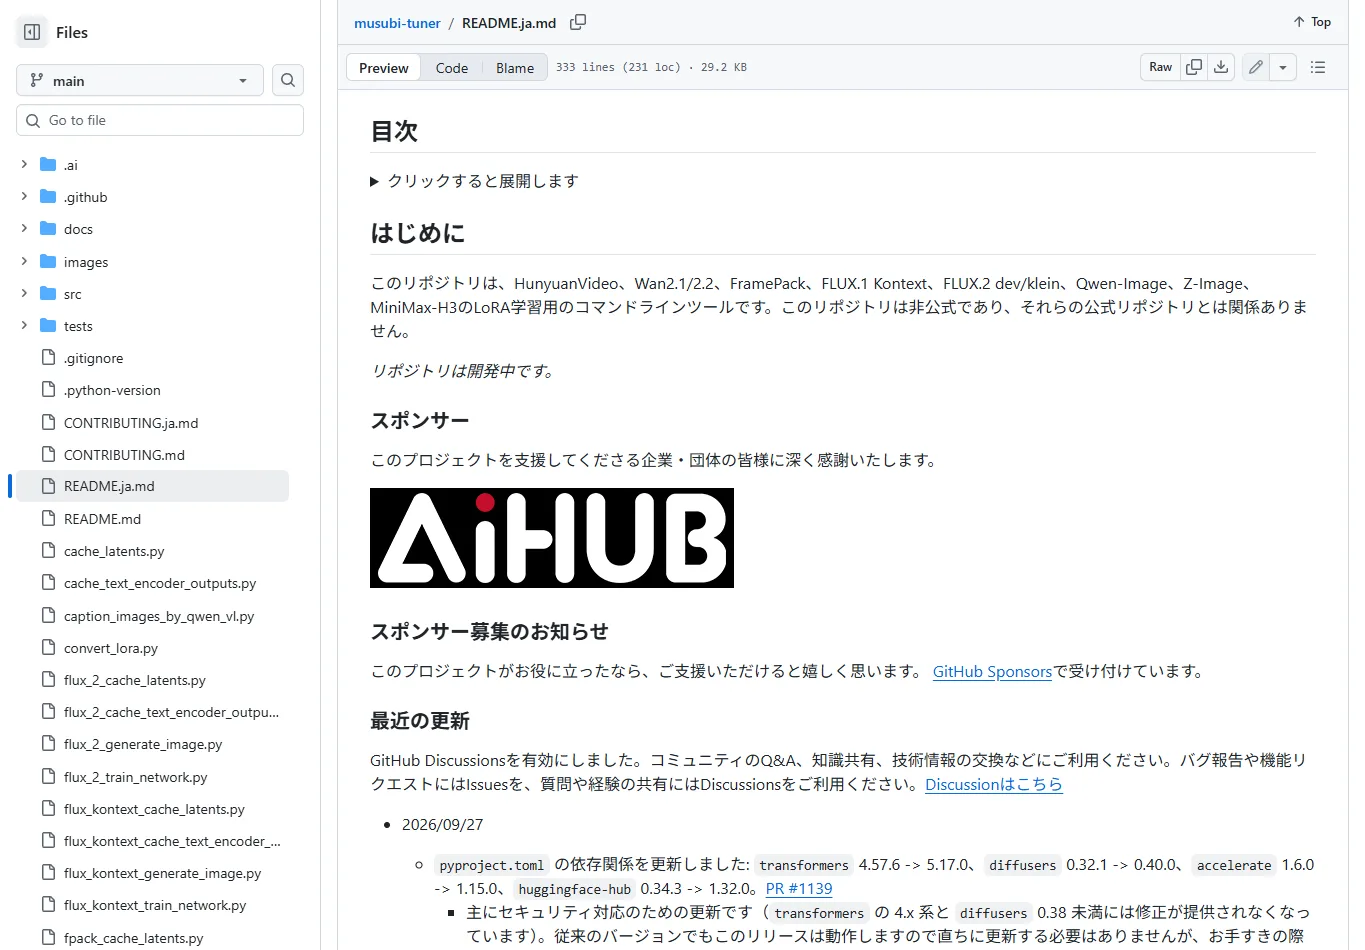
Musubi Tuner
キャッシュ作成と学習を分け、モデル固有のオプションやブロックスワップを細かく指定したい人向けです。専用環境を構築し、データセットTOML、潜在表現キャッシュ、テキストキャッシュ、モデル別学習スクリプトの順に進めます。別モデルのキャッシュやノイズ設定を流用しないことが重要です。
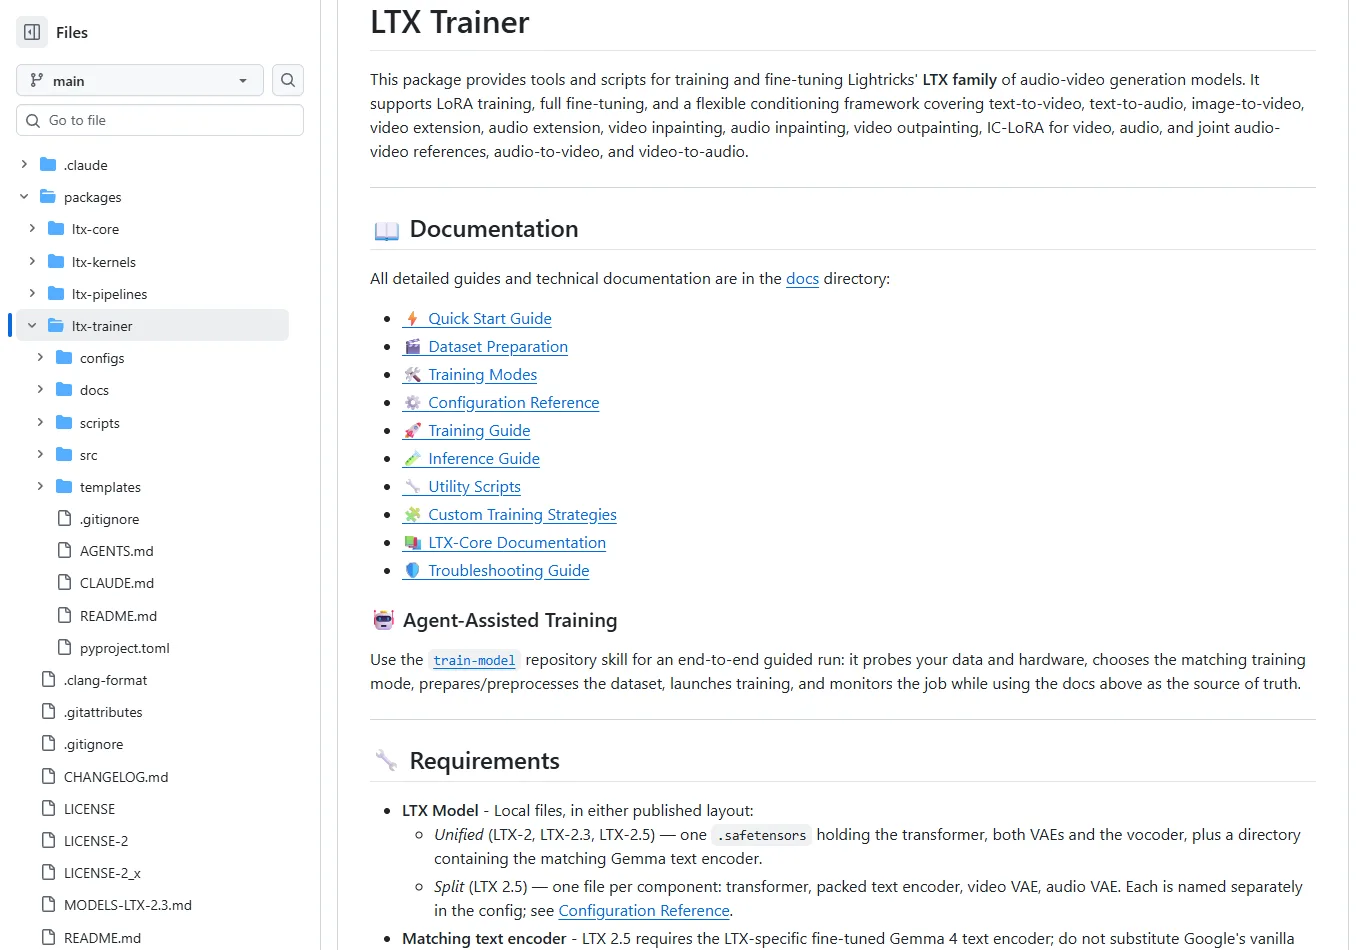
Lightricks LTX Trainer
LTX系では公式の学習パッケージを優先します。前処理、学習、評価の設定が同じリポジトリで管理されています。最初は通常または低VRAMのT2V LoRA設定をコピーし、フルファインチューニング用を選ばないようにします。モデルとテキストエンコーダーは対応するローカルファイルを指定します。
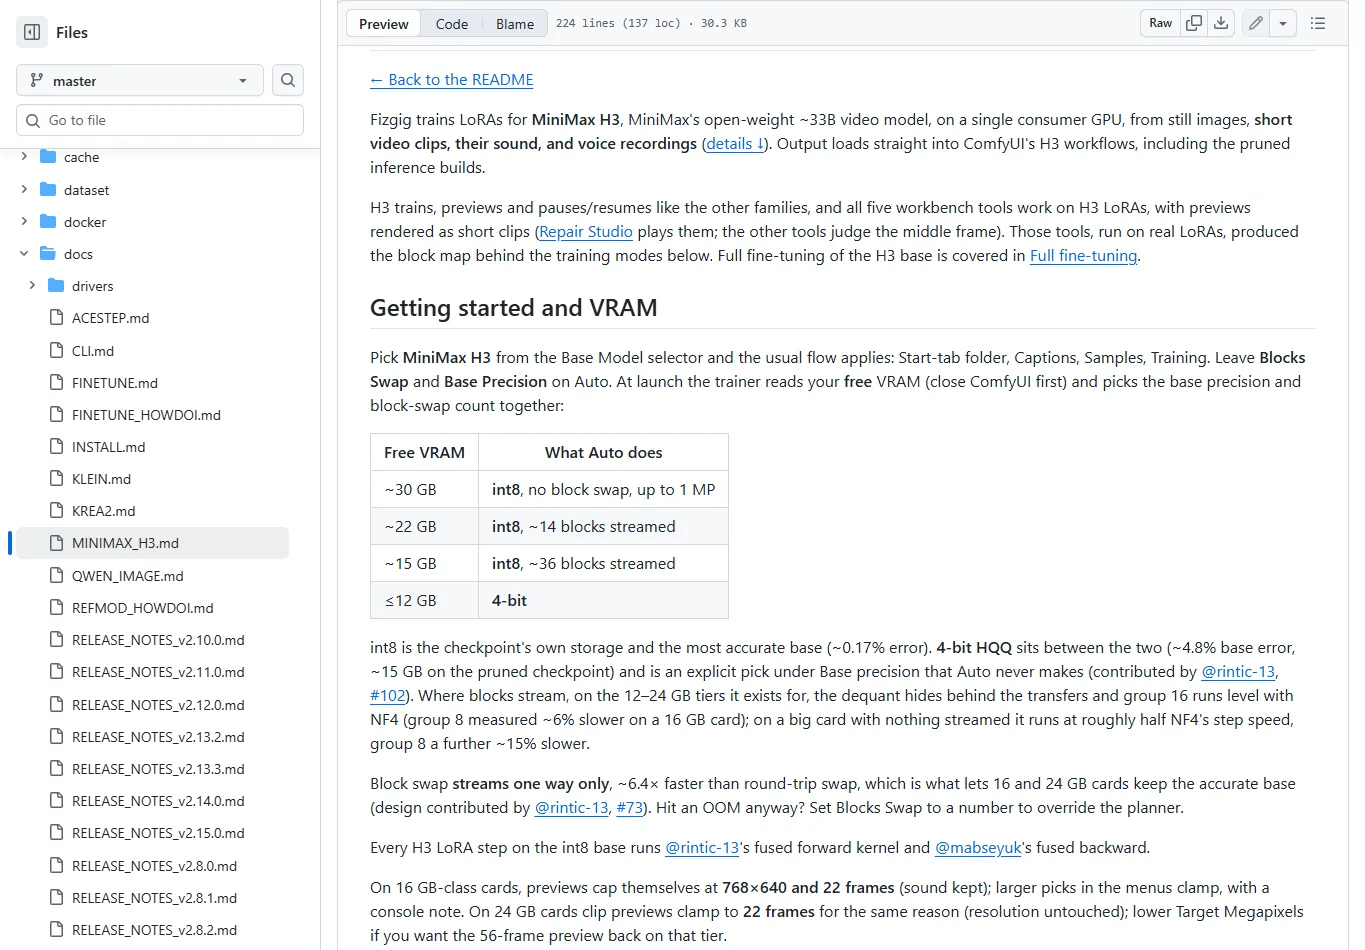
MiniMax H3をGUIで扱うFizgig
H3のデータ準備とプリセットをまとめて扱えるコミュニティ製ツールです。学習モデルでMiniMax H3を選び、静止画または短い動画に説明を付け、Fastプリセットから試します。保存結果を確認してから長さや規模を増やします。自動学習率の仕組みはMusubiの固定学習率の例とは異なるため、設定を混ぜないでください。
覚えさせたい内容に合うデータセットを作る
- 目的を一つに絞ります。人物・キャラクター、画風、商品、動きでは必要な素材が違います。画像の最初の試行なら、重複の少ない20〜50枚程度を扱いやすい目安にできますが、最低枚数や成功保証ではありません。画風には複数の題材が必要です。
- 重複、破綻、透かし、強い圧縮、別人が混ざった画像を除きます。構図・姿勢・照明・背景を変え、固定したい特徴と偶然写った要素を区別しましょう。不要な背景までトリガーに結び付かないよう、可変要素は説明します。
- subject_001.pngとsubject_001.txtのように名前をそろえます。アニメ系ではタグ、新しいTransformer系では自然文が使いやすい場合があります。自動説明は左右、人数、動作、名前の誤りを必ず見直してください。
- 評価用には別の画像・動画を確保します。同じ動画の隣接フレームを学習用と評価用に分けても、汎化の確認になりません。
- 動画は場面の切り替わりで分割し、一続きの動きを残します。FPSと長さを記録してください。静止画の集まりは外見を教えられても、時間順序を持つ動作の代わりにはなりません。
- 解像度とフレーム数は各ツールのバケット制約に合わせます。音声付きモデルは同期した有用な音声、または明示的に対応した動画のみの設定が必要です。無音ファイルの追加で必ず解決するわけではありません。
- 自分が権利を持つ、または学習利用を許可された素材を使います。人物や声は必要な同意も確認します。元モデルのライセンス、素材の権利、公開するLoRAの条件は別々に確認してください。
- モデルのリビジョン、トレーナーのコミット、説明ルール、設定を保存します。実行途中で環境を更新せず、キャプション・部品・前処理を変えたら対応するキャッシュを作り直します。
キャプションの記述例です。生成結果の実測例ではありません。
Anime: a1explorer, adult woman, blue jacket, standing, forest, daylight
Photo: A photo of a1subject wearing a blue jacket beside a window in soft daylight.
Video: a1subject walks from left to right, turns toward the camera, and stops. The camera remains fixed.
初期設定の目安と公式ドキュメントの例
「例」は特定の学習ツールのドキュメントにある出発点であり、すべての素材で最適だった実測値ではありません。SDXLの範囲と試行予算は本ガイドの提案です。rank・alpha・学習率・最適化手法は一組で考え、alpha=1とalpha=rankを同じ設定として扱わないでください。初回はbatch 1でメモリを確認します。
| モデル・系統 | 設定例・試行の出発点 |
|---|---|
| SDXL / Pony / Illustrious / NoobAI | SDXL系:試行案はrank 16〜32、alpha=rank、U-Net学習率1e-4、テキストエンコーダー固定。余裕があれば1024バケット、動作確認を軽くするなら768を検討します。 ドキュメント |
| Anima | Anima:sd-scriptsの例はrank 8、既定alpha 1、学習率1e-4、AdamW8bit、bf16です。alphaを上げるなら学習率も見直します。 ドキュメント |
| Z-Image | Z-Image Base:Musubiの例はrank 32、学習率1e-4、AdamW8bit、shift 2.0。Turboは専用の蒸留解除/学習アダプター経路を使います。 ドキュメント |
| Qwen-Image | 初代Qwen-Image:Musubiの例はrank 16、学習率5e-5、shift 2.2。Qwen-Image-2.1やEdit全般の共通設定ではありません。 ドキュメント |
| FLUX | FLUX.1-dev:AI Toolkitの例はrank/alpha 16/16、学習率1e-4、batch 1、2,000 steps、512/768/1024バケット。FLUX.2とKleinは別のモデル設定です。 ドキュメント |
| Krea 2 | Krea 2 RAW:Musubiの例はrank/alpha 32/32、学習率1e-4、bf16、AdamW8bit。1024の固定shiftは2.5で、解像度連動のkrea2_shiftも別途用意されています。 ドキュメント |
| Wan | Wan 2.1:Musubiの例はrank 32、学習率2e-4、AdamW8bit、shift 3.0。Wan 2.2ではエキスパート別の時刻範囲を加味します。 ドキュメント |
| LTX | LTX低VRAM設定:rank/alpha 16/16、学習率1e-4、batch 1、2,000 steps、INT8とcheckpointing。576×576×49という評価設定を、全学習素材に必須の形状と誤解しないでください。 ドキュメント |
| MiniMax H3 | MiniMax H3:Musubiの例はrank/alpha 16/16、学習率1e-4に加え、H3固有の損失方式を一つ選びます。Fizgig Fastは8/8、50 epochs、0.25 MP、1e-6からの自動スケジュールです。 ドキュメント |
画像LoRA:アニメ系モデルの学習
生成に使うモデルに近いチェックポイントで学習するのが基本です。SDXL派生間でファイルが読み込めても、顔立ち、配色、適切な強度が変わることがあります。移植性は実際の出力で判断します。
Pony V6 XL:タグと元モデルをそろえる
kohya_ss/sd-scriptsのSDXL LoRAを使います。キャラクターや画風のトリガーと、服装・背景など可変の説明を分けます。評価時は選んだPonyの品質タグ規則に従い、そのままIllustriousやNoobAIへコピーしないでください。
GUIでモデル、データ、caption拡張子、バケット、rank/alpha、U-Net学習率を設定し、初回はテキストエンコーダーを固定します。保存ごとに同じプロンプトで確認し、一つの姿勢や背景に固定されるなら早いチェックポイントを選びます。Pony V7は別の学習経路です。
ドキュメント — Pony V6 XL:タグと元モデルをそろえる
Illustrious XL:背景まで覚え込ませない
基本の学習ツールはSDXL系と共通ですが、バージョンと派生先を合わせます。生成に使うモデルを選び、その説明ルールに従ってください。自然文を重視する版もあり、古いタグ中心の設定が常に最適とは限りません。
最初は一つのキャラクターまたは画風に絞り、rank 16〜32、エンコーダー固定で試します。背景まで同じになるならrankを増やす前に素材と説明を修正し、未学習の服装・構図でも特徴が保たれるか確認します。
ドキュメント — Illustrious XL:背景まで覚え込ませない
NoobAI XL:eps/v-predictionを先に確認
NoobAIには予測方式が異なる版があります。V-Predのモデルカードはv-predictionとzero-terminal-SNRの推論設定を示しています。学習側も対応する予測方式とノイズ設定にそろえ、通常のepsilon用SDXL設定をそのまま使わないでください。Noobという名前だけで全版をv-predにするのも誤りです。
正しい系統を選んだ後、小規模なSDXL学習を行います。色やコントラストが崩れる場合は、素材より先に予測方式と推論スケジューラーを確認します。モデルカードから案内されるv-pred専用手順を参照し、設定をLoRAと一緒に保管してください。
ドキュメント — NoobAI XL:eps/v-predictionを先に確認
Anima:専用DiTとして学習する
AnimaはSDXLの追加学習版ではありません。DiT、Qwen3-0.6B、対応するQwen-Image VAEと、版に応じたTokenizer/Adapterを準備し、anima_train_network.pyとnetworks.lora_animaを使います。Pony LoRAの名前を変えてもAnima用にはなりません。
最初はDiTのみを学習し、テキスト出力をキャッシュする構成が整理しやすいでしょう。rank 8/alpha 1の例を一組として扱います。エンコーダーも学習するならキャッシュを無効にし、別の低い学習率で試します。Animaのcaption dropout対応をSDXLにもそのまま期待しないでください。
使い方
- データセットTOMLを作成し、Animaの例に部品のパスを設定します。
- 対応GPUではbf16とgradient checkpointingを使い、初回はDiTのみの学習を明示します。
- 毎epoch保存し、同じAnima版と未学習プロンプトで比較してからrankや学習対象を増やします。
画像LoRA:写真・実写系モデルの学習
Z-Image:まずBaseで学習する
現在のMusubiドキュメントはBaseでの学習を推奨しています。「Turboしかない」という古い説明とは状況が違います。蒸留済みTurboでは、対応したDe-Turboまたは学習アダプターを使い、推論時もその手順に合わせる必要があります。
DiT・VAE・エンコーダーを用意し、Z-Image用のキャッシュスクリプトからzimage_train_network.pyへ進みます。rank 32/学習率1e-4の例で短く試し、ComfyUI側が別のキー形式を要求する場合は変換手順を確認します。
使い方
- Base、De-Turbo、Turbo+学習アダプターを明確に選び、実行名にも記録します。
- 対応する部品で画像と説明をキャッシュし、複数のチェックポイントを保存します。
- 同じZ-Image系の推論ワークフローで確認し、必要な場合だけ公式ツールのLoRA形式変換を行います。
Qwen-Image:生成用と編集用で素材を分ける
初代の画像生成モデルにはMusubiのrank 16/学習率5e-5の例があります。編集LoRAは入力画像、目標画像、変更内容の指示が必要で、人物画像と説明だけでは編集操作を十分に教えられません。版ごとのオプションで入力の処理方法も変わります。
AI ToolkitはQwen-Image-2.1の生成・編集に対応すると記載し、control画像で編集を有効にします。古いmodel_version originalの例をそのまま流用せず、正確なモデルを選びます。編集では未知の入力に対して、変更箇所以外が維持されるか確認してください。
使い方
- 生成か編集かを決め、Qwenの正確な版を選びます。
- 編集では入力と目標画像を対応させ、変化を説明する指示を付けます。
- 少量で学習し、未使用の入力で編集の強さと元画像の維持を両方評価します。
ドキュメント — Qwen-Image:生成用と編集用で素材を分ける · AI Toolkit: Qwen-Image-2.1
FLUX:1・2・Kleinを区別する
AI ToolkitのFLUX.1-dev用YAMLにはrank、保存間隔、評価文、stepsが示されています。コピーしたジョブのデータ・出力パスとトリガーを変更し、python run.pyで実行します。必要なライセンスに同意し、アクセストークンは公開しません。
FLUX.2-devやKleinには、それぞれの対応アーキテクチャと部品を指定します。FLUXという名前だけでFLUX.1の例を流用しないでください。説明は自然な文で見えている状況を書き、トリガーを一定にします。自動生成された誤った説明は削除します。
使い方
- 該当する例またはGUIプリセットから新規ジョブを作ります。
- 新しい背景、異なる構図、トリガーなしの評価文を固定します。
- FLUX.1-devの2,000 steps例を目安に途中結果を比べ、硬直化するなら早めの保存版を採用します。
Krea 2:RAWで学習しTurboで評価する
MusubiはRAW学習からTurbo推論への流れを推奨します。raw.safetensors、Qwen-Image VAE、単体ファイルのQwen3-VL-4Bを準備し、krea2_cache_latents.py、krea2_cache_text_encoder_outputs.py、krea2_train_network.pyの順に使います。
最初はrank/alpha 32/32、学習率1e-4の例を一組として試します。1024の固定shift 2.5と解像度連動krea2_shiftは別の選択肢です。RAWはCFGを必要とし、Turboは少ないstepsとCFG無効の例です。CFGなしでRAWの試写がぼやけても、直ちにLoRA失敗とは判断できません。
使い方
- RAW用部品でキャッシュし、Turboチェックポイントを別に保持します。
- RAWで学習し、メモリ設定と互換性がある場合はTurbo試写オプションを使います。
- Turboの8 steps/CFG 1の例で始め、顔だけでなく姿勢の自由度と背景も比較します。
ドキュメント — Krea 2:RAWで学習しTurboで評価する
動画LoRA:Wan・LTX・MiniMax H3
Wan 2.1/2.2:外見と動きを分けて考える
MusubiではT2V/I2Vと版を選んでから素材をキャッシュします。単一フレームは外見学習に使えますが、動きには連続した動画が必要です。wan_cache_latents.py、wan_cache_text_encoder_outputs.py、wan_train_network.pyの順に進めます。
Wan 2.2 A14Bは高ノイズ・低ノイズのエキスパートを分けます。文書の範囲はI2Vが0〜900/900〜1000、T2Vが0〜875/875〜1000で、一方だけの学習では分布形状の維持も指定します。両方を同時に扱うとメモリ負担が大きくなります。
使い方
- 正確なtaskと重みを選び、短いフレームバケットで読み込まれる動画を確認します。
- 対応VAE/T5とタスク用部品でキャッシュし、Wanの設定例から始めます。
- 2.2は対象エキスパートと範囲を記録し、推論側でも対応する枝にLoRAを読み込みます。
- 一枚目だけでなく、全編の動きと顔の変化を評価します。
ドキュメント — Wan 2.1/2.2:外見と動きを分けて考える
LTX:世代に合う公式トレーナーを使う
公式トレーナーはLTX-2、2.3、2.5に対応しますが、部品は同じではありません。LTX-2/2.3はGemma 3、2.5はLTX専用に追加学習されたGemma 4を使います。モデルだけ変更して古い埋め込みを再利用しないでください。
32GB向け低VRAM設定はrank/alpha 16/16、学習率1e-4、batch 1、2,000 stepsとINT8/checkpointingを組み合わせます。標準構成の推奨は80GBです。どの32GB GPUでも任意の長さ・解像度で動くという保証ではありません。
使い方
- LTX環境と、同じ世代のモデル・エンコーダーを準備します。
- 動画を分割して説明を確認し、対応バケットでprocess_dataset.pyを実行します。
- 低VRAMまたは標準YAMLをコピーし、モデルと前処理済みデータのパスを設定してscripts/train.pyを実行します。
- I2V、音声、参照学習では、それに対応したstrategyとtarget modulesを選びます。
ドキュメント — LTX:世代に合う公式トレーナーを使う · LTX: low-VRAM YAML
MiniMax H3:H3専用レシピを崩さない
H3は大きな音声動画モデルのため、汎用的な動画LoRA設定の流用が特に危険です。GUIで始めるならFizgig Fastのrank/alpha 8/8、50 epochs、0.25 MPと専用自動スケジュールが一案です。同ツールの16GB例は0.25 MPで56フレームまでの短い動画に限られ、H3共通の最低要件ではありません。
Musubiの例は16/16、学習率1e-4ですが、学習アダプター、guidance loss、teacher matchingから完全な損失設定を一つ選びます。base timeはuniform/none/shift 1.0で、動画・音声のshiftは内部処理です。Wanのshiftをコピーすると別の仕組みを変えてしまいます。
使い方
- FizgigかMusubiの一方を選び、学習率の仕組みを混ぜません。
- 外見なら静止画、動きなら最短の対応クリップから始めます。
- Musubiではtaskと損失方式を選び、それに必要な動画・音声・テキストを一貫してキャッシュします。
- 短い保存・再読み込みテスト後、実際に使うbaseで評価します。学習アダプター適用中の試写だけで判断しないでください。
ドキュメント — MiniMax H3:H3専用レシピを崩さない · Fizgig: MiniMax H3
データセットから最初のLoRAを書き出すまで
次の例はepsilon予測のSDXLチェックポイント用の出発点です。sd-scriptsの導入手順を済ませ、すべてのパスを変更してください。テキストエンコーダーを固定してキャッシュを使います。NoobAI V-Predや別アーキテクチャでは対応設定が必要で、このコマンドをそのまま使うことはできません。
設定例 — dataset.toml
[general]
caption_extension = ".txt"
shuffle_caption = false

[[datasets]]
resolution = 1024
batch_size = 1
enable_bucket = true

[[datasets.subsets]]
image_dir = "/path/to/images"
num_repeats = 5
SDXL / Epsilon
accelerate launch sdxl_train_network.py --pretrained_model_name_or_path="/path/to/sdxl-epsilon.safetensors" --dataset_config="dataset.toml" --output_dir="output" --output_name="subject_lora" --network_module=networks.lora --network_dim=16 --network_alpha=16 --network_train_unet_only --learning_rate=1e-4 --optimizer_type=AdamW8bit --lr_scheduler=constant --max_train_steps=1000 --save_every_n_steps=250 --mixed_precision=bf16 --save_model_as=safetensors --gradient_checkpointing --cache_latents --cache_text_encoder_outputsまず100〜200 optimizer steps程度で、キャッシュ、逆伝播、保存、推論時の読み込みを通します。書き出したLoRAが効くことを確認してから本学習に進み、最後の保存版だけでなく途中も比較しましょう。
Musubiの基本はTOML→潜在キャッシュ→テキストキャッシュ→モデル別学習→対応する推論です。部品、対象モジュール、時刻分布、損失方式まで含め、該当文書の完全な例を使ってください。
チェックポイントの評価と失敗の切り分け
LoRAの効果がない
読み込み、トリガー、モデルの一致、推論強度を確認します。missing keyの警告を調べてから学習回数を増やします。
いつも同じ画像になる
早いチェックポイントと低い強度を試し、素材の多様性を改善します。rankを増やすより先にrepeatsと総stepsを見直します。
lossは下がるのに見た目が悪化
固定seedと未学習の評価文で比べます。lossが低くても構図や動きの自由度は落ちることがあります。
VRAM不足
キャッシュ・学習・評価のどこで失敗するかを確認し、batch、解像度、フレーム数や対応するオフロードを調整します。勾配蓄積は一つの大きすぎるサンプルを小さくしません。
動画がちらつく・動かない
素材の連続性、FPS、時間方向のタスクと対象層を確認します。静止画で似ていても、動作を学習できたとは限りません。
新しい説明が反映されない
キャプション、トリガー、エンコーダーなどを変えたら対応キャッシュを再生成します。別モデルの潜在表現も流用しません。
VRAM・所要時間・費用の考え方
推論画面のVRAM表示だけで機材を選ばないでください。学習には活性値、勾配、optimizer stateが必要で、評価生成の方がピークになる場合もあります。SDXLは比較的軽い入り口で、新しい画像DiTでは16〜24GB以上と対応するオフロードが役立ちますが、これは計画上の目安で保証値ではありません。
Musubiの一般案内は画像12GB以上、動画24GB以上、RAM 64GBを推奨します。個別モデルはさらに必要になることがあります。Kreaの1024/batch 1の比較では3090にbf16が収まらず、量子化経路が用意されています。LTXの32GB/80GBとFizgigの条件付きH3例を、一律の最低VRAMに置き換えないでください。
クラウド費用は、ダウンロード・キャッシュ時間+steps×実測秒数+評価・保存時間を見積もり、その時点の時間料金と保存・転送料金を加えます。国内の支払いでも請求通貨や消費税を確認しましょう。ローカルは機材と電力の費用がかかり、学習ソフトが無料でも計算資源は無料ではありません。
実効batch=GPUごとのbatch×勾配蓄積×GPU数です。40枚、repeats 5、実効batch 2、10 epochsなら単純計算は約1,000 optimizer steps。バケットや端数処理で変わるため、トレーナーの実際の総数を確認します。
LoRA学習のよくある質問
一つのLoRAを全モデルで使えますか?
できません。形状と対象層はアーキテクチャに依存します。SDXL派生間でも読み込み互換性と出力品質は別で、学習元と確認した推論先を明記します。
テキストエンコーダーも学習すべき?
まず固定して比較基準を作りましょう。キャッシュ済み埋め込みではエンコーダーを更新できません。対応する場合だけ、別実験として学習率とキャッシュを調整します。
20枚で足りますか?
狭い対象の試行には使える場合がありますが成功保証ではありません。画風は題材の幅、動きは連続クリップが重要で、単純なrepeats増加より素材の不足を直します。
rankは32で統一できますか?
統一はおすすめしません。rankは容量とメモリ、alphaは倍率に関係します。Animaのalpha 1とKreaのalpha=rankを混同せず、一度に一つずつ変更します。
静止画で新しい動きを覚えられますか?
外見には役立ちますが、孤立した画像に時間順序はありません。動きは対応する動画学習と全編の評価が必要です。
Turboや量子化モデルで直接学習できますか?
トレーナーがその形式と手順に対応する場合だけです。凍結重みを量子化する方式や学習アダプターを使う方式があり、GGUF推論対応だけでは学習対応を意味しません。
完成したLoRAはどう使う?
推論アプリのLoRAフォルダーに置き、対応するbaseとloader、トリガーを使います。最初は強度0/0.5/1と複数seedを比較し、必要な形式変換も確認します。
最初に選ぶべき学習ルート
一つのモデル、一つの目的、固定の評価セットから始めましょう。最初のアニメキャラクターはkohya_ssのSDXLが分かりやすく、Animaで生成するなら最初からAnimaで学習します。写真系ではAI Toolkitが扱いやすく、細かなモデル別設定を理解したい場合はMusubiが役立ちます。
動画は外見、動き、編集、音声のどれを学ばせるかを先に決めます。短い素材で専用設定を守り、最初の保存結果を確認してから拡大してください。素材を暗記した大きなLoRAより、狙った特徴を加えながら自由度を残すLoRAの方が使いやすいはずです。


