Strataレビュー|ローカルAIの対応モデル・導入・速度・安全性を解説
Strataのデスクトップ版、対応モデル、必要なメモリ、使い方、API、実際のユーザー報告とDeepSeekの制限を解説。

Strataは、対応する言語モデルを自分のPCで動かし、チャットやコーディングツールにつなげられる無料のオープンソースソフトです。GPUのVRAM、システムRAM、必要に応じてSSDを組み合わせ、大きなモデルを一般向けPCで扱える点が特徴です。ローカル環境を自分で管理したい人に向いています。
モデルの選択、ローカルチャット、コーディングツールとの接続を一つの環境にまとめられる点が魅力です。快適に使うには、手元のRAMや保存容量に合う対応モデルを選ぶことが重要で、機材と設定によって使い心地が変わります。
目次
Strataの仕組み
StrataにはデスクトップアプリとTerminalランチャーがあり、対応モデル向けのローカル推論エンジンを利用します。Mixture of Expertsモデルでは必要な部分をGPUとCPU・RAMへ配置し、RAMに入りきらない場合はSSDから読み込む仕組みです。SSD読み込みが増えると速度は下がりやすく、回答の質もモデル、量子化、設定に左右されます。
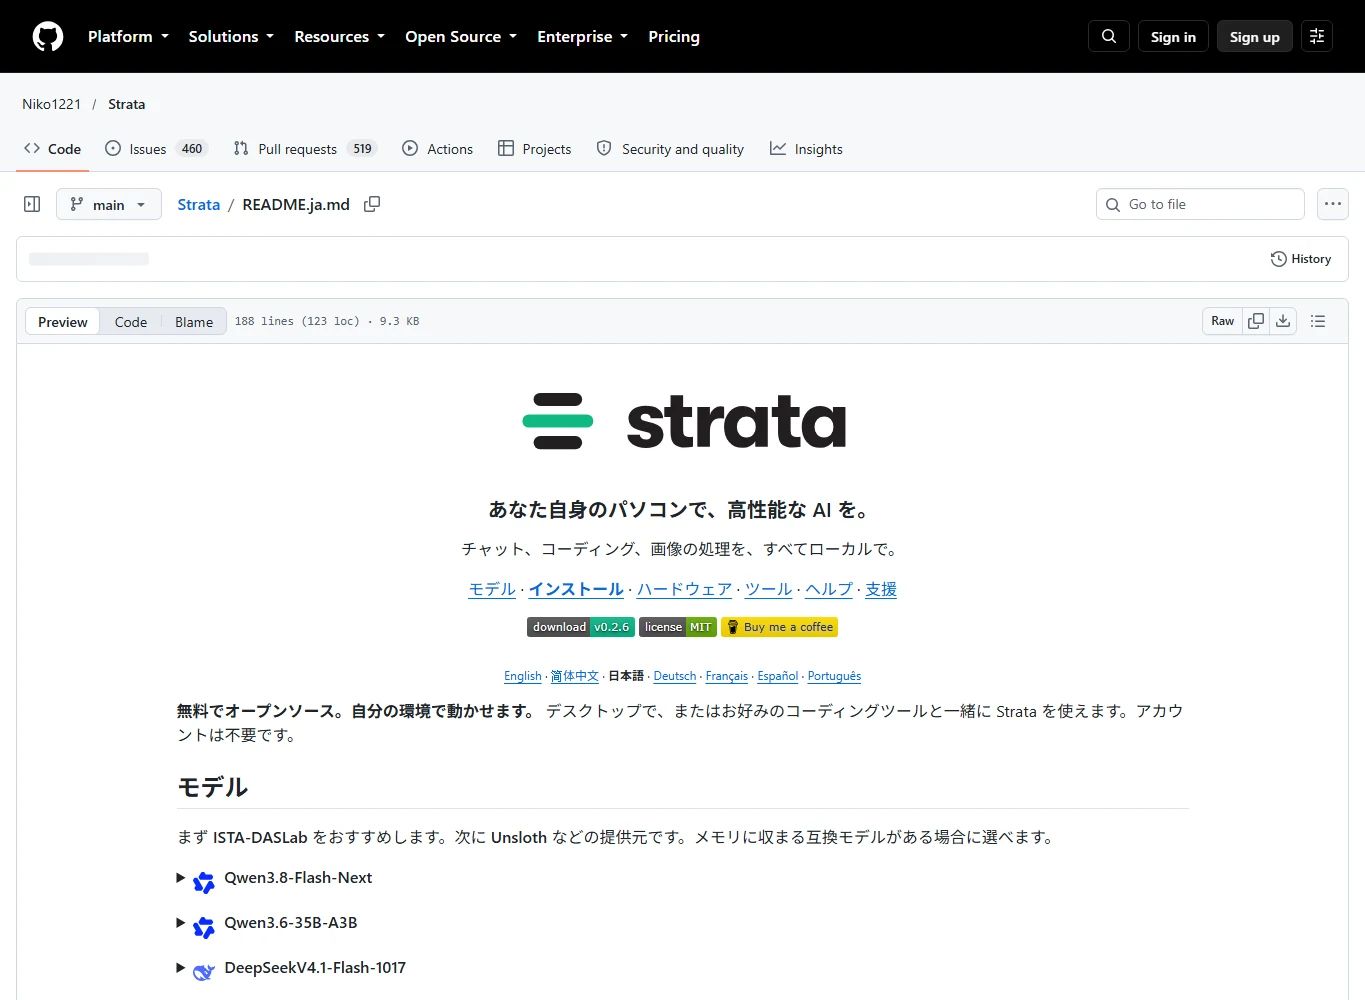
本体はMITライセンスで無料、アカウント不要と公式に説明されています。0.2.6ではWindows、Linux、Apple Silicon macOS向けアプリがありますが、個々のモデルやエンジンの対応環境は別途確認が必要です。
対応モデルとハードウェア
公式のモデル一覧にはQwen3.8-Flash-NextのISTA-DASLabやUnslothなどの対応パック、Qwen3.6-35B-A3BのUnslothパック、専用エンジンを使うDeepSeek V4.1-Flash-1017が掲載されています。ファイルは何でも交換できるわけではなく、モデル系列と互換パックを選びます。
公式の概算ではQwen3.8-Flash-NextのQ2_0の重みにRAM+VRAM合計37.6GB、IQ3_Sには54.8GBが必要です。OSやコンテキストの余裕は別で、SSDへ退避する実行方法は遅くなります。Strata全体ではNVIDIA RTX、対応AMD Radeon、LinuxのIntel Arc、Apple Silicon、Ryzen AI Maxを案内していますが、モデルごとに対応は異なります。
インストールと日常の使い方
0.2.6の公式手順では、OSに合うインストーラーを入手し、Windows/Linuxでは初回起動時にGPUに合うエンジンを取得し、モデルと保存先を選んでチャットを始めます。Mac版にはMetalエンジンが含まれ、Intel ArcはLinuxのTerminalを使います。モデルの取得・初期準備には時間と空き容量が必要です。
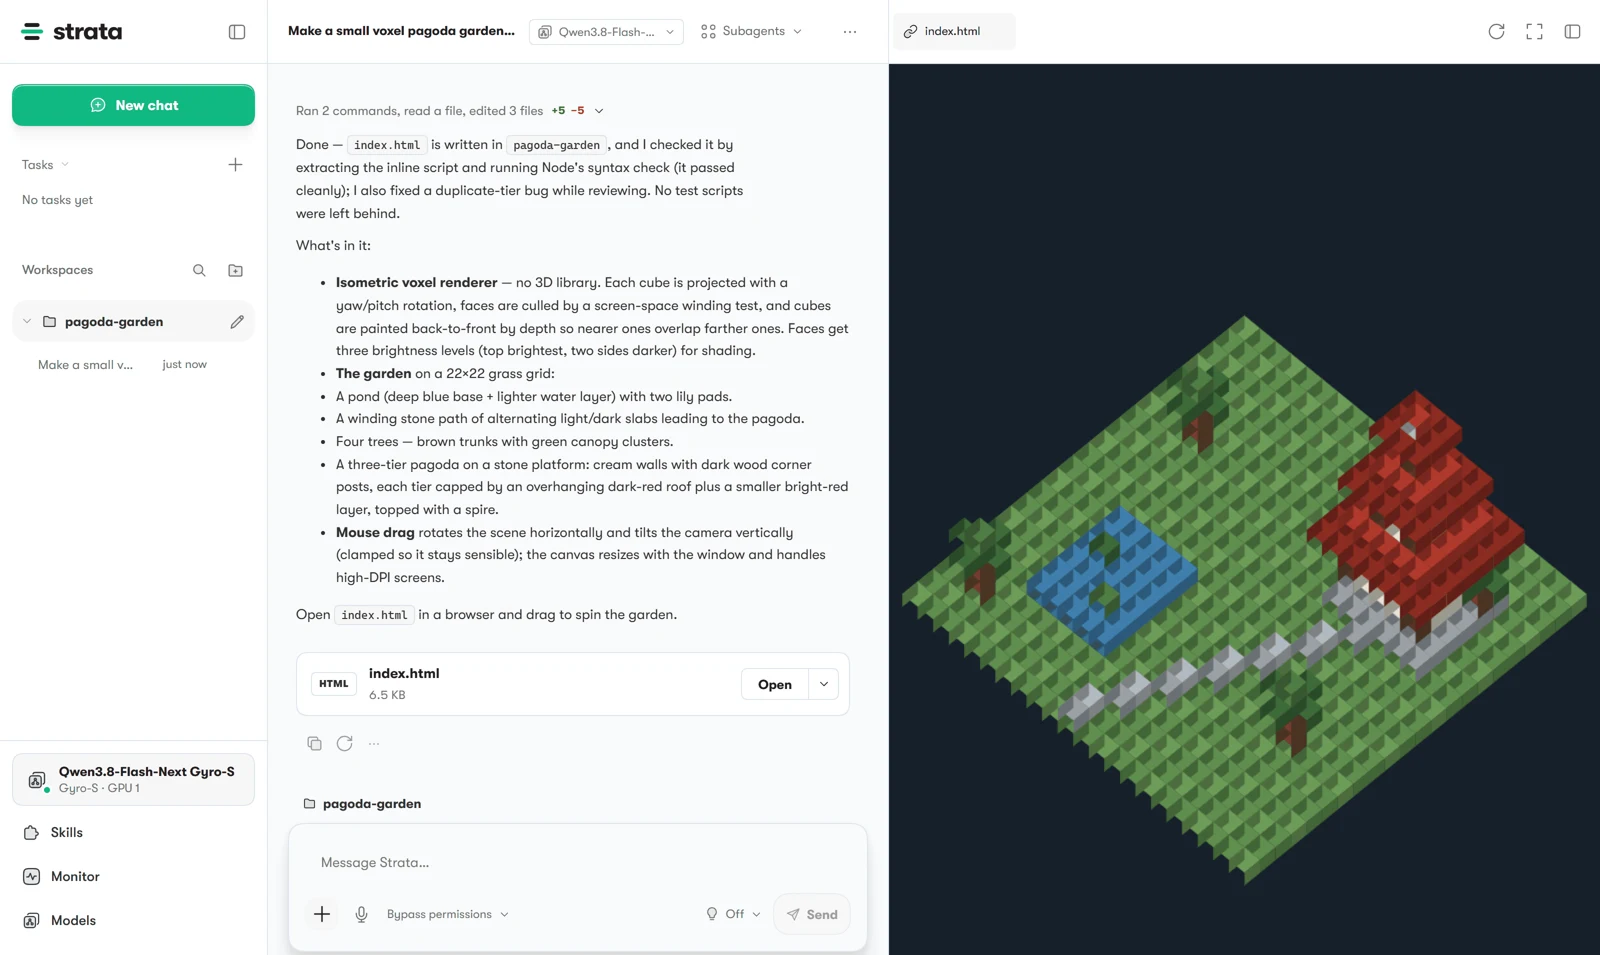
デスクトップアプリはチャット、ファイル、コードのライブプレビューを提供し、Terminalでは対話式の設定や監視を利用できます。これは公式資料に基づく機能説明で、当サイトによる操作性の実測ではありません。大きなモデルを取得する前にドライバー、容量、ライセンスとトラブルシューティングを確認しましょう。
コーディングツールとAPI
OpenAI互換・Anthropic互換のローカルAPIを通じてClaude Code、Codex CLI、OpenCodeなどを接続でき、`strata connect`で設定案内を確認できます。API互換は、クラウドサービスの全パラメーターやツール呼び出しが同じ動作をするという保証ではありません。
まず短い入力と小さなツール呼び出しで、実際のクライアントとの相性を確認してください。コンテキスト長、画像入力、同時処理はモデルやエンジンによって異なります。Qwenで使える機能をDeepSeekにも当てはめないことが大切です。
速度とユーザーの報告
ある利用者はRTX 5070 Ti 16GB、RAM 64GB、Qwen3.8-Flash-Next IQ2_XS、Strata 0.1.38〜0.1.43で、DevOps関連の28課題を各2回実行。ある設定で49/56と報告しました。本人申告の限定的な課題であり、現行0.2.6の検証や、あらゆる作業での品質同等性を証明するものではありません。
別の利用者はRTX 4080と3060の構成で、単一GPU約55 tokens/sに対し2枚使用時約45 tokens/sになったと報告しています。さらに応答のループやポート設定の分かりにくさを挙げる投稿もあります。いずれも個別の経験で、一般的な不具合率や公平な比較とは言えません。外部の解説記事も、ハードウェアと大容量ダウンロード、エージェント利用時の制約を指摘しています。
DevOps user report · Dual-GPU user report · User discussion · External review
大型モデルの活用例:12GB VRAMでDeepSeekを動かす
DeepSeek V4.1 Flash 1017の12GB GPU対応は、Strataの一機能です。開発者の公開例では別途RAM 46〜64GBを使用し、2.00-bit版は約257GBのダウンロードと約265GBの空きNVMe容量が必要です。当サイトで再現測定はしていません。
この専用エンジンの既定コンテキストは8,192 tokensで、現行資料では画像入力と同時リクエストに非対応。小容量GPU向けの高速設定では6専門家のうち5を使う場合があり、Full qualityは6を使います。開発者の0.2.5例はRTX 5070 12GBで出力約4〜6、RTX 3060 12GBで約9〜11 tokens/sですが、PCや条件が異なるため速度保証ではありません。
プライバシー・安全性・費用
開発者は使用状況のテレメトリーを送信せず、サーバーは既定でローカルに待機すると説明しています。モデルやエンジンの取得、更新確認には通信が必要で、任意のウェブ検索、外部モデル、共有やトンネルを使う場合はデータの送信先が増えます。設定と権限を用途ごとに確認してください。
本体は無料のMITライセンスですが、モデルと依存ソフトには個別の条件があり、電力・ストレージなどの費用もかかります。ローカル実行は絶対的な安全性を保証せず、モデルの回答にも誤りが含まれ得ます。
代替ツールと注意点
OllamaやLM Studioなどのローカル実行環境と比べ、Strataは対応モデル系列に合わせた推論とメモリ階層の活用に重点を置いています。それぞれのモデル・バックエンド対応は更新されるため、選ぶ直前に確認してください。小型モデルなら導入しやすく速い場合があり、クラウドAPIは大容量ダウンロードを避ける代わりに外部送信と利用料が発生します。
長所はローカルAPI、モデルに合わせた最適化、デスクトップとTerminalの選択肢。短所は対応モデルの範囲、大容量の取得、機材による速度差、更新の速さ、成熟した製品に比べた独立検証の少なさです。
どんな人に向いているか
対応GPUと十分なRAM・SSDがあり、設定を確認しながらローカルでチャットやコーディングを試したい人に適しています。最初は互換性のある小さめのパックと計画機能から始め、普段の入力で動作を確認するとよいでしょう。
2026年10月27日時点の公式資料、公開情報をまとめた外部記事とユーザー報告を参照し、文章作成にAIを使用しました。Strataのインストール、独立した速度・安定性・品質の測定は行っていません。
関連 レビュー
YouTube動画を文字起こしする方法|無料・AIツールでテキスト化

Canva Craftレビュー|2K・横長画像・日本語文字・料金と編集の実力
GPT-Image-2.5レビュー【2026年】料金・FlareとSunburst・NSFW対応を比較
AI顔交換ツールおすすめ6選|動画・写真の顔入れ替え【2026年】
Claude Fable 5レビュー|性能・使い方・前世代AIデザインツールとの違い
ERNIE-Imageレビュー|オープンソース画像生成AI、LoRA、ローカル導入、NSFW対応まで解説